




MMLU Benchmark
MMLUとは?
MMLU (Massive Multitask Language Understanding) は、多様な分野にわたって言語モデルのマルチタスク能力を評価するために設計されたベンチマークです。人文科学、STEM、社会科学などのトピックにまたがる57のタスクを対象とし、初等レベルから専門レベルまでの問題が含まれています。MMLUは、モデルが幅広いドメインにわたって知識を一般化し、推論する能力を評価するため、高度な言語モデルにとって包括的なテストとなります。MMLUで高い性能を示すことは、幅広い知識と文脈理解を必要とする複雑な現実世界の問題にモデルが対応できる能力を示しています。
MMLUはどのように機能するのか?
MMLUは、一連の多肢選択式問題を用いて、AIモデルがNatural Language Processing (NLP)における多様な種類の情報を処理し、応答する能力を評価します。各問題は、モデルの認知能力を主に3つの領域で試します:推論、知識検索、理解。
これらの要素がどのようにテストされるのかを見ていきましょう:
推論
MMLUにおける推論タスクでは、モデルが論理的思考と演繹的スキルを適用して正答に到達することが求められます。これらの問題は単に事実を思い出すだけではなく、問題を分析し、パターンを特定し、または提示された情報に基づいて結論を導き出すものです。これらのタスクはモデルの批判的思考能力をテストし、人間のような意思決定を模倣します。
例:
数学の推論問題では、複雑な方程式を解いたり、幾何学的関係を理解したりする必要があるかもしれません。
人文科学の分野では、歴史的出来事を解釈し、その影響を特定することができます。
知識検索
知識検索は、さまざまな分野にわたって保存された情報にアクセスし、活用するモデルの能力を評価します。ここで重視されるのは事実の正確性と、モデルが訓練データから関連情報をどれだけうまく引き出せるかであり、人間の専門家が記憶から知識を取り出す方法をシミュレートします。問題は公開されているデータから設計されており、科学、法律、テクノロジーなどのトピックにまたがっています。
例えば:
生物学の問題では、モデルが細胞小器官の機能を特定する必要があるかもしれません。
歴史の問題では、特定の時代における重要な出来事について尋ねられる場合があります。
理解
理解タスクでは、モデルが与えられた資料を解釈し理解することが求められます。それが文章の一節、データセット、または問題文であっても同様です。理解問題は、モデルが単に事実を暗記しているだけではなく、情報を有意義に統合し解釈できることを確認します。
例:
文学の問題では、モデルが短い抜粋を分析して、著者の意図や語調を推測するかもしれません。
医学の問題では、症状を解釈して可能性のある診断を特定することが含まれるかもしれません。
MMLUにおける問題構造と複雑性
MMLUの各問題には複数の回答選択肢があり、通常は4つ以上で、その中からモデルが正しいものを選択しなければなりません。この多層的な複雑性により、ベンチマークは幅広い知的スペクトラムにわたってモデルの能力を評価できます。問題は、さまざまな複雑さのレベルを反映するよう慎重に構成されています:
基本概念: これらの問題は、基礎的な数学、物理、歴史など、高校レベルで通常教えられる基礎知識を扱います。
中級レベルの理解: このレベルでは、問題は学部レベルのトピックを扱うことができ、対象分野についてより深い把握を必要とします。
高度な専門知識: これらの問題は、医療ケースの診断、工学的問題の解決、法的原則の解釈など、専門家レベルの課題をシミュレートします。
MMLUに含まれるタスク
このベンチマークには、単純なファクトチェックや暗記を超えるタスクが含まれています。モデルは以下についてテストされます。
批判的思考: 最善の解決策を見つけるために論理と推論を適用すること。
分野固有の知識: 生物学、物理学、または金融における専門的な質問に答えること。
マルチタスク適応性: パフォーマンスを落とさずにトピック間を容易に切り替えること。
AI開発におけるMMLUの重要性
MMLUは、複数の領域にわたって知識を一般化するモデルの能力を評価するため、AI研究における重要なベンチマークです。
領域をまたいだ一般化
MMLUは、AIモデルが1つの分野でうまく機能することに限定されず、関連のないトピック間をシームレスに移行できることを保証します。たとえば、モデルは生物学の質問に答えた後、経済学の問題に取り組むかもしれません。この一般化能力は、カスタマーサービスや教育ツールなど、多様な知識が求められるマルチタスク環境を扱えるAIシステムを作成するうえで重要です。
狭いタスクを超えて
MMLUでテストされるAIシステムは、テキストの要約や感情検出のような単純なタスクを超える必要があります。より複雑な推論を行い、特定の知識を取り出し、微妙なニュアンスを含むシナリオを解釈することが求められます。たとえば、単に事実を思い出すのではなく、モデルは物理学の問題を解くために論理を適用したり、歴史的文脈における関係性を推測したりする必要があるかもしれません。
現在のAIモデルを押し広げる
MMLUは、医学、工学、法律などの分野における専門職レベルの質問を含めることで、今日の言語モデルの限界に挑戦します。これらの質問はしばしば、表面的な理解を超える専門知識や推論を必要とします。例:
法律に関する質問では、憲法上の原則の含意について尋ねる場合があります。
医学に関する質問では、限られた情報に基づいて症状を診断することが求められる場合があります。
MMLUの実世界での応用
ヘルスケア: MMLUモデルは、患者の症状を分析し、考えられる診断を提案し、治療選択肢のために医学文献を要約することで、医師を支援できます。
教育: パーソナライズされた学習システムは、数学や歴史などの科目に合わせた説明を提供し、AIはさまざまな学習レベルに適した小テストや学習教材を作成します。
法律業界: MMLUは、契約書のレビュー、重要条項の要約、関連する判例法や法令を迅速に取得することによる法的調査を支援します。また、複雑な法律用語を簡略化し、クライアントの理解を向上させるのにも役立ちます。
カスタマーサポート: マルチタスクAIエージェントは、技術的な問題のトラブルシューティングから請求に関する懸念への対応まで、多様な問い合わせを管理しながら、共感的で正確な回答を提供します。
ビジネスと金融: MMLUは、財務サマリーの作成、不正行為の特定、企業が情報に基づいた意思決定を行うのに役立つクライアント向け提案書の作成を支援します。
科学と研究: 分野を横断してデータを統合し、結果を解釈し、助成金申請書や出版物向けの技術的要約を生成することで、研究者を支援します。
政府サービス: MMLUは、法的権利に関するリアルタイム情報を提供し、公共政策のギャップを分析し、資源調整と正確な更新情報によって緊急対応活動を支援することで、公共サービスを強化します。
MMLUの限界
領域バイアス: このベンチマークは、AIの訓練データに一般的に含まれる領域やトピックを優遇する可能性があり、真の一般化を評価することを難しくします。
多肢選択形式: 多肢選択式の質問に依存しているため、AIシステムにおける自由回答型の推論や創造性の評価が制限されます。
限定的な実世界の文脈: 多様ではあるものの、MMLUの質問には、追加の文脈や相互作用が必要となる可能性のある動的な実世界のシナリオが欠けています。
更新のスケーラビリティ: 進化する知識を反映するために新しい科目を追加したりデータセットを更新したりすることは、リソースを多く必要とし、維持が難しい場合があります。
言語的・文化的範囲: 焦点が英語データセットに置かれることが多く、言語的・文化的多様性を見落とす可能性があります。
人為的なスコアの上昇: 類似のデータセットで直接訓練されたモデルは、理解が真に向上していなくても、人為的に高い性能を示す可能性があります。
深さと広さの評価: このベンチマークは知識の広さをテストしますが、特定分野における理解の深さを十分に捉えきれない可能性があります。
MMLUと単一タスクベンチマークの違い
MMLUと単一タスクベンチマークの違いを理解することで、MMLUがAIモデルを評価するためのより包括的なツールである理由が明確になります。単一タスクベンチマークが特定の能力に焦点を当てる一方で、MMLUはモデルに対して、さまざまな科目やタスクにわたって汎化し、性能を発揮することを求めます。以下の表は明確な比較を示しています。
| 特徴 | MMLU | 単一タスクベンチマーク(例: GLUE, SuperGLUE) |
|---|---|---|
| 評価範囲 | 科学、人文科学、専門分野にわたる50以上の多様な科目をテストします。 | 感情分析、言い換え、質問応答などの特定のタスクに焦点を当てます。 |
| タスクタイプ | マルチタスク: 関連のない分野やタスク間を移行する必要があります。 | 単一タスク: 各ベンチマークは、特定の狭い問題における性能を評価します。 |
| 実世界での関連性 | 分野をまたぐ汎用性が求められる実世界のシナリオを反映します。 | 複雑なシナリオに汎化しない可能性のある、特定の制御された文脈に限定されます。 |
| 質問形式 | 主に多肢選択式で、事実知識、推論、理解をカバーします。 | 文の類似度、テキスト分類、QAペアなど、さまざまな形式を含みます。 |
| 知識レベル | 質問は高校レベルから高度な専門知識まで幅があります。 | 一般的に、標準的な言語理解レベルまたは特定のデータセットに焦点を当てています。 |
| 汎化テスト | 未知のタスクや分野に適応するモデルの能力を評価します。 | 大きな分野の変化を伴わず、事前定義されたタスク範囲内でモデル性能をテストします。 |
| ベンチマーク例 | MMLU | GLUE, SuperGLUE, SQuAD, MNLI, CoLA. |
表: MMLU vs. 単一タスクベンチマーク
MMLUベンチマークを使用するタイミング
MMLUベンチマークは、以下のシナリオで使用するのに適しています。
汎化能力の評価: MMLUを使用して、AIモデルが複数の科目にわたって知識をどれだけうまく汎化できるかを評価します。モデルが明示的に訓練された分野を超えて多様なタスクを処理できるかどうかを特定するのに有用です。
マルチタスク性能のテスト: 目標が、異なるタスクやドメイン間をシームレスに切り替えられるAIシステムを開発することであれば、MMLUは適切なベンチマークです。数学、歴史、法律など、さまざまな分野からの質問でモデルに課題を与えることで、マルチタスク適応性を評価します。
推論と理解力の測定: MMLUは、モデルの推論スキル、理解力、知識検索能力をテストするのに非常に効果的です。論理的思考、文脈の理解、問題解決を必要とするタスクに有用です。
AIの進歩のベンチマーク: MMLUを使用して、モデルの性能を他の最先端モデルや人間のベースラインと比較できます。実世界におけるマルチタスク能力の観点から、モデルがどの位置にあるかを理解するための標準化された指標を提供します。
マルチドメインアプリケーションの構築: カスタマーサポートボット、教育ツール、ナレッジアシスタントなど、多様で複雑なクエリを処理する必要があるAIアプリケーションでは、MMLUはモデルが実用的なユースケースに十分対応できる堅牢性と汎用性を備えていることを確認するのに役立ちます。
モデルの弱点の特定: MMLUは、モデルの理解におけるギャップを明らかにする優れた診断ツールです。たとえば、モデルが特定の科目、推論タスク、または新しいドメインへの適応に苦戦しているかどうかを明らかにできます。
MMLUによる言語モデルの評価とRAGによる強化
MMLUベンチマークは、大規模言語モデル(LLMs)の能力を評価するための重要なツールです。多様なタスクにわたるモデルの性能を測定する標準化されたフレームワークを提供し、モデル間の直接比較を容易にします。推論や事実想起のような強みを明らかにし、複雑な推論やドメイン固有のタスクでの苦戦といった弱点を浮き彫りにすることで、MMLUは研究者が改善すべき領域を特定するのに役立ちます。こうした洞察により、ファインチューニングが可能になり、モデルの理解力とコンテンツ生成能力が向上します。
しかし、MMLUはLLMの改善に有用ではあるものの、万能薬ではありません。LLMには、ベンチマークでどれほど高い性能を発揮しても、固有の限界があります。LLMは静的なオフラインデータセットで学習されており、リアルタイム情報やドメイン固有の情報にアクセスできません。これにより、モデルが不正確または捏造された回答を生成するハルシネーションにつながる可能性があります。こうした欠点は、独自情報に関するクエリや高度に専門化されたクエリに対応する際に、さらに問題となります。
RAGの紹介: LLMの応答を強化するソリューション
これらの課題に対処するために、Retrieval-Augmented Generation (RAG)は強力なソリューションを提供します。RAGは、大規模言語モデル(LLM)の生成能力と、MilvusやZilliz Cloudのようなベクトルデータベースに保存された外部ナレッジベースからドメイン固有の情報を取得する能力を組み合わせることで、LLMを強化します。ユーザーが質問すると、RAGシステムは関連情報をデータベースで検索し、その情報を使用してより正確な応答を生成します。RAGプロセスがどのように機能するか見てみましょう。
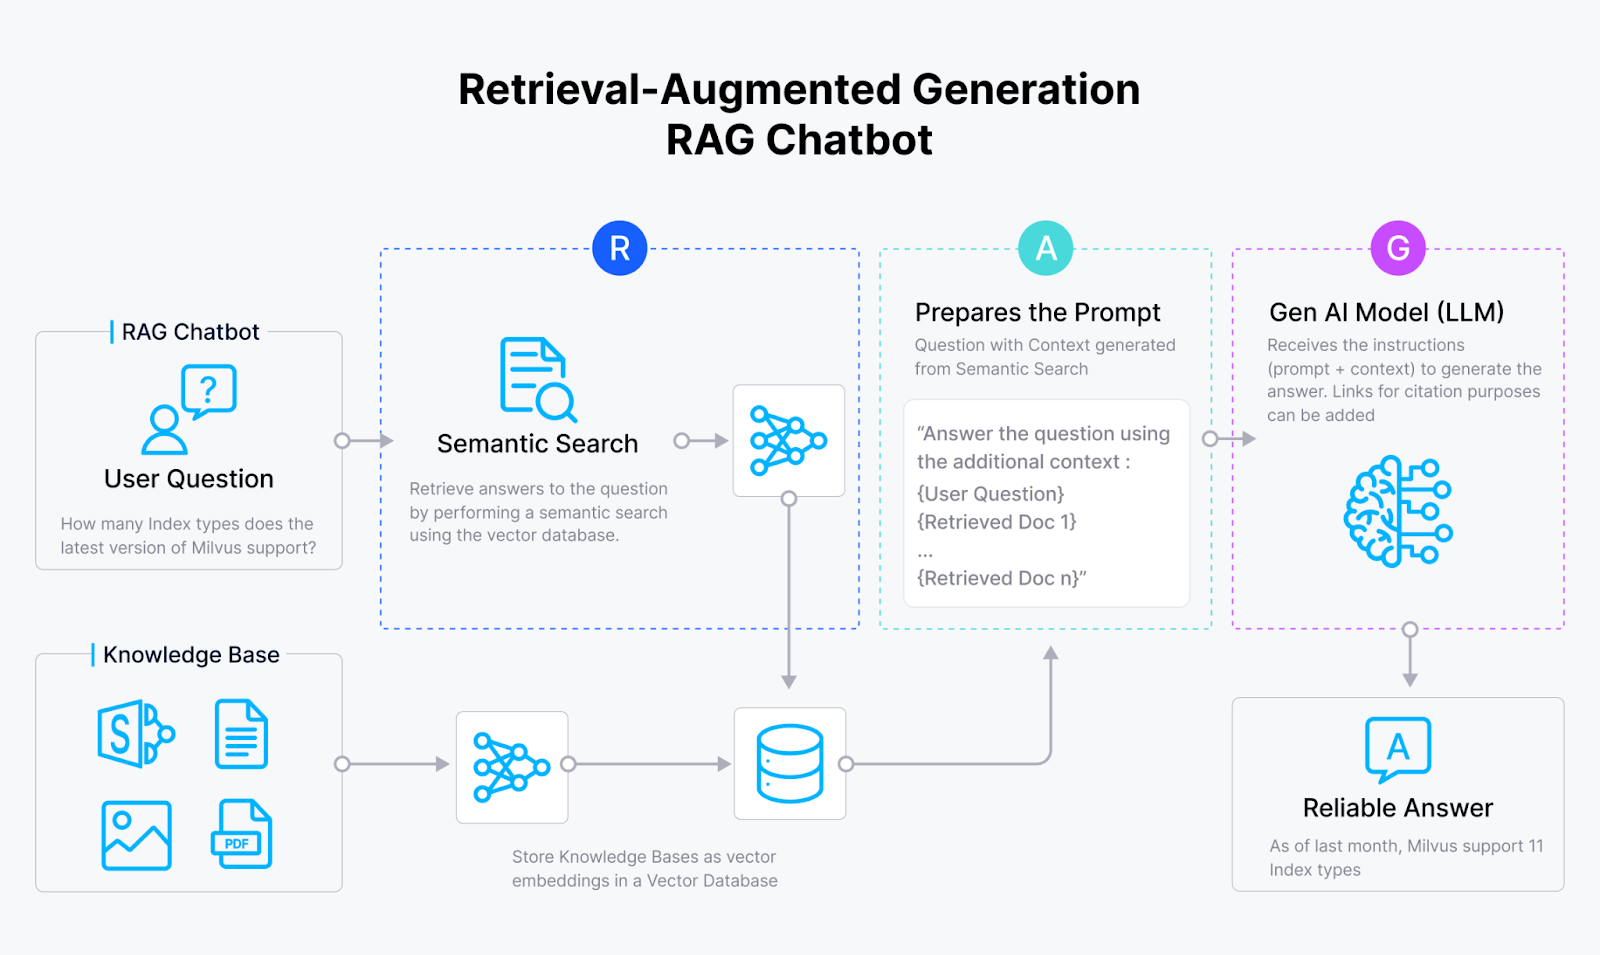 Figure- RAG workflow.png
RAGシステムは通常、埋め込みモデル、ベクトルデータベース、LLMの3つの主要コンポーネントで構成されます。
埋め込みモデルはドキュメントをベクトル埋め込みに変換し、それらはMilvusのようなベクトルデータベースに保存されます。
ユーザーが質問すると、システムは同じ埋め込みモデルを使用してクエリをベクトルに変換します。
その後、ベクトルデータベースは類似性検索を実行して、最も関連性の高い情報を取得します。この取得された情報は元の質問と組み合わされ、「コンテキスト付きの質問」を形成し、その後 LLM に送信されます。
LLM はこの強化された入力を処理して、より正確で文脈的に関連性の高い回答を生成します。
このアプローチは、静的な LLM とリアルタイムでドメイン固有のニーズとのギャップを埋めます。
結論
MMLU は、多様な分野や課題にわたって AI モデルのマルチタスク能力をテストするための強力なベンチマークです。実世界のシナリオにおける推論、知識検索、理解を評価することで、AI が達成できることの限界を押し広げます。Milvus のようなベクトルデータベースは、効率的なデータ検索と統合を通じて、AI モデルがこのようなベンチマークでより優れた性能を発揮できるよう支援するうえで重要な役割を果たします。
MMLU に関する FAQ
MMLU とは何ですか? MMLU は Massive Multitask Language Understanding の略で、AI モデルが複数の領域や科目にわたるタスクを処理する能力をテストするために設計されたベンチマークです。
AI 開発にとって MMLU が重要なのはなぜですか? MMLU は、多様な実世界のシナリオにおいてモデルが汎化し、性能を発揮する能力を評価し、研究者がより適応性が高く多用途な AI システムを作成するのに役立ちます。
MMLU にはどのような種類のタスクが含まれていますか? MMLU には、科学、人文学、法律、医学などの科目にわたって、推論、知識検索、理解をテストするタスクが含まれています。
MMLU の課題は何ですか? MMLU は、ドメインバイアス、質問における実世界の文脈の不足、進化する知識を反映するためにデータセットを更新する際のスケーラビリティなどの課題に直面しています。