MMLU Benchmark
Что такое MMLU?
MMLU (Massive Multitask Language Understanding) — это бенчмарк, разработанный для оценки многозадачных возможностей языковых моделей в различных предметных областях. Он охватывает 57 задач по темам, таким как гуманитарные науки, STEM, социальные науки и другие, с вопросами от элементарного до профессионального уровня. MMLU оценивает способность модели обобщать знания и рассуждать в широком спектре доменов, что делает его комплексным тестом для продвинутых языковых моделей. Высокие показатели в MMLU указывают на способность модели решать сложные реальные задачи, требующие широких знаний и контекстуального понимания.
Как работает MMLU?
MMLU использует серию вопросов с несколькими вариантами ответа для оценки способности модели ИИ обрабатывать различные типы информации и отвечать на них в области Natural Language Processing (NLP). Каждый вопрос проверяет когнитивные способности модели в трех основных областях: рассуждение, извлечение знаний и понимание.
Давайте обсудим, как тестируются эти компоненты:
Рассуждение
Задачи на рассуждение в MMLU требуют от модели применять логическое мышление и дедуктивные навыки, чтобы прийти к правильному ответу. Эти вопросы связаны не просто с воспроизведением фактов, а с анализом проблемы, выявлением закономерностей или формулированием выводов на основе предоставленной информации. Такие задачи проверяют способность модели к критическому мышлению и имитируют принятие решений, похожее на человеческое.
Например:
Вопрос на рассуждение в математике может требовать решения сложного уравнения или понимания геометрических взаимосвязей.
В гуманитарной дисциплине он может предполагать интерпретацию исторического события и выявление его последствий.
Извлечение знаний
Извлечение знаний оценивает способность модели получать доступ к сохраненной информации и использовать ее в различных предметных областях. Здесь акцент делается на фактической точности и на том, насколько хорошо модель может извлекать релевантную информацию из своих обучающих данных, имитируя то, как эксперт-человек извлекает знания из памяти. Вопросы составлены на основе общедоступных данных и охватывают такие темы, как наука, право и технологии.
Например:
В вопросе по биологии модели может потребоваться определить функцию клеточной органеллы.
Вопрос по истории может касаться значимых событий определенного периода.
Понимание
Задачи на понимание требуют от модели интерпретировать и понимать предоставленный материал, будь то текстовый фрагмент, набор данных или формулировка задачи. Вопросы на понимание гарантируют, что модель не просто запоминает факты, но также может осмысленно синтезировать и интерпретировать информацию.
Например:
В вопросе по литературе модель может анализировать короткий отрывок, чтобы сделать вывод о намерении или тоне автора.
Медицинский вопрос может включать интерпретацию симптомов для определения возможного диагноза.
Структура и сложность вопросов в MMLU
Каждый вопрос в MMLU имеет несколько вариантов ответа, обычно четыре или более, из которых модель должна выбрать правильный. Эта многоуровневая сложность обеспечивает оценку способностей модели в широком интеллектуальном спектре. Вопросы тщательно структурированы, чтобы отражать различные уровни сложности:
Базовые концепции: Эти вопросы охватывают фундаментальные знания, обычно преподаваемые на уровне старшей школы, такие как базовая математика, физика или история.
Промежуточное понимание: На этом уровне вопросы могут охватывать темы уровня бакалавриата и требовать более глубокого понимания предмета.
Продвинутая экспертиза: Эти вопросы имитируют задачи профессионального уровня, такие как диагностика медицинских случаев, решение инженерных задач или интерпретация правовых принципов.
Задачи, включенные в MMLU
Бенчмарк включает задачи, которые выходят за рамки простой проверки фактов или запоминания. Модели тестируются на:
Критическое мышление: Применение логики и рассуждений для поиска лучшего решения.
Предметно-специфические знания: Ответы на специализированные вопросы по биологии, физике или финансам.
Многозадачная адаптивность: Легкое переключение между темами без потери производительности.
Важность MMLU в развитии ИИ
MMLU — ключевой бенчмарк в исследованиях ИИ, поскольку он оценивает способность модели обобщать знания в нескольких областях.
Обобщение между областями
MMLU гарантирует, что модели ИИ не ограничиваются хорошей работой только в одной области, а могут плавно переходить между несвязанными темами. Например, модель может ответить на вопрос по биологии, а затем решить задачу по экономике. Эта способность к обобщению критически важна для создания систем ИИ, способных работать в многозадачных средах, таких как обслуживание клиентов или образовательные инструменты, где требуются разнообразные знания.
За пределами узких задач
Системы ИИ, тестируемые с помощью MMLU, должны выходить за рамки простых задач, таких как суммирование текста или определение тональности. Им предлагается выполнять более сложные рассуждения, извлекать конкретные знания и интерпретировать нюансированные сценарии. Например, вместо простого воспроизведения фактов модели может потребоваться применить логику для решения задачи по физике или вывести взаимосвязи в историческом контексте.
Расширение возможностей современных моделей ИИ
MMLU проверяет пределы возможностей современных языковых моделей, включая вопросы профессионального уровня в таких областях, как медицина, инженерия и право. Эти вопросы часто требуют специализированной экспертизы или рассуждений, выходящих за рамки поверхностного понимания. Например:
Юридический вопрос может касаться последствий конституционного принципа.
Медицинский вопрос может требовать диагностики симптомов на основе ограниченной информации.
Реальные применения MMLU
Здравоохранение: Модели MMLU могут помогать врачам, анализируя симптомы пациентов, предлагая потенциальные диагнозы и обобщая медицинскую литературу по вариантам лечения.
Образование: Персонализированные обучающие системы предоставляют адаптированные объяснения по таким предметам, как математика или история, а ИИ создает тесты и учебные материалы, подходящие для разных уровней обучения.
Юридическая отрасль: MMLU помогает в проверке контрактов, обобщении ключевых положений и проведении юридических исследований путем быстрого поиска соответствующих судебных прецедентов или законов. Он также помогает упрощать сложные юридические термины для лучшего понимания клиентами.
Поддержка клиентов: Многозадачные ИИ-агенты обрабатывают разнообразные запросы — от устранения технических проблем до решения вопросов оплаты, предоставляя при этом чуткие и точные ответы.
Бизнес и финансы: MMLU помогает создавать финансовые сводки, выявлять мошеннические действия и составлять предложения для клиентов, которые помогают бизнесу принимать обоснованные решения.
Наука и исследования: Поддерживает исследователей, синтезируя данные из разных областей, интерпретируя результаты и создавая технические резюме для грантовых заявок или публикаций.
Государственные услуги: MMLU улучшает государственные услуги, предоставляя информацию о юридических правах в режиме реального времени, анализируя государственную политику на наличие пробелов и поддерживая усилия по реагированию на чрезвычайные ситуации посредством координации ресурсов и точных обновлений.
Ограничения MMLU
Предметная предвзятость: Бенчмарк может отдавать предпочтение областям или темам, широко представленным в обучающих данных ИИ, что затрудняет оценку истинного обобщения.
Формат множественного выбора: Опора на вопросы с множественным выбором ограничивает оценку открытого рассуждения и креативности в системах ИИ.
Ограниченный реальный контекст: Несмотря на разнообразие, вопросы MMLU не содержат динамичных реальных сценариев, где могут потребоваться дополнительный контекст или взаимодействие.
Масштабируемость обновлений: Добавление новых предметов или обновление наборов данных для отражения меняющихся знаний может требовать значительных ресурсов и быть сложным в поддержке.
Языковой и культурный охват: Основное внимание часто уделяется англоязычным наборам данных, что может упускать из виду языковое и культурное разнообразие.
Искусственное завышение оценок: Модели, обученные непосредственно на похожих наборах данных, могут демонстрировать искусственно высокую производительность без подлинного улучшения понимания.
Оценка глубины и широты: Бенчмарк проверяет широту знаний, но может не полностью отражать глубину понимания в конкретных областях.
Различие между MMLU и одноцелевыми бенчмарками
Понимание различий между MMLU и одноцелевыми бенчмарками показывает, почему MMLU является более комплексным инструментом для оценки моделей ИИ. В то время как одноцелевые бенчмарки сосредоточены на конкретных способностях, MMLU побуждает модели обобщать и работать в различных предметных областях и задачах. В таблице ниже приведено наглядное сравнение.
| Характеристика | MMLU | Одноцелевые бенчмарки (например, GLUE, SuperGLUE) |
|---|---|---|
| Область оценки | Проверяет более 50 разнообразных предметов, охватывающих науки, гуманитарные и профессиональные области. | Сосредоточены на конкретных задачах, таких как анализ тональности, перефразирование или ответы на вопросы. |
| Тип задачи | Многозадачный: требует переключения между несвязанными областями и задачами. | Одноцелевая: каждый бенчмарк оценивает производительность в конкретной узкой задаче. |
| Практическая значимость | Отражает реальные сценарии, где необходима универсальность в разных областях. | Ограничены конкретными контролируемыми контекстами, которые могут не обобщаться на сложные сценарии. |
| Формат вопросов | В основном множественный выбор, охватывающий фактические знания, рассуждение и понимание. | Включают различные форматы, такие как сходство предложений, классификация текста и пары QA. |
| Уровень знаний | Вопросы варьируются от уровня старшей школы до продвинутой профессиональной экспертизы. | Обычно сосредоточены на стандартных уровнях понимания языка или конкретных наборах данных. |
| Проверка обобщения | Оценивает способность модели адаптироваться к ранее не встречавшимся задачам или областям. | Проверяет производительность модели в рамках заранее определенной области задачи без значительных смен домена. |
| Примеры бенчмарков | MMLU | GLUE, SuperGLUE, SQuAD, MNLI, CoLA. |
Таблица: MMLU против одноцелевых бенчмарков
Когда использовать бенчмарк MMLU
Бенчмарк MMLU целесообразно использовать в следующих сценариях:
Оценка возможностей обобщения: Используйте MMLU, чтобы оценить, насколько хорошо модель ИИ может обобщать свои знания по нескольким предметам. Это полезно для определения того, может ли модель справляться с разнообразными задачами за пределами областей, на которых она была явно обучена.
Тестирование многозадачной производительности: Если ваша цель — разрабатывать ИИ-системы, которые могут бесшовно переключаться между разными задачами или доменами, MMLU — подходящий бенчмарк. Он оценивает многозадачную адаптивность, предлагая моделям вопросы из различных дисциплин, таких как математика, история и право.
Измерение рассуждения и понимания: MMLU высокоэффективен для тестирования навыков рассуждения модели, способностей к пониманию и возможности извлечения знаний. Он ценен для задач, которые требуют логического мышления, понимания контекста и решения проблем.
Бенчмаркинг прогресса ИИ: Используйте MMLU, чтобы сравнить производительность вашей модели с другими моделями уровня state-of-the-art или человеческими базовыми показателями. Он предоставляет стандартизированную метрику для понимания того, где находится ваша модель с точки зрения реальных многозадачных возможностей.
Создание многодоменных приложений: Для ИИ-приложений, которым необходимо обрабатывать разнообразные и сложные запросы — таких как боты поддержки клиентов, образовательные инструменты или помощники по работе со знаниями, — MMLU помогает убедиться, что модель достаточно надежна и универсальна для практических сценариев использования.
Выявление слабых мест в моделях: MMLU — отличный диагностический инструмент для обнаружения пробелов в понимании вашей модели. Например, он может показать, испытывает ли ваша модель трудности с конкретными предметами, задачами на рассуждение или адаптацией к новым доменам.
Оценка языковых моделей с помощью MMLU и их улучшение с помощью RAG
Бенчмарк MMLU — важный инструмент для оценки возможностей больших языковых моделей (LLMs). Он предоставляет стандартизированную основу для измерения производительности модели в различных задачах и облегчает прямые сравнения между моделями. Подчеркивая сильные стороны, такие как рассуждение и воспроизведение фактов, и выявляя слабости, такие как трудности со сложным рассуждением или доменно-специфическими задачами, MMLU помогает исследователям определить области для улучшения. Эти инсайты позволяют выполнять дообучение, улучшая понимание модели и ее способности к генерации контента.
Однако, хотя MMLU ценен для улучшения LLM, он не является универсальным средством. У LLM есть внутренние ограничения, независимо от того, насколько хорошо они показывают себя на бенчмарках. Они обучаются на статических офлайн-наборах данных и не имеют доступа к информации в реальном времени или доменно-специфической информации. Это может приводить к галлюцинациям, когда модели генерируют неточные или вымышленные ответы. Эти недостатки становятся еще более проблематичными при работе с проприетарными или узкоспециализированными запросами.
Представляем RAG: решение для улучшения ответов LLM
Чтобы решить эти проблемы, Retrieval-Augmented Generation (RAG) предлагает мощное решение. RAG улучшает большие языковые модели (LLMs), сочетая их генеративные возможности со способностью извлекать доменно-специфическую информацию из внешних баз знаний, хранящихся в векторной базе данных, такой как Milvus или Zilliz Cloud. Когда пользователь задает вопрос, система RAG ищет в базе данных релевантную информацию и использует эту информацию для генерации более точного ответа. Давайте посмотрим, как работает процесс RAG.
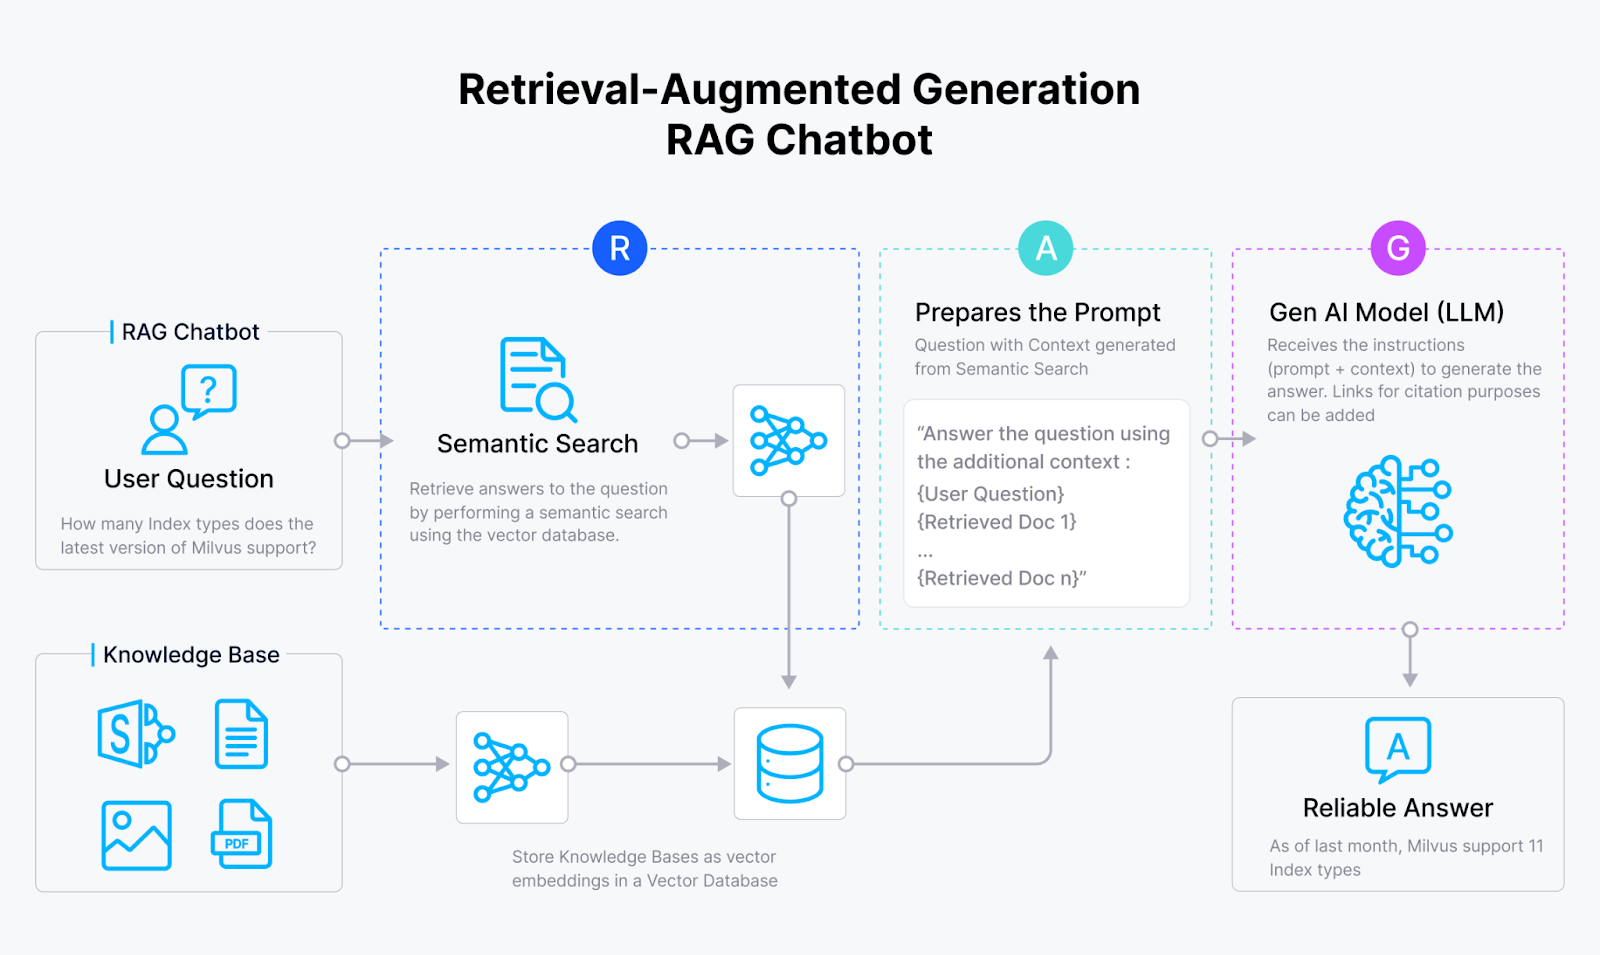 Figure- RAG workflow.png
Система RAG обычно состоит из трех ключевых компонентов: модели эмбеддингов, векторной базы данных и LLM.
Модель эмбеддингов преобразует документы в векторные эмбеддинги, которые хранятся в векторной базе данных, такой как Milvus.
Когда пользователь задает вопрос, система преобразует запрос в вектор с помощью той же модели эмбеддингов.
Затем векторная база данных выполняет поиск по сходству, чтобы извлечь наиболее релевантную информацию. Эта извлеченная информация объединяется с исходным вопросом, чтобы сформировать «вопрос с контекстом», который затем отправляется в LLM.
LLM обрабатывает эти обогащенные входные данные, чтобы сгенерировать более точный и контекстуально релевантный ответ.
Этот подход устраняет разрыв между статичными LLM и потребностями в реальном времени, специфичными для предметной области.
Заключение
MMLU — это мощный бенчмарк для тестирования многозадачных способностей моделей ИИ по различным предметам и задачам. Он расширяет границы того, чего может достичь ИИ, оценивая рассуждение, извлечение знаний и понимание в реальных сценариях. Векторные базы данных, такие как Milvus, играют важную роль в поддержке моделей ИИ, помогая им лучше справляться с такими бенчмарками благодаря эффективному извлечению и интеграции данных.
Часто задаваемые вопросы о MMLU
Что такое MMLU? MMLU расшифровывается как Massive Multitask Language Understanding — бенчмарк, предназначенный для проверки способности моделей ИИ выполнять задачи в различных доменах и предметных областях.
Почему MMLU важен для разработки ИИ? MMLU оценивает способность модели обобщать и работать в разнообразных реальных сценариях, помогая исследователям создавать более адаптивные и универсальные системы ИИ.
Какие типы задач включает MMLU? MMLU включает задачи, которые проверяют рассуждение, извлечение знаний и понимание по таким предметам, как естественные науки, гуманитарные науки, право и медицина.
Каковы сложности MMLU? MMLU сталкивается с такими сложностями, как предметная предвзятость, ограниченный реальный контекст в вопросах и масштабируемость для обновления наборов данных с учетом развивающихся знаний.