




深層強化学習(DRL)の理解:包括的ガイド
簡単な回答: 深層強化学習(DRL)はAIの一分野であり、エージェントが環境と相互作用し、フィードバックや「報酬」に基づいて時間とともに改善することで、意思決定の方法を学習します。DRLは、試行錯誤を通じた学習方法である強化学習(RL)と、画像やセンサー読み取り値のような複雑なデータをエージェントが扱えるようにする深層学習を組み合わせたものです。DRLは、深層ニューラルネットワークを使用して、高次元の入力を伴う複雑なタスクをエージェントにナビゲートさせることができます。環境の複雑さと変動性のために従来の学習手法が苦戦する、ロボティクスやゲームプレイのような用途で広く使用されています。
深層強化学習(DRL)の理解:包括的ガイド
2016年、AlphaGoが、宇宙に存在する原子の数よりも多い可能な手を持つゲームである囲碁で世界チャンピオンのイ・セドルを破ったとき、それはビジネステクノロジーにおける画期的な瞬間となりました。この勝利の裏にあった秘密は何だったのでしょうか? 深層強化学習——コンピューターに練習を通じて改善するよう訓練する手法であり、コートで何年もかけてサーブを完璧にするテニス選手に似ています。従来のコンピュータープログラムが予期しない変化に苦戦する一方で、この技術は、忙しい倉庫でロボットを誘導することから株式取引で迅速な意思決定を行うことまで、絶えず変化する状況で真価を発揮します。機械学習へのこの新しいアプローチは、通常のソフトウェアでは解決できないほど複雑だった問題に取り組み、企業に新たな可能性を開きます。
このガイドでは、深層強化学習について深く掘り下げ、主要な概念、さまざまな応用、利点、そして実装時に生じる可能性のある課題を取り上げます。
深層強化学習とは?
深層強化学習(DRL)は、2つの効果的なAI技術である強化学習(RL)と深層学習を組み合わせ、AIエージェントが複雑な環境で試行錯誤を通じて最適な行動を学習できるようにします。RLでは、エージェントは環境と相互作用し、長期的な報酬を最大化するために、報酬と学習戦略に基づいて自身の行動を調整します。深層学習は、ニューラルネットワークを使用して詳細な状態表現を扱う能力を追加します。
たとえば、迷路を進むロボットは最初はランダムに動きますが、時間が経つにつれて、フィードバックを通じて効率的に目標に到達することを学習します。DRLは、エージェントが動的な環境に適応し、詳細な指示なしに複雑な問題を解決するのに役立ちます。ビデオゲーム、自動運転車、パーソナルレコメンデーションで有用です。強化学習と深層学習を組み合わせることで、DRLエージェントは複雑な現実世界のタスクを効果的に扱うことができます。
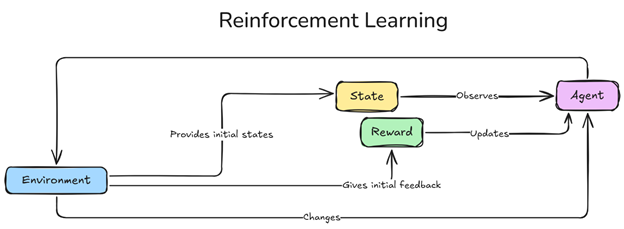 図1 強化学習フレームワーク.png
深層強化学習の仕組み
DRLの仕組みを理解するには、その主要な構成要素を知ることが重要です。
エージェント
環境
状態
行動と報酬
方策
エージェント
エージェントは、環境をナビゲートし、時間の経過とともに累積報酬を最大化するための選択を行う意思決定者です。繰り返される相互作用(学習エピソード)を通じて、エージェントはフィードバックに基づいて戦略を洗練し、長期的な成功を達成するために行動を調整します。ゲームのプレイヤーのように、エージェントの行動は方策、つまり性能を向上させ最適な結果に到達するために時間をかけて学習された一連のルールによって導かれます。
環境
環境とは、エージェントが動作する構造化された空間であり、可能な状態、行動、報酬を定義します。環境は各エージェントの行動に反応し、エージェントの将来の意思決定に影響を与え、その学習プロセスを形作るフィードバックを提供します。
状態
状態は、特定の瞬間における環境のスナップショットを表し、エージェントの意思決定に重要な情報を含みます。たとえば、状態には迷路内でのエージェントの位置や障害物、または車両の速度や他の車との近接度が含まれる場合があります。各状態は、エージェントが自分の状況を評価し、最も有利な行動を選択するのに役立ちます。
行動と報酬
行動は各状態におけるエージェントの選択を表し、環境内での進路を方向づけます。行動には次のものがあります。
離散行動: グリッド環境で上、下、左、右に移動するなどの限られた選択肢により、エージェントが探索し、方策を開発しやすくなります。
連続行動: 速度や角度の調整など、値の範囲を含むもので、複雑性の増大に対応するために高度なモデルを必要とします。
エージェントは、時間の経過とともに最適な行動を取り、報酬を最大化することを目指します。
報酬は、エージェントの学習を導くためのフィードバックを提供します。正の報酬は成功した行動を示し、負の報酬は誤りに罰を与えます。報酬には次のものがあります。
即時報酬: チェスで相手の駒を取って得点するように、行動の直後に直接与えられます。
遅延報酬: 迷路を進むことなど、一連の行動を完了した後に得られます。
報酬形成として知られる報酬構造を設計することが重要です。たとえば、複雑な経路上の中間報酬は学習を加速させ、エージェントが最終目標に向けて特定のステップを踏むよう動機づけることができます。
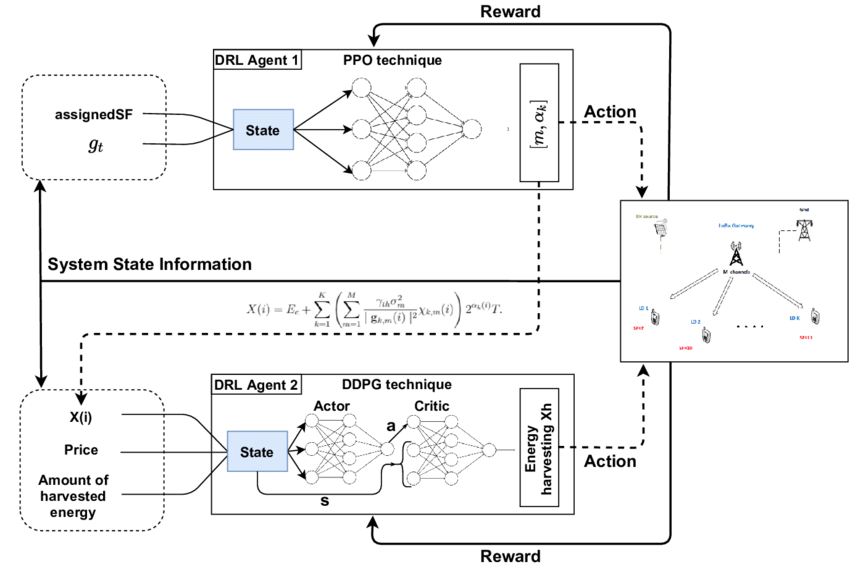 図- Reinforcement Learning architecture.png
図: 強化学習アーキテクチャ
学習プロセス
深層強化学習の学習または訓練プロセスは、以下を含む相互作用、フィードバック、改善の反復的なサイクルです。
探索
活用
Deep Neural Networks
逆伝播
探索
最初、エージェントは環境を知りません。ランダムに探索することから始め、さまざまな行動を試し、その結果を観察します。この探索フェーズは、環境情報を収集し、報酬の得られる行動を発見するために重要です。
活用
エージェントが探索して経験を蓄積するにつれて、正の報酬につながる行動を特定し始めます。その後、この知識を活用し、報酬を最大化するためにそれらの行動をより頻繁に選択します。
Deep Neural Networks
エージェントは深層ニューラルネットワークを使用して、エージェントの方策と価値関数を近似します。
方策ネットワーク: このネットワークは現在の状態を入力として受け取り、異なる行動を取る確率を出力します。
価値ネットワーク: このネットワークは、特定の状態にいることの長期的な価値を推定し、エージェントがより高い累積報酬につながる意思決定を行うのを助けます。これらのニューラルネットワークにより、エージェントは複雑な環境パターンや関係を学習でき、より知的な意思決定を行うのに役立ちます。
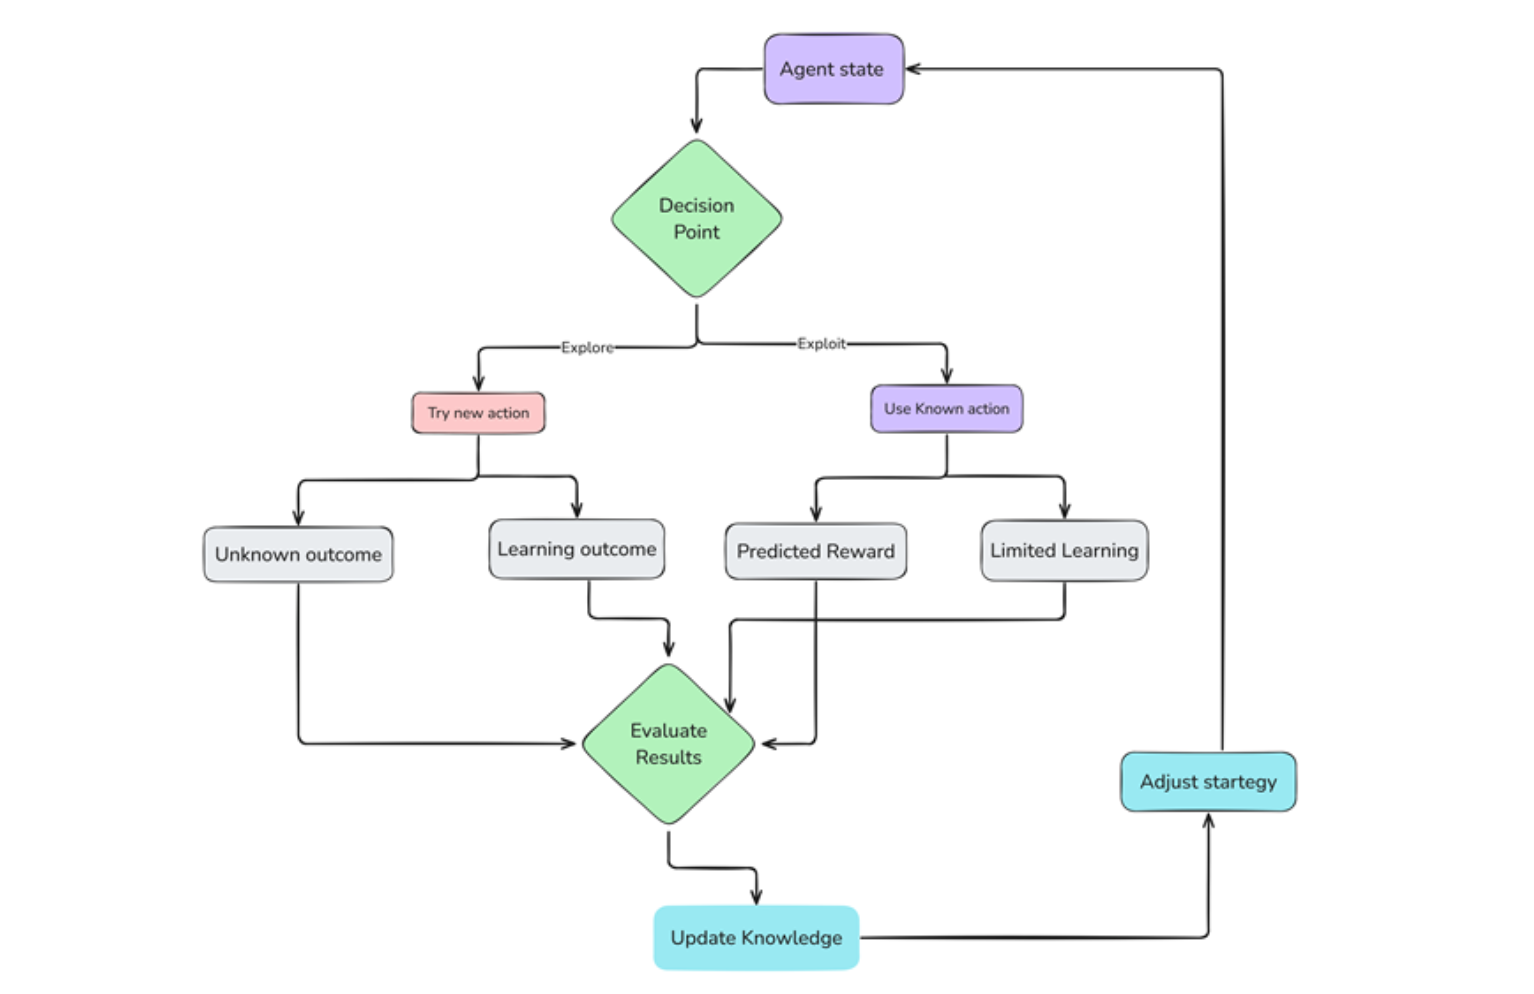 探索 vs 活用プロセス .png
図 3 探索 vs 活用プロセス
逆伝播
逆伝播は、「誤差の後方伝播」の略で、ニューラルネットワークの訓練における主要なアルゴリズムです。予測の誤差を最小化するために、ニューラルネットワーク内の重みを調整します。
バックプロパゲーションは、フィードバックから学習することで、エージェントが意思決定モデルを改善するのに役立ちます。エージェントが行動を取ると、その行動がどれほど良かったか、または悪かったかについてのフィードバック(報酬の形で)を受け取ります。バックプロパゲーションはその後、ニューラルネットワークの重みを調整し、予測された結果と実際の報酬との間の誤差を減らします。バックプロパゲーションを繰り返し適用することで、ニューラルネットワークは価値関数または方策関数をより適切に近似することを学習し、より正確な意思決定につながります。このプロセスにより、エージェントは環境に対する理解を徐々に改善し、時間とともにますます最適な意思決定を行えるようになります。これは、動的で高次元な複雑な環境における複雑なタスクを習得するために不可欠です。
深層強化学習における一般的なアルゴリズム
DRLは、学習プロセスにおけるさまざまな課題に取り組むよう設計された多様なアルゴリズムを採用しています。以下は、最も広く使用されている手法の一部です。
Q-Learning: Q-Learningは、基礎的な強化学習アルゴリズムの1つです。これは、Q値と呼ばれる状態-行動ペアの価値を推定し、エージェントが特定の状態でどの行動が望ましいかを判断するのに役立ちます。このアルゴリズムは、即時報酬と予想される将来の報酬に基づいてこれらのQ値を更新し、長期的な価値がより高い行動を優先するようにエージェントの選択を徐々に洗練します。
Deep Q-Networks (DQN): DQNは、ニューラルネットワークを利用してQ値を近似することでQ-learningを強化します。このアプローチにより、DQNはゲームAI、ロボットナビゲーション、自動運転などの複雑な環境で効果を発揮します。
Policy Gradients: 価値ベースの手法とは異なり、方策勾配アルゴリズムは、受け取った報酬に基づいてニューラルネットワークの重みを調整することで、エージェントの方策を直接最適化します。このアプローチにより、成功する行動の可能性を高めることでエージェントは性能を向上させることができます。これは、ロボットアームの操作など、精密な調整を必要とする制御タスクにおいて特に重要です。
Actor-Critic Methods: ハイブリッドアプローチは、特定の状態における各行動の価値を推定することを目的とする方策ベースの手法と、最適な方策を直接学習することに焦点を当てる価値ベースの手法の強みを組み合わせます。この枠組みでは、actorが行動の選択を担当し、criticがこれらの行動を評価してフィードバックを提供します。このフィードバックにより、方策の継続的な改善が可能になります。
深層強化学習と他の概念の比較
深層強化学習(DRL)は、他のAIアプローチとよく比較されます。違いと類似点を明確にするために、重要な側面を分解して見てみましょう。
| 側面 | 深層強化学習(DRL) | 通常の強化学習(RL) | 教師あり学習 | 教師なし学習 | |
| 中核概念とデータ処理 | RLと深層ニューラルネットワークを組み合わせる;高次元で複雑なデータを処理する | より単純なモデルによるRLに焦点を当てる;低次元環境でうまく機能する | 事前定義された出力を持つラベル付きデータから学習する;ラベル付きデータセットに依存する | ラベルなしデータのパターンを見つける;ラベルなしデータセットを扱う | |
| 学習プロセス | 環境との相互作用を通じた試行錯誤。 | 環境からのフィードバックを通じた試行錯誤。 | ラベル付きの入力・出力ペアからパターンを学習する。 | データ内のクラスターまたは構造を特定する。 | |
| 目標 | 時間の経過とともに累積報酬を最大化する。 | 時間の経過とともに累積報酬を最大化する。 | 入力データに基づいて出力を予測する。 | データ内の隠れたパターンやグループ化を発見する。 | |
| 応用分野 | 複雑なタスク:ゲームAI、ロボティクス、自動運転車。 | 基本的な制御システムと単純な意思決定タスク。 | 分類、回帰、予測モデリング。 | クラスタリング、次元削減、異常検知。 |
深層強化学習の利点と課題
深層強化学習には多くの可能性がありますが、何に優れていて、どこで不足する可能性があるのかを知ることが重要です。DRLの主な利点と課題をいくつか見てみましょう。
利点:
適応性: DRLの重要な利点の1つは、その適応性です。DRLエージェントは、追加のプログラミングを必要とせずに、新しく予期しない状況に対応できます。たとえば、DRLを搭載した自動運転車は、障害物や悪天候などの突然の道路状況の変化に対応し、安全に走行できるように挙動を調整できます。
最適な意思決定: DRLはまた、より賢く、しばしばより効果的な意思決定を可能にします。従来のルールベースのシステムとは異なり、DRLモデルは人間の設計者でさえ見落とす可能性のある戦略を発見できます。たとえば金融分野では、DRLは従来のシステムよりも頻繁に高い利益を生む判断を行う取引ボットの作成に成功裏に適用されています。
自動化の可能性: DRLは、物品の移動、医療、顧客支援などの分野におけるタスクの自動化を可能にします。これらの多くの場合複雑で常に変化する領域において、DRLは自動化によって物事をより容易にするのに役立ちます。
課題:
サンプル効率: DRLにおける最大の課題の1つは、大量の訓練データを必要とすることです。DRLモデルは通常、良好に機能するために広範なデータを必要とし、それを収集するには費用と時間がかかる場合があります。経験再生のような手法は、モデルが過去のデータから学習できるようにすることで役立ちますが、DRLをより実用的にするには、データ効率のさらなる改善が依然として必要です。
報酬設計: もう1つの課題は、効果的な報酬関数を設計することにあります。適切な報酬を設定することは非常に重要です。なぜなら、設計の悪い報酬は、意図しない、時には問題のあるエージェントの行動につながる可能性があるからです。その結果、DRLにおける報酬設計には、エージェントが意図された目標に沿った方法で行動するようにするための慎重な計画が必要です。
安定性と収束: 最後に、DRLの訓練は不安定になることがあります。時には、モデルが理想的とは言えない戦略にはまり込んだり、安定した解に到達できなかったりします。訓練の安定性を向上させることは、特に一貫性が重要となるハイステークスな用途において、DRLモデルをより信頼できるものにするために不可欠です。
深層強化学習の実世界での応用
深層強化学習(DRL)の仕組みを見てきたところで、次はその実用的な応用に焦点を移しましょう。DRLは、さまざまな領域で実世界の問題を解決するために使用されています。以下が含まれます:
ゲームプレイ: DRLは、チェス、囲碁、Dota 2のようなゲームで優れた性能を発揮する高度なAIエージェントの作成を可能にしました。実践的な探索に関心のある人にとって、Unity ML-Agentsはゲームベースの学習を試すための利用しやすいツールキットを提供します。
ロボティクス: ロボティクスでは、DRLは移動や物体の取り扱いなどの機械スキルを教えます。DRLは倉庫で非常に効果的であることが示されており、ロボットが新しいレイアウトや変化するタスクに適応できるようにし、業務の効率を高めます。
自動運転車: 自動運転車では、DRLは車線変更、障害物の回避、速度調整のための瞬時の判断において重要な役割を果たします。たとえばWaymoは、複雑な交通状況で車両が安全な選択を行えるようにDRLを使用しています。
金融取引: DRLはまた、市場の変化に対応する取引ボットを開発するために金融分野で広く使用されています。Deep Q-Learningのようなアプローチを用いて、DRLを搭載した取引ボットは過去の傾向とライブデータを分析し、情報に基づいた買い、保有、または売りの判断を行い、多くの場合、手動の取引戦略よりも良い結果を達成します。
パーソナライズされたレコメンデーション: DRLは、ますます高度化するレコメンデーションシステムを支えています。個別に最適化されたレコメンデーションを提供するために、DRLアルゴリズムはストリーミングサービス、オンラインストア、ソーシャルメディアプラットフォーム上でのユーザーの行動や好みを分析します。ユーザーの行動を観察することで、DRLは個人の好みにより密接に合致するコンテンツや製品を推薦できます。
深層強化学習に関するFAQ
- 深層強化学習では、エージェントはどのように学習しますか?
DRLでは、エージェントは環境内で行動を取り、報酬という形でフィードバックを受け取ることで学習します。エージェントは、有効な戦略を見つけるために探索(新しい行動を試すこと)を使い、報酬を最大化するために活用(既知の行動を使うこと)を使います。深層ニューラルネットワークは、エージェントが経験から汎化し、複雑なシナリオに適応するのを助けます。
- 深層強化学習モデルは、探索と活用のバランスをどのように取りますか?
DRLモデルは、epsilon-greedyやThompson Samplingのようなアルゴリズムを通じて、探索(より良い戦略を見つけるために新しい行動を試すこと)と活用(報酬を最大化するために既知の行動を使うこと)のバランスを取ります。これらの手法はバランスを維持し、エージェントが既知の報酬を最大化しながら新しい戦略を発見できるようにします。
- 深層強化学習では、価値関数はどのように機能しますか?
価値関数は、ある状態にいること(状態価値関数)または特定の状態で特定の行動を取ること(行動価値関数)によって期待される報酬を推定します。これにより、エージェントはより高い報酬につながる状態や行動を優先でき、意思決定を導きます。
- AIアプリケーションにおいて、DRLをMilvusとどのように併用できますか?
Milvusは、DRLエージェントによって生成される高次元の状態表現を保存および管理できます。過去の経験のリプレイバッファとして機能したり、状態表現の保存を支援したりすることで、方策最適化と価値推定の効率を高めます。
- 深層強化学習を使用する際の倫理的懸念は何ですか?
倫理的懸念には、訓練データに含まれる潜在的なバイアス、不適切に設計された報酬関数から生じる意図しない行動、機微な用途における公平性の問題が含まれます。これらのリスクを軽減するには、堅牢なテスト、透明性、説明可能なAIを実装することが重要です。
関連リソース
さらに詳しく調べるには、以下のリソースを検討してください。