グラフィカル・デザイナーのための知的類似性検索システム
ベクターデータベースを使用して、デザイン資産の類似検索システムを構築する方法をご紹介します。

*この記事はアンジェラ・ニーが転記したものです。
グラフィカルデザイナーは通常、広告ポスター、プロモーションビデオ、パンフレットなど、印刷媒体や電子媒体向けのあらゆる種類のビジュアル資産を革新的に作成する必要があります。多くの場合、グラフィカル・デザイナーは魅力的な画像やビデオを作るために、流行のビジュアル要素やテキストさえも一緒に組み立てなければなりません。似たようなビジュアルアセットを探すことは、デザイナーにとって良いインスピレーションの源になるかもしれない。
多くの画像や動画の類似検索システムからヒントを得て、すべてのデザイン資産に対して統合された類似検索システムを構築し、グラフィカルデザイナーにより革新的なアイデアをもたらすこともできる。このタイプの類似検索システムは、画像、ビデオクリップ、テキストを含むすべてのデザイン資産を収集する中心的なハブです。デザイナーが画像をシステムにアップロードすると、システムは類似した画像やビデオクリップ、テキストを複数返します。そして、デザイナーはそのアセットを活用して、自身のクリエイションを充実させることができる。
システムの実装
システム・アーキテクチャ](https://assets.zilliz.com/graphical_design_1_ccc97fdd51.png)
上の図は、グラフィカル・デザインのための類似検索システムのアーキテクチャの説明図である。最下層では、画像、動画、テキストをベクトルに変換するために特定のAIモデルを使用します。また、オープンソースの機械学習パイプラインであるTowheeを使って、非構造化データを埋め込みデータにエンコードすることもできる。そして、オープンソースのベクトルデータベースであるMilvusをベクトル管理とベクトル類似検索のために採用する。また、画像や動画の対応情報を保存するために、Redisキャッシュレイヤーを導入しています。これらの情報は、情報検索の高速化のため、KV(キー・バリュー)の形でRedisに格納される。
Webアプリケーション・サービスに関しては、ユーザーの多くがPython言語に精通していることを考慮し、Nginx、Flask、Gunicorn、supervisorを使用した。
適切なインデックスの選択
今回は、限られたリソースで高速なクエリが保証されるインデックスタイプ IVF_PQ を選択することにした。PQ(Product Quantization) は、元の高次元ベクトル空間をm` 個の低次元ベクトル空間のデカルト積に一様に分解し、分解した低次元ベクトル空間を量子化する。積量子化により、対象ベクトルと全ユニットの中心との距離を計算する代わりに、対象ベクトルと各低次元空間のクラスタリング中心との距離を計算することが可能となり、アルゴリズムの時間的複雑性と空間的複雑性を大幅に削減することができる。
IVF_PQ は,ベクトルの積を量子化する前にIVFインデックスクラスタリングを行います.そのインデックスファイルはIVF_SQ8よりもさらに小さい。欠点は、それに応じて再現率が低下することである。
IVF_PQ インデックス](https://assets.zilliz.com/image_d68d13de13.png)
Milvus doc](https://milvus.io/docs/v2.0.0/index_selection.md#IVF_PQ)による、
- A = 単一セグメントの計算で、
ターゲットベクトル量* (nlist+ (セグメント内のベクトル量) /nlist) に等しい。*nprobe) に等しい。 - B= セグメントの数。これは
総データ量/index_file_sizeに等しい。 - コレクションのクエリの計算は A * B に等しい。
したがって、今回のケースでは、インデックスパラメーターの適切な値は
nlist=1024,m=8 となる。
ベクトル類似検索の高速化のためのパーティションの使用
検索効率を大幅に向上させるためには、パーティションが必要である。ベクトルデータは,その特徴量のデカルト積の値に基づいて,異なるパーティションに挿入される.
例えば、あるベクトルの対応する項目が2つの特徴を持っているとする。特徴Aに基づいて、データセットをA1, A2, A3, A4に分割する。特徴Bに基づいて、データセットをB1, B2, B3に分割する。そして12のパーティションを作り、A1_B1, A1_B2, A1_B3, A2_B1, A2_B2, A2_B3, ......, A4_B3, A4_B3と名付ける。各パーティションは500万ベクトル以下であり、検索性能の向上に寄与する。
注目すべきは、パーティションを作成する際の特徴は簡単に変わるものであってはならないということである。そうでなければ、パーティションを作り直し、データをインポートし直し、インデックスを再構築しなければならず、プロセス全体が複雑になってしまう。また、あまりに多くの機能に基づいてパーティションを作りすぎるのも避けるべきだ。さもないと、各フィーチャーの値を乗算して生成されるデカルト積が非常に大きくなってしまいます。フィルタリングの代替として、Milvusのハイブリッド検索の機能を活用することができます。
ベクトル類似検索 powered by Milvus
検索結果はリアルタイムで返されることが予想されるため、システムは高い並行性に対応する必要があります。そこで、オープンソースのベクトルデータベースであるMilvusをベクトル類似検索に採用することにしました。すぐに使える機能を備えたMilvusは使いやすい。また、システムパラメータを設定することにより、検索精度とリソース消費のトレードオフをサポートする。
さらに、Milvusはvector、Int、Bool、floatなどの複数のデータ型をサポートしています。Milvusでは、特定の条件で検索結果をフィルタリングしながら類似資産を検索するハイブリッド検索も可能です。
パフォーマンス
テストの結果、類似検索システムのパフォーマンスは以下の通りです。
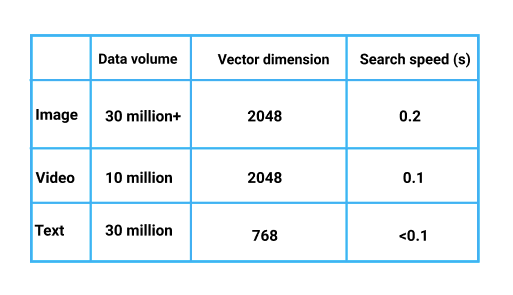 Performance
より多くのリソースをお探しですか?
- ベクトル類似検索のより多くの産業への応用:
- 画像ベースの商標類似検索システム](image-based-trademark-similarity-search-system):知的財産権保護のよりスマートなソリューション](image-based-trademark-similarity-search-system)
- ベクトル類似検索であなたのワードローブを持続可能にする方法](vector-similarity-search-and-fashion)
 James ZhangAlgorithm Engineer at Meetsocial Group