Llama2
Llama 2とは?
2023年にMeta AIによって導入されたLlama 2は、大規模言語モデル(LLM)における重要な進歩です。これらのモデルであるLlama 2とLlama 2-CHATは、最大700億パラメータまでスケールし、研究および商用目的で無償利用でき、テキスト生成からプログラミングコードの解釈まで、自然言語処理(NLP)能力の飛躍的な進歩を示しています。
非商用ライセンスの下で当初は研究機関のみがアクセス可能だった前身のLLaMa 1を基盤として、Llama 2は最先端AI技術へのアクセスを民主化する方向への重要な転換を示しています。前身とは異なり、Llama 2モデルは「オープンソース」であり、研究および商用アプリケーションに自由に利用できるため、より包摂的で協調的な生成AIエコシステムを育成するというMetaのコミットメントを反映しています。
Llama 2のリリースは、最先端のLLMへのアクセスを提供し、その開発に伴う計算上の課題に対処します。パラメータ数を指数関数的に増やすことなく性能を最適化することで、Llama 2は70億から700億までのさまざまなパラメータサイズのモデルを提供します。この戦略的アプローチにより、小規模な組織や研究コミュニティでも、法外な計算資源なしにLLMの力を活用できます。
さらに、Llama 2のコードとモデル重みの両方を公開するというMetaの決定には、透明性への同社の献身が明確に表れており、AI研究コミュニティ内でのより深い理解と協働を促進します。参入障壁を下げ、アクセシビリティを促進することで、Llama 2はAI研究開発における、より包摂的で革新的な未来への道を切り開きます。
Llama 2
Llama 2は、公開データの新しい組み合わせで学習されたLlama 1の更新版です。事前学習データセットは40%増加し、コンテキスト長は2倍になり、MetaチームはLlama 2を構築する際にgrouped-query attentionを採用しました。
| 学習データ | パラメータ | コンテキスト長 | Group-query attention | トークン | |
| Llama 1 | Touvron et al.(2023)を参照 | 7B | 2K | - | 1.0T |
| 13B | 2K | - | 1.0T | ||
| 33B | 2K | - | 1.4T | ||
| 65B | 2K | - | 1.4T | ||
| Llama 2 | 公開されているオンラインデータの新しい組み合わせ | 7B | 4K | - | 2.0T |
| 13B | 4K | - | 2.0T | ||
| 34B | 4K | ✓ | 2.0T | ||
| 70B | ✓ | 2.0T |
Llama 2-CHAT
Llama 2-CHATは、Metaチームが自然言語のユースケース向けに最適化した、Llama 2のファインチューニング版です。このモデルのバリアントは、7B、13B、70Bのパラメータで利用できます。Llama 2-Chatは、事前学習後に知識更新が停止すること、根拠のない助言など事実に基づかない生成の可能性、ハルシネーションを起こしやすい傾向など、他のLLMと同様によく認識されている制限の対象となります。
Llama 2 open source
Metaは研究および商用目的のためにLlama 2モデルの開始コードとモデル重みに寛大にもアクセスを提供していますが、そのライセンス契約に記載された特定の制限により、これを「open source」と呼ぶことの妥当性について議論が生じています。
Llama 2のライセンス条件の分類をめぐる議論は、技術的および意味的なニュアンスにかかっています。「open source」は、自由にアクセス可能なソースコードを持つあらゆるソフトウェアを指す口語表現として一般的に使われますが、Open Source Initiative (OSI) によって監督される正式な指定としては特定の意味を持ちます。「Open Source Initiative approved」として認められるには、ソフトウェアライセンスは公式のOpen Source Definition (OSD) に示された10の基準に準拠する必要があります。
そのため、Llama 2モデルに「open source」というラベルを適用できるかどうかは、そのライセンス条件がOSIによって定められた厳格な基準に合致しているかに依存します。この区別は、より広範な開発コミュニティ内でソフトウェアリソースのアクセシビリティと配布について議論する際に、明確さと正確さが重要であることを強調しています。
しかし、Llama 2は完全にオープンソースではないものの、OpenAI、Google、および生成AI分野の他の主要プレイヤーが作成したクローズドモデルよりもはるかに高い柔軟性を備えた魅力的なモデルを開発者に提供しています。
Llama 2 Architecture
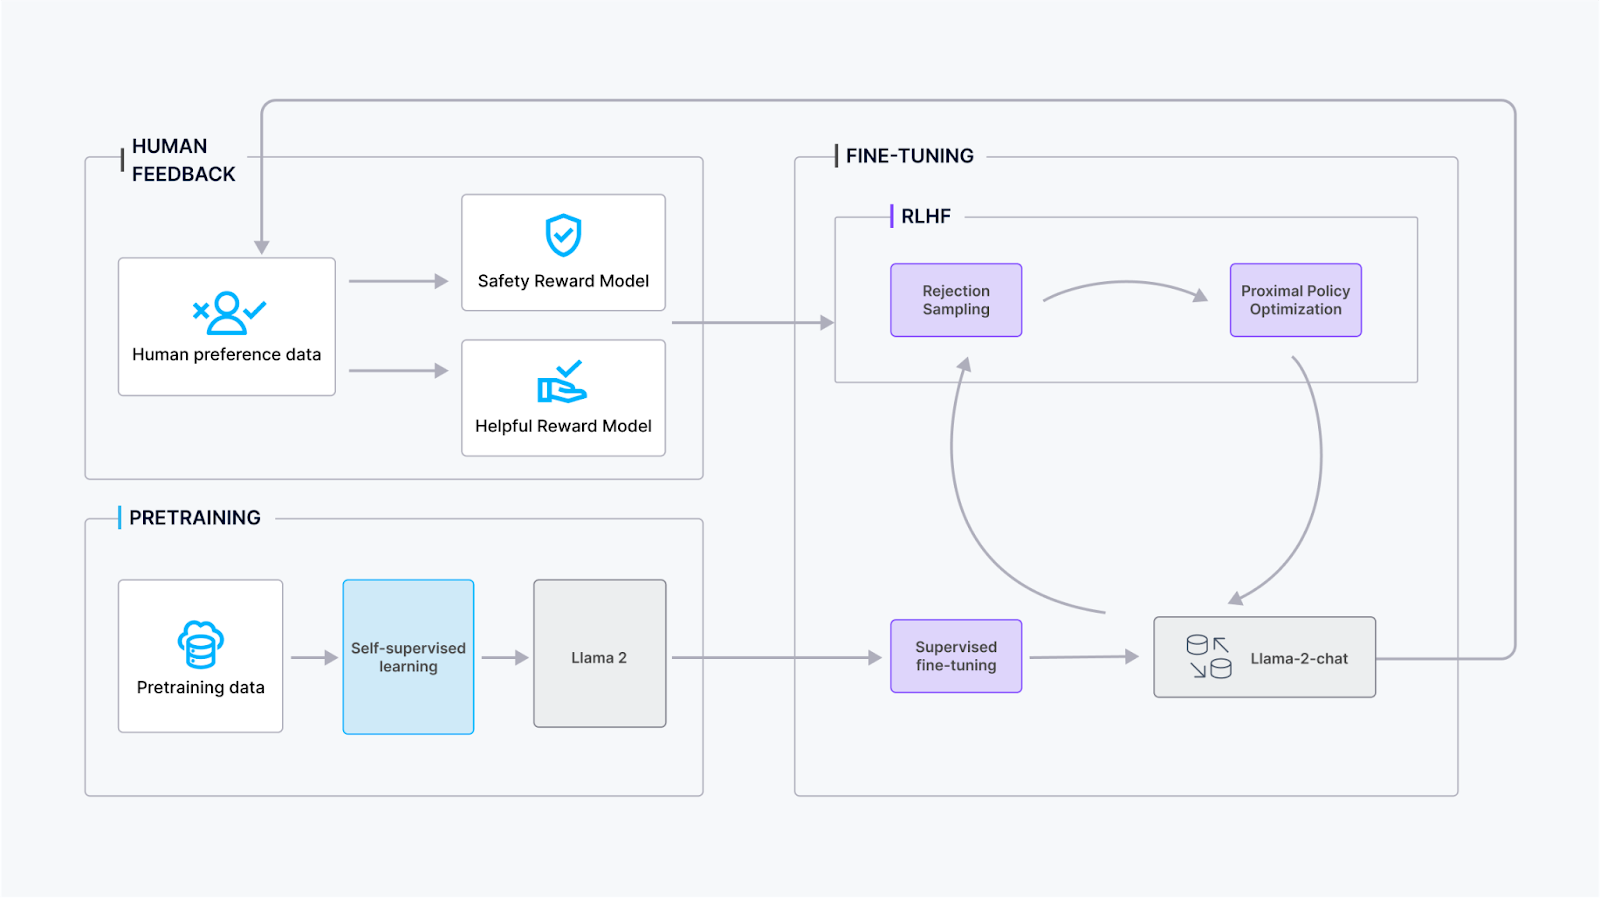
Llama 2-Chatのトレーニングプロセスには、最適な性能と洗練を確保するためにいくつかの段階が含まれます。
Pretraining: Llama 2は、基礎知識と言語理解を確立するために、公開されているオンラインソースを用いて事前学習を行います。
Supervised Fine-Tuning: Metaチームは、教師ありファインチューニングを通じてLlama 2-Chatの初期バージョンを作成しました。この段階では、モデルがラベル付きデータから学習し、会話能力を向上させます。
Reinforcement Learning with Human Feedback (RLHF): モデルは、主にリジェクションサンプリングとProximal Policy Optimization (PPO) を通じて、RLHF手法を用いた反復的な改良を受けます。この段階では、会話品質を向上させるために、人間のフィードバックとの継続的な相互作用が含まれます。
Iterative Reward Modeling: RLHF段階全体を通じて、反復的な報酬モデリングデータの蓄積がモデルの強化と並行して行われます。反復的な報酬モデリングにより、報酬モデルが分布内に保たれ、モデルの会話能力を一貫して向上させることに貢献します。
これらのステップを組み込むことで、Llama 2-Chatのトレーニングは、ユーザーフィードバックに適応し、報酬モデルとの整合性を維持しながら、堅牢な会話性能を達成することを目指しています。
機械学習におけるEmbeddingとは?
機械学習において、embedding とは、単語、画像、エンティティなどのオブジェクトを連続ベクトル空間内で学習された表現として表すものを指します。これらの埋め込みは、オブジェクト間の意味的関係や類似性を捉えるため、計算タスクにより適したものになります。natural language processing (NLP) では、たとえば単語埋め込みは、語彙内の単語を高次元空間内の密なベクトルにマッピングし、類似した単語同士が互いに近くなるようにします。
Llama 2では、埋め込みは自然言語を理解し生成するうえで重要な役割を果たします。Llama 2は、単語、フレーズ、または文全体を連続ベクトル空間で表現するために埋め込みを使用します。Llama 2は、意味的関係やニュアンスを捉えながら、言語の入力と出力を埋め込むことで、テキストを効果的に処理および生成できます。
たとえば、Llama 2は学習プロセス中に、学習対象となる膨大なテキストコーパスから単語やフレーズの埋め込みを学習します。これらの埋め込みは言語に関する意味情報をエンコードし、Llama 2がクエリやプロンプトに対して一貫性のある応答を理解し生成できるようにします。
Llama 2で使用されるものを含む機械学習における埋め込みは、言語やその他のデータを構造化され意味的に有意義な方法で表現することを容易にし、自然言語の効果的な処理、理解、生成を可能にします。
Llama 2の使い方は?
Llama 2を効果的に使用するには、提供されているインターフェースまたはAPIを通じてモデルにアクセスし、権限が整っていることを確認します。テキスト、画像、または互換性のある形式などの入力データを準備し、必要に応じて前処理します。テキスト生成や要約など、Llama 2に実行させるタスクを指定します。前処理済みデータをLlama 2に入力し、出力を取得して、その品質を評価します。結果を最適化するために、さまざまな形式や構成を試します。精度や速度などのパフォーマンス指標を監視し、フィードバックに基づいて戦略を調整します。効果を最大化するために機能強化の最新情報を把握し、プロジェクトやアプリケーションの新たな可能性を引き出します。 RAGアプリケーションを構築する際には、LangChain、LlamaIndex、Semantic KernelのようなツールとともにLlama 2を使用することもできます。
Llama 2のパフォーマンス
全体的なパフォーマンスは、いくつかの一般的な集約ベンチマークを見ることで確認できます。以下は、LLama 2論文に記載されている、オープンソースベースのモデルと比較したパフォーマンス結果の表です。
| モデル | サイズ | コード | 常識推論 | 世界知識 | 読解力 | 数学 | MMLU | BBH | AGI Eval |
| MPT | 7B | 20.5 | 57.4 | 41.0 | 57.5 | 4.9 | 26.8 | 31.0 | 23.5 |
| 30B | 28.9 | 64.9 | 50.0 | 64.7 | 9.1 | 46.9 | 38.0 | 33.8 | |
| Falcon | 7B | 5.6 | 56.1 | 42.8 | 36.0 | 4.6 | 26.2 | 28.0 | 21.2 |
| 40B | 15.2 | 69.2 | 56.7 | 65.7 | 12.6 | 55.4 | 37.1 | 37.0 | |
| Llama 1 | 7B | 14.1 | 60.8 | 46.2 | 58.5 | 6.95 | 35.1 | 30.3 | 23.9 |
| 13B | 18.9 | 66.1 | 52.6 | 62.3 | 10.9 | 46.9 | 37.0 | 33.9 | |
| 33B | 26.0 | 70.0 | 58.4 | 67.6 | 21.4 | 57.8 | 39.8 | 41.7 | |
| 65B | 30.7 | 70.7 | 60.5 | 68.6 | 30.8 | 63.4 | 43.5 | 47.6 | |
| Llama 2 | 7B | 16.8 | 63.9 | 48.9 | 61.3 | 14.6 | 45.3 | 32.6 | 29.3 |
| 13B | 24.5 | 66.9 | 55.4 | 65.8 | 28.7 | 54.8 | 39.4 | 39.1 | |
| 33B | 27.8 | 69.9 | 58.7 | 68.0 | 24.2 | 62.6 | 44.1 | 43.4 | |
| 65B | 37.5 | 71.9 | 63.6 | 69.4 | 35.2 | 68.9 | 51.2 | 54.2 |
Llama 2は、MMLUやBBHのような多くのカテゴリでLlama 1を上回っており、Falconモデルに対しても優れた成果を示していることがわかります。
Llama 2 vs GPT 4
Llama 2 の論文では、以下に示すように、Llama 2 と GPT 4、およびその他いくつかとの比較も扱っています。
| ベンチマーク(ショット数) | GPT-3.5 | GPT-4 | PaLM | PaLM-2-L | Llama 2 |
| MMLU(5ショット) | 70.0 | 86.4 | 69.3 | 78.3 | 68.9 |
| TriviaQA(1ショット) | — | — | 81.4 | 86.1 | 85.3 |
| Natural Questions(1ショット) | — | — | 29.3 | 37.5 | 33.0 |
| GSM8K(8ショット) | 57.1 | 92.0 | 56.5 | 80.7 | 56.8 |
| HumanEval(0ショット) | 48.1 | 67.0 | 26.2 | — | 29.9 |
| BIG-Bench Hard(3ショット) | — | — | 52.3 | 65.7 | 51.2 |
- MMLU(5-shot):モデルには、応答を生成するために5つの文章または例が与えられます。
- TriviaQA(1-shot):モデルが回答を生成する前に、単一のコンテキストまたは質問が提供されるデータセットです。
- Natural Questions(1-shot):モデルに1つの質問が入力として与えられる別のデータセットです。
- GSM8K(8-shot):モデルに、質問に答えたりタスクを実行したりするための8つの文章または例が与えられるデータセットです。
- HumanEval(0-shot):モデルが明示的に学習していないタスクや質問で評価されるデータセットまたは評価設定であり、そのため「0-shot」と呼ばれます。
Zilliz は Llama 2 と連携しますか?
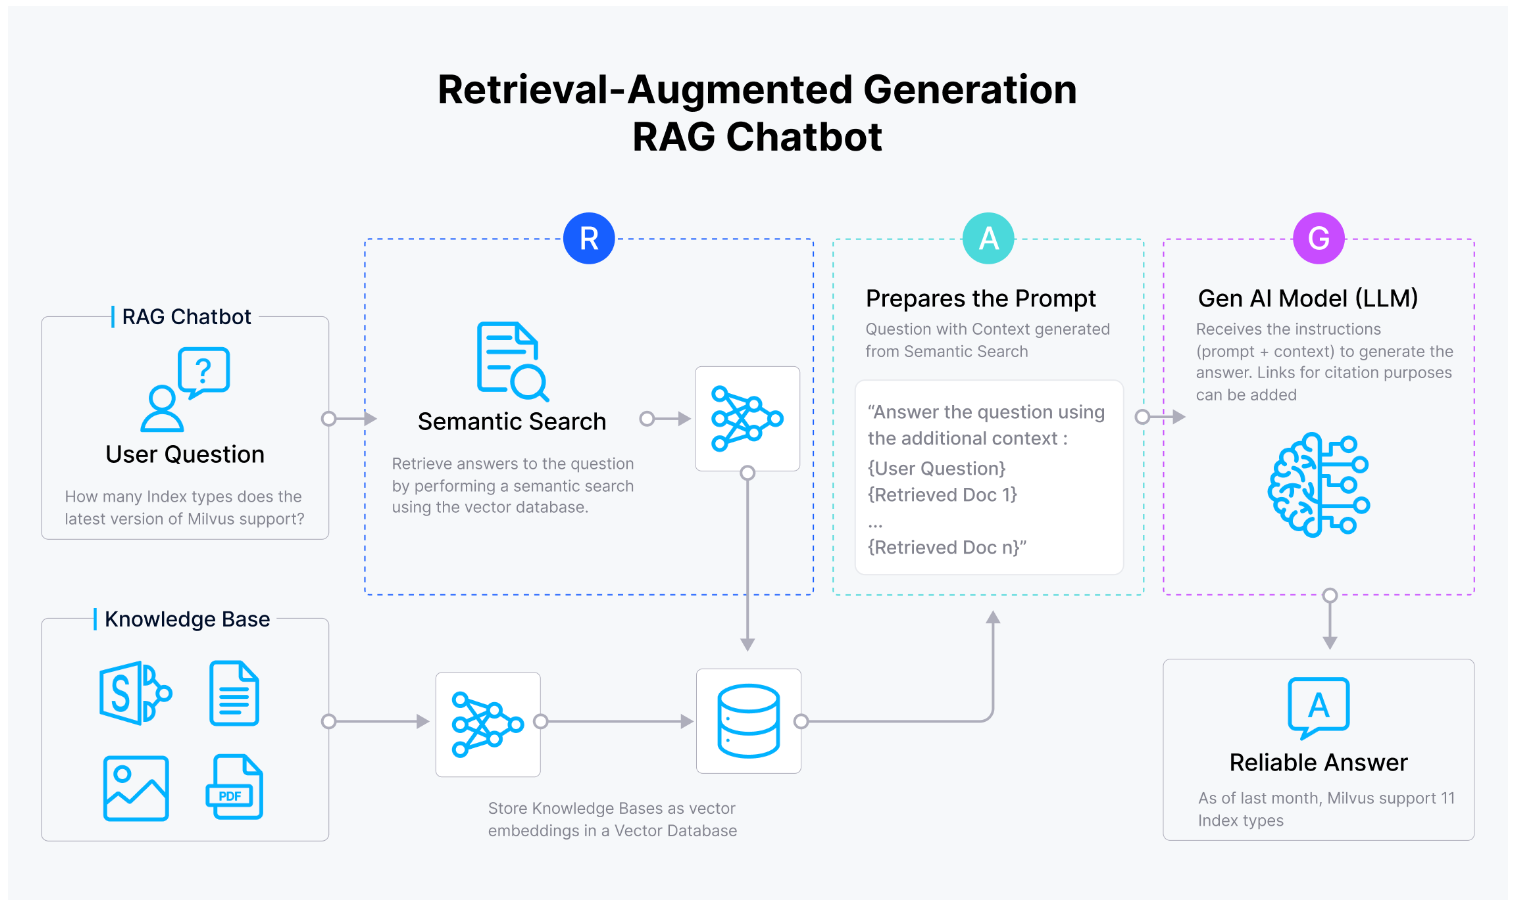
Llama 2 と組み合わせた Zilliz Cloud の最も一般的なユースケースは、Retrieval Augmented Generation(RAG)アプリケーションの開発です。RAG アプリケーションは、Llama 2 のような大規模言語モデル(LLM)の機能を活用します。これらのモデルは膨大なデータセットで学習されていますが、本質的には有限のデータの範囲内で動作します。Llama 2 単体では、十分なコンテキストや正確な情報がない場合でも回答を生成してしまう、「ハルシネーション」を起こす傾向があります。RAG は、このハルシネーションに対処する方法の一つです。
Zilliz Cloud と Llama 2 を組み合わせることで、ユーザーは高度な言語理解および生成機能を、Zilliz Cloud が提供する効率的でスケーラブルなベクトルベースの検索システムとシームレスに統合できます。両プラットフォームの強みを活用することで、開発者は包括的な言語処理、情報検索、生成機能を必要とするタスクに優れた高度なアプリケーションを作成できます。