




過学習と未学習:AIにおける最適なバランスの見極め
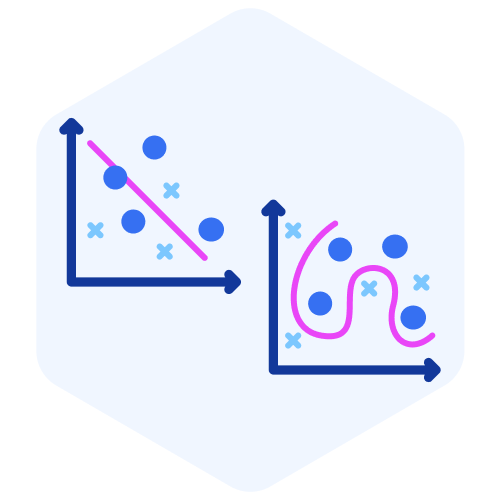
過学習と未学習:AIにおける最適なバランスの見極め
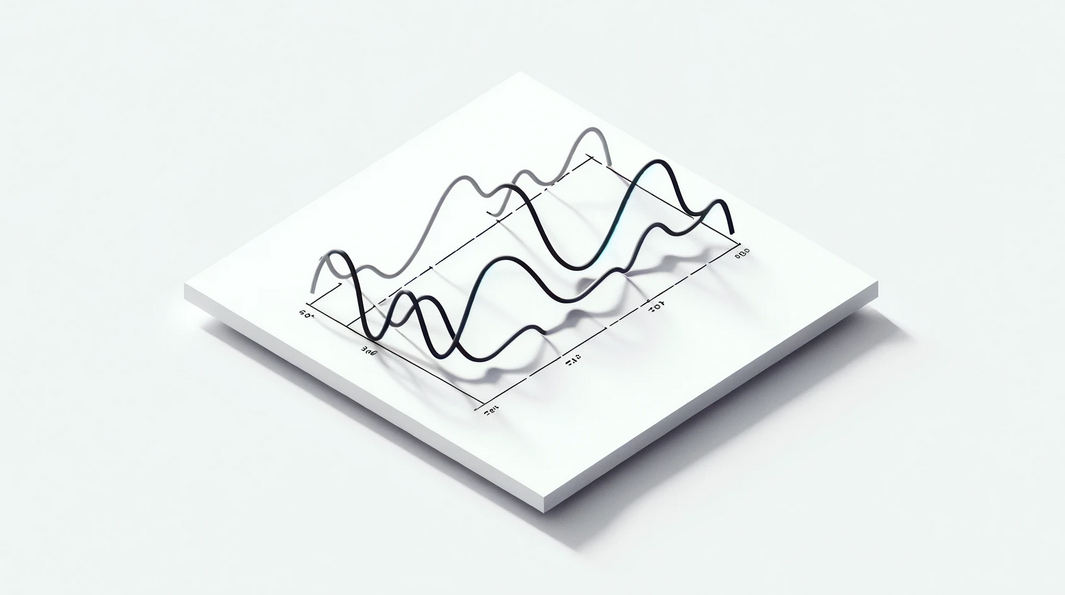 Figure 1- Striking the Balance- Visualizing Underfitting and Overfitting
図1:バランスの見極め:未学習と過学習の可視化
一貫性と信頼性は、人工知能と機械学習において常に重要でした。多くのAI modelsは、トレーニング中に優れた性能を達成し、正確かつ効率的です。しかし、実世界の環境で実装されると、その性能は低下します。過学習と未学習は、トレーニングと実世界での適用可能性の差に影響を与える2つの主要な問題です。これらはモデル開発における大きな課題となります。
これらの課題を克服することは、さまざまなデータセットに対してよく汎化する強力で信頼性の高いモデルを構築する鍵です。この記事では、過学習と未学習の兆候と原因、ならびにその影響と実用的な活用について明らかにします。
過学習と未学習とは?
過学習と未学習とは何かを理解しましょう。
過学習
過学習とは、モデルが入力変数と出力変数の間にある根本的なパターンを「理解する」のではなく「記憶する」状況を指します。これは、モデルが複雑になりすぎ、トレーニングデータ内のあらゆる細かな詳細や変動に適合しようとするときに起こります。モデルは、トレーニングデータセットに固有の意味のあるパターン、傾向、無関係なノイズ、異常値、ランダムな変動を学習してしまいます。
たとえば、顧客の購買行動データセットにおける過学習では、トレーニングデータでたまたま発生したために、時刻と商品タイプの特定の組み合わせを購入に結び付ける可能性があります。しかし、このパターンは新しい未見のデータセットには汎化しません。
過学習の影響は、モデルを検証データまたはテストデータで評価したときに、より明確になります。モデルはトレーニングデータセットではほぼ完璧なスコアを達成する一方で、新しいデータでの性能はしばしば大幅に低下します。
未学習
未学習は、モデルが単純すぎてデータ内の根本的なパターンを学習できず、性能が低くなる場合に発生します。モデルは入力特徴量と目的変数の関係を特定できず、トレーニングデータと未見データの両方で誤った予測を行います。
これは、モデルが解決しようとしている問題から学習していないことを意味します。これは、モデルの単純さ、不十分なトレーニング、または特徴量の欠落など、さまざまな要因によるものです。たとえば、住宅価格予測モデルが価格を予測するために、住宅の広さという1つの特徴量のみを使用している場合を考えてみましょう。
モデルは、より大きな住宅ほど高価であると仮定するかもしれませんが、価格に影響を与える他の重要な要因を組み込めません。これらの要因には、立地、状態、市場動向が含まれます。この過度な単純化は、信頼性が低く不正確な予測につながる可能性があります。
モデルのトレーニングにおける過学習と未学習
次に、過学習と未学習の主な原因と、それらを見分ける方法を見ていきましょう。
過学習の兆候
検証セットでの不安定な性能:モデルを異なる検証セットでテストすると、精度や損失指標が変動し、汎化できないことが明らかになる場合があります。
新しい状況への適応性の欠如:過学習したモデルは、わずかに変化した入力や未見の入力にさらされると、一般的に予測に失敗します。これにより、実用上の有用性が制限されます。
高い感度:過学習したモデルは感度が高すぎるため、わずかに異なるデータでトレーニングすると異なる結果を出すことがあります。これは、パターンを学習するのではなく詳細を記憶しているためです。
過学習の原因
過度に複雑なモデル: 複雑なアーキテクチャは、根底にあるパターンを学習する代わりに、訓練データ内のノイズを記憶してしまう可能性が高くなります。訓練データの不足により、モデルは利用可能な少数のサンプルに過度の注意を払わざるを得なくなります。そのため、モデルはノイズや外れ値を重要なパターンとして解釈し、汎化能力を低下させる可能性があります。
訓練エポック: 適切な正則化がないまま訓練エポックが多すぎると、モデルは訓練データの特異性に合わせて自らを微調整してしまいます。これにより、モデルが汎化を犠牲にして訓練誤差を最小化する一方で、過学習のリスクが高まります。
データ前処理技術の欠如: 特徴量スケーリングや正規化などのデータ前処理技術を適用しないと、過学習のリスクが高まる可能性があります。このプロセスがないと、特に一部の特徴量が異なるスケールにある場合、モデルは適切に学習できない可能性があります。訓練中の不適切な検証メカニズムでは、このように見過ごされがちな過学習の傾向を捉えられない場合があります。その後、モデルが未知のデータに汎化するテスト時に問題が明らかになります。
適合不足の兆候
精度が向上しない: モデルにデータを追加しても、そのアーキテクチャが意味のある洞察を抽出できません。
訓練の収束が遅い: これは、モデルが損失を最小化するために過度に長く訓練される場合に起こります。これは、モデルが根底にあるパターンを学習するのに十分な能力を欠いていることを示唆します。
多種多様な入力データに対する一様な予測: モデルが広範囲の入力に対して類似または同一の出力を生成する場合、これは適合不足を示します。これは、モデルがデータ内に存在する違いを捉えていないことを示しています。
適合不足の原因
モデル選択: 線形回帰などの単純なモデルを選択すると、不正確な予測を行う可能性があります。これは、線形回帰モデルが線形関係を仮定しているために起こります。この仮定は、データに複雑な非線形パターンが含まれている場合、大きく破られる可能性があります。
訓練エポック: 訓練エポックが十分でないと、モデルがデータパターンを完全に学習できず、不正確な予測につながる可能性があります。
データ品質: 欠損または無関係な特徴量を含む低品質のデータセットは、適合不足を悪化させる可能性があります。これは、モデルが予測を行うための十分な情報を持っていないためです。
単純さ: 単純さは過学習の回避に役立つ一方で、過度に単純化すると重要なパターンがモデル化されず、モデルの有効性が低下する可能性があります。
 図 2- AI Tools Illustration
図 2: AI Tools Illustration
過学習と適合不足を防ぐ方法
過学習と適合不足を避けることは、リアルタイムアプリケーションでモデルを円滑に稼働させ続けるための鍵です。だからこそ、それらを防ぐ最善の方法を知ることが重要です。見てみましょう。
過学習の防止
L1 または L2 正則化を使用して、過度に複雑なモデルにペナルティを与えます。正則化は、損失関数にペナルティ項を追加することで、モデルが訓練データに過学習するのを防ぎ、より単純なモデルを優先します。
ドロップアウトを導入してニューラルネットワークにランダム性を生み出し、共適応を防ぐのに役立てます。訓練中は毎回一部のニューロンがランダムに非活性化されるため、モデルはより堅牢で汎化された特徴量を学習せざるを得なくなります。
データ拡張を使用して、訓練データセットの多様性を人工的に増やします。これには、データサンプルにおける反転、回転、ノイズ付加などの技術が含まれます。これにより、モデルはより一般的なパターンから学習でき、汎化能力が向上します。
検証データを使用して訓練の進捗を監視し、モデルが改善していないことが明らかな場合は早期に停止します。早期停止と呼ばれるこのアプローチは、不要な訓練を避けることで過学習を防ぐのに役立ちます。
交差検証手法を使用して、複数のデータサブセットにわたってモデルの性能をテストします。これにより、モデルは異なるデータ分布に対してもうまく汎化できるようになります。
アンダーフィッティングの防止
パターンがより微妙になるにつれて、モデルの複雑さを高めます。たとえば、データが非線形関係を示している場合は、線形回帰ベースのモデルではなく、ニューラルネットワークモデルを使用します。
収束に十分なトレーニングエポックを確保します。ほとんどのモデルは、意味のあるパターンを学習するために十分な時間を必要とします。したがって、早期停止はアンダーフィッティングにつながる可能性があります。
高度なアルゴリズムやアーキテクチャを使用します。決定木やランダムフォレストなどのアンサンブル手法は、複雑なデータセットにおけるモデルの予測力を高めます。
ノイズが除去され、顕著なパターンのみが現れるようにデータを前処理します。これには、スケーリング、正規化、欠損値補完、およびモデルがそこから学習できるよう入力データを十分に整える、より徹底した手法が含まれます。
オーバーフィッティングとアンダーフィッティングの比較
オーバーフィッティングとアンダーフィッティングはAIモデルにとって一般的な課題ですが、その特性は異なります。モデルの性能にどのように影響するかを理解するために、それぞれの主要な特性を比較してみましょう。
| 観点 | オーバーフィッティング | アンダーフィッティング |
|---|---|---|
| モデルの複雑さ | 高すぎる | 低すぎる |
| トレーニングデータでの性能 | 非常に高い | 低い |
| テストデータでの性能 | 低い | 低い |
| 一般的な原因 | 過度なモデルの複雑さ、ノイズの学習 | 単純なモデル、不十分なトレーニング |
| 学習の挙動 | ノイズを含む詳細を記憶する | 重要なパターンの学習に失敗する |
| 実世界での応用 | 信頼できない予測 | 効果が低く、過度に単純化された結果 |
| 是正策 | 正則化、データの追加、より単純なモデル | 複雑さの増加、特徴量の追加 |
| データ依存性 | 特定のデータセットに大きく依存する | 十分なデータがあっても苦戦する |
| 柔軟性 | トレーニングデータに過度に最適化されている | データの変動に適応するには硬直的すぎる |
オーバーフィッティングとアンダーフィッティングの利点と課題
新しいデータで良好に機能するモデルを開発するには、オーバーフィッティングとアンダーフィッティングのバランスが重要です。しかし、このバランスを達成する際には課題が生じることがあります。以下は、このバランスを達成することの主な利点と課題です。
利点
バランスの取れたモデル: オーバーフィッティングとアンダーフィッティングのバランスを取ることは、多様なデータセットで高い性能を達成するための鍵です。これにより、モデルはノイズへの過剰適合やパターンの過度な単純化を避けることで、未知のデータを効果的に扱えるようになり、実世界のアプリケーションで信頼性が高く一貫した結果をもたらします。
汎化性能の向上: オーバーフィッティングを避けることで、未知のデータにうまく汎化できるモデルになります。汎化により、モデルはトレーニング中に学習したパターンを適用して、実世界のシナリオで正確な予測を行うことができます。したがって、これはモデルの有用性と有効性を高めます。
リソース使用の効率性: バランスの取れたモデルは、大規模な再トレーニングや変更を必要としません。したがって、計算資源および人的リソースの消費は最小限に抑えられます。
より優れた予測力: オーバーフィッティングもアンダーフィッティングもしないモデルは、データ内の意味のあるパターンや関係を見つけ出すことに優れています。これにより、より優れた、より実行可能な予測につながります。
スケーラビリティ: 複雑なモデルは、より大規模なデータセットを処理する能力に優れているため、さまざまな用途に適しています。ただし、スケーラビリティは計算資源やデータ品質などの要因にも依存します。
課題
正則化: L1 や L2 などの正則化手法の選択と微調整は、依然として最も難しい課題の一つです。正則化の強度は、モデルが有効性を保ち、過度に制約されないように最適化する必要があります。
データ品質: ノイズ、欠損値、無関係な特徴量などの低いデータ品質は、アンダーフィッティングとオーバーフィッティングの両方の問題を悪化させ、火に油を注ぎます。高品質で適切に前処理されたデータを確保することが、成功するモデリングのまさに基盤となります。
ハイパーパラメータチューニング: 学習率、バッチサイズ、エポック数などのパラメータには多くの試行錯誤が伴い、通常は時間がかかります。
評価指標: モデル性能評価のための指標の選択は適切である必要があります。指標は、モデルの成功を誤って評価しないように、精度と汎化能力の両方を捉えるべきです。
動的な環境: 進化する分野では、モデルは迅速かつ効果的に適応しなければなりません。安定性と新しいデータへの応答性のバランスを取ることは、モデル開発にさらなる複雑さをもたらします。
オーバーフィッティングとアンダーフィッティングの管理ツール
オーバーフィッティングとアンダーフィッティングを防ぐために、複数のツールが利用できます。これらには以下が含まれます:
TensorFlow と PyTorch は、最も人気のある2つのフレームワークです。これらは、正則化、ドロップアウト層、データ拡張のためのよく整備されたライブラリを提供しており、複雑なモデルのオーバーフィッティングとアンダーフィッティングを迅速にテストするのに役立ちます。
Scikit-learn は、複数のモデルのテスト、特徴量選択、交差検証のためのツールを提供する汎用性の高いライブラリです。さまざまなアルゴリズムやハイパーパラメータを試すことで、アンダーフィッティングとオーバーフィッティングをより適切に処理できます。
FAQ
- 自分の AI モデルがオーバーフィッティングしているかどうかは、どうすれば分かりますか?
訓練セットと検証セットの両方での性能を監視する必要があります。検証データよりも訓練データで良い性能を示す場合、それはオーバーフィッティングしています。L2 やドロップアウトなど、さまざまな正則化手法がこの問題の防止に役立ちます。
- アンダーフィッティングを避ける一般的な方法には何がありますか?
モデルの複雑さはデータに見合ったものである必要があります。より多くのパターンを学習するには、より表現力の高いモデルを使用し、訓練エポック数を増やします。データセットにさらに特徴量を追加することでも、この状況を回避できます。
- 交差検証はオーバーフィッティングへの対策に役立ちますか?
交差検証では、モデル性能を一貫して評価するためにデータを複数のサブセットに分割します。これにより、モデルが未知のデータに対してよく汎化することを確認でき、異なる分割で訓練とテストを行うことで、オーバーフィッティングの初期兆候を特定できます。
- データ拡張はオーバーフィッティングに役立ちますか?
はい。データ拡張は、回転、反転、ノイズの追加を通じて訓練セット内の多様性を高めます。これにより、現実世界の変動性をシミュレートして汎化を助け、データ内の特定のパターンへの依存を減らします。
- Milvus はこれらの問題の解決にどのように貢献しますか?
Milvus は、大量のデータを効率的に処理でき、高速な類似性検索とクラスタリングをサポートするオープンソースのベクトルデータベースです。全文検索サポートとベクトル圧縮により、このフレームワークは訓練用の高品質なデータを保証するためにデータを効率的に前処理します。これにより、オーバーフィッティングとアンダーフィッティングのリスクが低減されます。
関連リソース