




Change Data Capture (CDC)
変更データキャプチャ(CDC)とは?
変更データキャプチャ(CDC)は、データベース内で発生するデータの変更を、その発生時に識別して追跡するために使用される手法です。更新を手動で監視したり、繰り返しクエリしたりする代わりに、CDC は挿入、更新、削除をリアルタイムまたはほぼリアルタイムで自動的にキャプチャします。トランザクションログやデータベーストリガーなどの CDC 技術により、組織はさまざまなシステムやデプロイメント環境全体でデータの一貫性と整合性を維持できます。これにより、従来型の分析を支えるものでも、ベクトルベースの AI モデルを支えるものでも、下流のシステムやアプリケーションが常に最新のデータを利用できるようになります。
たとえば、ベクトルデータベースでは、CDC はセマンティック検索や不正検出のようなタスクにおいて、正確な結果を得るために最新データが必要とされる場合に、埋め込みのリアルタイム更新を追跡します。
データ統合の進化:CDC の役割
以前は、バッチ処理がデータ統合の主なアプローチでした。しかし、データ更新は変更が発生してから数時間後または数日後に、スケジュールされた間隔で一括処理されることが多く、遅延を引き起こしていました。この制約により、高次元データを分析するためにベクトルデータベースに依存する、AI 搭載チャットボット向けのリアルタイムセマンティック検索や推薦システムのようなアプリケーションには適していませんでした。
CDC は、変更が発生した時点でそれをキャプチャし、システムをリアルタイムで更新することで、この問題を解決します。この技術により、企業はデータベースを同期し、リアルタイムダッシュボードを稼働させ、応答性の高いアプリケーションを構築できます。CDC の台頭は、タイムリーなデータ複製と統合が重要である現代の分散システムやクラウドネイティブアーキテクチャの成長と同時期に起こりました。定期的な更新による古いデータを扱うのではなく、組織は変更が発生した時点でそれをキャプチャし、対応できるようになりました。この変化により、CDC は企業がリアルタイムで応答性と競争力を維持するのを支援する、現代のデータ戦略における重要な構成要素となりました。
変更データキャプチャはどのように機能するのか?
e コマースプラットフォーム上での顧客のインタラクションを追跡することを想像してみてください。閲覧、カートへの追加、購入などの各インタラクションによって新しいデータが生成されます。CDC はこの変更データをリアルタイムで Milvus のようなベクトルデータベースにストリーミングし、そこでベクトル埋め込みとも呼ばれるそれらのベクトル表現を、パーソナライズされた推薦や不正防止などのタスク向けに更新できます。
CDC がどのように機能するのかを理解するために、主要なコンポーネントとメカニズムに分けて見ていきましょう。
CDC の主要コンポーネント
CDC を機能させるには、複数のコンポーネントが連携します。以下の図は CDC プロセスを示しています。
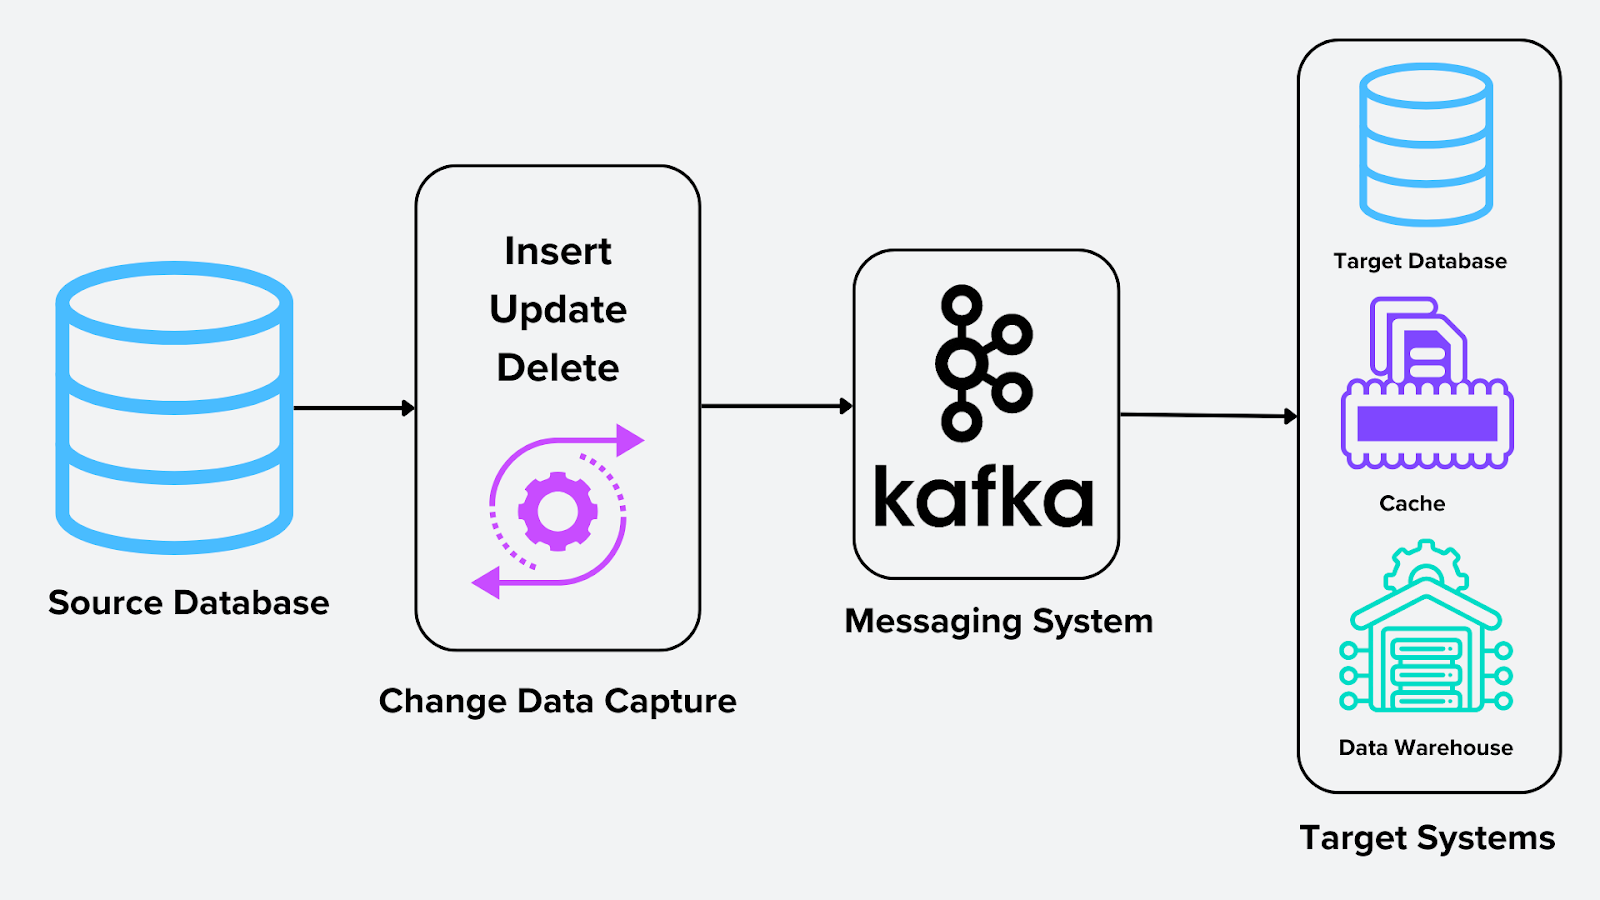 Figure- Change Data Capture Process .png
図: 変更データキャプチャプロセス
ソース: 変更が発生するシステムであり、リレーショナルデータベース、NoSQL システム、またはベクトルデータベースなどが該当します。Milvus のようなベクトルデータベースの場合、ソースは深層学習モデルや画像認識モデルから生成された埋め込みである可能性があります。
CDC エンジン: 変更をキャプチャしてフォーマットする中核的なプロセスです。ベクトルデータベースの場合、これは Milvus-CDC や Confluent Kafka Connect のようなツールを使用して、Milvus に保存された埋め込みを更新することを意味する場合があります。
メッセージングシステム: Apache Kafka のようなメッセージングシステムは、変更をリアルタイムで配信するためのバックボーンとして機能します。キャプチャされた変更を保存し、1つまたは複数のターゲットシステムにストリーミングする仲介役として機能します。これにより、データパイプラインのスケーラビリティと信頼性が確保されます。
ターゲットシステム: 処理されたデータ変更が送信される宛先です。例としては次のようなものがあります。
データウェアハウス(例: Snowflake、BigQuery):分析用。
キャッシュ:クエリ応答を高速化するため。
データベース:システム間のレプリケーションと同期のため。
CDCメカニズムの概要
CDCがデータベースから変更をキャプチャする主な方法は3つあります。以下の例では、SQLデータベースを使用して説明します。
1. ログベースCDC
この方法は、データベースのトランザクションログに依存します。これは、すべてのデータベース変更(挿入、更新、削除)を記録するシステムレベルの機能です。CDCエンジンはこれらのログを読み取り、下流で使用するために関連する変更を抽出します。ベクトルデータベースでは、Milvusに挿入または変更される埋め込みベクトルの更新をキャプチャすることを意味する場合があります。
仕組み:
トランザクションログは、すべてのデータベース操作における単一の真実の情報源です。
CDCツールはログを監視し、プライマリデータベースに影響を与えることなく、変更を継続的に特定してキャプチャします。
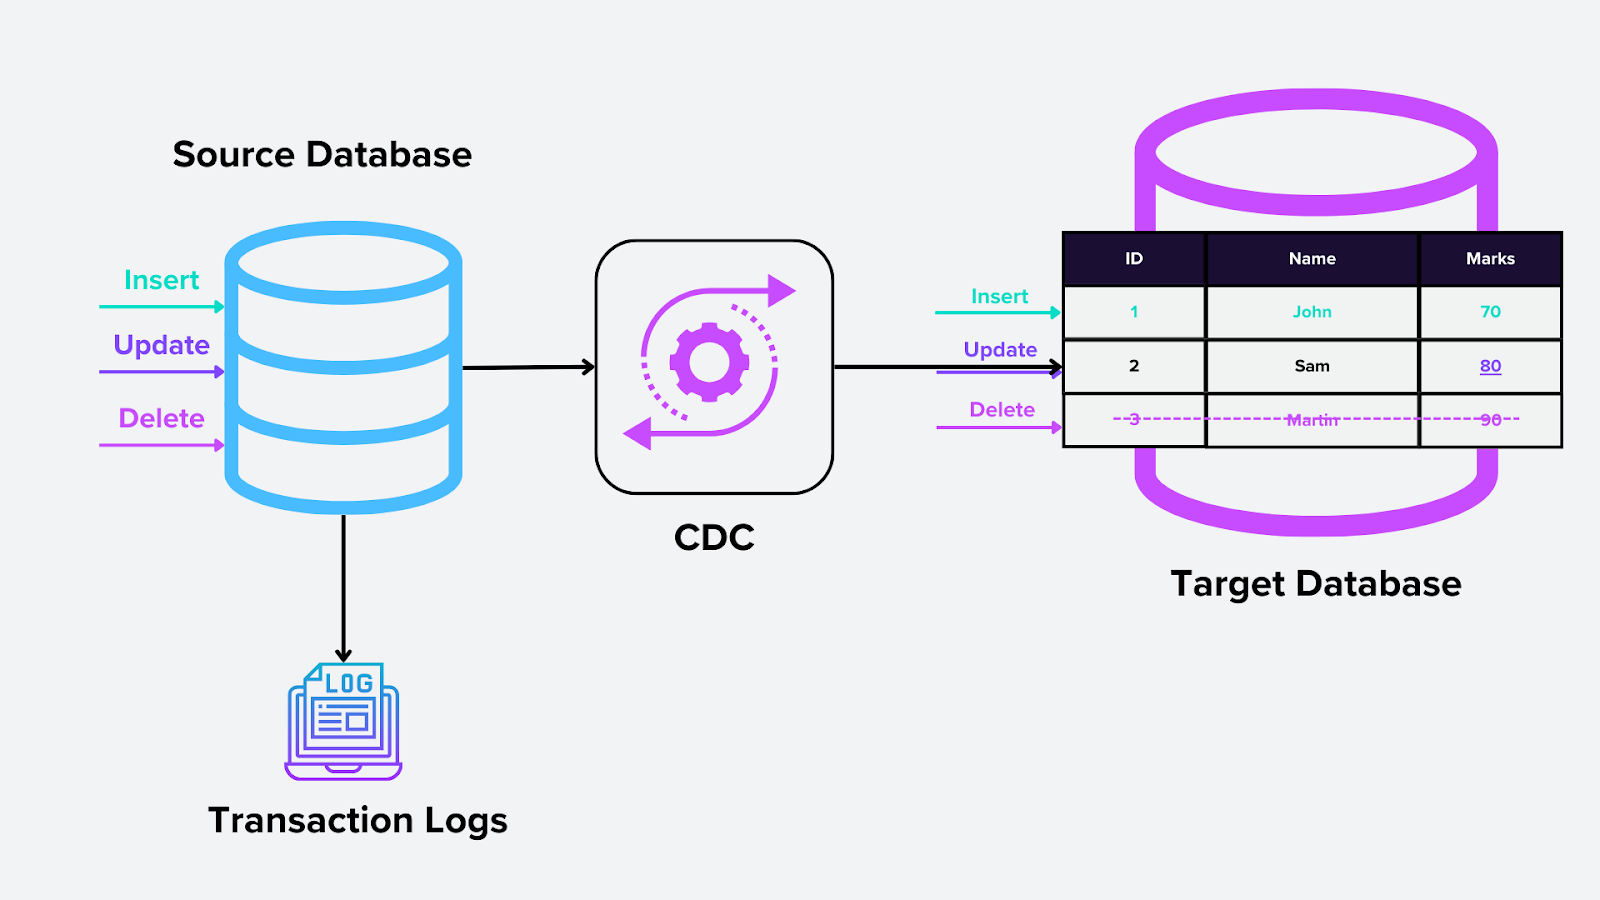 Figure- Log-based CDC.png
図: ログベースCDC
メリット:
高パフォーマンス: ログから直接読み取るため、データベースへの影響が最小限です。
包括的: トリガー、ストアドプロシージャ、その他の間接的な方法を含むすべての変更をキャプチャします。
スケーラブル: トランザクションの多いシステムでも適切に機能します。
デメリット:
複雑性: データベースの内部ログ構造との深い統合が必要であり、これはデータベースの種類によって異なる場合があります。
互換性: すべてのデータベースが外部アクセス用にトランザクションログを公開しているわけではありません。
2. トリガーベースCDC
このアプローチでは、データベーストリガーを使用します。これは、テーブルで特定の変更(例: 挿入、更新、削除)が発生したときに自動的に実行されるカスタムロジックです。 たとえば、新しい埋め込みが追加されたときに、トリガーがMilvusベクトルインデックスを自動的に更新することができます。
仕組み:
データベース内の対象テーブルにトリガーが追加されます。
変更が発生すると、トリガーがそれらをキャプチャし、下流処理のために指定された場所またはテーブルに情報を送信します。
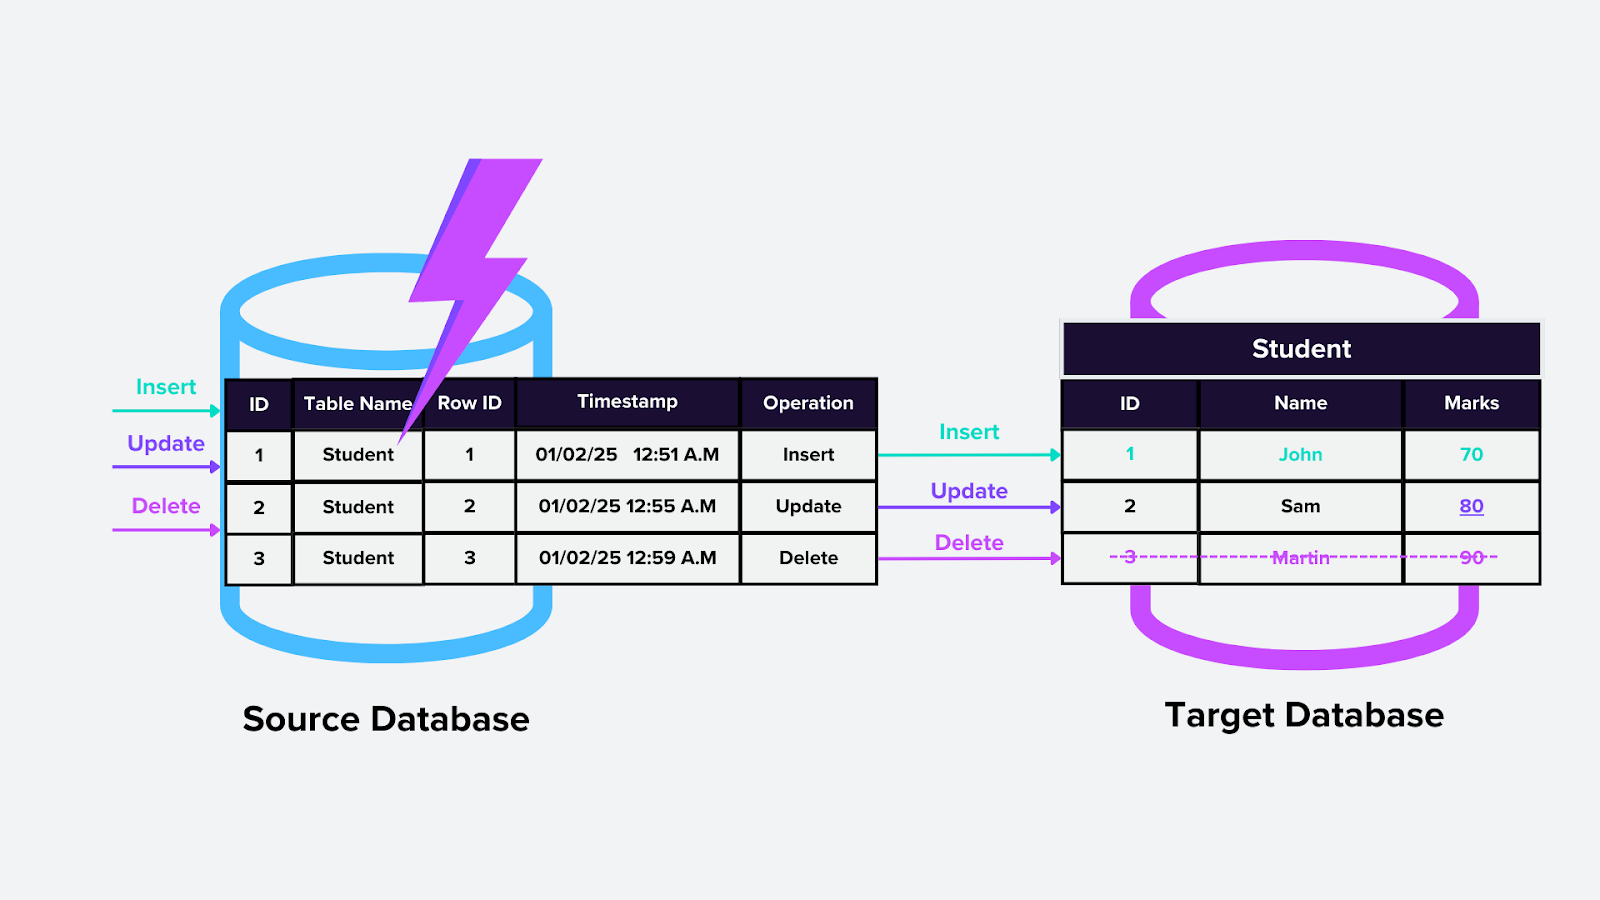 Figure- Trigger-based CDC.png
図: トリガーベースCDC
メリット:
柔軟: 特定のユースケースに合わせて変更を追跡するようにカスタマイズできます。
広くサポート: ほぼすべてのリレーショナルデータベースがトリガーをサポートしています。
デメリット:
パフォーマンスへの影響: トリガーはデータベースにオーバーヘッドを追加し、特に高頻度のトランザクションでは影響が大きくなります。
保守上の課題: 複数のテーブルにわたってトリガーを管理および更新することは困難になる場合があります。
エラーが発生しやすい: 不適切に記述されたトリガーは、パフォーマンスのボトルネックを引き起こしたり、エッジケースをキャプチャできなかったりする可能性があります。
3. クエリベースCDC
この方法では、変更を検出するためにデータベースに対して定期的にクエリを実行します。通常、クエリはタイムスタンプやバージョンを比較して、新しく変更されたレコードを特定します。たとえば、更新された埋め込みについてベクトルデータベースをポーリングする場合などです。
仕組み:
CDCエンジンはスケジュールされた間隔でクエリを実行し、特定の基準(例: 最終更新日)に基づいて変更を特定します。
検出された変更はその後、下流に送信されます。
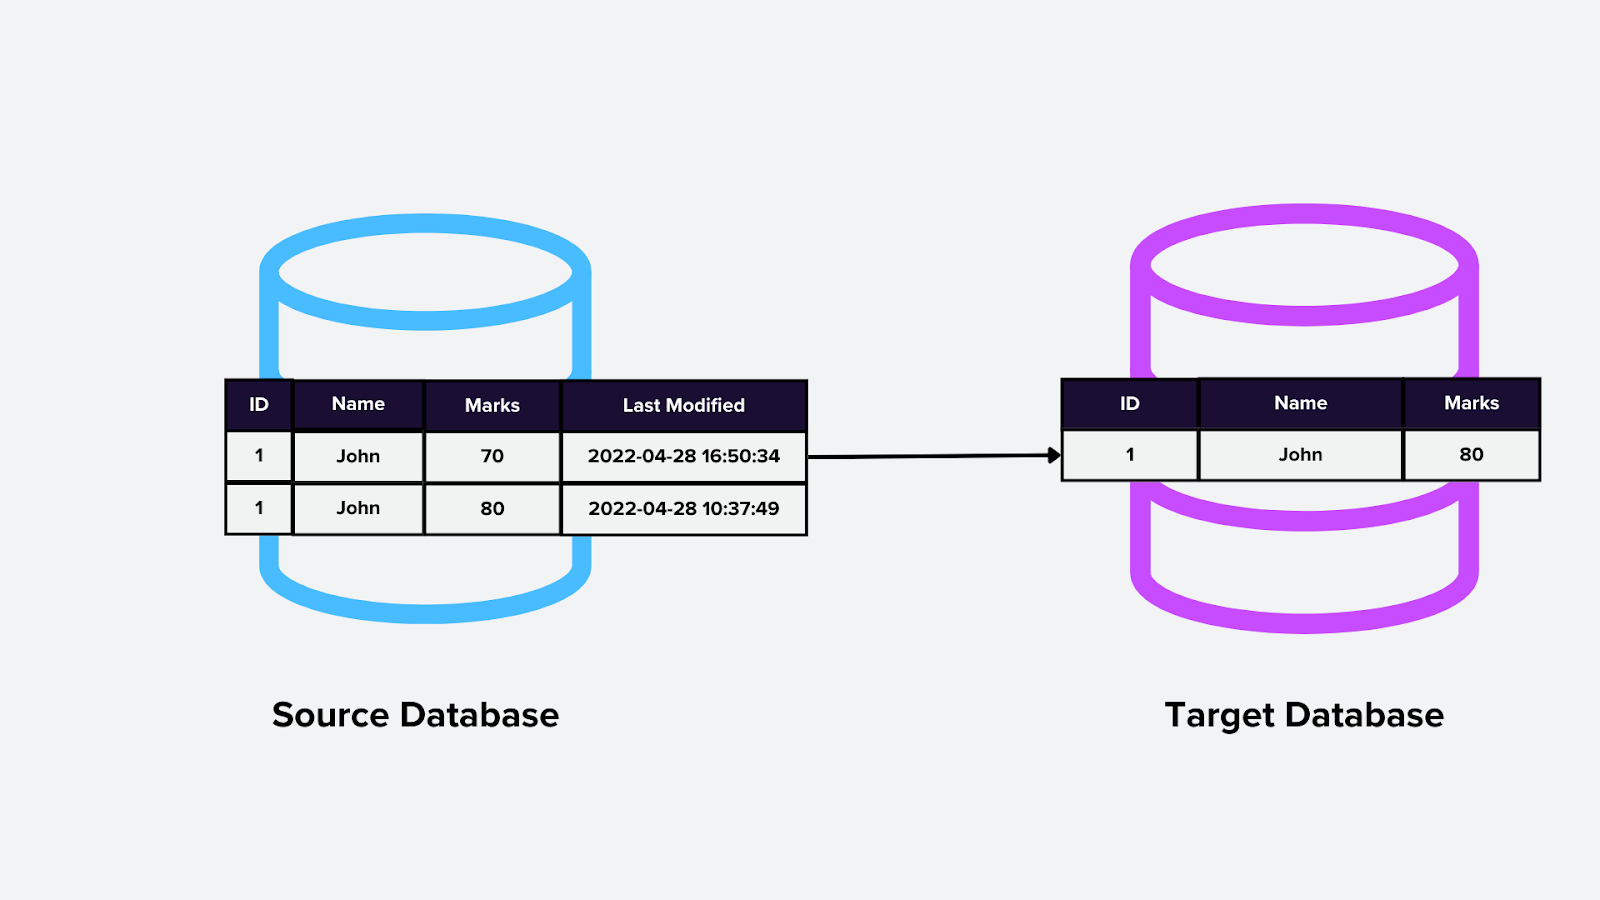 Figure- Query-based CDC.png
図: クエリベースCDC
メリット:
簡単なセットアップ: データベースとの深い統合や変更を必要としません。
データベース非依存: クエリをサポートするほぼすべてのデータベースで機能します。
デメリット:
レイテンシ: クエリスケジュールに依存するため、リアルタイムではありません。
パフォーマンスのオーバーヘッド: 頻繁なクエリはデータベースに負荷をかける可能性があります。
限定的な精度: クエリ間隔の間にデータ変更が発生した場合、変更を見逃す可能性があります。
CDCメカニズムの比較
以下の表は、さまざまなCDCメカニズムとそのユースケースについての概要を示しています。
| メカニズム | リアルタイム | パフォーマンスへの影響 | セットアップの容易さ | ユースケースの適合性 |
| ログベース | はい | 低 | 中 | 大量トランザクションシステム |
| トリガーベース | はい | 中〜高 | 低〜中 | カスタム変更ロジックを必要とするユースケース |
| クエリベース | いいえ | 高 | 高 | 低頻度の変更を伴うシンプルなセットアップ |
表: CDCメカニズムの比較
MilvusによるCDC: ベクトルデータベースのためのリアルタイムデータ統合
Milvusは、機械学習モデルからのベクトル埋め込みなどの非構造化データを管理するために構築されたオープンソースのベクトルデータベース(Zillizのエンジニアによって開発)であり、Milvusインスタンス内でのデータレプリケーションと同期タスクを処理するために明示的に設計された独自のCDCツール、Milvus-CDCを備えています。Milvus-CDCは、ソースとターゲットのMilvusインスタンス間でシームレスな同期を行うために増分データ変更をキャプチャします。これにより、データの整合性と一貫性を維持しながら、増分バックアップ、災害復旧、永続的なデータレプリケーションなどのタスクをサポートします。Milvus-CDCには、ユーザーリクエストを管理し、タスクを実行し、タスクメタデータを維持するHTTP Serverと、タスク同期を処理するCorelibという2つの主要コンポーネントが含まれます。Corelibには、ソースMilvusインスタンスとメッセージキューからデータを抽出するreader、およびこれらの変更を処理してターゲットMilvusインスタンスに送信するwriterがあります。
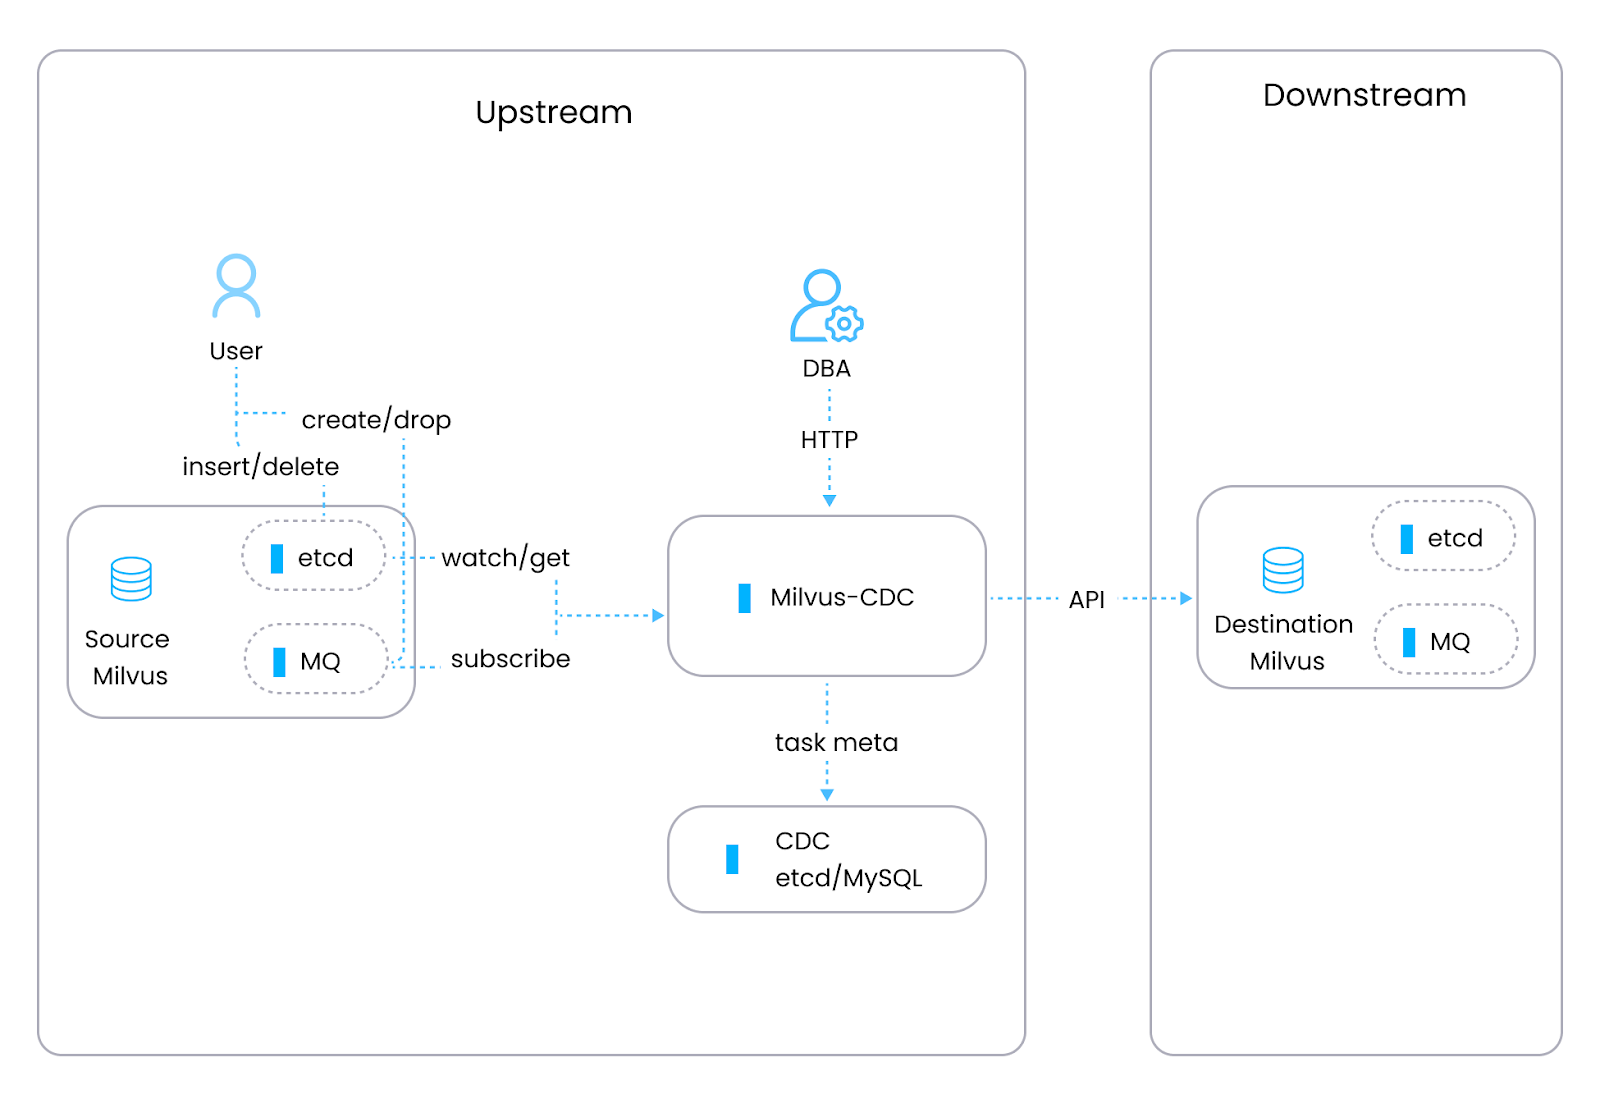 Figure- The Milvus-CDC architecture.png
図: Milvus-CDCアーキテクチャ
Milvus-CDC: 主な機能
順次データ同期: 変更が適用される順序を保証し、Milvusインスタンス間でデータの一貫性を保持します。
増分データレプリケーション: ソースMilvusからターゲットインスタンスへの挿入や削除などの変更をキャプチャしてレプリケートします。
タスク管理: ユーザーはOpenAPIを使用してCDCタスクを作成、管理、削除し、さまざまなワークフローと統合できます。
将来のシステムとの統合: ストリーム処理システムとの統合サポートを拡張する計画があります。
Kafkaを使用したMilvusでのCDC
Milvus-CDCはMilvus向けに明確に調整されていますが、MilvusをApache Kafkaと統合することで、CDCへの別のアプローチが得られます。Kafkaは、Kafka Sink connectorなどのCDCツールを使用してさまざまなソースからのデータ変更をキャプチャし、伝播する中央ハブです。これらの変更はその後Milvusに取り込まれ、ベクトルデータベースを最新の埋め込みや特徴ベクトルで最新の状態に保ちます。
KafkaをMilvusに接続するには、次のガイドを参照してください: KafkaとMilvusを接続する。
分散データベースとクラウドネイティブアプリケーションにおけるCDCの役割
組織が大規模で地理的に分散したワークロードを処理するために分散データベースとクラウドネイティブアプリケーションを採用するにつれて、CDCはこれらの複雑なシステム全体でシームレスなデータ同期において重要な役割を果たします。
分散システム全体でのデータ同期: 分散データベースでは、パフォーマンスとスケーラビリティを向上させるために、データが複数のノードやリージョンに分散されることがよくあります。CDC は、あるノードで行われた変更を即座に他のノードへ伝播し、システム全体の一貫性を維持します。
クラウドネイティブアーキテクチャにおけるリアルタイムデータ共有: クラウドネイティブアプリケーションは、多くの場合、それぞれが独自のデータストレージを持つ microservices に依存しています。CDC により、これらのサービスは、イベント駆動型アーキテクチャをサポートするために重いバッチ処理に依存することなく、リアルタイムの更新を共有できます。
高可用性と災害復旧のためのレプリケーション: 分散システムでは、高可用性のためにデータレプリケーションを使用することがよくあります。CDC は変更をキャプチャし、バックアップノードやフェイルオーバーシステムにレプリケートします。
データパイプラインの効率化: 複数のシステムが共有データセットに依存する環境では、CDC はリアルタイムの変更を分析プラットフォーム、データレイク、またはメッセージキューに供給する仕組みを提供します。
ベクトルデータベースにおける CDC の応用
以下は、特にベクトルデータベースを扱う AI アプリケーションにおける CDC の具体的なユースケースです。
セマンティック検索: CDC は最新の埋め込みでベクトルデータベースを更新し、セマンティック検索システムが正確で関連性の高い結果を提供できるようにします。たとえば、エンタープライズ検索エンジンは、ドキュメントやクエリの埋め込みに対するリアルタイム更新に基づいて、正確な回答を提供できます。
推薦システム: ベクトルデータベースは、埋め込みを使用してパーソナライズされた推薦を生成します。CDC は、新しいユーザー行動や製品更新などのリアルタイムの変更をストリーミングするため、推薦システムは変化するデータにすばやく適応できます。
不正検出: 金融システムでは、取引データからの埋め込みがベクトルデータベース内で継続的に更新されます。CDC により、これらの更新がリアルタイムでストリーミングされ、異常な活動を即座に検出し、潜在的な不正をフラグ付けできます。
画像・動画認識: タグ付けや視覚的に類似したコンテンツの検索などのアプリケーションでは、CDC が画像や動画から生成されたベクトル埋め込みをデータベース内で最新の状態に保ちます。これにより、ソーシャルメディアのモデレーションや e コマースのビジュアル検索など、リアルタイムのユースケースで正確かつ高速な結果が可能になります。
チャットボットとバーチャルアシスタント: CDC は、RAG ベースの LLM チャットボットがリアルタイムで正確な応答を提供するのに役立ちます。たとえば、ライブのユーザーインタラクションや更新されたナレッジベースを表す埋め込みが即座にキャプチャおよび更新され、チャットボットのパフォーマンスが向上します。
異常検知: CDC は、ネットワークトラフィックやシステムログ内の異常なパターンに即時対応が必要なサイバーセキュリティで役立ちます。
CDC のメリット
CDC は、現代のデータアーキテクチャが効率的に運用され、情報に基づいた意思決定を行うための大きな利点を提供します。主なメリットは次のとおりです。
リアルタイムのインサイト: CDC は、迅速な意思決定を支援するために最新のデータを提供します。そのため、企業はパフォーマンスやトレンドを即座に監視できます。
データレイテンシの削減: 従来のバッチ処理によって生じる遅延を排除します。変更がほぼ即座にシステム全体に反映されるため、同期データに依存するアプリケーションの応答性が向上します。
大規模システムにおけるスケーラビリティ: 大量のデータ変更を処理できるため、大規模データベースや分散環境に適しています。
シームレスなデータレプリケーションと移行: この機能により、高可用性、災害復旧、負荷分散のためにシステム間でリアルタイムのデータレプリケーションが容易になります。また、移行中に同期されたデータを使用することで、ダウンタイムを最小限に抑えたデータベース移行も簡素化されます。
イベント駆動アーキテクチャのサポート: データ変更に基づいて下流のワークフローやプロセスをトリガーすることで、イベント駆動型アプリケーションを強化します。したがって、ビジネス運用における自動化と応答性を向上させます。
データの正確性と一貫性: 接続されたすべてのシステムで一貫性があり正確なデータを保持し、エラーや不整合を削減します。したがって、堅牢なデータ駆動型ソリューションを構築するための信頼性の高い基盤を提供します。
CDCの実装における課題
CDCの実装は複雑になる可能性があり、組織は効率的で信頼性の高い運用のためにいくつかの課題に対処する必要があります。主な障壁は次のとおりです。
パフォーマンスのオーバーヘッド: リアルタイムの変更を取得して処理することは、データベースに追加の負荷をかけ、主要アプリケーションのパフォーマンスに影響を与える可能性があります。また、トリガーや頻繁なクエリのようなリソース集約型の方法は、データベースの応答時間を低下させる可能性があります。速度と正確性および信頼性のバランスを取るには、最適化されたパイプライン設計が求められます。
スキーマ変更への対応: カラムの追加、データ型の変更、テーブル構造の変更など、データベーススキーマへの変更はCDCパイプラインを中断させる可能性があります。
ネットワークとストレージに関する考慮事項: CDCにおける継続的なデータストリーミングでは、コストの急増を避けるために十分なストレージ容量と効率的な圧縮技術が必要です。ネットワークトラフィックの増加は、特に地理的に分散したシステムにおいて帯域幅に負荷をかける可能性があります。
CDCパイプラインにおけるデータ整合性: パイプライン内の障害や不整合は、下流システムの正確性を損なう可能性があります。順序が前後したイベントの処理や、分散環境における競合の解決は、複雑さを増す可能性があります。
ツールの互換性とベンダーロックイン: 一部のCDCソリューションは特定のデータベースやテクノロジーに結び付いており、異種環境での柔軟性を制限します。ツールの切り替えやシステムのアップグレードには、CDCプロセスの再設計が必要になる場合があります。
セキュリティとコンプライアンスのリスク: 機密データをリアルタイムでストリーミングするには、不正アクセスを防ぐための堅牢な暗号化とアクセス制御が必要です。GDPRやCCPAなどのデータ保護規制への準拠は、CDCの実装を複雑にする可能性があります。
CDCのためのツールとフレームワーク
CDCを実装するために、いくつかのツールとフレームワークが利用可能であり、それぞれが特定のユースケースに合わせた独自の機能を備えています。一般的な選択肢の一覧は次のとおりです。
Debezium**: Apache Kafka上に構築されたオープンソースのCDCプラットフォームであるDebeziumは、MySQL、PostgreSQL、MongoDB、SQL Serverなど、さまざまなデータベースをサポートします。リアルタイムのデータストリーミングやイベント駆動アーキテクチャとの統合に最適です。
Oracle GoldenGate: Oracleの堅牢なエンタープライズグレードのCDCソリューションであるGoldenGateは、異種データベース間での高性能なデータレプリケーションとリアルタイム統合をサポートします。災害復旧や移行に広く使用されています。
AWS Database Migration Service (DMS): ****オンプレミスとクラウドの両方で、さまざまなデータベース向けのCDCをサポートするAmazonのフルマネージドサービスです。大きなオーバーヘッドを必要とせずに、データ移行とレプリケーションを簡素化します。
Qlik Replicate: 以前はAttunity Replicateとして知られていたQlik Replicateは、幅広いデータベースとファイルシステム向けのCDCをサポートします。高速でスケーラブルなデータレプリケーションと分析プラットフォームへの統合を目的として設計されています。
Confluent Kafka Connect: Confluentエコシステムの一部であるKafka Connectは、データ変更をKafkaトピックにストリーミングするためのCDC機能を提供します。また、リアルタイムのイベント処理のためにKafkaプラットフォームとシームレスに統合されます。
結論
CDCは、リアルタイム更新とプラットフォーム間の統合を通じて、現代のデータシステムにおいて重要な役割を果たします。バッチ処理の制限に対処することで、CDCはリアルタイム分析、イベント駆動型アーキテクチャ、シームレスなデータ同期をサポートします。Apache Kafkaのようなツールは、Milvusのようなベクトルデータベースを含む下流システムでの変更を効率化することで、CDCをさらに強化します。これにより、企業は非構造化データを扱い、運用を拡張し、応答性の高いアプリケーションを構築できます。