




MLマネジメントの課題を克服する:成功のためのツールと洞察
機械学習(ML)が猛烈なスピードで進歩し続ける中、膨大なデータセットとモデルの管理とバージョン管理の複雑さは指数関数的に増大している。ソフトウェア開発では、開発者は長い間Gitのようなバージョン管理ツールに頼ってきたが、機械学習特有の課題には、より専門的なソリューションが必要だ。コードベースが比較的容易にバージョン管理できるソフトウェアとは異なり、MLモデル、データセット、および成果物には、バージョン管理と管理のための統一された業界標準がないことが多い。
最近Zillizが主催したUnstructured Data Meetupで、XetHub(現在はHuggingFaceによって買収された)の共同創設者であるRajat Aryaは、彼と彼のチームがMLのバージョニングと管理におけるこのギャップにどのように対処したかについて議論した。彼のチームは、ペタバイトスケールのデータを扱うためにGitを拡張するツール、XetHubを開発した。そう、ペタバイトスケールのデータだ。しかし、なぜこれが必要なのか?どのような利点があり、どのように機能するのか?ベクターデータベースとの関係は?Arya氏の洞察に飛び込み、重要なポイントを紐解いていこう。
ラジャットの講演のリプレイを見る。
機械学習開発におけるペインポイント機械学習開発における大きなハードルの1つは、MLパイプライン全体をカバーする包括的なツールが存在しないことだ。特定のタスクのためのツールは数多く存在するが、エンドツーエンドのプロセスを効率的に処理するソリューションに関しては大きな隔たりがある。以下は、主要なペインポイントである:
スケーラビリティ
100ペタバイトを超えるデータセットの管理は、特に従来のツールでは扱えるファイル数に制限があった場合、非常に大きな課題となります。
データ管理
リポジトリの不変スナップショットを作成することは、データの整合性を確保し、バージョン管理を容易にするために極めて重要です。この機能がないと、変更の追跡と一貫性の維持が困難になります。
コラボレーション
データサイエンティストとエンジニア間のシームレスなコラボレーションの促進は不可欠である。ソフトウェア開発におけるソース管理によってもたらされた革命は、MLにはまだ十分に及んでおらず、標準化されたツールの欠如により、コラボレーションはしばしば障害に直面している。
観測可能性
モデルやデータセットにいつ、どのような変更が生じたかを理解することは、MLシステムのデバッグや改善に不可欠です。これらの変更を可視化できなければ、チームは効果的な反復を行うことができません。
研究から実世界のMLアプリケーションへ:すべてが変わる
初期の頃、MLとAIは主に研究に焦点を当てたもので、学術的な目標は静的で、しばしば構造化されたデータセットを扱うことでした。その目的は、精度やエラー率といった指標を向上させることであり、管理された研究環境ではうまく機能した。
しかし、MLがアカデミアから産業界に移行するにつれ、状況は劇的に変化した:
静的データセットと動的データセット
アカデミックなMLでは静的なデータセットを扱うことが多いが、産業界のMLでは常に変化するデータが扱われ、時には1時間ごとに更新されることもある。この動的な性質は、継続的な更新をシームレスに扱えるツールを必要とします。
構造化データと非構造化データ
学術研究では構造化データに焦点を当てることが多いが、実世界のアプリケーションでは非構造化データを扱うことが多い。この変化により、より洗練されたデータ処理技術が要求される。このような非構造化データを管理するためには、Milvusや Zilliz Cloud (フルマネージドMilvus)のようなデータストレージ、インデックス作成、検索用の専用ベクターデータベースが必要です。
モデルの複雑化
MLモデルは、より多くのパラメータとより深いアーキテクチャを持ち、ますます複雑になってきています。このような複雑なモデルを管理するには、モデルに合わせて拡張できるツールが必要です。
アプリケーションコードとの統合
産業環境では、MLモデルはアプリケーションコードとスムーズに統合する必要があり、摩擦なく連携するパッケージやフレームワークのまとまったエコシステムが必要です。
XetHub による機械学習のための Git の機能拡張
XetHubは、大規模なデータセットとモデルを効率的に管理するためにGitの機能を拡張することで、スケーラビリティの課題に取り組んでいます。どのような違いがあるのかを紹介しよう:
ファイル数に制限がない: 従来のGitは大量のファイルを扱うのに苦労していましたが、XetHubはこの制限を取り除き、ファイル数に関係なくシームレスなスケーリングを可能にします。
不変スナップショット: XetHubは不変スナップショットを作成し、堅牢なML開発に不可欠なデータの一貫性と再現性を保証します。
効率的なデータ管理: XetHubは、大規模なデータセットを転送する代わりに、メタデータとポインタを管理することで、システムの高速化と効率化を実現し、時間とリソースを節約します。
機械学習プロジェクトにおける観測可能性の達成
観測可能性はMLのモデルやシステムにとって非常に重要であり、デバッグ、反復、モデルの改善に必要な可視性を提供します。以下は、MLプロジェクトで観測可能性を高めるためのいくつかの提案です:
データの要約
**データから始めよう。これはデータセットの経時的な変化を理解する上で非常に重要である。例えば、データセットAが異なる時点で異なる分布を持っている場合、要約があれば、これらの変化に基づいて情報に基づいた意思決定を行うことができる。
モデルの指標と動作
**例えば、MLモデルの特徴の重要度を追跡することで、どの特徴が予測の原動力となっているかがわかります。特徴の重要度の変化は、トレーニングデータのシフトやアーキテクチャの変更を示している可能性があります。このようにモデルを深く理解することで、迅速なデバッグと改善が可能になります。
コンピュートとオペレーション
**データ、コード、成果物、その他の資産に関わらず、全ての操作はコミットや変更毎に保存されるべきです。この包括的な追跡は、MLの完全な観測可能性を可能にし、効率性、トレーサビリティ、同じプロセスの異なる実行間での再現性を保証します。
現代の機械学習におけるベクトルデータベースの役割
MilvusやZilliz Cloud(フルマネージドMilvus)のようなベクトルデータベースは、テキスト、ビデオ、オーディオ、画像のような非構造化データの高次元データ-数値表現(ベクトル埋め込みとしても知られている)を保存、インデックス付け、検索するデータ管理システムの一種である。類似検索](https://zilliz.com/learn/vector-similarity-search)、意味検索、推薦システム、検索拡張生成(RAG)、その他多くのユースケースで広く使用されている。
MLモデルとデータセットがより複雑になるにつれ、膨大な量の高次元データの管理と検索はますます困難になっている。ベクターデータベースはこの課題に対処し、従来のデータベースでは対応できないソリューションを提供する。
検索拡張世代 (RAG)
ベクトルデータベースの最もエキサイティングなアプリケーションのひとつが、検索拡張生成(RAG)である。このテクニックは大規模言語モデル(LLMs)のパワーと効率的なベクトルデータ検索を組み合わせたものである。RAGのセットアップでは、入力クエリは、OpenAIのテキスト埋め込みモデルのような機械学習モデルを使用してベクトルに変換され、Milvus.のようなベクトルデータベースに格納されているベクトルの膨大なコレクションに対して検索される。最も関連性の高い結果が取得され、LLMに供給され、より正確で文脈に関連した応答を生成できるようになる。このアプローチは、LLMにおける幻覚の問題を緩和するだけでなく、データセキュリティの問題を心配することなく、プライベートなデータセットや専有データセットの可能性を利用することを可能にする。
研究と産業界のギャップを埋める
研究に特化したMLから実世界のアプリケーションへの移行は、しばしば非構造化で動的なデータの取り扱いを伴う。ベクターデータベースは、MLモデルを最新のデータに継続的に適応させることができるため、この課題に対応できる独自の機能を備えています。この適応性により、基礎となるデータが進化しても、モデルが適切かつ効果的であり続けることが保証されます。
例えば、商品説明やカスタマーレビューが常に更新されるe-commerceでは、Milvusのようなベクトルデータベースは最も適切な情報を素早く取得することができ、MLモデルが最新の推奨や洞察を提供することを可能にする。
XetHubのようなツールとのシームレスな統合
XetHubのペタバイトスケールのデータ管理能力は、ベクトルデータベースの強みを補完する。不変のスナップショットを作成し、メタデータを効率的に管理することで、XetHubは大規模なMLプロジェクトがスケールしてもデータの整合性とバージョン管理を維持することを保証します。ベクターデータベースは、様々な機械学習モデルやXetHubのようなツールと統合することができ、特にRAGのような情報検索の精度と関連性が最も重要なシナリオにおいて、MLモデルの開発と展開をサポートします。
結論
Rajat Arya氏の議論は、機械学習における重要な課題と、モデルとデータを管理しバージョンアップするためのより良いツールの必要性を強調しました。XetHubは、膨大なデータセットを効率的に扱うためにGitの機能を拡張することで、これらのニーズに対応している。
機械学習が進歩し続けるにつれて、観測可能性とデータ管理のための堅牢なツールを持つことは非常に重要になります。XetHubのようなソリューションとベクターデータベースや機械学習モデルを組み合わせることで、MLプロジェクトの有効性を高めることができます。このような組み合わせは、研究から実世界での応用へのスムーズな移行をサポートし、AI開発をより実用的で信頼性の高いものにします。
その他のリソース
YouTubeでラジャト・アリヤのMeetup講演を再生。
ベクターデータベースとは何か、どのように機能するのか](https://zilliz.com/learn/what-is-vector-database)
検索拡張世代(RAG)とは何か](https://zilliz.com/learn/Retrieval-Augmented-Generation)
あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
AI・ベクトルデータベース・ML学習センター】(https://zilliz.com/learn)

読み続けて
A Few Notes from Databricks Data + AI Summit 2026: Why the Data Layer Matters Again
James Luan shares notes from Databricks Data + AI Summit 2026 on why production AI is pushing the data layer back to the center of infrastructure.
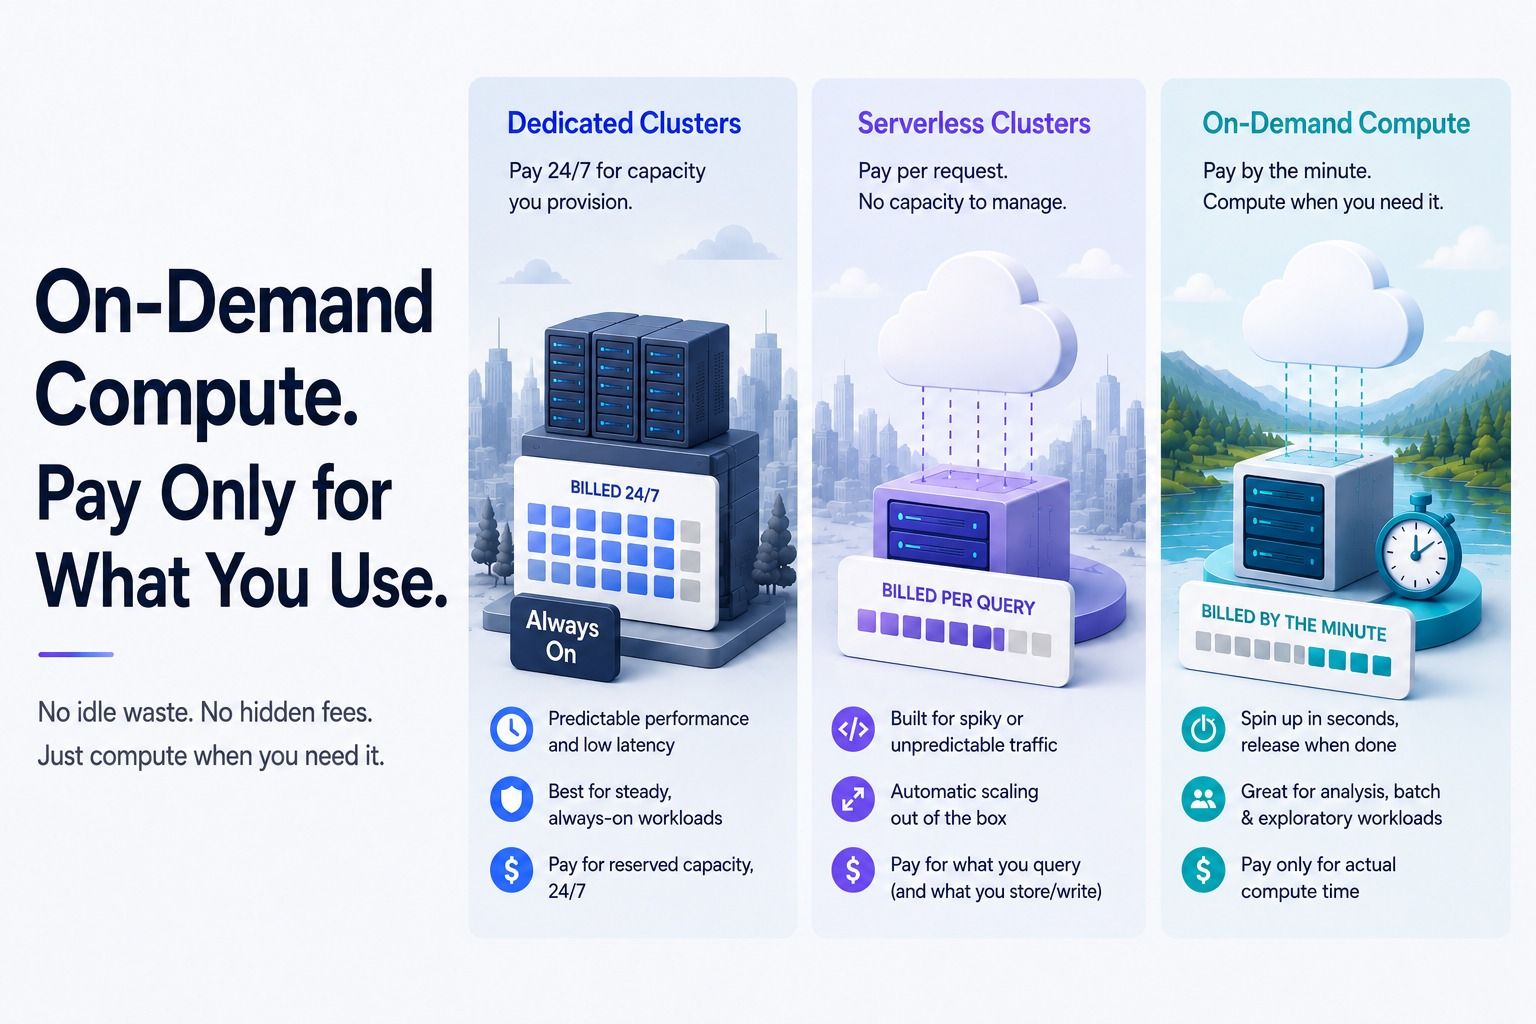
Zilliz Cloud On-Demand Compute: Pay Only for What You Use
The customer case behind Zilliz Cloud On-Demand: how a $10K vector search bill came down to under $500, and the engineering changes that made it possible.
How to Install and Run OpenClaw (Previously Clawdbot/Moltbot) on Mac
Turn your Mac into an AI gateway for WhatsApp, Telegram, Discord, iMessage, and more — in under 5 minutes.