




Milvus 2.6.x が Zilliz Cloud で一般提供開始、本番 AI 向けのベクトル検索をより高速、スマート、コスト効率良く
Milvus 2.6.x はオープンソースコミュニティでしばらく前から利用可能になっており、急速に人気のアップグレード先となっています。ユーザーは、よりスムーズなデータ取り込み、より優れたパフォーマンス、改善されたコスト効率、そしてより高性能なハイブリッド検索のためにこれを採用してきました。Milvus 2.6.x がアップストリームでリリースされるとすぐに、多くの Zilliz Cloud ユーザーから同じ質問が寄せられるようになりました。「Zilliz Cloud 上で Milvus 2.6.x を本番環境で実行できるのはいつですか?」
本日、Milvus 2.6.x が Zilliz Cloud 上で正式に Generally Available(GA)となり、すべてのお客様がすぐに利用を開始できることをお知らせできるのを大変嬉しく思います。 このリリースは、Milvus 2.6.x の全機能セットを当社のフルマネージドクラウド環境にもたらすだけでなく、セルフマネージド環境では実現できないレベルにパフォーマンス、安定性、効率を高める一連の クラウド限定の最適化 も導入します。
本番グレードの RAG システム、会話型エージェント、レコメンデーションエンジン、エンタープライズナレッジプラットフォーム、その他あらゆる AI 駆動型アプリケーションを急速に構築、プロトタイピング、または運用しているチームにとって、Zilliz Cloud 上で Milvus 2.6.x を実行することは、フルマネージドサービスの容易さ、信頼性、コスト効率とともに Milvus の最新機能にアクセスできることを意味します。これにより、チームはインフラ運用ではなく、構築に集中し続けることができます。
Milvus 2.6.x が重要な理由 — そして Zilliz Cloud で特別な点
Milvus 2.6.x は、本番環境のベクトル検索にとって大きな前進であり、より高速なインデックス作成、より低いストレージおよびメモリコスト、より優れたテキスト検索、改善された言語サポートをもたらします。システム全体にわたってデータが保存、検索、管理される方法をアップグレードし、大規模な AI ワークロードをより効率的かつ運用しやすくします。
Milvus 2.6.x が Zilliz Cloud 上で GA となったことで、これらすべての改善が、フルマネージドで本番対応の環境において即座に利用可能になりました。そして Zilliz Cloud は Milvus の開発元によって構築・運用されているため、オープンソース版をさらに超えて、自動化、パフォーマンス、信頼性、エンタープライズグレードの安定性に関する多くのクラウド限定の最適化を追加しています。
要するに、Milvus 2.6.x はここ数年で最大の技術的飛躍をもたらし、Zilliz Cloud はそれを、今日から本番環境で実行できるターンキーのスケーラブルなサービスへと変えます。
Zilliz Cloud 上で Milvus 2.6.x を実行する際に期待できる主な機能とメリットを見ていきましょう。
ベクトル検索コストを S3 に近いレベルまで削減する 3 層ティアードストレージ
すべてのデータが同じというわけではありません。実際の AI システムでは、最近のクリック、トレンド商品、頻繁に参照されるドキュメントなど、データのごく一部だけが常にアクセスされます。残りはほとんどの時間アイドル状態です。しかし、多くのベクトルデータベースでは、すべてを高性能(かつ高コスト)なストレージに保存することを強いられ、総所有コストが大幅に膨らみます。
Milvus 2.6.x は 組み込みのティアードストレージ によってこれを変え、Zilliz Cloud はフルクラウドネイティブな 3 層設計でさらに一歩先へ進めます。コーパス全体に対して SSD やメモリの料金を支払う代わりに、データはアクセスパターンに一致するストレージ層へ自動的に配置されます。
具体的には、Zilliz Cloud のティアードストレージクラスターでは、
オブジェクトストレージ(例:S3)が全データセットを保存します
ローカル SSD は、繰り返しアクセスを高速化するウォームキャッシュとして機能します
メモリは、即時応答クエリ向けのホットティアとして機能します
このアーキテクチャはリアルタイムで適応します。トラフィックパターンが変化すると、システムは自動的に各層間でデータを昇格または降格させます。本番テストでは、これにより 90%以上のキャッシュヒット率 が実現され、ほとんどのクエリが高速なメモリまたは SSD から処理されますが、ベースラインのストレージ料金は依然として S3 のように振る舞います。
実際には、ティアードストレージによりストレージコストを 最大 87% 削減し、コンピューティング費用を 25% 削減し、全体的な TCO を実質的に生の S3 料金に近づけることができます。かつて月額約 $3,000 かかっていた 10 TB のデータセットが、現在ではおよそ $400 で実行可能です。それでいて、ホットワークロードに対して一貫して低レイテンシの検索を提供します。
そのため、階層型ストレージクラスターは、明確なホット/コールドデータパターンを持つ超大規模でコストに敏感なアプリケーションに最適です。たとえば、次のようなものです。
ロングテールの商品検索。数百万のSKUが存在するものの、毎日クエリされるのは上位5~10%のみ
全社規模のドキュメントリポジトリ。最新のコンテンツのみが頻繁に検索される
ニュースおよびメディアアーカイブ。現在の記事はホットで、過去のコンテンツはコールド
データ量が予算よりも速く増加するあらゆるワークロード。データの一部のみが高速なインメモリ性能を必要とする
階層型ストレージの料金について詳しくは、Zilliz Cloud docsをご覧ください。
インデックス構築レベル: 検索精度とストレージコストを自動的にトレードオフ
階層型ストレージは、異なるデータを異なる階層に配置することで、すでに生ベクトルの保存コストを削減しています。しかし、生データを安価に保持できるようになっても、ベクトル検索システムには依然として大きなコスト要因が1つ残っています。それがインデックスです。
図書館でカード目録を使うと本を瞬時に見つけられるのと同じように、インデックスは大規模なベクトル検索を高速化します。そして、それらはメモリまたはSSD上に保持されなければなりません。基本的に、結果の精度を高めたいほど、インデックスはより多くの近傍、グラフリンク、メタデータを維持する必要があり、そのサイズは大きくなります。10億規模のワークロードでは、インデックスが生ベクトル自体のサイズを上回ることさえあります。
ただし、すべてのAIアプリケーションが最大の検索精度を必要とするわけではありません。一部のワークロード—不正検知やランキングなど—では、それが絶対に必要です。しかし、ロングテールの商品検索、ログ検索、アーカイブ、実験環境などでは、わずかな精度を犠牲にして、インデックスを大幅に小さくし、コストを下げることができます。これが、精度と容量のトレードオフを制御することが重要な理由です。わずかに精度を落としたインデックスは、劇的に小さく、安価になり、それでも多くのワークロードにとって十分に許容可能であり得ます。
今回のリリースでは、Zilliz Cloudがインデックス構築レベル機能を導入します。これは、AIワークロードに適した精度と容量のバランスを自動的に選択するのに役立ちます。
精度優先: AIを活用した不正検知のようなミッションクリティカルなワークロード向けの最大リコール(精度)。
バランス型(デフォルト): 精度、パフォーマンス、メモリ効率の強力な組み合わせ—ほとんどの汎用AIアプリケーションに最適。
容量優先: ストレージ密度に重点的に最適化。コールドデータ、大規模アーカイブ、または完全なリコールが不要なワークロードに最適。
舞台裏では、Zilliz Cloudが次世代の量子化エンジンを適用し、インデックスの圧縮と構造を動的に調整することで、手動設定を一切必要とせずに、サイズ、精度、コストの理想的なバランスを提供します。
より多くの実世界のAIユースケースに対応する拡張データ型サポート
以前は、AIアプリケーションで位置情報を考慮した検索、時間ベースのフィルタリング、または複雑な構造化エンティティをサポートするには、ベクトルデータベースに加えて、追加のデータベース、GISツール、または重い前処理が必要でした。Milvus 2.6.xは、これらのワークロードをZilliz Cloud内で完全に実行できるようにする、より基盤的なデータ型を追加することで、その複雑さを取り除きます。これにより、開発者がネイティブに構築できるものが広がり、アーキテクチャが簡素化され、運用上のオーバーヘッドが削減されます。
Geometryフィールド(POINT, LINESTRING, POLYGON)
多くの配送、物流、eコマースアプリケーションでは、検索は意味的な関連性と地理空間フィルタリングを組み合わせる必要があります。「この店に似たレストランを1km以内で探す」 や 「近くのEV充電ステーションを取得し、ユーザーの好みに基づいてランク付けする」 といったクエリでは、以前はベクトルデータベースに加えて別個のGISエンジンが必要でした。ネイティブのgeometry型により、Zilliz Cloudでは意味的類似性 + 位置認識を単一のクエリで組み合わせることができます—デプロイや保守が必要な追加システムはありません。
TimestampTz(タイムゾーン対応タイムスタンプ)
時間は、イベント計画や監視システムからログ分析やアラートまで、多くの実世界のAIアプリケーションにおいて重要な次元です。ネイティブな時間サポートがなければ、チームはベクトルデータベースを外部の時系列ストアと組み合わせたり、扱いにくいエンコード戦略を使ったりする必要がありました。TimestampTz により、Zilliz Cloud は現在、時間ウィンドウ付きベクトル検索、最新性を重視したランキング、イベント駆動型検索をサポートし、時間的推論を大幅に簡素化するとともに、ログ、アラート、監視、リアルタイム分析のためのよりクリーンなパイプラインを実現します。
INT8 Vector Type(8ビット埋め込み)
最新の埋め込みモデル、特に E5-base や MiniLM-L12 のような効率重視のモデルは、8ビット埋め込みを生成することがよくあります。以前は、開発者はそれらを float にアップコンバートする必要があり、メモリとストレージを浪費していました。ネイティブ INT8 サポートにより、次のことが可能になります:
より小さなベクトル → ストレージとメモリのコスト削減
より小さなペイロード → スループット向上
前処理やフォーマット変換が不要
これは、エッジAI、軽量モデル、コストに敏感なワークロードにとって特に価値があります。
Struct と Array-of-Structs
実世界のデータは、単純なフィールドのリストだけではありません。製品には複数のサイズや画像があるかもしれませんし、ユーザーには複数の嗜好や行動があるかもしれません。また、ドキュメントにはセクション、タグ、メタデータが含まれる場合があります。以前の Zilliz Cloud リリースでは、このような「データの中のデータ」をモデル化するには、フィールドをフラット化し、情報を重複させる必要がありました。
Struct と Array-of-Structs がネイティブにサポートされるようになったことで、Zilliz Cloud ではリッチでネストされた情報を直接保存およびクエリできます。これにより、複雑なエンティティを実際の姿のまま表現しやすくなり、回避策や追加システムは不要になります。これにより、次のようなユースケースでよりクリーンなモデリングが可能になります。
ネストされた属性を持つ製品カタログ
複数の行動シグナルを持つユーザープロファイル
レイヤー化または階層化されたメタデータを持つドキュメント
テキスト、画像、構造化メタデータを組み合わせたマルチモーダル項目
これらの関係をそのまま保持することで、開発者はよりシンプルなクエリ、少ない結合、そしてより現実的で表現力のあるデータモデルを、すべてベクトルデータベース内で実現できます。
JSON Shredding と JSON Path: より優れた検索精度でメタデータフィルタリングを100倍高速化
eコマース検索やレコメンデーションシステムなどのAIアプリケーションは、ベクトルを保存して取得するだけではありません。製品詳細、ユーザー属性、ドキュメントタグ、イベントログ、嗜好、設定などのメタデータに大きく依存しています。JSON は柔軟で扱いやすいため、通常は自然なフォーマットです。しかし、ほとんどのデータベース(ベクトルデータベースを含む)では、JSON をフィルタリングするには JSON ブロブ全体をスキャンする必要があります。データが増えるにつれて、これらのフィルターはすぐに耐えがたいほど遅くなります。
Zilliz Cloud 上の Milvus 2.6.x は、ネイティブ JSON Shredding と JSON Path によりそのボトルネックを取り除き、ベクトルデータベース内で直接、最大 100倍高速なメタデータフィルタリングを実現します。
JSON Shredding: メタデータはこれまでどおり通常の JSON として保存します。データの書き込み方法は何も変わりません。しかし Zilliz Cloud は内部で JSON を自動的に再構造化し、大規模または複雑なドキュメントであっても、フィルタリングを最大100倍高速化します。JSON の柔軟性を犠牲にすることなく、構造化データベースの速度を得られます。
JSON Path: JSON Path を使うと、JSON 内の特定のキー(
price、category、event.typeなど)にインデックスを作成できるため、それらのフィールドに対するフィルターが即時に実行されます。重要なキーを Zilliz Cloud に指定するだけで、最適化は Zilliz Cloud が処理します。これは、範囲、等価性、カテゴリベースのルックアップなど、予測可能なフィルターに最適です。
JSON Shredding と JSON Path を組み合わせることで、構造化フィルタリングとベクトル検索を1つのシステムに統合し、メタデータフィルタリングを劇的に高速化するとともに、最終的な検索結果の精度を向上させます。この機能は、特に次のような用途で価値があります。
豊富なユーザー属性またはアイテム属性を持つレコメンデーションシステム
メタデータによってドキュメントをフィルタリングまたはルーティングする RAG パイプライン
効率的なセグメンテーションを必要とするマルチテナントアーキテクチャ
そして、リッチなメタデータを備えたその他多くの AI アプリケーション
BM25 に最適化された全文検索:Elasticsearch より最大 7 倍高速
エンタープライズナレッジアシスタント、カスタマーサポートチャットボット、その他多くの RAG ベースの AI アプリケーションは、ベクトル類似度だけに依存しているわけではありません。正確な用語に一致させ、まれなエンティティを扱い、ドメイン固有の言語でフィルタリングし、LLM の応答を正確な事実に結びつけるために、強力な全文検索も必要です。これを実現するため、多くのチームはいまだにベクトルデータベースと並行して Elasticsearch や別のテキストエンジンを運用しており、インフラが倍増し、検索が遅くなっています。
Zilliz Cloud は昨年初め、Milvus 2.5.x GA により、ハイブリッドなキーワード + ベクトル検索を導入しました。Milvus 2.6.x GA では、ベクトル検索と密接に統合された BM25 最適化全文エンジンにより、これをさらに大きく進化させています。
Elasticsearch より 4 倍高速、特定のデータセットでは最大 7 倍高速
インデックスサイズは生テキストのわずか 3 分の 1
1 つのシステムで統合されたキーワード + ベクトル検索
LLM が生成する回答のレイテンシを低減し、より正確なグラウンディングを実現
このアップグレードは、次のような実際の RAG アプリケーションにおいて特に価値があります。
名前、略語、規制、エラーコードの完全一致と組み合わせたセマンティック検索を必要とするエンタープライズナレッジアシスタント
製品名、バージョン番号、設定パラメータ、診断メッセージでドキュメントをフィルタリングする必要があるカスタマーサポートおよびヘルプデスクのコパイロット
さらに多くの用途。
Zilliz Cloud 上の Milvus に BM25 が直接組み込まれたことで、ハイブリッド検索は、別個のテキスト検索スタックを維持することなく、劇的に高速化し、低コストになり、運用が容易になります。
グローバルユーザー向けの多言語サポートを強化し、すべての言語でテキスト検索を改善
AI アプリケーションが複数の国や言語のユーザーにサービスを提供する場合、検索品質は多くの場合、システムがテキストをどれだけ適切にトークン化し理解できるかに左右されます。Milvus 2.6.x では、日本語、韓国語、中国語のような複雑な分かち書きを必要とする言語において、検索精度を大幅に向上させる複数のアップグレードが導入されています。このリリースにより、Zilliz Cloud は最適化されたデフォルト設定とシームレスな統合を通じて、これらの機能を本番環境に直接提供します。
Zilliz Cloud における強化された多言語サポートには、以下が含まれます。
日本語、韓国語、混在言語の分かち書きを劇的に改善する Lindera + ICU tokenizers
カスタム辞書サポート付き Jieba により、チームは特定のドメインや製品語彙に合わせて中国語のトークン化を微調整可能
一貫性があり予測可能な検索品質のために、チームがトークン化の挙動を検査・デバッグできる run_analyzer がクラウド環境で利用可能に
Zilliz Cloud はまた、すべての言語ワークロード向けに一般的なテキスト検索もアップグレードしています。
Phrase Match:設定可能な slop による、正確で順序付けられたフレーズクエリを実現
NGRAM Index:VARCHAR フィールドおよび JSON パス全体で、部分文字列、ワイルドカード、ファジー、部分テキスト検索を高速化
これらの改善により、Zilliz Cloud における多言語および複雑なテキスト検索は、精度と柔軟性が大幅に向上します。グローバルアプリ、e コマースプラットフォーム、カスタマーサポートコパイロット、エンタープライズナレッジアシスタント、そしてユーザーが言語や表記スタイルに関係なく信頼性の高い検索を期待するあらゆるシステムに最適です。
Zilliz Cloud 上の Milvus 2.6.x 機能の完全な一覧については、 Milvus release notesをご覧ください。
Zilliz Cloud で Milvus 2.6.x を試す準備はできましたか?
新しい Milvus 2.6.x のすべての機能は、現在 Zilliz Cloud で完全に利用可能です。
すでに Zilliz Cloud アカウントをお持ちの場合は、sign in するだけで、新機能をすぐに使い始められます。アップグレードや移行は不要です。
Zilliz Cloud は初めてですか?無料でサインアップして、世界をリードするマネージドベクトルデータベースを体験できる $100 のクレジットを獲得しましょう。
いずれかのアップデートについてご質問がありますか?最新のドキュメントを確認するか、Zilliz Supportまでお問い合わせください—Zilliz Cloud 上で Milvus 2.6.x を最大限に活用できるよう、私たちがお手伝いします。
制限なく構築:Zilliz Cloud のエンタープライズ対応機能を詳しく見る
Zilliz Cloud 上での Milvus 2.6.x の GA により、このプラットフォームは、最も高性能で、コスト効率が高く、安全なフルマネージドベクトルデータベースサービスとしての地位をさらに強固にします—同時に、Milvus の高度な AI 検索機能の全パワーを、運用の手間がかからないエンタープライズ対応環境で提供します。
エラスティックスケーリングとコスト効率 – ワンクリックデプロイ、サーバーレスオートスケーリング、従量課金制。
高度な AI 検索 – メタデータフィルタリング、動的スキーマ、マルチテナンシーを備えた、ベクトル、全文、ハイブリッド(スパース + デンス)検索。
エンタープライズグレードの信頼性とセキュリティ – 99.95% SLA、SOC 2 Type II および ISO 27001 認証、GDPR 準拠、HIPAA 対応、RBAC、BYOC、監査ログ、ビジネスクリティカルプラン、そして今回グローバルクラスター。詳細については、当社のトラストセンターをご覧ください。
グローバル可用性 – AWS、GCP、Azure 全体でのデプロイにより、世界中で 100ms 未満のレイテンシを実現。
シームレスな移行 – Pinecone、Qdrant、Elasticsearch、PostgreSQL、OpenSearch、AWS S3 vectors、Weaviate、またはオンプレミスの Milvus から移行するための組み込みツール。
自然言語クエリ – 複雑な API なしで直感的なクエリを可能にする MCP server サポート。
これらの機能を総合すると、Zilliz Cloud は単なるベクトルデータベースを超えた存在です — 制限なく AI アプリケーションを構築し、スケールするための、フルマネージドで本番対応のプラットフォームです。

読み続けて
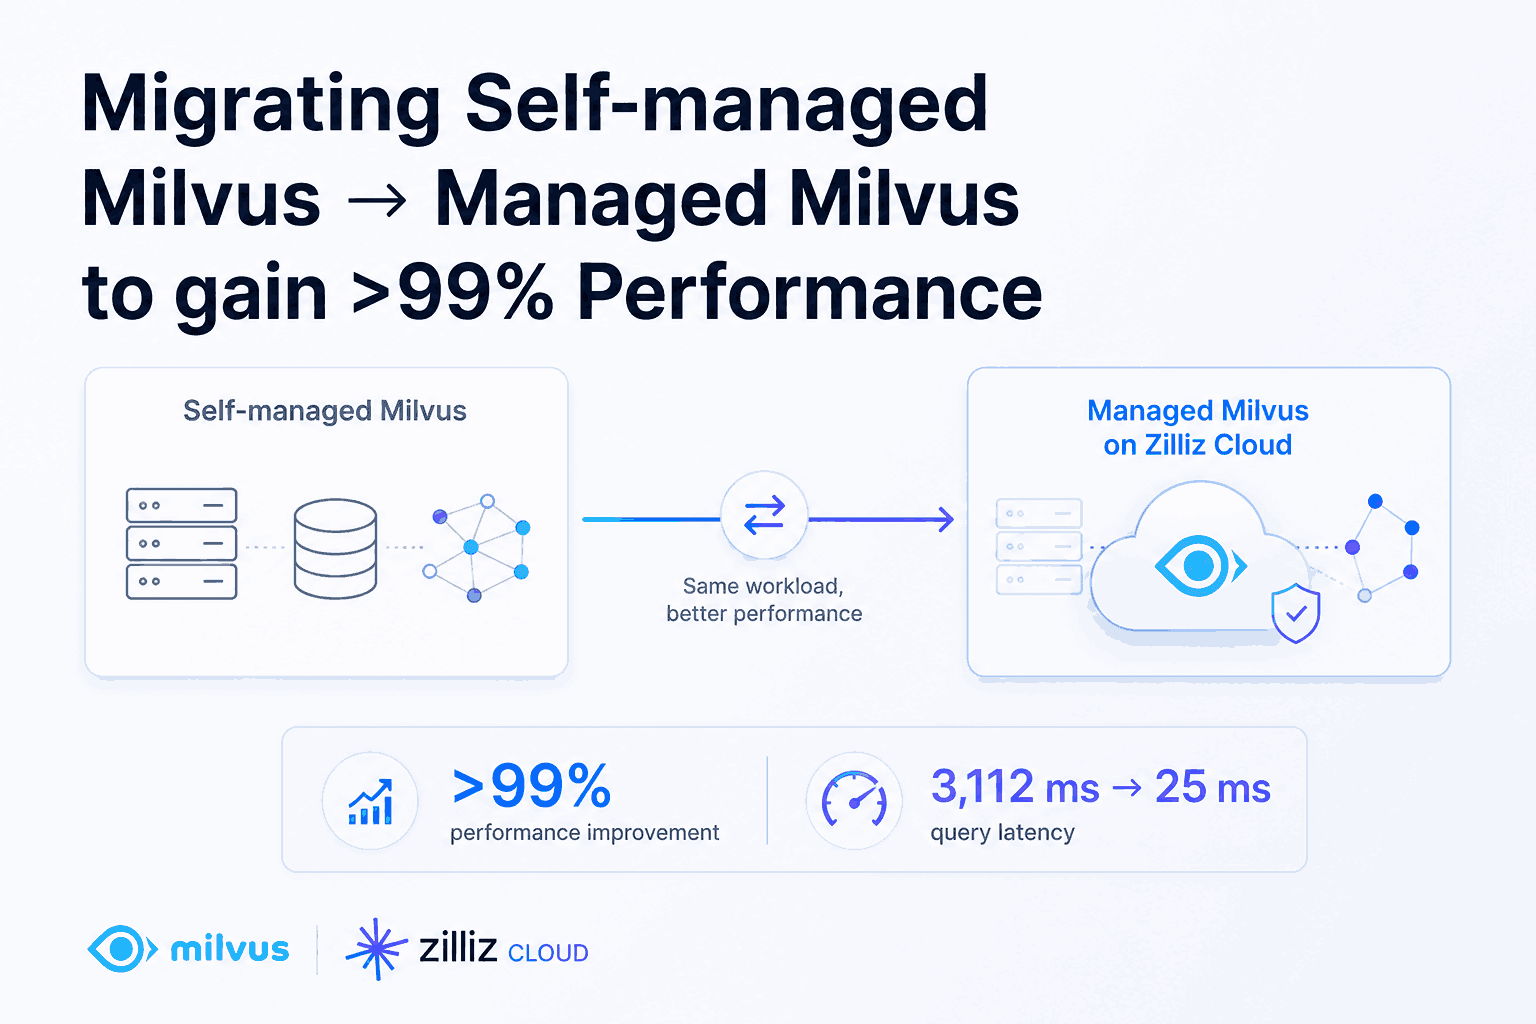
Migrating Self-Managed Milvus to Zilliz Cloud for >99% Latency Reduction
Step-by-step guide to migrating 50M vectors from self-managed Milvus to Zilliz Cloud using milvus-backup. Achieve >99% query latency reduction with zero data loss.
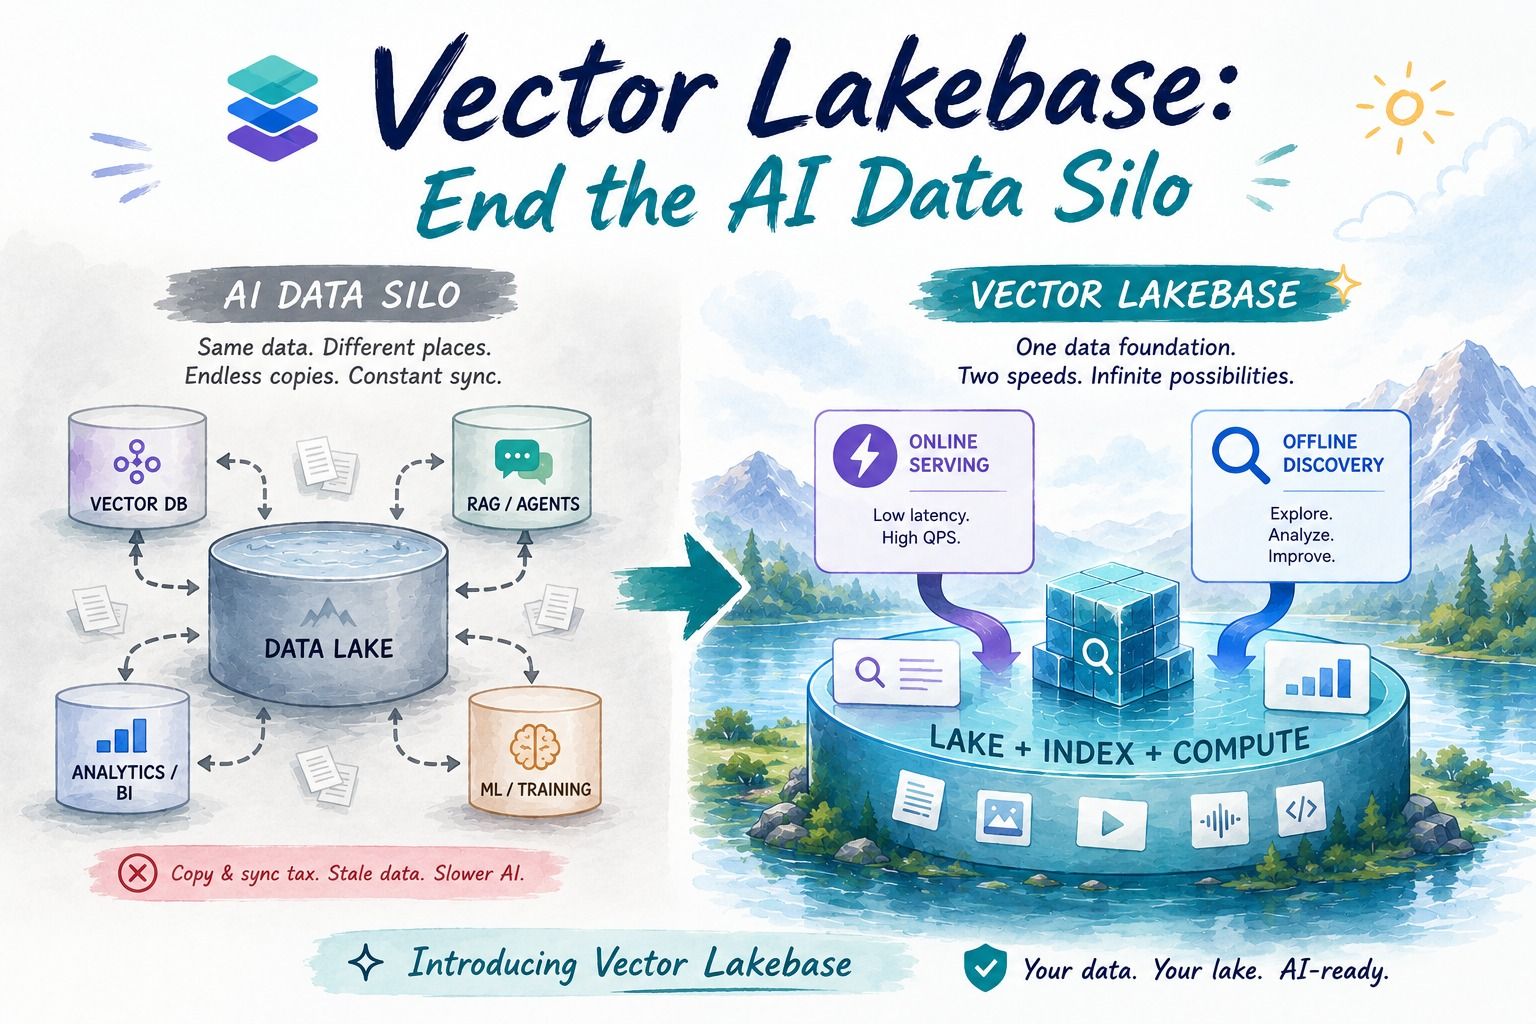
Vector Lakebase: End the AI Data Silo
Learn how Vector Lakebase unifies vector search, data lakes, and AI data operations so teams can serve RAG and agents without copy-and-sync pipelines.
Zilliz Cloud Now Available in AWS Asia Pacific (Seoul)
Zilliz Cloud is now available in AWS Seoul — low-latency vector search, in-country data residency, and one-step migration for Korean AI teams. 31 regions across 5 clouds.