




Couchbase vs pgvector AIアプリに適したベクターデータベースの選択
ベクターデータベースとは?
Couchbaseとpgvectorを比較する前に、まずベクターデータベースの概念を探ってみましょう;
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするように設計されています。これは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品属性などの複雑な情報を符号化する。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLMs)の性能を向上させる技術であるRAG(Retrieval Augmented Generation) において重要な役割を果たす。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Couchbaseは分散マルチモデルNoSQL文書指向データベースで、ベクトル検索をアドオンとして備えている。この記事では、両者のベクトル検索機能を比較する。
Couchbase:概要とコアテクノロジー
Couchbaseは分散型オープンソースのNoSQLデータベースで、クラウド、モバイル、AI、エッジコンピューティング向けのアプリケーション構築に利用できる。リレーショナルデータベースの強みとJSONの汎用性を兼ね備えている。Couchbaseはまた、ベクトルインデックスをネイティブサポートしていないにもかかわらず、ベクトル検索を実装する柔軟性を提供する。開発者は、ベクトル埋め込み-機械学習モデルによって生成された数値表現-をJSON構造の一部としてCouchbaseドキュメント内に格納することができる。これらのベクトルは、高次元空間で互いに近いデータポイントを見つけることが重要であるセマンティック検索に基づく推薦システムや検索拡張生成などの類似検索のユースケースで使用することができます。
Couchbaseでベクトル検索を可能にする1つのアプローチは、全文検索(FTS)を活用することです。FTSは一般的にテキストベースの検索用に設計されていますが、ベクトルデータを検索可能なフィールドに変換することで、ベクトル検索に対応させることができます。例えば、ベクトルをテキストライクなデータにトークン化することで、FTSはそれらのトークンに基づいてインデックスを作成し、検索することができる。これにより、近似ベクトル検索が容易になり、類似性の近いベクトルを持つ文書に問い合わせる方法を提供することができる。
あるいは、開発者は生のベクトル埋め込みをCouchbaseに保存し、アプリケーションレベルでベクトルの類似度計算を実行することができます。これは、ドキュメントを取得し、ベクトル間のコサイン類似度やユークリッド距離などのメトリックを計算し、最も近い一致を識別することを含む。この方法では、アプリケーションが数学的比較ロジックを処理する間、Couchbaseはベクトルのストレージソリューションとして機能することができます。
より高度なユースケースのために、一部の開発者は、効率的なベクトル検索を可能にする特殊なライブラリやアルゴリズム(FAISSやHNSWのような)とCouchbaseを統合しています。これらの統合は、外部ライブラリが実際のベクトル比較を実行しながら、Couchbaseがドキュメントストアを管理することを可能にします。このように、Couchbaseはまだベクトル検索をサポートするソリューションの一部であることができます。
これらのアプローチを使用することで、Couchbaseはベクトル検索機能を扱うように適応させることができ、類似検索に依存する様々なAIや機械学習タスクのための柔軟な選択肢となる。
pgvector概要とコアテクノロジー
pgvectorはPostgreSQLの拡張で、ベクトル操作のサポートを追加します。これにより、ユーザはPostgreSQLデータベース内に直接ベクトルの埋め込みを保存し、問い合わせることができます。
pgvectorの主な機能は以下の通りです:
- 厳密および近似最近傍探索のサポート
- PostgreSQLのインデックス機構との統合
- 加算や減算のようなベクトル演算の実行機能
- 様々な距離メトリック(ユークリッド、余弦、内積)のサポート。
pgvectorはデフォルトで正確な最近傍探索を採用しており、完全な再現を保証しますが、大規模なデータセットでは遅くなる可能性があります。性能を最適化するために、pgvectorは近似最近傍探索のインデックスを作成するオプションを提供しています。このアプローチは、多くの実世界のアプリケーションにおいて、しばしば価値のあるトレードオフです。
注意すべき点は、近似インデックスを追加するとクエリの結果が変わる可能性があるということです。これは、実際に返される結果に影響を与えない一般的なデータベースインデックスとは異なります。pgvectorでサポートされる2種類の近似インデックスがあります:
1.HNSW (Hierarchical Navigable Small World):pgvectorバージョン0.5.0で導入されたHNSWは、その高い性能と結果の品質で知られています。HNSWは多層グラフ構造を構築し、検索時の高速な走査を可能にします。 2.IVFFlat (Inverted File Flat):ベクトル空間をクラスタに分割する手法。検索時には、まず最も関連性の高いクラスターを特定し、そのクラスター内で厳密な検索を行う。これにより、大規模なデータセットの検索を大幅に高速化することができる。
これらのインデックス・タイプの選択は、データセット・サイズ、要求されるクエリ速度、精度の許容可能なトレードオフなどの要素を考慮し、特定のユースケースに依存する。HNSWは一般的にパフォーマンスが高いが、より多くのメモリを使用する可能性がある。
プロジェクトでpgvectorを実装する際には、両方のインデックスタイプとそのパラメータを試して、特定のニーズに最適な構成を見つけるようにしてください。この微調整のプロセスは、ベクトル検索操作の性能と精度に影響を与えます。
pgvectorの使い方を知りたいですか?チュートリアル](https://zilliz.com/blog/getting-started-pgvector-guide-developers-exploring-vector-databases)をご覧ください!
主な違い
ベクトル検索のためのCouchbase対pgvector
検索方法
pgvectorはPostgreSQLで直接ベクトル演算を行い、複数の距離メトリクスで厳密および近似最近傍探索を行います。パフォーマンスのためにHNSWとIVFFlatインデックスを使用。Couchbaseは間接的なアプローチをとり、ベクトルデータ用にFull Text Searchを適応させるか、開発者がアプリケーションレベルでベクトル計算を行う必要がある。CouchbaseとFAISSを統合してベクトル演算を行うチームもある。
データハンドリング
CouchbaseはベクトルをJSONドキュメントに格納し、スキーマの柔軟性と半構造化データをサポートする。pgvectorはPostgreSQLのリレーショナルフレームワークで動作し、ベクトルは通常のテーブルに構造化データと一緒に格納することができます。これは、ベクトル操作でSQLクエリを使用できることを意味します。
スケーラビリティと性能
Couchbaseの分散アーキテクチャは、ノード間で水平スケーリングを可能にしますが、ベクトル検索のパフォーマンスは実装に依存します。pgvectorの性能はPostgreSQLでスケールし、HNSWインデックスはメモリ使用量が多くても高速であり、IVFFlatはメモリ効率は良いが遅い。
柔軟性とカスタマイズ
Couchbaseはベクトル検索の実装方法に柔軟性があり、FTSを適応したり、アプリケーションで計算したり、外部ライブラリを統合したりできます。pgvectorは組み込みのベクトル操作でより構造化されたアプローチを提供しますが、カスタマイズオプションはPostgreSQLの機能とインデックスパラメータに制限されます。
統合とエコシステム
pgvectorはPostgreSQLのエコシステムとうまく統合されており、既存のツール、フレームワーク、知識を活用することができます。Couchbaseはベクトル検索のために余分なセットアップを必要とするが、クラウドやエッジコンピューティングではうまく機能する。その柔軟性により、AIや機械学習ワークフローとの複数の統合パターンが可能です。
使いやすさ
pgvectorは、既にPostgreSQLに慣れ親しんでいるチームにとってよりシンプルな実装であり、ベクトル操作はデータベースにネイティブである。Couchbaseは、より多くの初期設定とベクトル検索の実装に関する決定を必要としますが、そのJSONドキュメントモデルは、一部の開発者にとってより直感的かもしれません。
セキュリティ
どちらのシステムも親データベースからセキュリティを継承している。ドキュメントにはセキュリティの比較は記載されていませんが、セキュリティの必要性に応じて、認証、暗号化、アクセス制御を検討する必要があります。
Couchbase*** を選択するとき
クラウドとエッジコンピューティング環境での混合ワークロードを処理できる分散NoSQLシステムが必要な場合、Couchbaseを選択する。ベクトル検索の実装に柔軟性を求め、既存のJSONベースのアプリケーションを持っているチームに最適です。Couchbaseは、水平方向に拡張する必要があり、フルテキストサーチの適応やFAISSのような特殊なライブラリとの統合など、ベクトル検索のアプローチをカスタマイズする能力を必要とするプロジェクトに適しています。
pgvector** を選択する場合
pgvectorは、PostgreSQL環境でネイティブなベクトル操作が必要な場合や、従来のSQL機能とベクトル検索を組み合わせたい場合に適した選択です。特に、既にPostgreSQLを使用しているチームや、組み込みのインデックスオプションを使用した正確または近似最近傍検索を必要とするアプリケーション、直接的なベクトル操作が重要なプロジェクトに適しています。ベクトル検索アプローチの完全な柔軟性よりも実装の単純さを重視する場合はpgvectorを選択してください。
結論**
Couchbaseは柔軟なJSONドキュメントモデルと適応可能なベクトル検索実装で分散環境に優れており、pgvectorはPostgreSQL統合と組み込みインデックスオプションでネイティブなベクトル操作を提供します。あなたの選択は、既存のインフラ、スケーリングニーズ、組み込みのベクトル操作(pgvector)と実装の柔軟性(Couchbase)のどちらを好むかによって決まります。最終的な決定を下す際には、チームの専門知識、開発スケジュール、特定のパフォーマンス要件を考慮してください。
Couchbaseとpgvectorの概要を知るにはこれを読んでほしいが、これらを評価するにはユースケースに基づいて評価する必要がある。それに役立つツールの1つが、ベクターデータベースを比較するためのオープンソースのベンチマークツールであるVectorDBBenchだ。最終的には、独自のデータセットとクエリパターンを使って徹底的なベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力だが異なるこれら2つのアプローチのどちらを選ぶかを決める鍵となるだろう。
オープンソースのVectorDBBenchを使ってベクトルデータベースを評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのためのオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)のような異なるベクトルデータベースシステムを独自のデータセットを使ってテストし比較し、自分のユースケースに合うものを見つけることができます。VectorDBBenchを使えば、ユーザーはマーケティング上の主張や伝聞ではなく、実際のベクターデータベースのパフォーマンスに基づいて決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースのパフォーマンスを簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: オープンソースベクターデータベースベンチマークツール](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
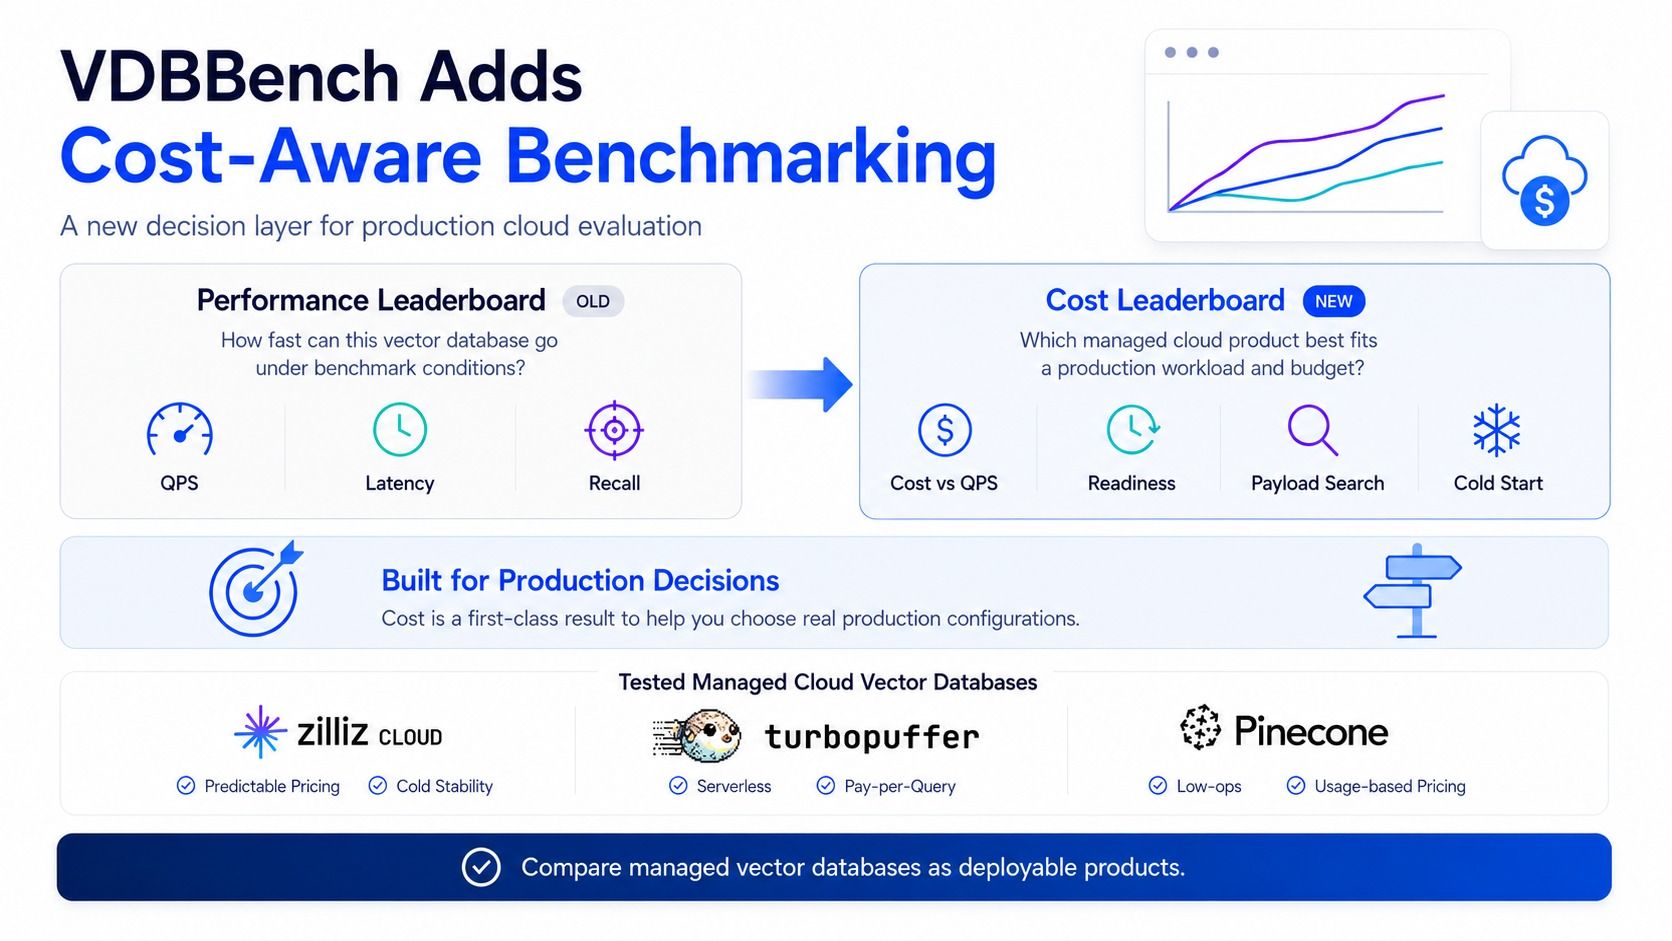
VDBBench Adds Cost-Aware Benchmarking for Vector Databases
Compare Zilliz Cloud, Pinecone, and turbopuffer with VDBBench cost-aware vector database benchmarks across latency, freshness, multitenancy, and cold starts.
Context Engineering Strategies for AI Agents: A Developer’s Guide
Learn practical context engineering strategies for AI agents. Explore frameworks, tools, and techniques to improve reliability, efficiency, and cost.
Expanding Our Global Reach: Zilliz Cloud Launches in Azure Central India
Zilliz Cloud expands to Azure Central India. This new region helps customers meet compliance, reduce latency, and optimize cloud costs when building AI applications.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.