




Latent Semantic Analysis (LSA)
TL;DR
潜在意味解析(LSA)は、テキストコーパス内の用語と文書の関係を明らかにするために使用される自然言語処理(NLP)技術です。用語-文書行列に特異値分解(SVD)を適用することで、高次元のテキストデータを低次元の表現へと削減します。このプロセスにより、データの潜在的な意味構造が捉えられ、文脈上の意味に基づいて類似した単語や文書がグループ化されます。LSAは、文書クラスタリング、情報検索、、トピックモデリングなどのタスクで一般的に使用されます。データ内の隠れたパターンを明らかにすることで、LSAは大規模なテキストデータセットの理解と整理を向上させます。
はじめに
検索エンジンは、あなたが正確な単語を使っていなくても、どうやって探しているものを理解しているのか疑問に思ったことはありませんか?そこで登場するのが潜在意味解析(LSA)です。
LSAは、テキスト内のパターンや関係性を認識することで、単語間の根本的なつながりを特定します。たとえば、「best running shoes」と検索すると、シューズブランドの比較、シューズレビュー、さらにはランニングのコツに関する結果が表示されることがあります。これらはすべて、あなたが使った正確な単語が含まれていなくても、検索内容に関連しています。LSAは、テキスト内のパターンを認識し、単語間の関係を明らかにすることで、これを可能にします。これにより、検索エンジン、レコメンデーションアルゴリズム、AI搭載チャットボットのようなシステムは、単なるキーワードではなく、文脈と意味を理解できるようになります。
では、LSAとは何か、どのように機能するのか、その重要性、利点、課題、応用について詳しく見ていきましょう。
LSAとは?
潜在意味解析は、自然言語処理(NLP)の手法であり、特異値分解(SVD)のような数学的手法を用いて、大規模なテキスト群における単語の関連性や文脈上の意味を特定します。
LSAの起源は1980年代後半にさかのぼります。最初に、テキスト内の隠れた意味構造を明らかにするために適用されました。1988年、Scott Deerwesterと同僚たちは、情報検索のための技術を特許化しました。この技術は、潜在意味インデックス(LSI)と呼ばれる潜在的な意味構造に基づいていました。当時、情報検索の主な方法がキーワード一致だった中で、正確なキーワード一致がなくても関連文書を検索できるようにしたため、これは画期的でした。その代わりに、用語間の根本的な意味的つながりに依存していました。
LSAは、テキスト内の隠れたパターンに気づき、単語やアイデアを意味のある形で結びつける賢い司書のようなものだと考えることができます。
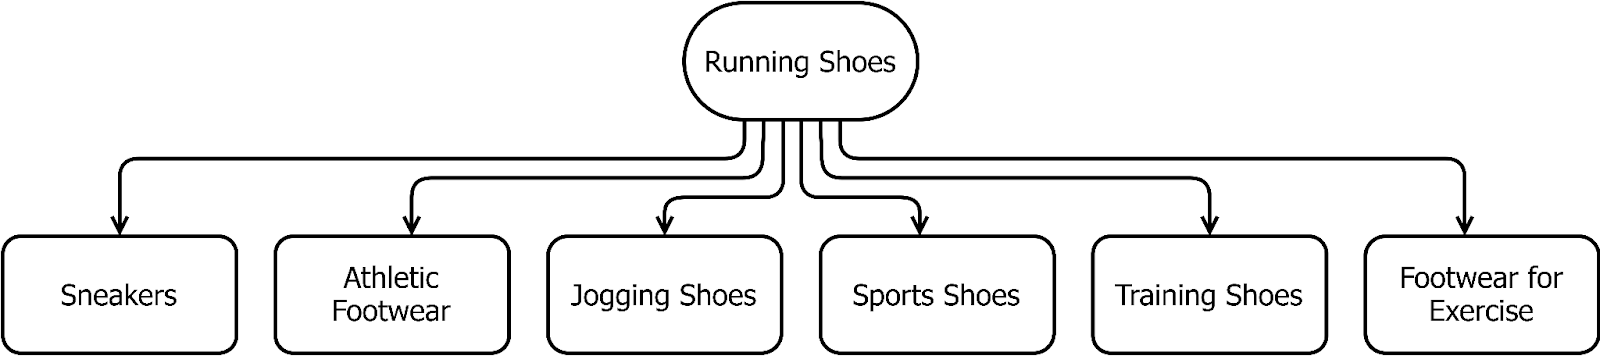 図- ランニングシューズのセマンティックネットワーク
図:ランニングシューズのセマンティックネットワーク
LSAにより、システムは次のことが可能になります。
単語やアイデアの間にある隠れた関係を見つける
テキストをよりよく理解し、情報検索を改善する
関連する用語を結びつけることで検索結果を改善する
大規模なテキストコレクションの中にあるより深い意味を見つける
LSAは、テキスト内の関係や構造を明らかにするためにラベル付きデータを必要としない教師なし学習アプローチです。特異値分解(SVD)を使用して用語-文書行列の次元を削減し、それをより小さな潜在特徴の集合へと変換します。これらの特徴は、データ内で最も重要なパターンを捉え、根本的な意味的関係を浮き彫りにします。
LSAはどのように機能するのか?
LSA には4つのステップがあります。Python ライブラリ scikit-learn を使用して、各ステップの実装を見ていきます。
テキスト前処理
文書-単語行列の作成
特異値分解(SVD)
トピックエンコード済みデータ
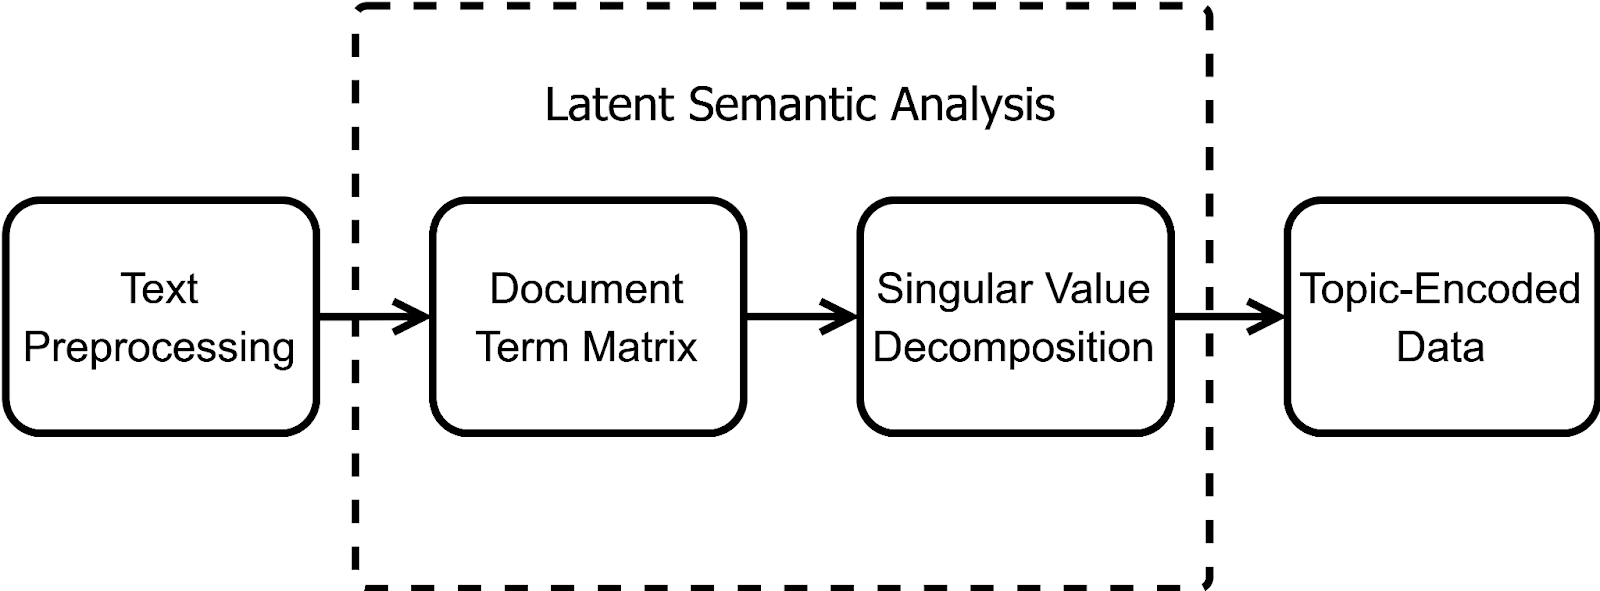 図- LSAのステップ別内訳.png
図: LSAのステップ別内訳
テキスト前処理
生のテキストデータを、リスト内の文字列として保存された文書として準備します。
documents = [
"tall green tree sway",
"short green bush stand",
"tall yellow tree glow",
"short yellow flower bloom”
]
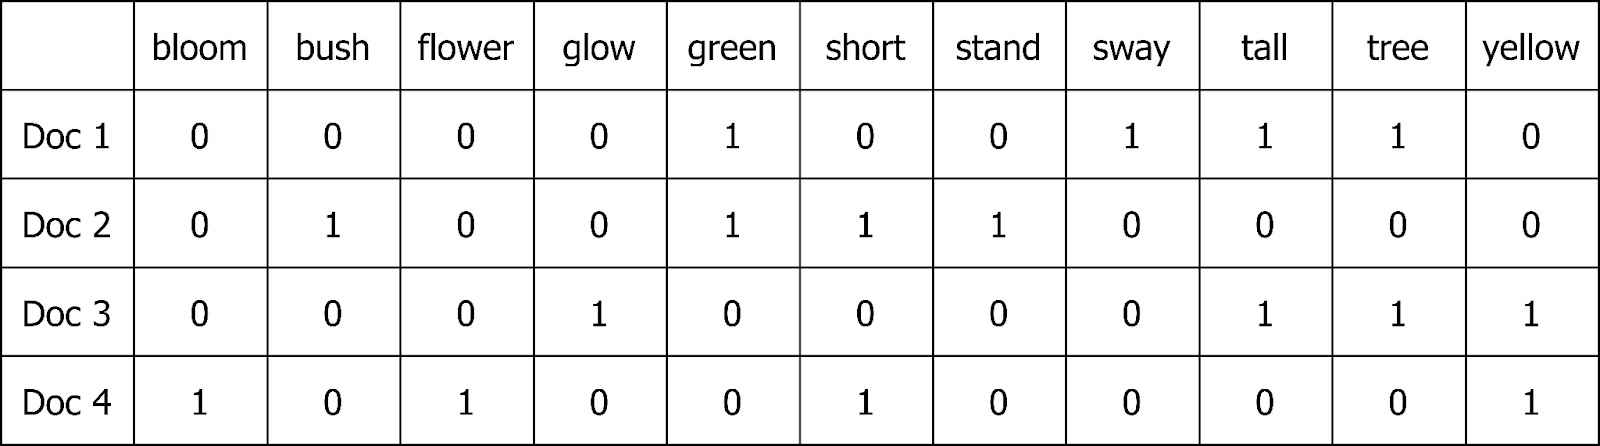 図- 文書-単語行列.png
文書-単語行列
文書-単語行列は、テキスト文書コレクションに出現する単語の頻度を表します。
図: 文書-単語行列
この文書-単語行列は、scikit-learn の CountVectorizer モデルを使用して生成できます。
from sklearn.feature_extraction.text import CountVectorizer
vectorizer = CountVectorizer()
document_term_matrix = vectorizer.fit_transform(documents)
このプロセスにより、各文書は ベクトル に変換されました。
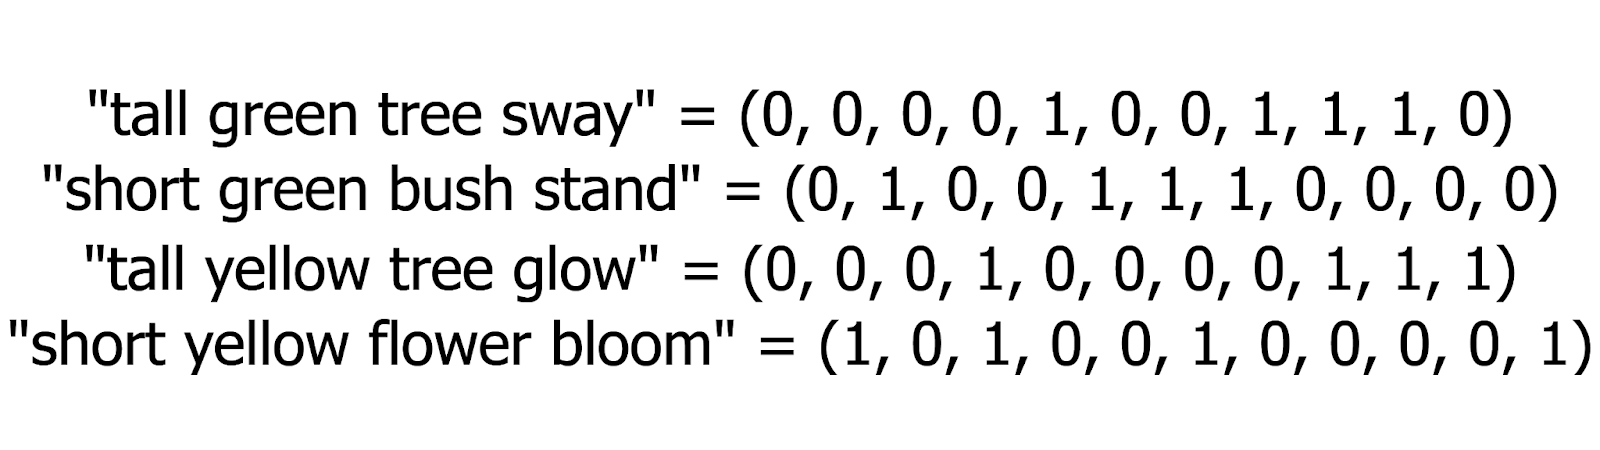 図- 文書からベクトルへ.png
図: 文書からベクトルへ
document_term_matrix.todense() を使用して、文書-単語行列を表示できます。
document_term_matrix.todense()
出力:
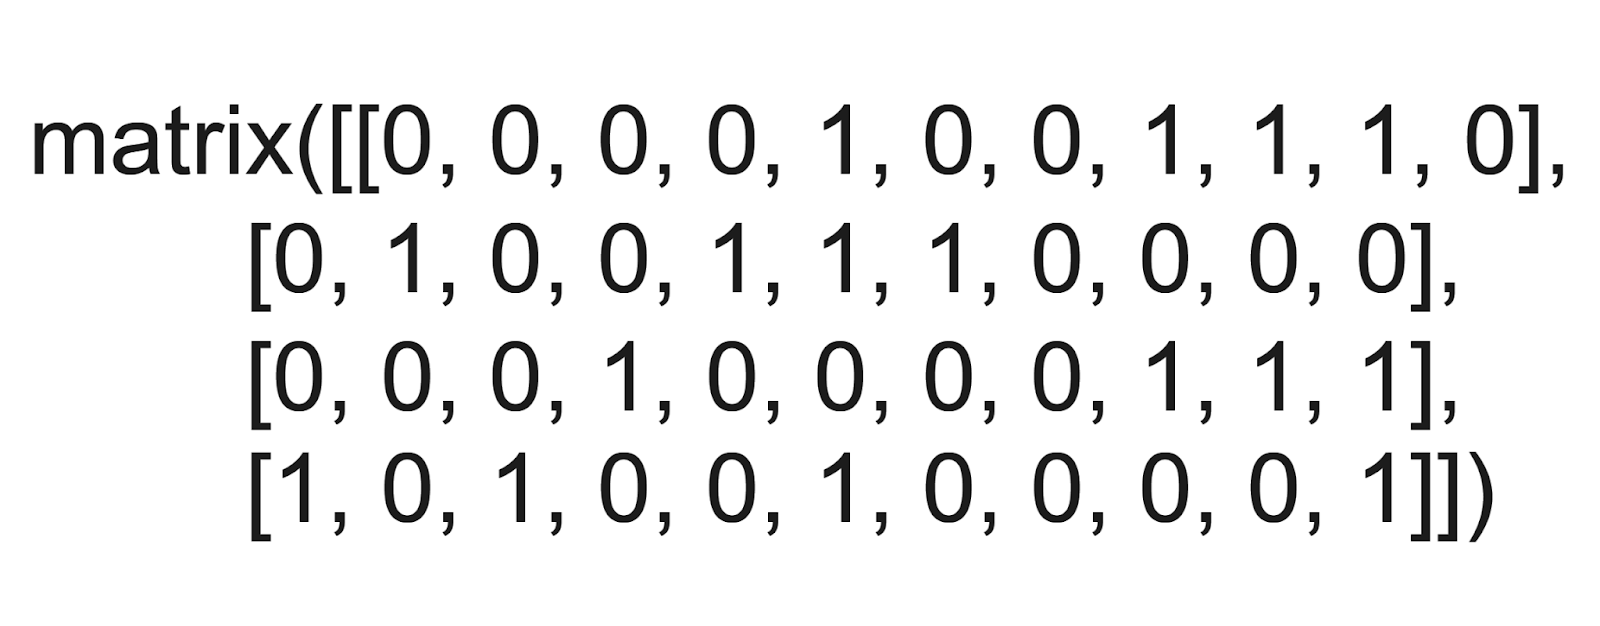 図- 出力
図: 出力
結果として得られる行列では、各行がベクトルとして示されます。各行は文書に対応し、列は単語を表します。値は、各単語が各文書に何回出現するかを示します。
特異値分解
SVD は、複雑なデータセットを単純化するために使用される数学的手法です。SVD は行列 A を3つの別々の行列に分解します。
_A=UΣVT_
A: __文書とその単語頻度を表す文書-単語行列。
U: 各文書が各トピックにどれほど強く関連しているかを示す直交文書-トピック行列。
Σ: トピックの重要度を捉える対角特異値行列。
_VT_: 単語とトピックの関係を示す直交単語-トピック行列。
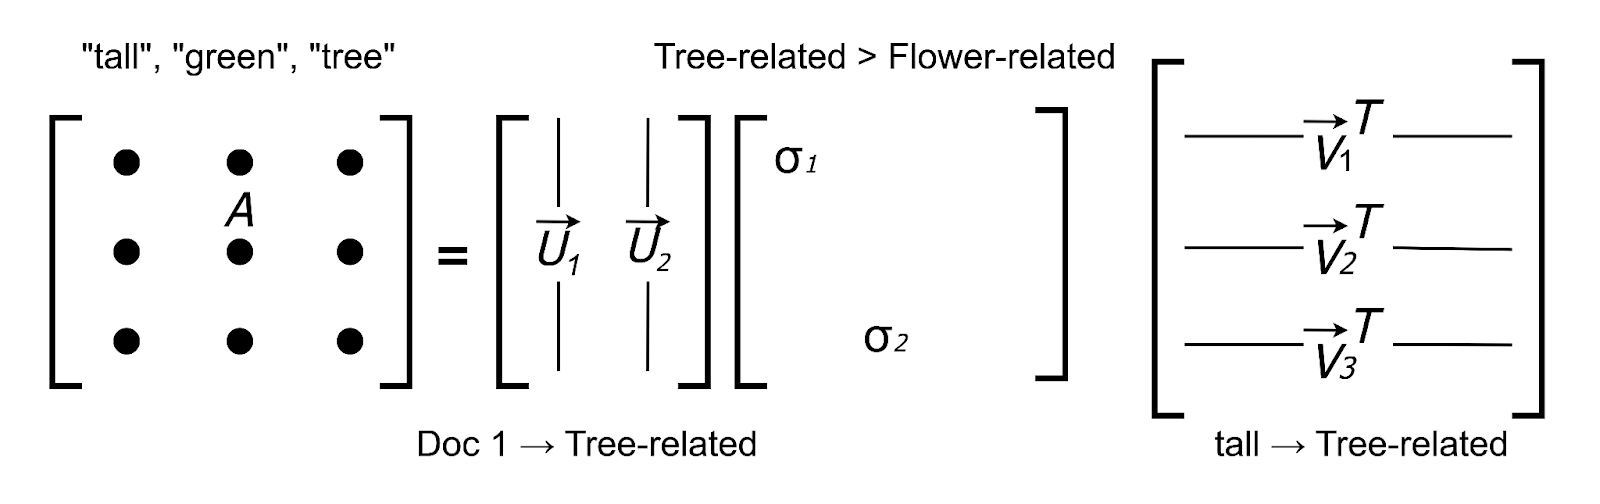 図- このユースケースにおけるSVD
図: このユースケースにおけるSVD
Truncated SVD による次元削減
次元削減 は、SVD に備わった機能です。この手法は、最も重要な情報を保持しながら特徴量の数を減らすことで、データセットを単純化します。
SVD は、scikit-learn の TruncatedSVD モデルを使用して実現できます。データセット内の特徴量数を大幅な情報損失なしに減らすため、「truncated(切り詰められた)」SVD と呼ばれます。これにより、次元削減 のための効果的なツールになります。
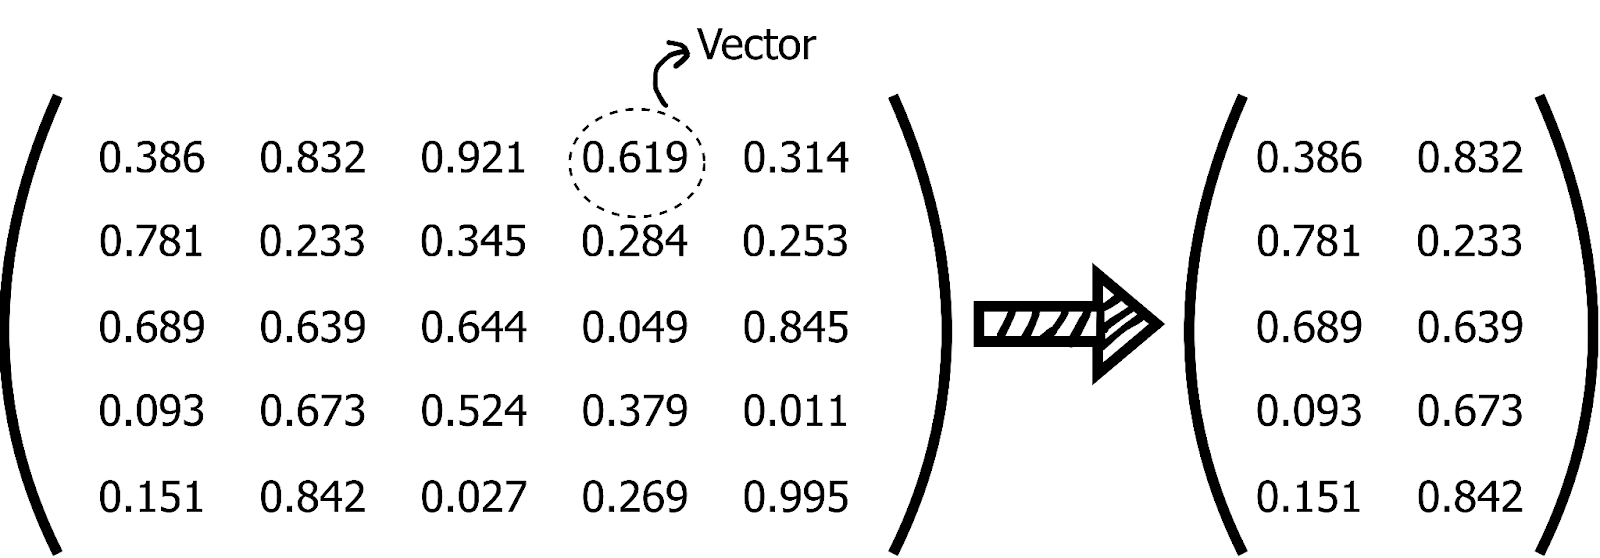 図- 次元削減
図: 次元削減
文書-単語行列に適合させて変換するために、SVD モデルを作成します。
from sklearn.decomposition import TruncatedSVD
svd = TruncatedSVD(n_components=2)
lsa = svd.fit(document_term_matrix)
このプロセスにより、元のデータをトピックエンコード済みデータに変換する準備が整います。2つのトピックを表すために、TruncatedSVD で n_components=2 を設定します。トピックとは、文書全体で頻繁に一緒に出現する単語を表します。
この場合、トピックは木や植物に関連する繰り返し現れるテーマを捉えます。"tall"、"green"、"tree" のような単語が一緒に現れ、これはデータ内の潜在的なパターンを示しています。したがって、SVD はデータを圧縮し、その意味構造を明らかにします。
トピックでエンコードされたデータ
データには現在 2 つの列が含まれています。各列は、TruncatedSVD で指定した 2 つのトピックのうちの 1 つを表します。LSA の出力を見るために、pandas ライブラリを使用します。
import pandas as pd
lsa_transformed = svd.transform(document_term_matrix)
topic_df = pd.DataFrame(lsa_transformed, columns=["Topic 1", "Topic 2"])
topic_df["Original Document"] = documents
print(topic_df[["Original Document", "Topic 1", "Topic 2"]].to_string(index=False))
出力:
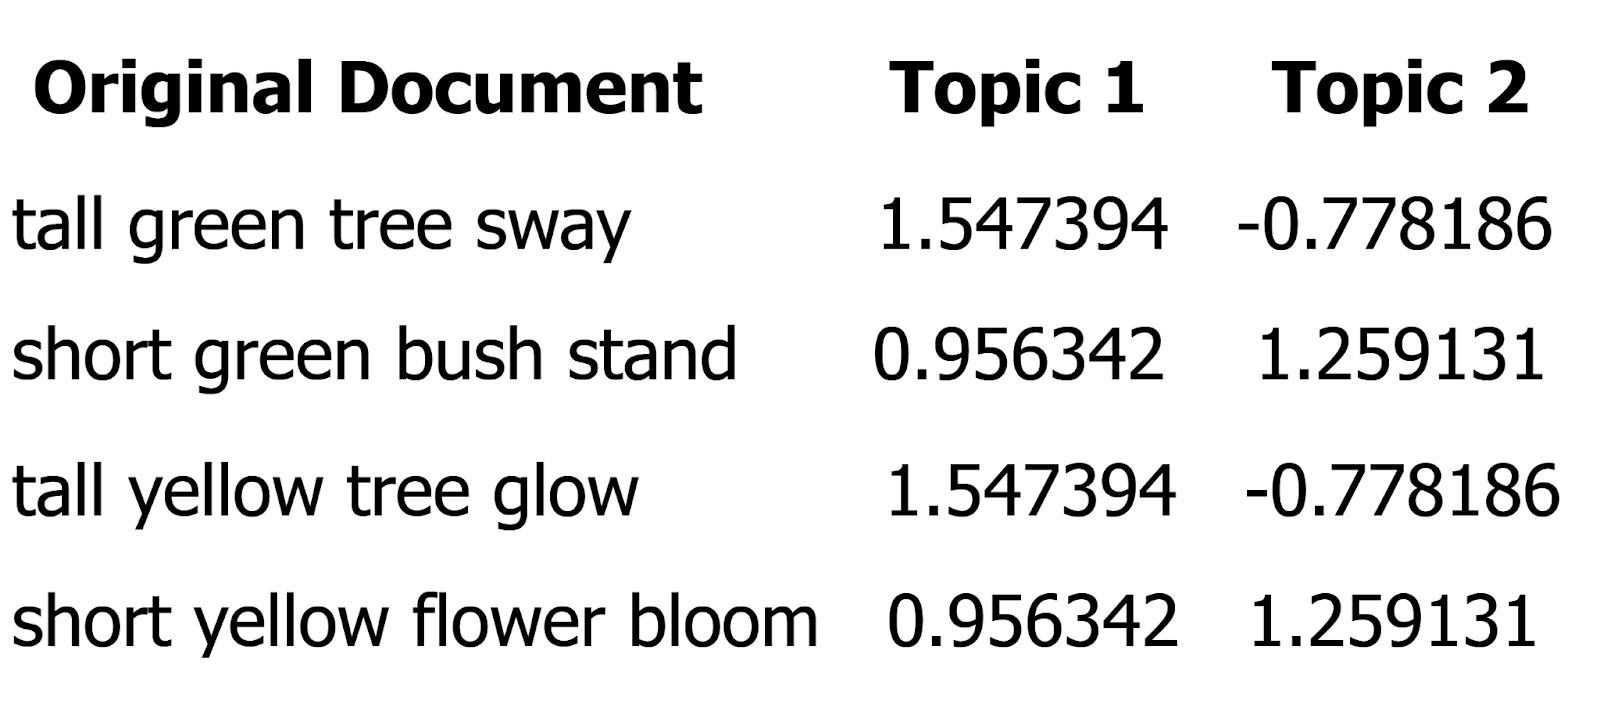
図: 出力
出力には、元の 4 つのドキュメントと数値が並んで表示されています。これらの値は、各ドキュメントが 2 つのトピックにどの程度強く関連しているかを表します。4 つすべてのドキュメントが Topic 1 で強いことがわかります。しかし、Topic 2 には明確な違いがあり、次のようになります。
1 番目と 3 番目のドキュメントは負です。
2 番目と 4 番目のドキュメントは正です。
これは、1 番目と 3 番目のドキュメントが背の高い木に焦点を当てている一方で、2 番目と 4 番目は低い茂みや花に関するものであることを示唆しています。この数値表現により、トピックに基づいてテキスト内のテーマを明確に区別できます。
辞書とエンコーディング行列を通じて各トピックが何を表しているかを理解することで、さらに一歩進めることができます。
辞書とは、ドキュメント内のすべての一意の単語の集合です。
エンコーディング行列は、各単語が各トピックにどの程度強く関連しているかを示します。
辞書の表示
辞書は CountVectorizer モデルの一部であり、.get_feature_names_out() メソッドを通じてアクセスできます。
vocabulary = vectorizer.get_feature_names_out()
print("Dictionary:", vocabulary)
**出力:
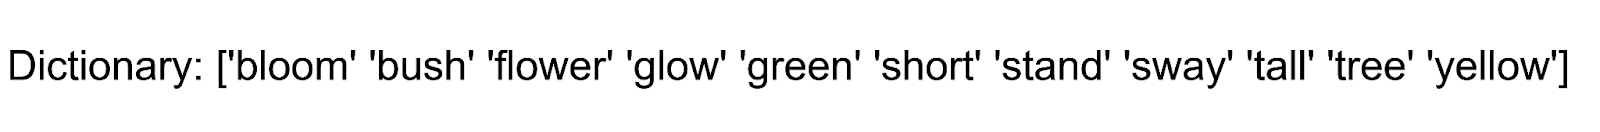
図: 出力
これらの単語は、トピックがどのように構成されているかを分析するための基盤となります。
エンコーディング行列の表示
エンコーディング行列は、TruncatedSVD モデルの components_ として保存されています。これは単語からトピックへの対応関係を提供します。
encoding_matrix = pd.DataFrame( svd.components_.T, index=vocabulary, columns=["Topic 1", "Topic 2"] ) print(encoding_matrix)
出力:
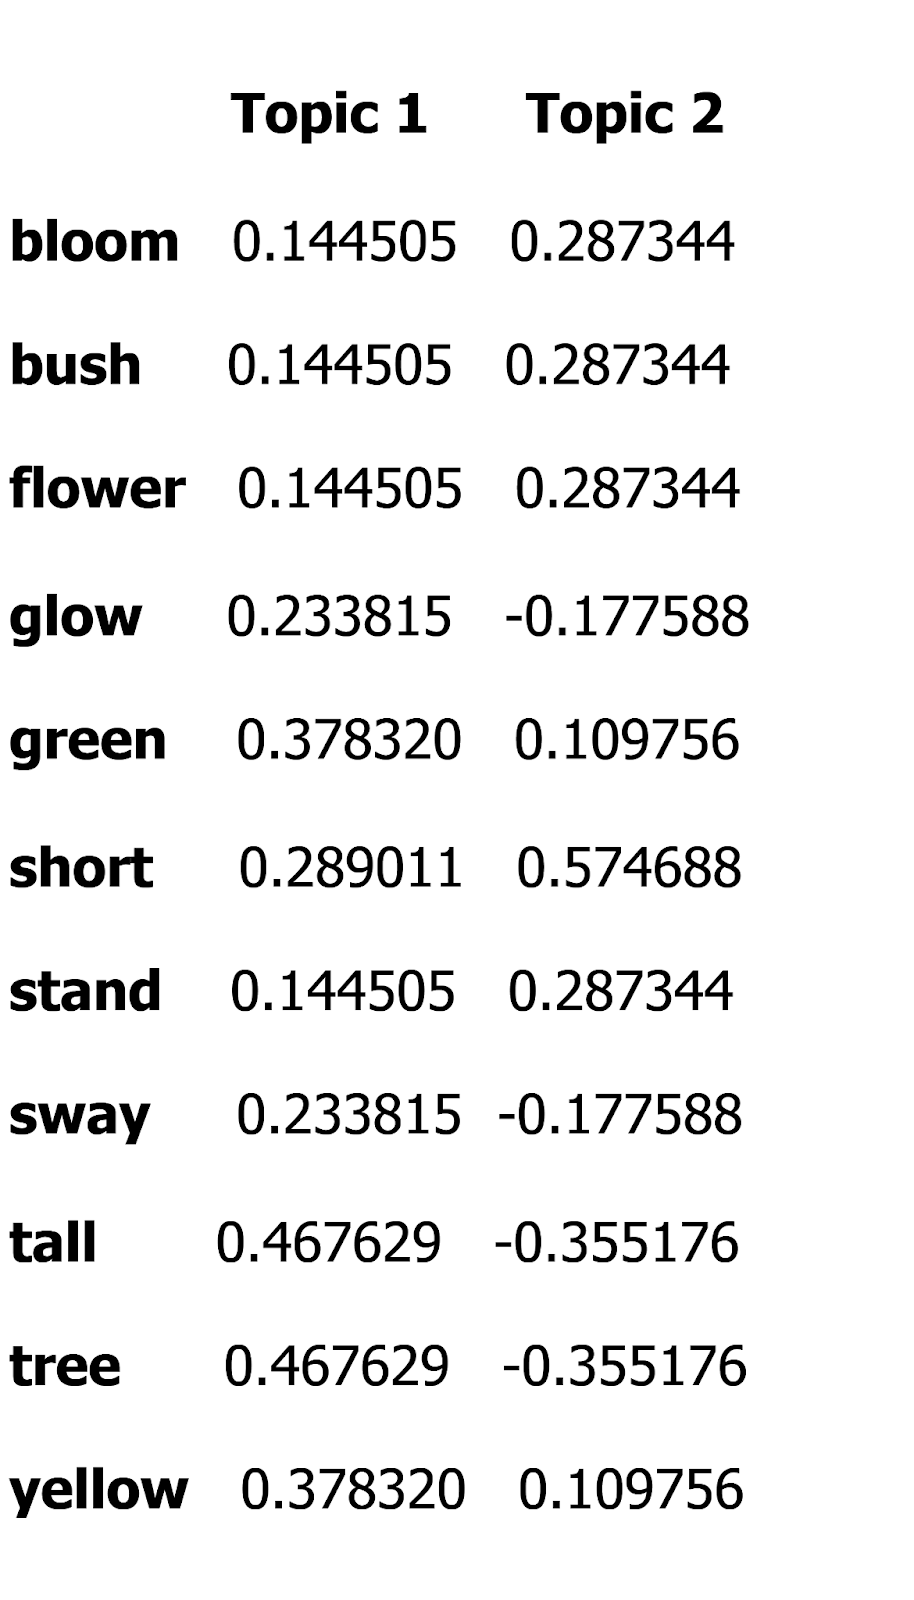
図: 出力
各行は単語に対応し、各列はトピックに対応します。値は、単語が各トピックにどの程度強く関連しているかを示します。
エンコーディング行列の解釈
各トピックにとって最も重要な単語を特定するために、エンコーディングの絶対値に注目します。
encoding_matrix["Abs Topic 1"] = encoding_matrix["Topic 1"].abs()
encoding_matrix["Abs Topic 2"] = encoding_matrix["Topic 2"].abs()
topic_1_top_words = encoding_matrix.sort_values("Abs Topic 1", ascending=False)
topic_2_top_words = encoding_matrix.sort_values("Abs Topic 2", ascending=False)
print("Top Words for Topic 1:")
print(topic_1_top_words[["Topic 1"]].head())
print("Top Words for Topic 2:")
print(topic_2_top_words[["Topic 2"]].head())
出力:
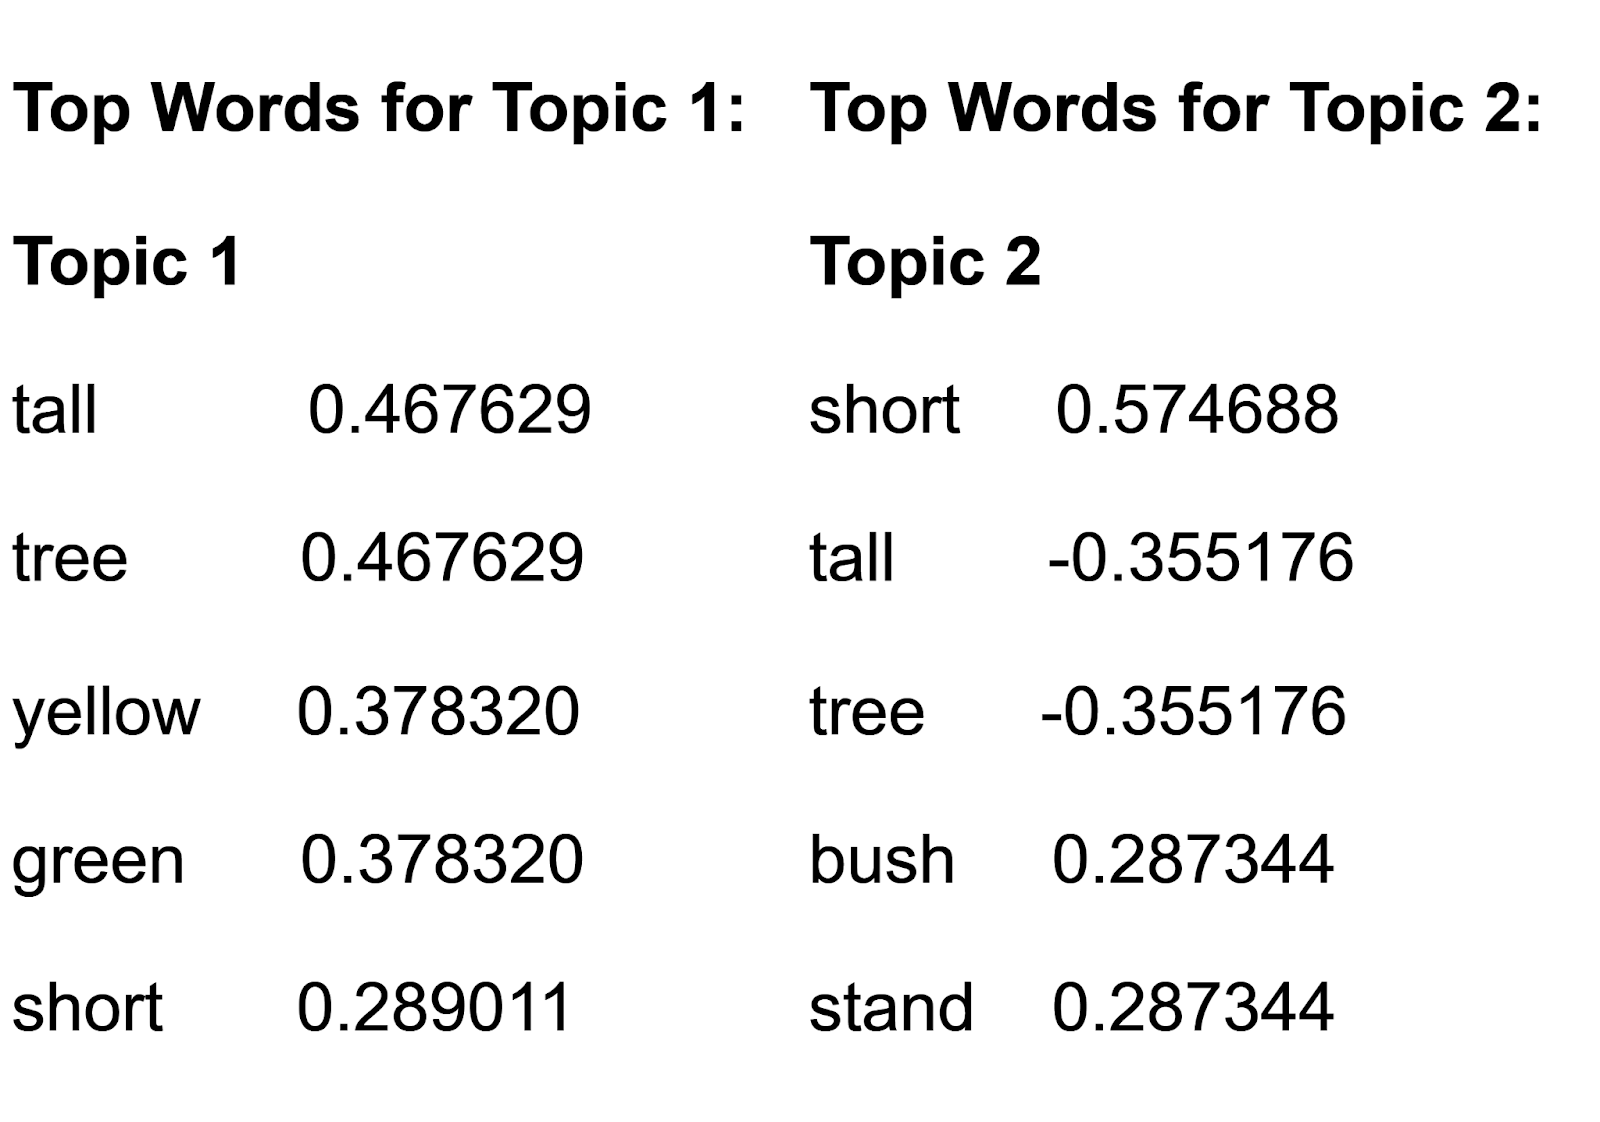 図- 出力 4.png
図: 出力
次のことがわかります。
Topic 1 では、"tall" や "tree" のような単語が重要です。
Topic 2 では、"short" や "tall" のような単語が重要です。
Topic 2 は、正の値を持つ "short" と、負の値を持つ "tall" という単語を対比しています。これは、Topic 2 が特定のドキュメントが “short” か “tall” かを区別するのに適していることを示しています。これらの単語の強い正および負の値は、このトピック内での重要性を示しています。Topic 2 は単語 “short” に対して正の値を持つため、このトピックを使って、特定のドキュメントが “short” にどれほど近く関連しているかを判断できます。
類似手法との比較
LSAは、テキスト分析における他の類似手法とよく比較されます。よくある誤解を明確にするための比較を以下に示します。
LSA vs. LDA
LDA (Latent Dirichlet Allocation)は、階層ベイズ分布を仮定してトピックを生成する確率モデルです。一方、LSAはSVDを使用して単語-文書行列の次元を削減します。これにより、LSAは固定された変換(SVD)を使用するため、同じ入力に対して毎回同じ結果を返す決定論的手法となります。
LDAは、トピック内の単語および文書内のトピックに対する確率を提供します。確率的フレームワークにより、より一貫性のあるトピックを作成します。そのため、大規模でノイズの多いデータセットに適しています。一方、LSAは小規模なデータセットや意味的関係の探索に効果的です。
LSA vs. NMF
NMF (Non-negative Matrix Factorization)は、行列分解を使用する点でLSAと類似しています。ただし、非負制約を課し、すべての成分が加法的であることを保証します。この制約により、因子分解プロセスで負の値を許容するLSAよりも、NMFの結果は解釈しやすくなります。
たとえば、NMFによって特定されたトピックは、肯定的なレビューにおける「good」や「quality」のような語の間の正の関連のみを示します。これにより、NMFは解釈しやすくなります。もう1つの違いは、結果の一貫性にあります。LSAはSVDを使用するため、同じ出力を返します。NMFの結果は初期化によって変わる可能性があり、最適化のために複数回の実行が必要になることがよくあります。
LSAの利点と課題
LSAの利点と課題を理解することは、自然言語処理タスクで効果的に適用するために不可欠です。
利点
LSAの主な利点には、以下のようなものがあります。
情報検索の改善: LSAは、単語の意味的意味を考慮することで検索エンジンの精度を向上させます。これにより、より関連性の高い検索結果が得られます。
次元削減: LSAは、文書-単語行列の次元数を削減することで複雑なデータを単純化します。これにより、データがより扱いやすく、解釈しやすくなります。
意味解析: LSAは、用語と文書の間の潜在的な意味関係を捉えます。これは、document clusteringやtopic modelingのようなタスクに役立ちます。
課題
LSAに関連する課題には、以下のようなものがあります。
線形関係の仮定: LSAは、用語と概念の間に線形関係があると仮定します。これは、言語の真の性質と常に一致するとは限りません。その結果、単語の意味の誤解釈など、不正確さにつながる可能性があります。
単語の順序: LSAは文書内の単語の順序を考慮しませんが、これは文脈や意味を理解するうえで重要な場合があります。
同義語と多義性の扱い: LSAは、複数の意味を持つ単語(多義性)や同義語の扱いに苦労する場合があります。これらの用語を明示的に曖昧性解消するわけではありません。
LSAの応用、ツール、プロバイダー
LSAはNLPおよび情報検索において幅広く適用可能であり、その統合とスケーラビリティを強化するさまざまなツールやプラットフォームによってサポートされています。
応用
LSAは、NLPおよび情報検索システム内の実世界のアプリケーションで広く使用されています。これには以下が含まれます。
検索エンジン: LSAは、文書やクエリ内の潜在的な意味構造を特定することで、検索結果の改善に役立ちます。
推薦システム: LSAは、履歴データや嗜好に基づいてユーザーとアイテム間の意味的関係を分析することで、関連するアイテムを提案します。
文書クラスタリング: LSAは次元を削減し、意味的関係を明らかにします。これにより、類似した文書を自動的にグループ化でき、大規模なテキストコーパスの整理に役立ちます。
チャットボット/NLPアプリケーション: LSAは、コンテキストと意図の理解を向上させることで、チャットボットやその他のNLPアプリケーションを強化します。
ツール
LSAの実装をサポートするさまざまなツールがあります。
Milvus: セマンティック類似性検索を実行するために、LSA技術によって変換されたベクトル埋め込みを保存およびクエリするためのオープンソースベクトルデータベース。
scikit-learn: SVDなどの手法を通じてLSA埋め込みを生成するためのユーティリティを提供するPythonライブラリ。
Gensim: トピックモデリングやドキュメント類似性分析に広く使用されているPythonライブラリ。Gensimは、gensim.models.LsiModelクラスを通じて潜在意味インデックス(LSI)の効率的な実装を提供します。
Milvusとの接続
Milvusは、埋め込みの効率的な保存と取得を可能にします。高速かつ正確なベクトル類似性検索を実行するのに理想的です。
ワークフロー概要
このプロセスには以下が含まれます。
埋め込み生成: DefaultEmbeddingFunctionを使用して、"tall green tree sway"のようなドキュメントをベクトル表現に変換します。これらの埋め込みは、セマンティック類似性検索を実行するうえで重要です。
Milvusでの保存: 生成された埋め込みを関連するメタデータとともにMilvusに保存し、効率的に管理します。
類似性検索: "tall green tree sway."のような検索フレーズからクエリベクトルが生成されます。このベクトルは、コレクション内で最も類似した一致を検索するために使用されます。
Milvusとの接続
Milvusは、埋め込みの効率的な保存と取得を可能にします。高速かつ正確なベクトル類似性検索を実行するのに理想的です。
ワークフロー概要
このプロセスには以下が含まれます。
埋め込み生成: LSAを適用して、"tall green tree sway"のようなドキュメントをベクトル表現に変換しました。これらのベクトルは、テキストの意味構造を包含しています。
Milvusでの保存: 変換されたベクトルを関連するメタデータとともにMilvusコレクションに保存します。
類似性検索: "tall green tree sway"のようなクエリベクトルを使用して、コレクションから意味的に最も類似したドキュメントを取得します。
実行手順
Milvusコレクションの作成: ベクトル次元を指定してコレクションを初期化します。
データの挿入: LSAで変換されたベクトルとそのメタデータをコレクションに追加します。
類似性検索の実行: ベクトルを使用してコレクションにクエリを行い、最も近い一致を見つけます。
from pymilvus import MilvusClient

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus",
    db_name="default"
)

if client.has_collection(collection_name="coll"):
    client.drop_collection(collection_name="coll")
client.create_collection(
    collection_name="coll",
    dimension=2,
)

vectors = lsa_transformed

data = [
    {"id": i, "vector": vectors[i], "document": documents[i]}
    for i in range(len(vectors))
]
data

res = client.insert(collection_name="coll", data=data)

query_vectors = [lsa_transformed[0]]

res = client.search(
    collection_name="coll",
    data=query_vectors,
    limit=3,
    output_fields=["document"],
)

for item in res[0]:
    print(f"ID: {item['id']}")
    print(f"Distance: {item['distance']}")
    print(f"Entity:")
    print(f"  Document: {item['entity']['document']}\n")
出力:
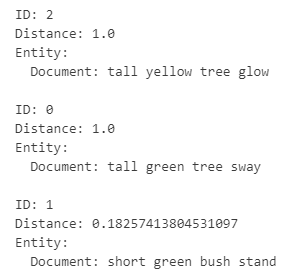
意味的な近さに基づいて、最も関連性の高いドキュメントを取得しました。
FAQ
- LSAは多義性をどのように扱い、その制限は何ですか?
LSAは各単語が単一の意味を持つものとして扱います。これにより、多義語に関する問題が発生し、意味的な不正確さを引き起こします。
- 大規模データセットにおけるLSAの計算上の課題は何ですか?
LSAにはSVDが必要であり、特に大規模データセットでは計算負荷が高く時間がかかります。さらに、SVDによって生成される次元は解釈が難しい場合があります。
- LSAが語順を捉える際の制限は何ですか?
LSAは語順を無視するため、感情分析のように単語の並び(例:「not good」と「good not」)が意味に影響するタスクに支障をきたします。
- LSAは同義語をどのように扱い、どのような課題が生じますか?
LSAは単語間の潜在的な意味関係を特定します。しかし、同義語間の微妙な違いを扱うのが難しい場合があり、文書クラスタリングのようなタスクを複雑にします。
- LSAは単語-文書行列のスパース性にどのように対処しますか?
LSAはスパースな単語-文書行列を作成するため、精度と効率が低下する可能性があります。SVDを用いても、このスパース性は文書分類のようなタスクにおける性能を制限します。