




Latent Semantic Analysis (LSA)
TL;DR
Латентно-семантический анализ (LSA) — это метод обработки естественного языка (NLP), используемый для выявления связей между терминами и документами в текстовом корпусе. Он снижает размерность многомерных текстовых данных, преобразуя их в представление меньшей размерности с помощью сингулярного разложения (SVD), применяемого к матрице «термин-документ». Этот процесс позволяет уловить скрытую семантическую структуру данных, группируя похожие слова и документы на основе их контекстных значений. LSA часто используется в таких задачах, как кластеризация документов, информационный поиск, и тематическое моделирование. Выявляя скрытые закономерности в данных, LSA улучшает понимание и организацию больших текстовых наборов данных.
Введение
Вы когда-нибудь задумывались, как поисковые системы понимают, что вы ищете, даже если вы не используете точные слова? Именно здесь на помощь приходит латентно-семантический анализ (LSA).
LSA определяет скрытые связи между словами, распознавая закономерности и отношения в тексте. Например, когда вы ищете «лучшие кроссовки для бега», вы можете получить результаты со сравнениями брендов обуви, обзорами обуви и даже советами по бегу. Все это релевантно вашему поиску, хотя точные слова, которые вы использовали, могут отсутствовать. LSA делает это возможным, распознавая закономерности в тексте и выявляя связи между словами. Это помогает таким системам, как поисковые системы, рекомендательные алгоритмы и чат-боты на базе ИИ, понимать контекст и смысл, а не только ключевые слова.
Теперь давайте подробно рассмотрим, что такое LSA, как он работает, его важность, преимущества, сложности и области применения.
Что такое LSA?
Латентно-семантический анализ — это метод обработки естественного языка (NLP), который использует математические методы, такие как сингулярное разложение (SVD), для выявления ассоциаций и контекстных значений слов в больших массивах текста.
Истоки LSA восходят к концу 1980-х годов. Впервые он был применен для выявления скрытых семантических структур в тексте. В 1988 году Скотт Дирвестер и его коллеги запатентовали метод информационного поиска. Этот метод был основан на скрытой семантической структуре, называемой латентно-семантическим индексированием (LSI). Он стал прорывным, потому что позволял системам извлекать релевантные документы без точного совпадения ключевых слов в то время, когда сопоставление ключевых слов было основным методом информационного поиска. Вместо этого он опирался на скрытые семантические связи между терминами.
LSA можно представить как умного библиотекаря, который замечает скрытые закономерности в тексте и осмысленно связывает слова и идеи.
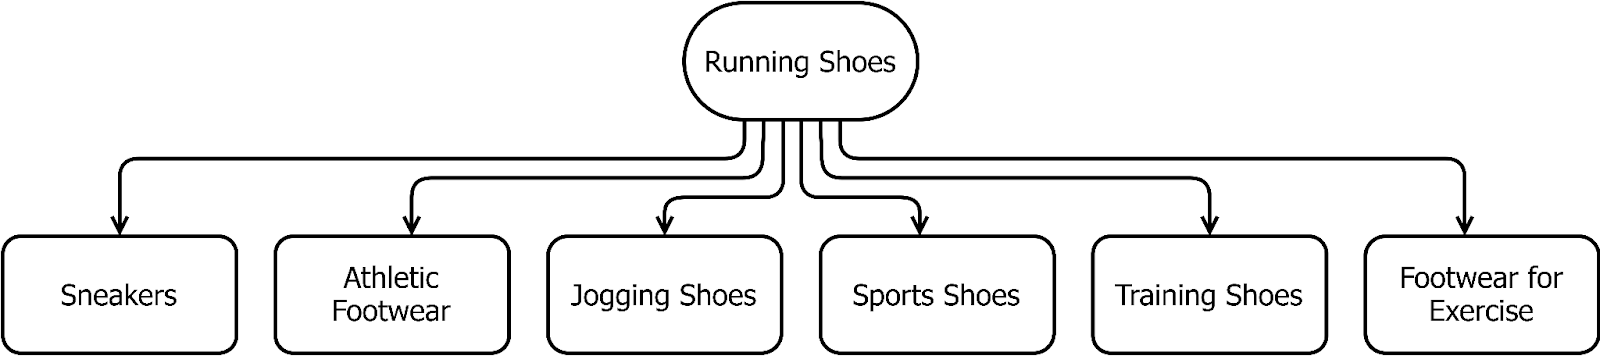 Рисунок — Семантическая сеть кроссовок для бега
Рисунок: Семантическая сеть кроссовок для бега
С помощью LSA системы могут:
Находить скрытые связи между словами и идеями
Лучше понимать текст и улучшать информационный поиск
Улучшать результаты поиска, связывая родственные термины
Находить более глубокие смыслы в больших текстовых коллекциях
LSA — это подход обучения без учителя, который не требует размеченных данных для выявления связей и структур в тексте. Он использует сингулярное разложение (SVD), чтобы уменьшить размерность матрицы «термин-документ», преобразуя ее в меньший набор скрытых признаков. Эти признаки отражают наиболее значимые закономерности в данных, подчеркивая лежащие в основе семантические связи.
Как работает LSA?
LSA включает четыре шага. Мы рассмотрим реализацию каждого шага с использованием библиотеки Python scikit-learn.
Предварительная обработка текста
Создание матрицы «документ-терм»
Сингулярное разложение (SVD)
Данные, закодированные по темам
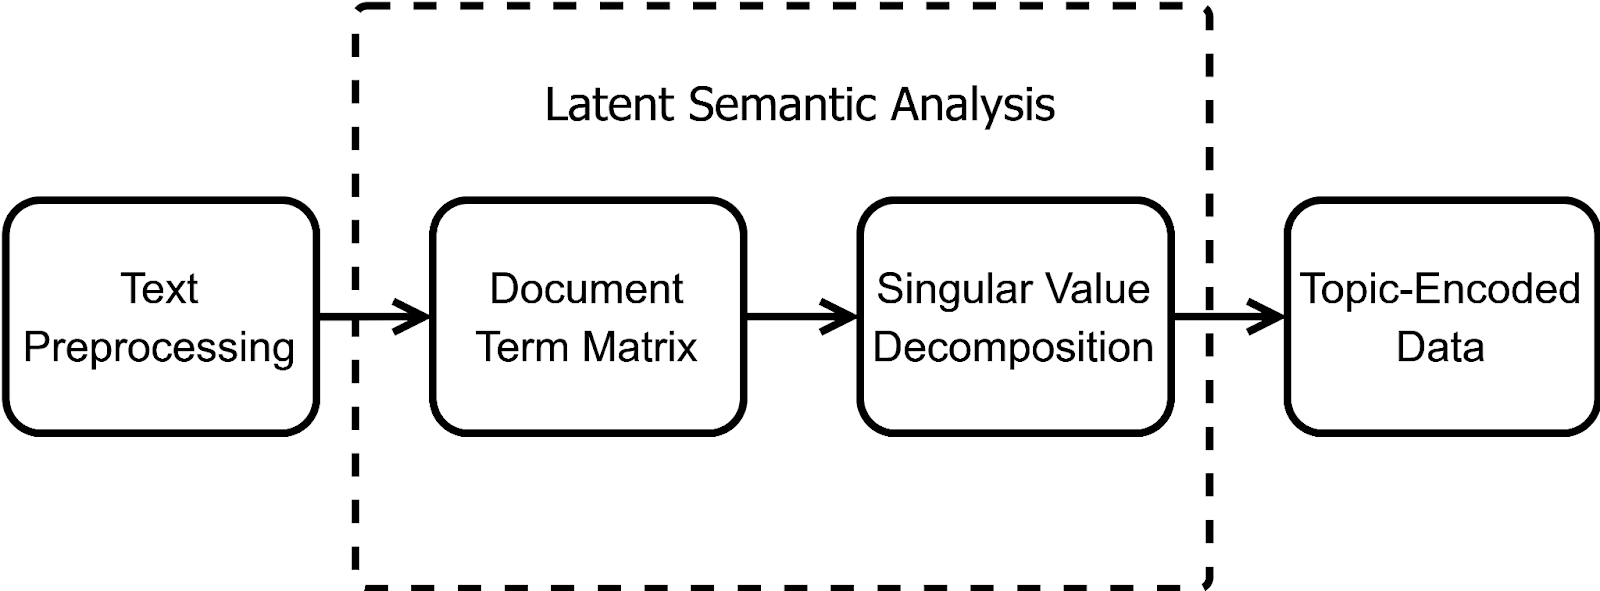 Figure- Step-by-Step Breakdown of LSA.png
Рисунок: Пошаговая разбивка LSA
Предварительная обработка текста
Мы подготавливаем наши необработанные текстовые данные как документы, хранящиеся в виде строк в списке.
documents = [
"tall green tree sway",
"short green bush stand",
"tall yellow tree glow",
"short yellow flower bloom”
]
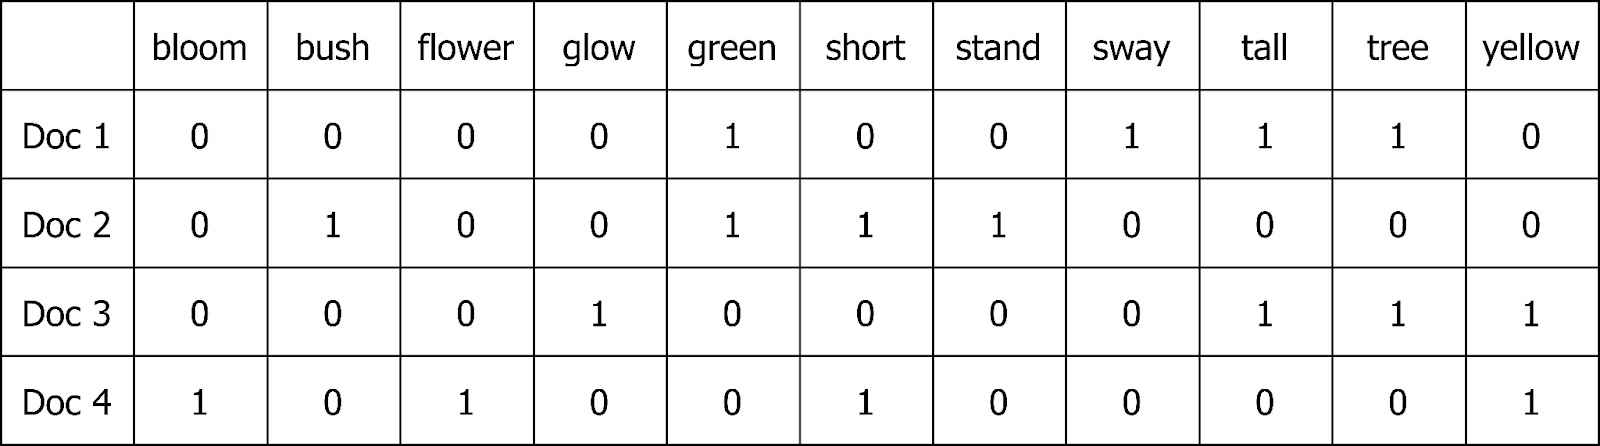 Figure- The Document-Term Matrix.png
Матрица «документ-терм»
Матрица «документ-терм» представляет частоты терминов, встречающихся в коллекции текстовых документов.
Рисунок: Матрица «документ-терм»
Эту матрицу «документ-терм» можно создать с помощью модели CountVectorizer в scikit-learn.
from sklearn.feature_extraction.text import CountVectorizer
vectorizer = CountVectorizer()
document_term_matrix = vectorizer.fit_transform(documents)
Этот процесс преобразовал каждый документ в вектор.
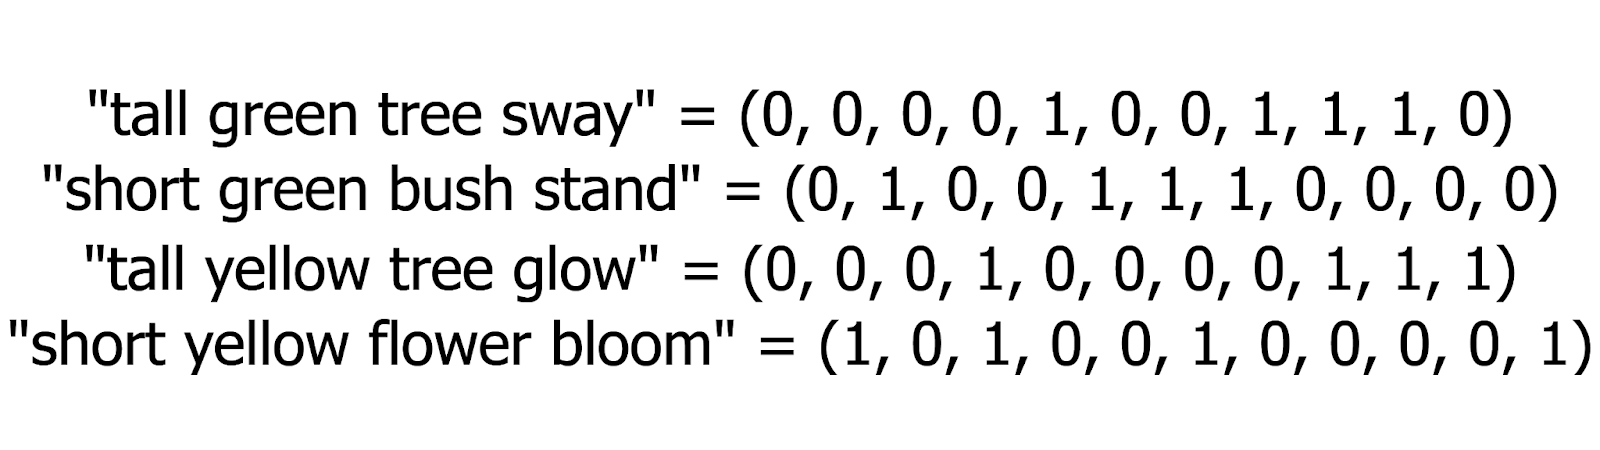 Figure- Documents to Vectors.png
Рисунок: Документы в векторы
Мы можем использовать document_term_matrix.todense(), чтобы просмотреть нашу матрицу «документ-терм».
document_term_matrix.todense()
Вывод:
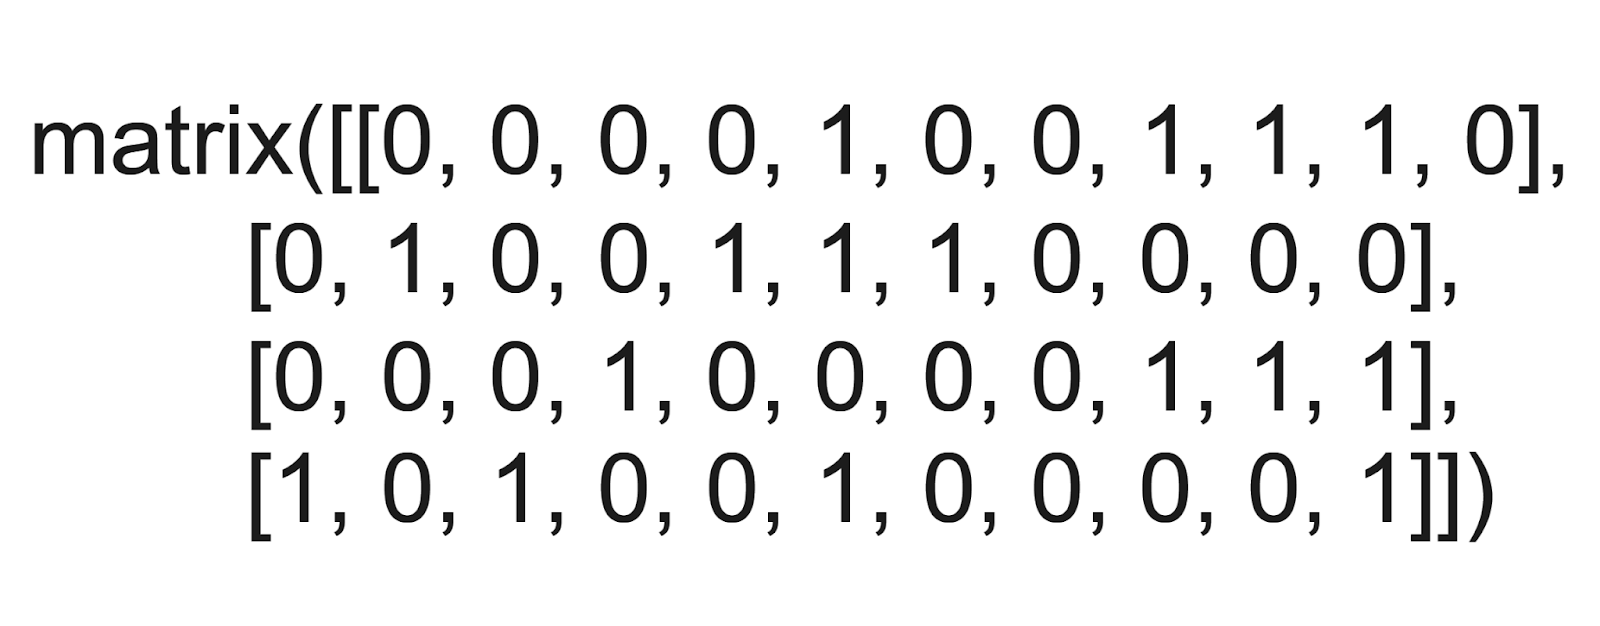 Figure- The Output
Рисунок: Вывод
Полученная матрица показывает каждую строку как вектор. Каждая строка соответствует документу, а столбцы представляют термины. Значения показывают, сколько раз каждый термин встречается в каждом документе.
Сингулярное разложение
SVD — это математический метод, используемый для упрощения сложных наборов данных. SVD разлагает матрицу A на три отдельные матрицы:
_A=UΣVT_
A: __Матрица «документ-терм», представляющая документы и частоты их терминов.
U: Ортогональная матрица «документ-тема», показывающая, насколько сильно каждый документ связан с каждой темой.
Σ: Диагональная матрица сингулярных значений, отражающая важность тем.
_VT_: Ортогональная матрица «терм-тема», показывающая связи между терминами и темами.
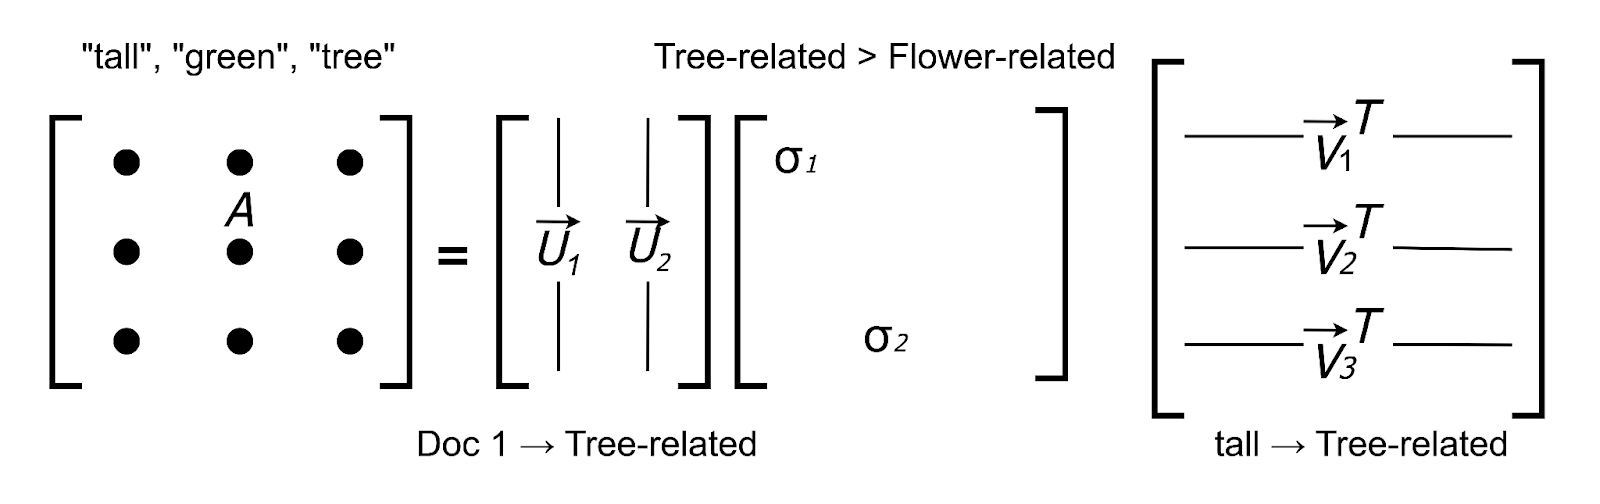 Figure- SVD in Our Use Case
Рисунок: SVD в нашем случае использования
Снижение размерности с помощью Truncated SVD
Снижение размерности — это встроенная возможность SVD. Этот метод упрощает наборы данных, уменьшая количество признаков и сохраняя при этом наиболее важную информацию.
SVD можно выполнить с помощью модели TruncatedSVD в scikit-learn. Он называется «усеченным» SVD, потому что уменьшает количество признаков в наборе данных без значительной потери информации. Это делает его эффективным инструментом для снижения размерности.
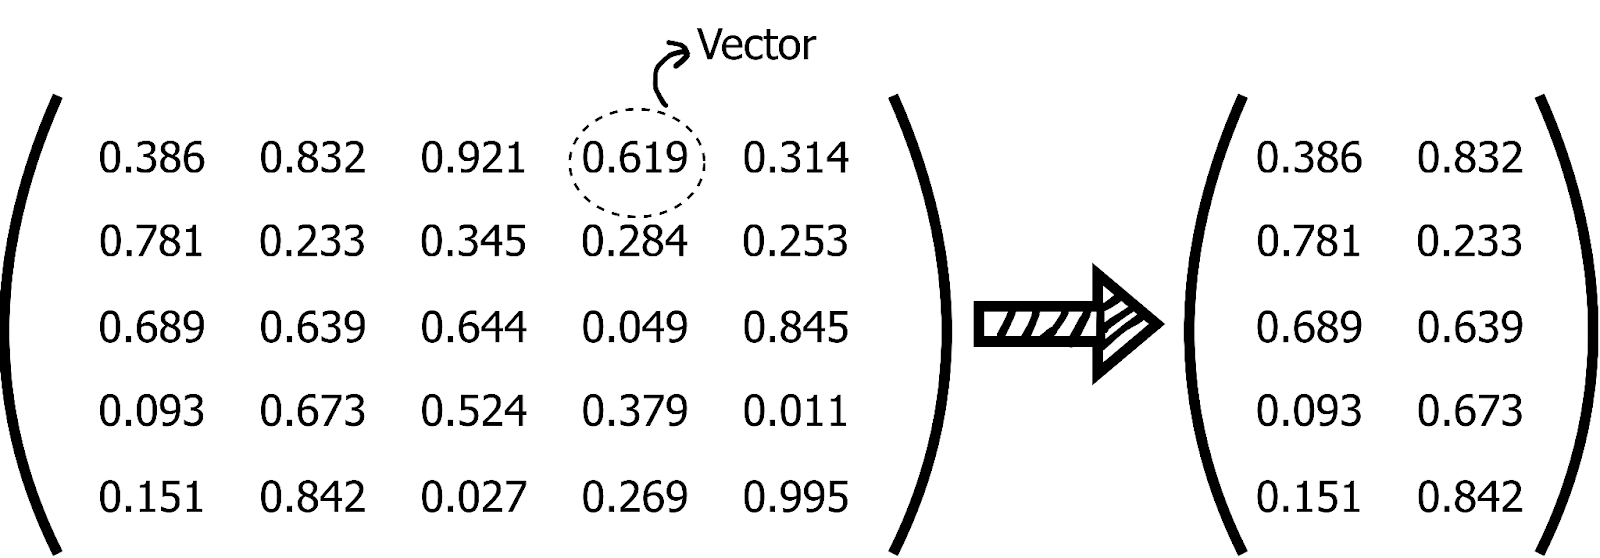 Figure- Dimensionality Reduction
Рисунок: Снижение размерности
Мы создадим модель SVD, чтобы обучить ее и преобразовать нашу матрицу «документ-терм».
from sklearn.decomposition import TruncatedSVD
svd = TruncatedSVD(n_components=2)
lsa = svd.fit(document_term_matrix)
Этот процесс подготавливает нашу модель к преобразованию исходных данных в данные, закодированные по темам. Мы задаем n_components=2 в TruncatedSVD, чтобы представить две темы. Тема представляет слова, которые часто встречаются вместе в разных документах.
В нашем случае тема отражает повторяющийся мотив, связанный с деревьями и растениями. Такие слова, как "tall," "green," и "tree", встречаются вместе, что показывает скрытые закономерности в данных. Таким образом, SVD сжимает данные и раскрывает их семантическую структуру.
Данные, закодированные по темам
Теперь данные содержат два столбца. Каждый столбец представляет одну из двух тем, которые мы указали в TruncatedSVD. Мы используем библиотеку pandas, чтобы увидеть результат нашего LSA.
import pandas as pd
lsa_transformed = svd.transform(document_term_matrix)
topic_df = pd.DataFrame(lsa_transformed, columns=["Topic 1", "Topic 2"])
topic_df["Original Document"] = documents
print(topic_df[["Original Document", "Topic 1", "Topic 2"]].to_string(index=False))
Вывод:
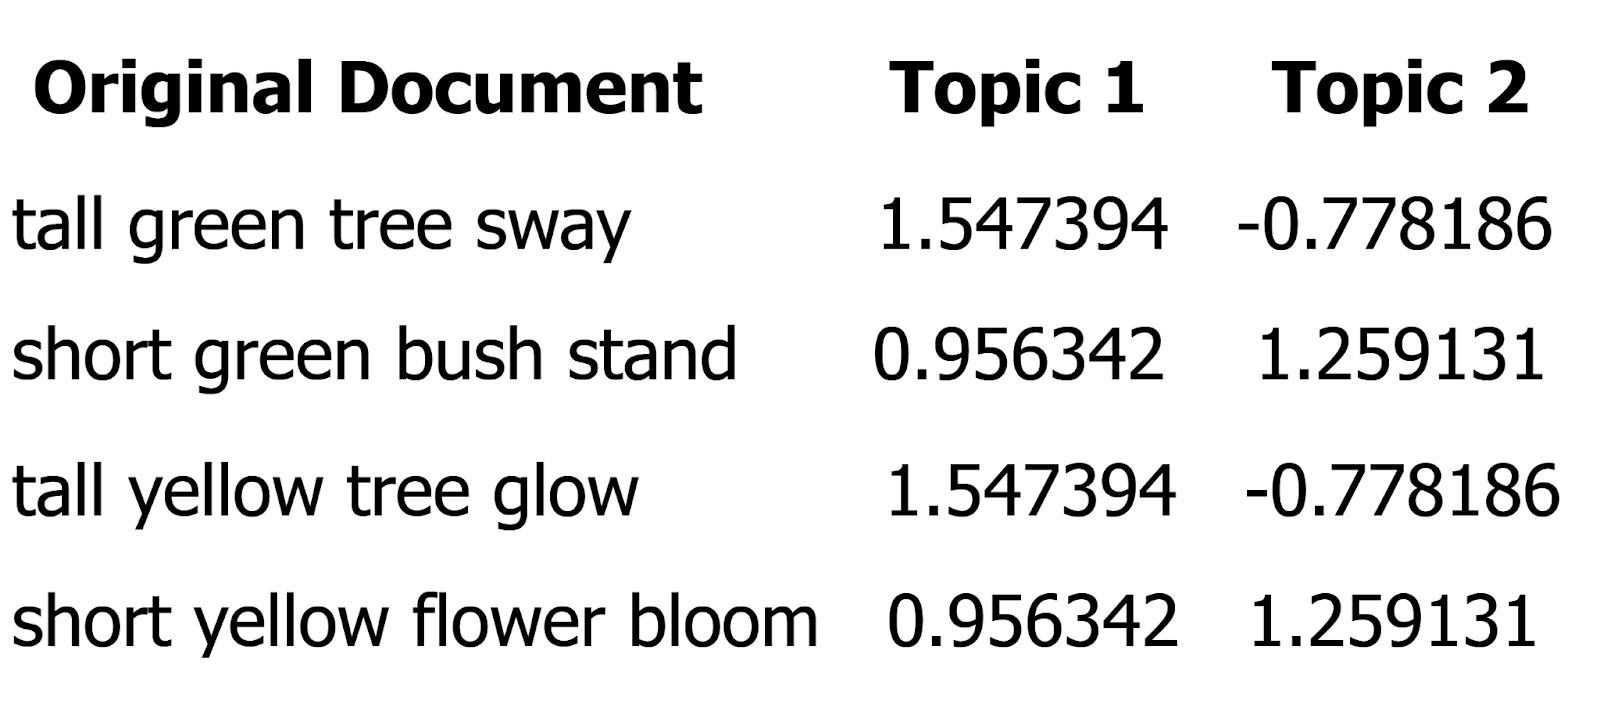
Рисунок: Вывод
Вывод показывает исходные четыре документа вместе с числовыми значениями. Эти значения представляют, насколько сильно каждый документ связан с двумя темами. Мы видим, что все четыре документа сильно выражены в Topic 1. Однако есть явное различие в Topic 2, где:
Первый и третий документы имеют отрицательные значения.
Второй и четвертый документы имеют положительные значения.
Это предполагает, что первый и третий документы сосредоточены на высоких деревьях, тогда как второй и четвертый — о низких кустах и цветах. Такое числовое представление помогает четко различать темы в тексте на основе тем.
Мы можем пойти дальше, поняв, что представляет каждая тема, с помощью словаря и матрицы кодирования.
Словарь — это коллекция всех уникальных слов в документах.
Матрица кодирования показывает, насколько сильно каждое слово связано с каждой темой.
Просмотр словаря
Словарь является частью модели CountVectorizer, доступной через метод .get_feature_names_out().
vocabulary = vectorizer.get_feature_names_out()
print("Dictionary:", vocabulary)
**Вывод:
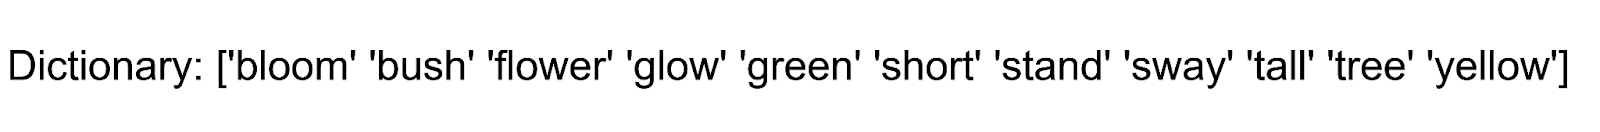
Рисунок: Вывод
Эти слова формируют основу для анализа того, как строятся темы.
Просмотр матрицы кодирования
Матрица кодирования хранится как components_ в модели TruncatedSVD. Она предоставляет отображение слов на темы.
encoding_matrix = pd.DataFrame( svd.components_.T, index=vocabulary, columns=["Topic 1", "Topic 2"] ) print(encoding_matrix)
Вывод:
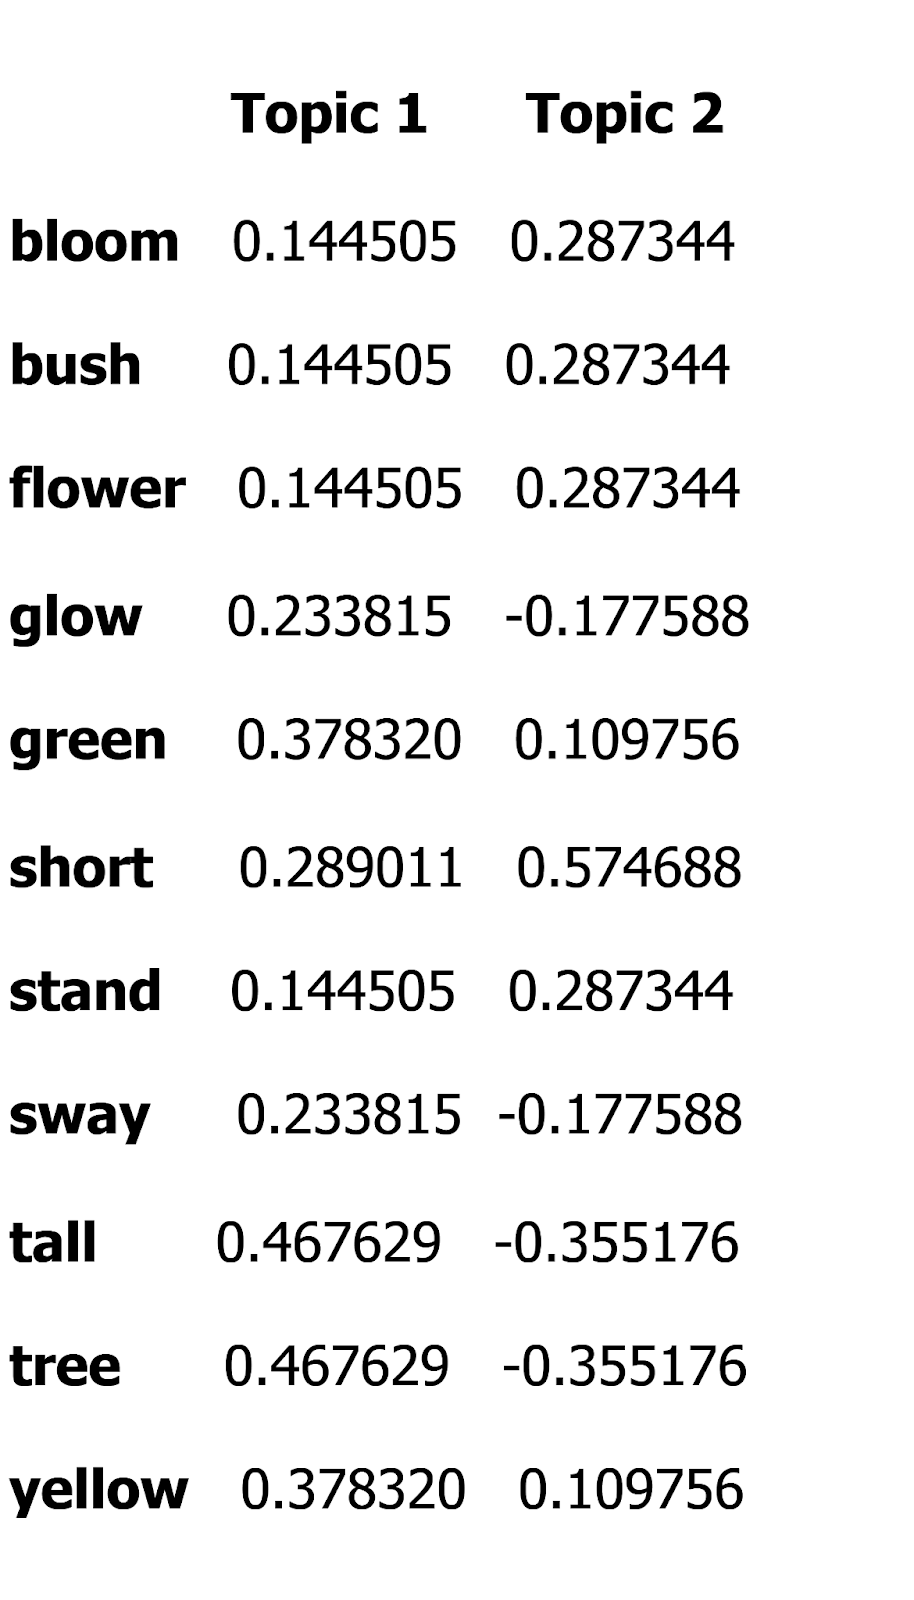
Рисунок: Вывод
Каждая строка соответствует слову, а каждый столбец соответствует теме. Значения показывают, насколько сильно слово связано с каждой темой.
Интерпретация матрицы кодирования
Мы фокусируемся на абсолютных значениях кодирования, чтобы определить наиболее важные слова для каждой темы.
encoding_matrix["Abs Topic 1"] = encoding_matrix["Topic 1"].abs()
encoding_matrix["Abs Topic 2"] = encoding_matrix["Topic 2"].abs()
topic_1_top_words = encoding_matrix.sort_values("Abs Topic 1", ascending=False)
topic_2_top_words = encoding_matrix.sort_values("Abs Topic 2", ascending=False)
print("Top Words for Topic 1:")
print(topic_1_top_words[["Topic 1"]].head())
print("Top Words for Topic 2:")
print(topic_2_top_words[["Topic 2"]].head())
Вывод:
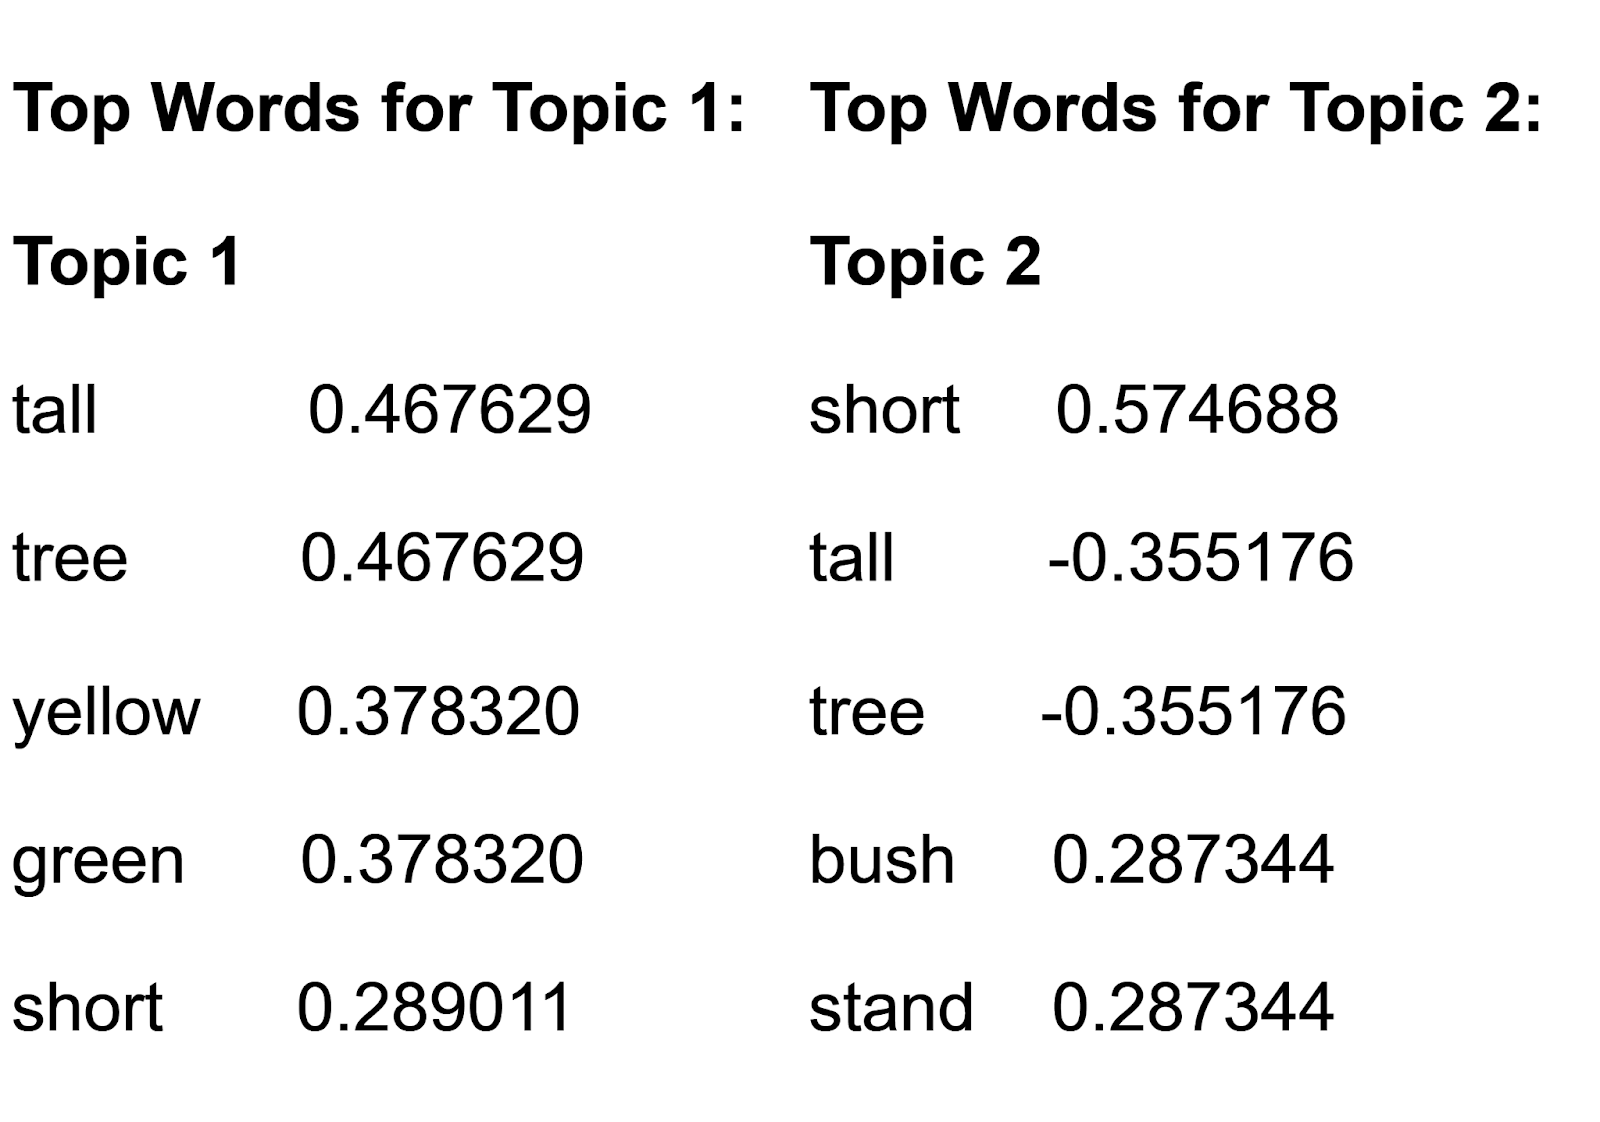 Рисунок- вывод 4.png
Рисунок: вывод
Мы наблюдаем, что:
Для Topic 1 важны такие слова, как "tall" и "tree".
Для Topic 2 важны такие слова, как "short" и "tall".
Topic 2 противопоставляет слова "short", которое имеет положительное значение, и "tall", которое имеет отрицательное значение. Это показывает, что Topic 2 подходит для определения того, является ли данный документ “short” или “tall.” Сильные положительные и отрицательные значения этих слов указывают на их значимость внутри этой темы. Поскольку Topic 2 имеет положительное значение для слова “short,” мы можем использовать эту тему, чтобы определить, насколько тесно данный документ связан с “short.”
Сравнение с похожими методами
LSA часто сравнивают с другими похожими методами анализа текста. Вот сравнение, которое помогает прояснить распространенные заблуждения:
LSA vs. LDA
LDA (Latent Dirichlet Allocation) — это вероятностная модель, которая генерирует темы, предполагая иерархическое байесовское распределение. В то же время LSA использует SVD для уменьшения размерности матрицы «термин-документ». Это делает LSA детерминированным методом, поскольку он использует фиксированные преобразования (SVD), давая один и тот же результат каждый раз для одного и того же входа.
LDA предоставляет вероятности для слов внутри тем и тем внутри документов. Благодаря своей вероятностной основе он создает более согласованные темы. Это делает его более подходящим для больших и шумных наборов данных. С другой стороны, LSA эффективен для небольших наборов данных и исследования семантических связей.
LSA vs. NMF
NMF (Non-negative Matrix Factorization) имеет сходство с LSA в использовании матричной факторизации. Однако он накладывает ограничение неотрицательности, гарантируя, что все компоненты являются аддитивными. Это ограничение делает результаты NMF более интерпретируемыми, чем результаты LSA, который допускает отрицательные значения в процессе факторизации.
Например, темы, выявленные NMF, будут показывать только положительные ассоциации между такими терминами, как "good" и "quality", в положительном отзыве. Это делает NMF более простым для интерпретации. Еще одно различие заключается в согласованности результатов. LSA дает один и тот же вывод благодаря использованию SVD. Результаты NMF могут варьироваться в зависимости от инициализации и часто требуют нескольких запусков для оптимизации.
Преимущества и сложности LSA
Понимание преимуществ и сложностей LSA необходимо для его эффективного применения в задачах обработки естественного языка.
Преимущества
Некоторые из ключевых преимуществ LSA включают:
Улучшенный поиск информации: LSA повышает точность поисковых систем, учитывая семантическое значение слов. Это позволяет получать более релевантные результаты поиска.
Снижение размерности: LSA упрощает сложные данные, уменьшая количество измерений в матрице «документ-термин». Это делает данные более управляемыми и интерпретируемыми.
Семантический анализ: LSA выявляет скрытые семантические связи между терминами и документами. Это помогает в таких задачах, как кластеризация документов и тематическое моделирование.
Сложности
Некоторые из сложностей, связанных с LSA, включают:
Предположение о линейных связях: LSA предполагает линейные связи между терминами и концепциями. Это не всегда может соответствовать истинной природе языка. В результате это может приводить к неточностям, таким как неверная интерпретация значений слов.
Порядок слов: LSA не учитывает порядок слов в документе, что может быть критически важно для понимания контекста и значения.
Обработка синонимов и полисемии: LSA может испытывать трудности со словами, имеющими несколько значений (полисемия), или синонимами. Он не выполняет явного устранения неоднозначности этих терминов.
Приложения, инструменты и поставщики LSA
LSA имеет широкое применение в NLP и поиске информации, а также поддерживается различными инструментами и платформами, которые улучшают его интеграцию и масштабируемость.
Приложения
LSA широко используется в реальных приложениях в рамках NLP и систем поиска информации. К ним относятся:
Поисковые системы: LSA помогает улучшить результаты поиска, выявляя скрытые семантические структуры в документах и запросах.
Рекомендательные системы: LSA предлагает релевантные элементы, анализируя семантические связи между пользователями и элементами на основе исторических данных или предпочтений.
Кластеризация документов: LSA снижает размерность и выявляет семантические связи. Это позволяет ему автоматически группировать похожие документы, помогая организовывать большие текстовые корпуса.
Чатботы/приложения NLP: LSA улучшает чатботы и другие приложения NLP, повышая понимание контекста и намерения.
Инструменты
Различные инструменты поддерживают реализацию LSA:
Milvus: Векторная база данных с открытым исходным кодом для хранения и запросов векторных эмбеддингов, преобразованных методами LSA для выполнения поиска семантического сходства.
scikit-learn: Библиотека Python, предоставляющая утилиты для генерации эмбеддингов LSA с помощью таких методов, как SVD.
Gensim: Библиотека Python, широко используемая для тематического моделирования и анализа сходства документов. Gensim предоставляет эффективную реализацию латентного семантического индексирования (LSI) через свой класс gensim.models.LsiModel.
Связь с Milvus
Milvus обеспечивает эффективное хранение и извлечение эмбеддингов. Он идеально подходит для выполнения быстрого и точного поиска векторного сходства.
Обзор рабочего процесса
Процесс включает:
Генерация эмбеддингов: Мы используем DefaultEmbeddingFunction для преобразования документов, таких как "tall green tree sway", в векторные представления. Эти эмбеддинги имеют решающее значение для выполнения поиска семантического сходства.
Хранение в Milvus: Храните сгенерированные эмбеддинги вместе со связанными метаданными в Milvus для эффективного управления.
Поиск сходства: Вектор запроса генерируется из поисковой фразы, такой как "tall green tree sway." Этот вектор используется для поиска в коллекции наиболее похожих совпадений.
Связь с Milvus
Milvus обеспечивает эффективное хранение и извлечение эмбеддингов. Он идеально подходит для выполнения быстрого и точного поиска векторного сходства.
Обзор рабочего процесса
Процесс включает:
Генерация эмбеддингов: Мы применили LSA для преобразования документов, таких как "tall green tree sway", в векторные представления. Эти векторы заключают в себе семантическую структуру текста.
Хранение в Milvus: Храните преобразованные векторы вместе со связанными метаданными в коллекции Milvus.
Поиск сходства: Используйте вектор запроса, такой как "tall green tree sway", чтобы извлечь из коллекции наиболее семантически похожие документы.
Шаги для выполнения
Создайте коллекцию Milvus: Инициализируйте коллекцию, указав размерность вектора.
Вставьте данные: Добавьте преобразованные с помощью LSA векторы и их метаданные в коллекцию.
Выполните поиск сходства: Выполните запрос к коллекции с использованием вектора, чтобы найти ближайшие совпадения.
from pymilvus import MilvusClient

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus",
    db_name="default"
)

if client.has_collection(collection_name="coll"):
    client.drop_collection(collection_name="coll")
client.create_collection(
    collection_name="coll",
    dimension=2,
)

vectors = lsa_transformed

data = [
    {"id": i, "vector": vectors[i], "document": documents[i]}
    for i in range(len(vectors))
]
data

res = client.insert(collection_name="coll", data=data)

query_vectors = [lsa_transformed[0]]

res = client.search(
    collection_name="coll",
    data=query_vectors,
    limit=3,
    output_fields=["document"],
)

for item in res[0]:
    print(f"ID: {item['id']}")
    print(f"Distance: {item['distance']}")
    print(f"Entity:")
    print(f"  Document: {item['entity']['document']}\n")
Вывод:
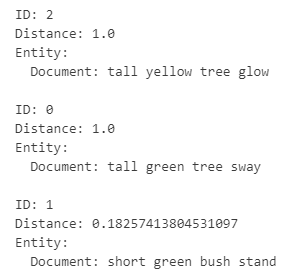
Мы извлекли наиболее релевантные документы на основе их семантической близости.
Часто задаваемые вопросы
- Как LSA обрабатывает полисемию и каковы его ограничения?
LSA рассматривает каждое слово как имеющее одно значение. Это приводит к проблемам с многозначными словами, которые вызывают семантические неточности.
- Каковы вычислительные сложности LSA на больших наборах данных?
LSA требует SVD, что является вычислительно затратным и отнимает много времени, особенно при работе с большими наборами данных. Кроме того, измерения, полученные с помощью SVD, могут быть сложны для интерпретации.
- Каковы ограничения LSA в учете порядка слов?
LSA игнорирует порядок слов, что влияет на такие задачи, как анализ тональности, где последовательность слов (например, "not good" и "good not") влияет на значение.
- Как LSA обрабатывает синонимы и какие проблемы возникают?
LSA выявляет скрытые семантические связи между словами. Однако он может испытывать трудности с улавливанием тонких различий между синонимами, что усложняет такие задачи, как кластеризация документов.
- Как LSA справляется с разреженностью в матрицах термин-документ?
LSA создает разреженные матрицы термин-документ, что может снижать точность и эффективность. Даже при использовании SVD такая разреженность ограничивает его производительность в таких задачах, как классификация документов.