




Annoy対Faiss:ベクトル検索に適したツールの選択
今日のAI主導の世界では、自然言語処理(NLP)、意味検索、画像検索など、高次元データを含むアプリケーションには効率的なベクトル検索が不可欠である。この分野では2つの強力なベクトル検索ツール、AnnoyとFaissが人気だが、どちらを選ぶかは難しい。どちらも価値ある機能を提供しているが、その長所や使用例は大きく異なっている。このブログでは、それぞれのテクノロジーが提供するものを探求し、お客様のニーズに最適なものを決定するお手伝いをします。
ベクターサーチとは?
比較に入る前に、ベクトル検索とは何かを明確にしておくと役に立つ。ベクトル検索、またはベクトル類似性検索とは、高次元のベクトルとして表されるデータセットから、最も類似しているアイテムを見つけるプロセスのことである。これらのベクトルは、しばしば機械学習モデルによって生成され、非構造化データの本質(例えば、文章の意味や画像の特徴)を捉える。
完全一致やフィルタリングに基づいて検索する従来のデータベースとは異なり、ベクトル検索は類似性に重点を置く。その目的は、距離メトリック(ユークリッド距離や余弦類似度など)に基づいて、互いに「近い」ベクトルを見つけることである。ベクトル検索は、生産推薦、自然言語処理(NLP)、画像類似検索、検索拡張生成(RAG)など、多くのユースケースやアプリケーションで広く採用されている。
ベクトル検索を実行するために、市場には以下のような多くのソリューションがある:
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)のような目的別ベクトルデータベース。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクターデータベース。
- 従来のデータベース ベクトル検索アドオン付き。
Annoy: 静的データのためのスピードとシンプルさ
Annoy](https://zilliz.com/learn/approximate-nearest-neighbor-oh-yeah-ANNOY) (Approximate Nearest Neighbors Oh Yeah)は、Spotifyによって開発されたオープンソースライブラリで、高次元空間における効率的な近似最近傍(ANN)検索のために設計されている。 Annoyの主な機能は、ベクトル埋め込みに基づいて、与えられたクエリアイテムに似ているアイテムを素早く見つけることである。Annoyは、「十分に近い」結果を素早く見つけることよりも、完全に一致することが重要でない大規模なデータセットを扱う場合に特に有用である。ユーザーの好みに基づいて、似たようなアイテム(曲、製品、ビデオなど)を提案するレコメンデーションエンジンを構築するためによく使われる。
Annoy の主な特徴:
1.近似最近傍探索:Annoyはランダムな射影木に基づく方法を使用しており、高速な検索を可能にしますが、速度のために精度をある程度犠牲にします。この方法は、スピードが重要で正確な結果が必要ないアプリケーションに適している。 2.メモリ効率:Annoyはメモリを効率的に使用するように最適化されている。メモリ上でインデックスを構築し、ディスク上に保存することができるため、RAMが十分でなくても大きなデータセットを扱うことができる。この機能は、システムのメモリが制約となっている場合に特に有用である。 3.不変インデックス:Annoyで一度構築したインデックスは変更できない。データセットが変更された場合、インデックス全体を再構築する必要があります。このため、データが頻繁に変更されない静的なデータセットに適している。 4.ディスクバックアップストレージAnnoyはインデックスをディスク上に保存することができる。つまり、すべてをメモリ上に保持することなく、大規模なデータセットに対してクエリを実行することができる。 5.言語サポートAnnoyは主にPythonで使用されますが、パフォーマンス上の理由からC++で書かれています。
**Annoyは、特に高速な静的データ検索ツールを必要とする開発者にとって、そのシンプルさ、スピード、使いやすさが広く評価されている。
Faiss大規模AIのためのパワーと柔軟性
Faiss](https://zilliz.com/learn/faiss) (Facebook AI Similarity Search)は、Meta社(旧Facebook社)によって開発されたオープンソースライブラリで、密なベクトルの高速な類似検索とクラスタリングのための非常に効率的なツールを提供します。 Faissは大規模な最近傍検索用に設計されており、高次元ベクトル空間での近似検索と厳密検索の両方を扱うことができます。Faissは膨大なデータセットを扱うように設計されており、GPUアクセラレーションを活用する能力が際立っているため、大規模アプリケーションのパフォーマンスを大幅に向上させることができる。特にAIや機械学習アプリケーションに適しています。
Faissの主な特徴
- 近似・厳密K-最近傍探索(ANN & KNN)**:Faissは近似および厳密最近傍(NN)探索の両方をサポートします。アプリケーションのニーズに応じて、速度と精度をトレードオフすることができます。
- GPUアクセラレーション**:Faissの際立った特徴のひとつは、GPUアクセラレーションをサポートしていることです。これにより、大規模なデータセットに効果的に対応し、CPUのみの方法よりも高速に検索を実行することができます。
- 大規模データセット処理**:Faissは、メモリに収まらないほど大きなデータセットの処理に最適化されています。インバーテッド・ファイル](https://zilliz.com/learn/vector-index)やクラスタリングなど、様々なインデックス作成技術を使用し、データを効率的に整理し、巨大なコレクションに対して検索を実行します。
- 複数のインデックス戦略**:Faissは、フラット(総当り)インデックス、積の量子化、階層的クラスタリングなど、ベクトルをインデックスするためのさまざまな方法をサポートしています。これにより、速度が重要か精度が重要かに応じて、検索方法を柔軟に変更することができます。
- 分散システムのサポート:Faissは、分散システムの複数のマシンにまたがって検索を実行できるため、エンタープライズ・レベルのアプリケーションにスケーラブルに対応できる。
- 機械学習フレームワークとの統合**:Faissは、PyTorchやTensorFlowなどの他の機械学習フレームワークとうまく統合できるため、AIワークフローへの組み込みが容易になります。
Annoy と Faiss の比較
AnnoyとFaissのどちらを選ぶかを決める際には、検索手法、データの取り扱い、パフォーマンス、スケーラビリティなど、いくつかの重要な要素を考慮する必要がある。
Annoyはランダム射影木を使って近似最近傍探索を行う。速度とメモリ効率に重点を置いているため、特にデータが静的であるような読み取り負荷の高いワークロードには最適である。しかし、このスピード重視は柔軟性を犠牲にすることになる。インデックスは不変であるため、頻繁な更新を必要とするアプリケーションには不向きである。対照的に、Faissは、単純なk-最近傍探索からより複雑なクラスタリング技術まで、より幅広い探索アルゴリズムを使用します。この柔軟性により、速度と精度のトレードオフを調整することができ、データセットが常に変化する環境では特に有用です。
また、Faissは動的なデータセットの扱いにおいてもAnnoyを凌駕している。Annoyはデータが変更されるたびにインデックスの完全な再構築を必要とするが、Faissはインクリメンタルにインデックスを更新できる。この機能とGPUアクセラレーションにより、Faissはスピードと柔軟性が不可欠な大規模リアルタイム・アプリケーションで優位に立つことができる。
どちらのツールもスケーラビリティの点では優れているが、その方法は異なる。Annoyはメモリ効率に最適化されており、ディスクに保存された大規模データセットを効率的に扱うことができる。しかし、分散コンピューティングやGPUアクセラレーションをサポートしていないため、真に巨大なデータセットのスケーリングには限界がある。一方、Faissはスケーラビリティを念頭に構築されている。GPUサポートと分散アーキテクチャにより、パフォーマンスが重要な大規模機械学習システムに適した選択肢となっている。
Annoy を選ぶべき時
Annoyの強みは、そのシンプルさと効率性にある。頻繁に変更されることのない大規模なデータセットを、高速かつ近似的に検索するのに最適なツールだ。その不変性は、レコメンデーションエンジンのような、データがほとんど静的で、リアルタイム更新の必要性が少ないアプリケーションに理想的だ。
完璧な精度よりもスピードが重要なプロジェクトに取り組んでいて、セットアップが簡単でメモリ効率の良いツールが欲しいなら、Annoyは有力な選択肢だ。また、効率的な動作には膨大なRAMを必要としないため、メモリに制約のある環境で動作するアプリケーションにも適している。
Faissを選ぶとき
FaissはAnnoyよりもはるかに強力で柔軟性があり、特に高いスケーラビリティ、リアルタイム更新、スピードと精度のバランスを必要とするアプリケーションに適しています。GPUアクセラレーションシステムを使用する場合や、利用可能なメモリを超える巨大なデータセットを扱う場合は、Faissが明らかに勝者である。厳密検索と近似検索に対応し、複数のインデックス作成オプションを備えているため、特定のニーズに合わせた多用途なツールとなっている。
Faissは、画像検索システム、大規模なNLPタスク、または高性能でリアルタイムのクエリを必要とするプロジェクトなどのアプリケーションを開発している場合に最適な選択だ。Annoyよりも学習曲線は急ですが、複雑さが増す分、カスタマイズ、スケーラビリティ、スピードに大きなメリットがあります。
ベクトル検索ライブラリと専用のベクトルデータベースの比較
AnnoyやFaissのようなベクトル検索ライブラリも、Milvusのような目的構築型ベクトルデータベースも、高次元ベクトルデータの類似性検索問題を解決することを目的としていますが、それぞれ異なる目標を持って構築されています。ここでは、両者の主な違いを説明します。
範囲と目的
- ベクトル検索ライブラリ(Annoy、Faiss、ScaNN、HNSWlib):ベクトル検索ライブラリ(Annoy、Faiss、ScaNN、HNSWlib): これらのライブラリは、最近傍検索を実行する特定のアプリケーショ ンに組み込むために設計された軽量ライブラリです。これらのライブラリは検索アルゴリズムにのみ焦点を当てており、通常、開発者はデータストレージ、スケーラビリティ、インフラストラクチャなどの他のすべての側面を管理する必要があります。
- MilvusやZilliz Cloudのような目的別ベクターデータベースは、ベクターデータの管理と検索に特化して構築された本格的なシステムである。データストレージ、スケーリング、インデックス作成、レプリケーション、クエリ管理など、より包括的なソリューションを提供します。これらのシステムは、ベクトル検索がインフラストラクチャの中核となるような大規模なプロダクション環境に対応するように設計されています。
機能セット
- ベクトル検索ライブラリ:これらのライブラリは、高速で効率的な最近傍検索の実行に限定されています。これらのライブラリは、ベクトルをインデックス化し、検索機能を提供することに重点を置いていますが、データの永続化、バックアップ、監視などの機能は含まれていません。データセットを動的に更新する必要がある場合、Annoyのようなライブラリはインデックスの完全な再構築を必要とするかもしれない。
- 目的別ベクターデータベース**:これらのデータベースは、データ永続性、水平スケーリング、レプリケーション、シャーディング、バックアップ/リストア機能など、あらゆるデータベース機能を備えている。動的で大規模なユースケース向けに設計されており、本番環境での管理が容易です。Milvusのような専用のベクターデータベースの中には、ベクターベースの検索と従来のキーワード検索を組み合わせた ハイブリッド検索をサポートするものもある。
スケーラビリティ
- ベクトル検索ライブラリ**:Faissのようなベクトル検索ライブラリは、特にGPUアクセラレーションによって優れたパフォーマンスを提供しますが、ネイティブでは分散システムをサポートしていません。複数のノードやマシンにまたがってスケーリングする必要がある場合、手動で管理する必要があり、複雑さが増します。何十億ものベクトルを扱うには、マシン間で負荷を分散させるために多くのエンジニアリング作業が必要になり、運用・保守コストが増大する可能性があります。
- 目的別ベクターデータベース:これらのデータベースはスケーラビリティを念頭に設計されています。Zilliz Cloudのようなデータベースは、シャーディング、レプリケーション、分散インデックスをすぐに扱うことができ、データセットが大きくなっても楽に拡張することができます。数十億のベクトルを分散環境で管理できるため、エンタープライズレベルのAIアプリケーションに最適です。
パフォーマンスの最適化
- ベクトル検索ライブラリ**:FaissやAnnoyのようなライブラリは、性能最適化を直接制御できます。インデックス作成ストラテジー(例:積の量子化、ランダム投影ツリー)を選択し、速度と精度の特定の要件に基づいてアルゴリズムを調整することができます。これにより、より多くの制御が可能になる反面、基礎となるアルゴリズムをより深く理解する必要があります。
- 目的別ベクターデータベース**:これらのデータベースは、パフォーマンス最適化プロセスの多くを自動化します。インデックス戦略についてはそれほどコントロールできないかもしれませんが、クエリー速度、データ分散、メモリー管理の最適化はシステムが行います。パフォーマンスが重要で、システムのチューニングの複雑さを軽減したい場合は、ベクターデータベースが適しています。
使いやすさとセットアップのしやすさ
- ベクトル検索ライブラリ:ベクトル検索ライブラリのセットアップには、より多くの手作業が必要です。データストレージ、インフラストラクチャー、インデクシング、スケーリングを処理する必要があります。AnnoyやFaissのようなライブラリは小規模なプロジェクトでは比較的使いやすいが、本番用に拡張するには、ストレージやロードバランシングのような周辺のインフラを自分で管理する必要がある。
- 目的別ベクターデータベース**:これらのデータベースは、本番環境用にセットアップしやすいように設計されています。Pinecone のようなマネージドソリューションでは、基盤となるインフラを気にすることなく、アプリケーションの構築に集中できます。また、これらのシステムにはデータ管理のための機能が組み込まれており、デプロイとスケーリングがより簡単になります。
コストの考慮事項
- ベクトル検索ライブラリ**:これらのライブラリは軽量でセットアップも最小限で済むため、特に小規模で静的なデータセットの場合、初期コストが低くなる傾向があります。しかし、システムを拡張したり、動的なデータセットを扱う必要がある場合は、インフラやエンジニアリングリソースの管理が必要になるため、長期的なコストは上昇する可能性がある。
- 目的別ベクターデータベース:Zilliz Cloudのようなマネージドベクターデータベースは、運用のオーバーヘッドを排除するため、より高価になる可能性があります。しかし、使いやすさ、スケーラビリティ、メンテナンスに関して長期的に大きなメリットがあります。大規模なベクトル検索を必要とするエンタープライズアプリケーションに取り組んでいる場合、マネージドサービスを使用するコストは、管理やインフラストラクチャのセットアップにかかる時間の節約によって正当化されることがよくあります。
各ベクトル検索ソリューションの選択時期
ベクター検索ライブラリ**を選択する場合:
- 小規模から中規模の比較的静的なデータセットを持っている。
- インデックス作成と検索アルゴリズムを完全にコントロールしたい。
- 既存のシステムに検索を組み込み、インフラを管理できる。
目的別ベクターデータベース**を選択する場合:
- 分散システムで数十億ベクトルまで拡張する必要がある。
- データセットが頻繁に変更され、リアルタイムの更新が必要な場合。
- ストレージ、スケーリング、クエリの最適化を代行してくれるマネージドソリューションを好む。
まとめると、柔軟性と小規模なアプリケーションにはベクトル検索ライブラリを、使いやすさと大規模な実稼働環境にはベクトルデータベースを選択してください。
異なるベクトル検索ソリューションの評価と比較
さて、ベクトル検索ソリューションの違いはわかった。次の疑問は、検索アルゴリズムが正確な結果を確実に、しかも高速に返すにはどうすればよいか?様々なANNアルゴリズムの有効性を、特に規模に応じてどのように評価するか?
これらの質問に答えるには、ベンチマークツールが必要である。そのようなツールは数多くあるが、最も効率的なものとして2つが挙げられる:**ANNベンチマーク](https://zilliz.com/glossary/ann-benchmarks)とVectorDBBenchである。
ANNベンチマーク
ANN ベンチマーク](https://zilliz.com/glossary/ann-benchmarks) (Approximate Nearest Neighbor Benchmarks) は、様々な近似最近傍 (ANN) アルゴリズムの性能を評価・比較するために設計されたオープンソースプロジェクトです。高次元ベクトル探索などのタスクで異なるアルゴリズムをベンチマークするための標準化されたフレームワークを提供し、開発者や研究者が様々なデータセットで探索速度、精度、メモリ使用量などのメトリクスを測定することを可能にします。ANN-Benchmarksを使うことで、Faiss、Annoy、HNSWlibなどのライブラリにあるようなアルゴリズムの速度と精度のトレードオフを評価することができます。
ANN Benchmarks GitHub リポジトリ: https://github.com/erikbern/ann-benchmarks
ANNベンチマークウェブサイト: https://ann-benchmarks.com/
ベクターDBBベンチ
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのために設計されたオープンソースのベンチマークツールです。このツールにより、ユーザは独自のデータセットを用いてMilvusやZilliz Cloud(マネージドMilvus)などの異なるベクトルデータベースシステムの性能をテスト・比較し、ユースケースに最も適したものを決定することができる。VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされている。
VectorDBBenchのGitHubリポジトリ: https://github.com/zilliztech/VectorDBBench
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)**で主流のベクトルデータベースのパフォーマンスを簡単に見てみましょう。
VectorDB評価のテクニックと洞察:
- ベンチマークベクターデータベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
Zilliz Cloud Now Available in Tokyo on AWS, GCP, and Azure
Zilliz Cloud is now available in Tokyo on AWS, Google Cloud, and Azure — low-latency vector search with in-country data residency for Japanese AI teams.
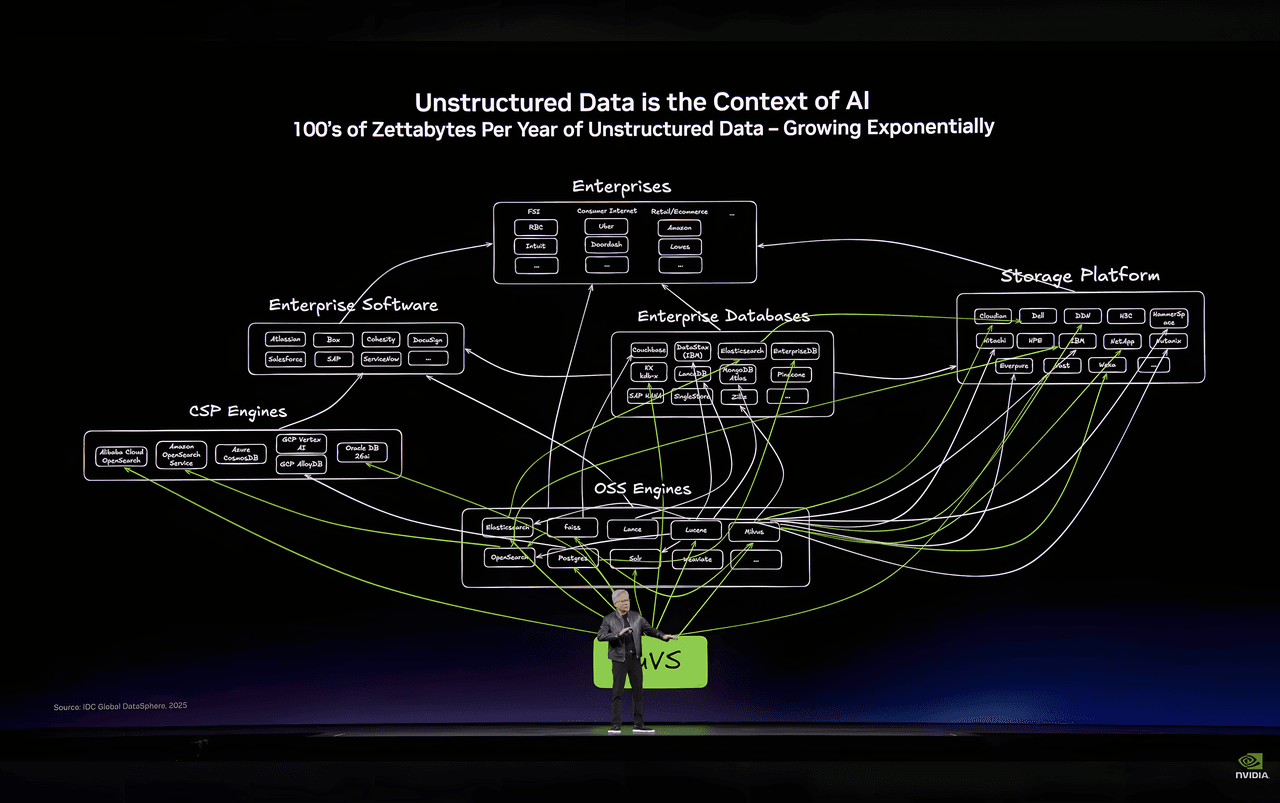
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.
DeepSeek vs. OpenAI: A Battle of Innovation in Modern AI
Compare OpenAI's o1 and o3-mini with DeepSeek R1's open-source alternative. Discover which AI model offers the best balance of reasoning capabilities and cost efficiency.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.