Zilliz Cloud オンデマンドコンピューティング:使用した分だけお支払い
前四半期、私たちは自動運転の顧客と請求に関するケースに取り組みました。その分析チームは、10億行のコレクションに対してベクトル検索を必要としていました。私たちはそれをDedicated clusterで見積もりました:$7,000/月。Serverlessも試しました:$10,800。実際の分析作業は月に数時間でした。
どちらの請求も正しいものでした。どちらのプロダクトも、まさに設計どおりに動作していました。問題は、この顧客のワークロード — 2つの他の本番ワークロードとデータセットを共有するまばらな分析 — が、どちらのプロダクトの設計意図にも合っていなかったことです。
そのケースこそが、私たちが Zilliz Cloud On-Demand Search を構築した理由です — Zilliz Vector Lakebase のローンチに合わせて出荷した新機能の1つです。同じワークロードで、$500/月未満。以下では、何が合わなかったのか、何を変えたのか、On-Demand が不適切なツールとなる場面、そして最後にそれが Vector Lakebase にどのように組み込まれるのかを説明します。
顧客のケース
そのコレクション — 約10億件のレコード — は、すでに2つの本番ワークロードで使用されていました。
- リアルタイムトラフィックを処理する online retrieval service。
- 回帰ジョブ用のシナリオデータを取得する model-training pipeline(別チームが運用)。
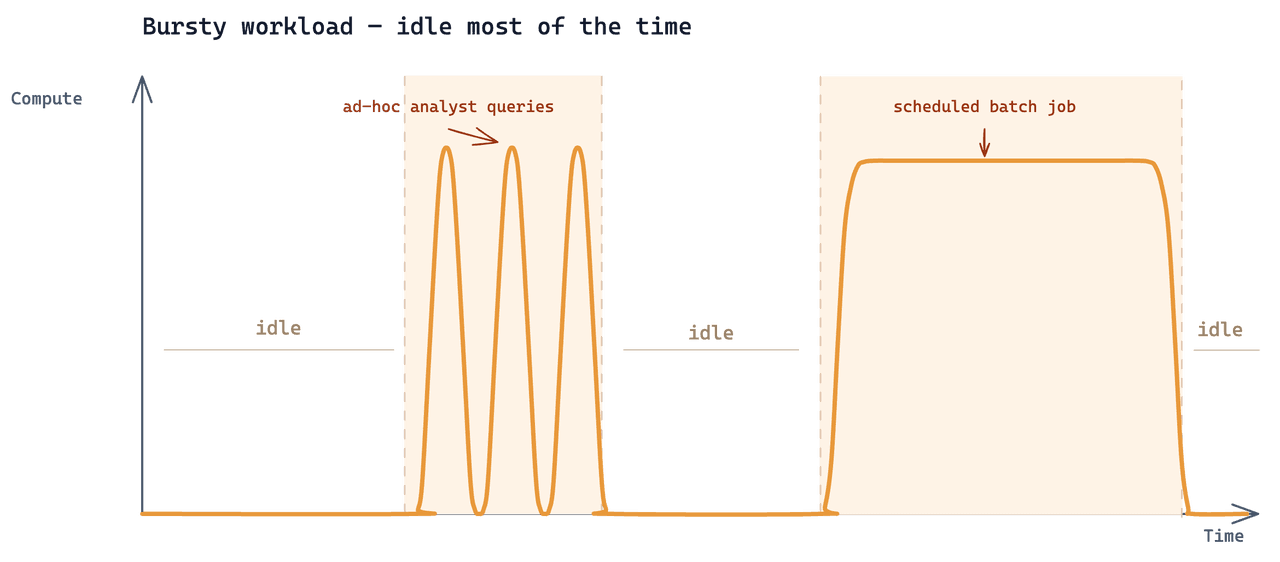
分析は、同じデータの上に追加される3つ目のワークロードでした。アクセスパターンは、アナリストが特定の問いを持ったときにだけ、現在の調査に基づく短い反復的なバーストで検索を実行するというものです。それ以外の時間は、分析クエリはクラスタに一切到達しません。
これは、かなり一般的なデータ規模における、かなり一般的な Zilliz のユースケースです。難しかったのは、3つすべてのワークロードが同じ基盤コレクションから読み取る必要があり、それぞれの実行ペースが大きく異なっていたことです。
Dedicated Cluster が合わなかった理由
既存のセットアップは、24 CU の Zilliz Cloud Tiered cluster でした。そこに分析ワークロードを追加すると、料金は約 $7,000/月になりました。クラスタは存在するすべての時間に対して課金されます:24 × 30 = 720 時間/月。実際の分析作業が消費したのは2〜3時間でした。残りの 717時間はアイドル状態のまま課金 されました — 総支出の99.6%が、誰も使っていないキャパシティに費やされたのです。
アイドル時間を避けるために、セッション間で Dedicated cluster を停止することはできます。私たちも検討しました。しかし、2つの理由でうまくいきません。
第一に、この規模のデータセットに対する分析用コールドクエリでは、Dedicated のコールドスタートに10分以上かかります。Dedicated のメンタルモデルでは、クエリ実行前に必要なすべてのデータがローカルメモリ内にある必要があるため、ワーキングセット全体をプリロードします — 通常、単一のコールドクエリが実際に触れるデータの数十倍から数百倍です。同じロードでは、DDL や削除など、クラスタがサポートする非クエリ作業の状態も立ち上げる必要があります。そのオーバーヘッドは、次のクエリがそれを必要とするかどうかに関係なく存在します。
第二に、課金は1時間単位に切り上げられます。そのため、アナリストがクラスタのウォームアップに10分以上待つことを受け入れたとしても、単一クエリの請求は依然として1時間分に加えてロード分になります。アナリストが短い反復的なバーストで実行する場合、開始/停止の運用をどれほど徹底しても、有用なクエリあたりのコストは高いままです。
Serverless Cluster が合わなかった理由
次に試した選択肢は Serverless でした。紙面上では、このアクセスパターンに適した形です:ステートレス、クエリごとの課金、アイドルコンピュートなし。分析ワークロード単体であれば、機能した可能性があります。
問題は、このデータセット上の Serverless は、分析ワークロードだけを切り離して価格設定しないことです。コレクションに触れるすべてのものを価格設定します。既存ワークロードを含めると、3つの明細項目によって計算が崩れました。
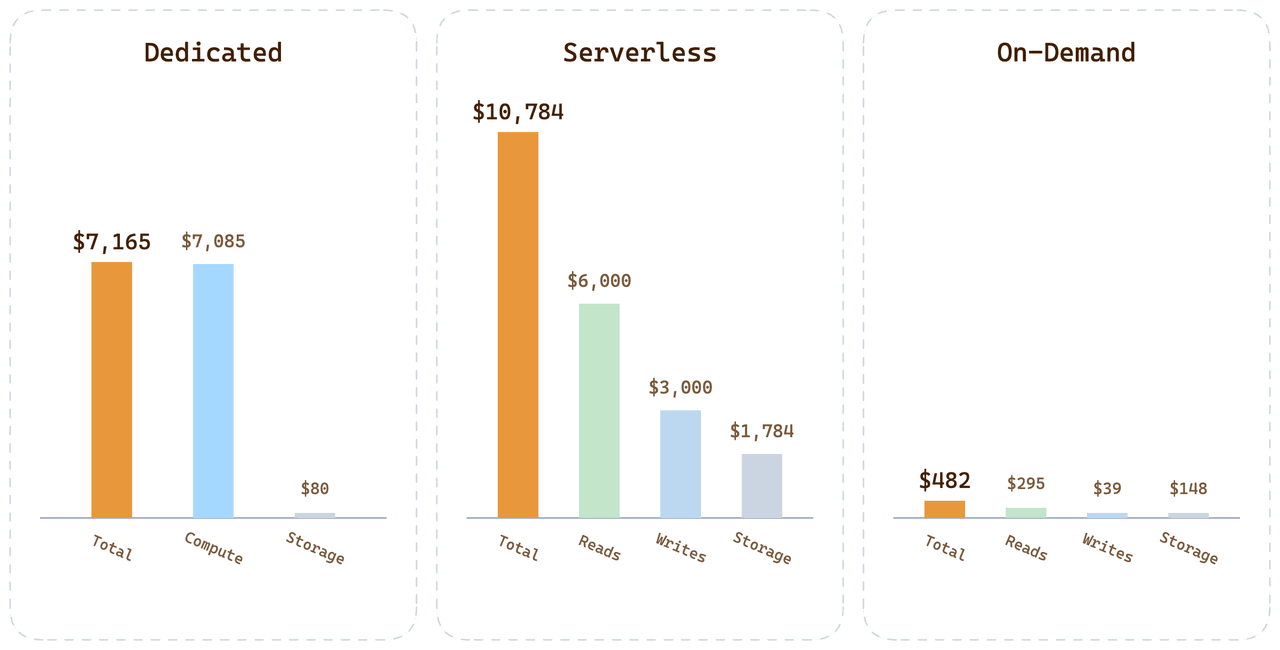
- クエリ: 月額約$6,000。 その大半は、モデル学習チームの隔週の回帰ジョブによるものです — 2週間ごとに、3時間にわたって100 QPS。Serverlessの単価にはコールドクエリのプレミアムが織り込まれており、クエリがホットな場合でも、すべてのクエリで支払われます。クエリ量がごくわずかでなくなると、採算が合わなくなります。
- ストレージ: 月額$1,700。 Serverlessにはストレージに織り込むためのコンピュート時間料金がないため、別途従量課金されます。
- 書き込み: 月額$3,000。 理由は同じです — 織り込むためのコンピュート時間がないからです。
合計: 月額$10,784。逃れようとしていたDedicatedクラスターより高くなりました。
これらのプレミアムには、それぞれ構造的な理由があります。
クエリにはコールドクエリのプレミアムが含まれます。 ユーザー側から見ると、Serverlessはステートレスです。プラットフォーム側から見ると、実行するには依然としてデータを特定のマシンにロードする必要があります。クエリはホット(データがすでにマシン上にある)とコールド(まずオブジェクトストレージから取得する)に分かれます。ホットクエリは安く、コールドクエリは高価です。プラットフォームは、特定のユーザーにとってどのクエリがコールドになるかを予測できないため、コールドクエリのコストをすべてのクエリの単価に分散します。ほとんどがホットクエリのワークロードは、結局、他の全員のコールドクエリの費用を負担することになります。
ストレージは限界費用を上回る価格になっています。 Dedicatedでは、ストレージと書き込みのコストはコンピュート時間料金に見えない形で乗っています。Serverlessには、そうしたコストを隠すためのコンピュート時間料金がないため、ストレージは明示的に課金されます。その明示的な価格は、保存されているが一度もクエリされないデータもカバーしなければなりません — プラットフォームはそれを極端にコールドなストレージへ移すことはできません。データはいつでもクエリ可能な状態を保つ必要があるからです。その準備状態を維持するには追加のステートが必要で、そのコストはストレージサイズに按分されますが、ストレージサイズは実際の消費を正確に反映しているわけではありません。
書き込みも限界費用を上回る価格になっています。 書き込みは、データセットを増やさずに多くの書き込みコストを発生させる高頻度の更新をユーザーが行うのを防ぐため、別途従量課金されます(そうでなければ、プラットフォームがそのコストを吸収することになります)。ストレージと同じ構図です。準備状態のコストが、書き込みごとの単価に織り込まれます。
より根本的な問題は、Serverlessが「コンピュートリソース」という抽象化をユーザーから隠していることです。ユーザーにはステートレスなインターフェースが見えますが、プラットフォームはその裏側で予測不能なアクセスパターン — ホット/コールドデータ、バースト的なトラフィック、クエリ可能な状態を保たなければならないアイドルストレージ — のコストを支払わなければなりません。これらのコストは特定のユーザーに正確に帰属させることができないため、クエリ、ストレージ、書き込みの単価に按分されます。課金対象となるすべてのアクションが、実際の限界費用より一段高くなります。
これは「リスク共有」モデルです。すべての明細項目に、誰か別の人のコールドクエリ、バースト、またはアイドルストレージをカバーするための上乗せ料金が含まれています。その変動の原因となる度合いが最も低いワークロード — 安定した、高頻度で、予測可能なホットクエリ — が、最も大きなプレミアムの取り分を支払います。ワークロードが安定しているほど、より多くを補助することになります。
顧客が実際に必要としていたもの
一歩引いて見ると、顧客の要望は特異なものではありませんでした。1つのデータセット、複数のアクセス頻度、そして各頻度が実際に使用したコンピュートだけに従って請求されること。
- オンライン検索: 継続的、低レイテンシ、予測可能。これにはDedicatedが適しています。
- モデル学習: バースト的だが予測可能 — 2週間ごとに3時間。
- 分析: まばらで予測不能 — 長い間隔を挟んで、その都度数分。
Dedicatedではそれを実現できませんでした。消費量ではなく、プロビジョニングされた容量に対して課金されるからです。Serverlessでも無理でした。クエリごとの単価は、プラットフォーム上の全ユーザーにまたがるコールドクエリ、アイドルストレージ、バースト余力を補助しなければならないため、安定したワークロードは、自分たちが生み出していない変動の費用を支払うことになります。
必要だったのは、第三のコンピュートモデルでした — Dedicatedと同じデータに接続でき、クエリごとの課金を現実的にできるほど高速に起動し、実際に実行されているときだけ課金されるものです。
変更したこと
On-Demand は Zilliz Cloud 上の独立したコンピューティングモデルで、Dedicated および Serverless と並んで存在します。これらのいずれと比較しても、次の 3 点が異なります。
- コールドスタート。 ワーキングセット全体ではなく、現在のクエリが触れるチャンクだけをロードします。10 分以上から数秒に短縮されます。
- 課金。 実際のコンピューティング稼働時間に対する分単位課金。書き込みも対象です。最低 1 時間の縛りも、クエリごとのコールド/ホットの割増料金もありません。
- 分離。 各ワークロードは、それぞれ独自のコンピューティングリソースグループを通じてコレクションに接続します。同じデータでありながら、競合はありません。
次の 3 つのセクションでは、それぞれについて説明します。
より少ないデータを、より速くロードする
Dedicated における 10 分のコールドスタートは、クラスターがクエリを処理する前にワーキングセット全体をローカルメモリへ取り込む必要があるために発生します。10 億行のコレクションでは、それは単一のクエリが実際に必要とするデータの数十倍から数百倍に相当します。コールドスタートを数秒に圧縮するには、その前提を捨てる必要があります。つまり、現在のクエリが触れるものだけをロードします。
一文で言えば簡単に聞こえますが、実際には 3 つのレイヤー、すなわち何を読むか、どこに置くか、どのように立ち上げるかを再設計する必要がありました。
部分的にロードできるインデックス。
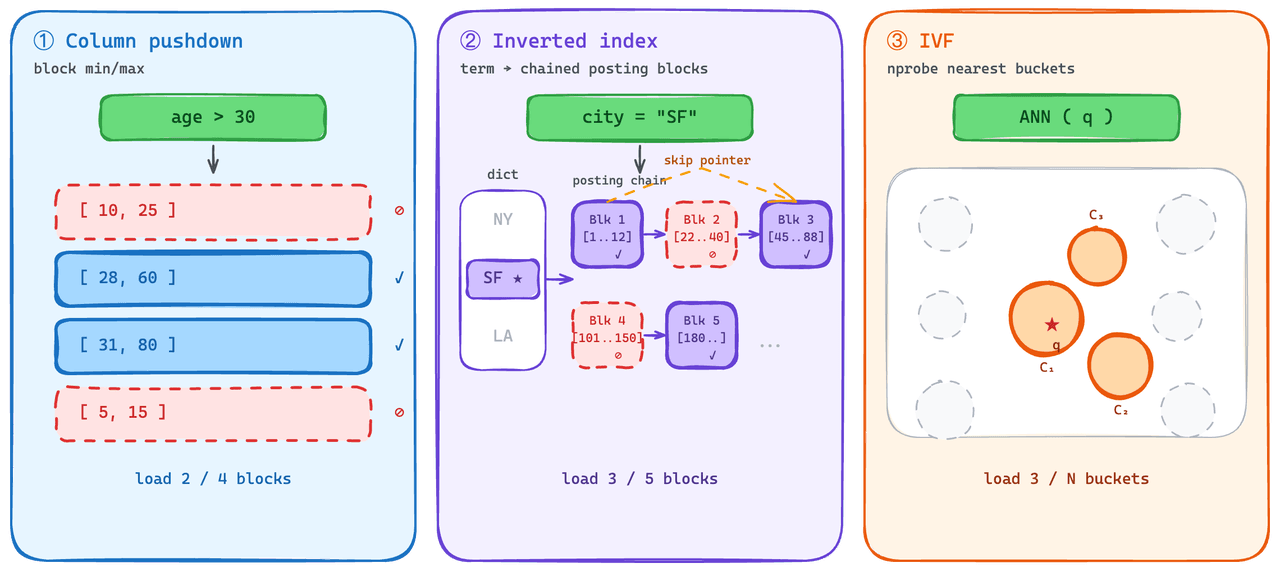
スカラー側では、述語プッシュダウンは標準的な手法です。エンジンは述語に一致し得ないブロックを除外し、それらの取得をスキップします。私たちはこれを転置インデックスで利用しています。各 posting list はブロックとしてロードされ、各リストにはエンジンが取得前に確認できる min/max 統計が含まれています。
より難しかったのは、ベクトル側にも同等の「サブセットを読む」機能を持たせることでした。グラフインデックスは、定常状態の QPS において高性能な選択肢ですが、部分ロード時にうまく性能が劣化しません。有用であるためには構造全体をロードする必要があるため、コールドロードのコストが高くなります。
On-Demand では代わりに IVF family を使用します。IVF はインデックス作成時にベクトルをバケットにクラスタリングし、クエリ時にはクエリに最も近いバケットだけを取得します。これにより、ベクトル側にも述語プッシュダウンに近いセマンティクスが得られます。コールドクエリはインデックス全体ではなく、そのごく一部だけを取得します。
これは意図的なトレードオフです。graph indexes の定常状態での性能は失われます。これが、On-Demand が高 QPS のサービングに適していない主な理由です(詳細は後述します)。スパースでバースト的なワークロードでは、このトレードオフには価値があります。
3 層のデータパス。
何を読むべきかが分かると、次の問題はそれをどこに保持するかです。チャンクは S3、ローカルディスク、メモリの間を自由に流れ、キャッシュのライフサイクルはクエリ間でチャンク単位に管理されます。現在のクエリが必要とするチャンクは引き上げられ、十分な時間アイドル状態のままのチャンクは削除されます。同じデータセットでも非常に異なる頻度でクエリされる可能性があり、いずれの場合も触れないデータをロードするコストを支払うことはありません。
各層には、それぞれのメディアの IO 特性に適応した独自のデータレイアウトと粒度があります。オブジェクトストレージに適したアラインメントはローカルディスクに適したアラインメントとは異なり、そのどちらもエンジンがメモリ上で実行対象とするものとは一致しません。
エンドツーエンドの非同期 IO。
IO チェーンは完全に非同期です。コンピューティングと IO は全体を通してパイプライン化されているため、CPU がフェッチを待って遊休状態になることも、IO 帯域幅がコンピューティングを待って遊休状態になることもありません。
総合すると、チャンク化 + 階層化 + 非同期化により、コールドクエリのペイロードはデータセット全体の 1~2% 未満に、エンドツーエンドのコールドパスは数秒に短縮されます。
分単位課金
コールドスタートが秒単位になると、「クエリが到着したらコンピューティングを起動し、終了したら解放する」ことが、単なる設計上の理想ではなく、実際のプロダクト機構として機能します。コントロールプレーンの 2 つの要素が重要な役割を担います。
スタンバイノードプール。 イメージの pull は、新しいノードを立ち上げる際のレイテンシを増加させます。私たちは事前に pull 済みのノードを小規模なプールとして待機させているため、スピンアップはゼロから開始するのではなく、そのプールから取得されます。
TTLベースの解放。 各セッションには設定可能なアイドルタイムアウトがあります。タイムアウトが発火したとき、クエリワークロードが終了したとき、またはセッションが閉じられたときに、コンピュートは自動的に解放されます。ライフサイクル全体がプラットフォームによってスケジュールされます — 「クラスターの停止を忘れた」状態も、手動運用もありません。
ライフサイクルが細粒度であるため、課金粒度もそれに合わせて下がります。コンピュートは実際の稼働時間に対して分単位で課金されます — 最低1時間も、クエリごとの最低料金もありません。書き込みも同じ方法で計測されます: 実際のリソース使用量を分単位で。
このコスト帰属の精度こそが、On-Demand が Serverless で必要となるストレージプレミアムを回避できる理由です。Serverless はストレージを限界費用より高く価格設定します。なぜなら、そのコンピュート層には帰属先のないコストを吸収する方法がないからです — プラットフォームが支出するすべてのドルは請求書のどこかに載せる必要があるため、ストレージと書き込みが、他の場所に帰属できないものの受け皿になります。On-Demand がコンピュートの毎分を特定のセッションに課金する場合、帰属先のないプールは存在しません。On-Demand のストレージは Zilliz Cloud pricing に従い、Dedicated レートが適用されます — 典型的な Serverless ストレージの約1/10です。
共有データ上のワークロード分離
3つ目の変更は、コンピュート層を明示的にすることです。Dedicated では、コンピュート層はクラスターです — ユーザーには単一のサイズ指定パラメータとして以外は見えません。Serverless では、コンピュート層は完全に隠されています。On-Demand はそれを公開します。
各ワークロードは、コンピュートリソースグループを通じてコレクションに接続します。新しいグループは、セッションを介して起動されるか、既存のものが再利用されます。異なるグループは互いに分離され、各グループの請求はそのグループ自身の消費のみを反映します。
自動運転のケースでは、これが分析ワークロードがデータに対する独自の接続を得る方法です: アドホッククエリ用に起動し、アイドル時に解放される On-Demand リソースグループで、既存のオンライン検索およびモデル学習ワークロードと同じ Milvus collection、同じインデックス、同じメタデータ上で実行されます。ストレージとコンピュートの分離により、それらのいずれもデータを使用するためにコピーや同期を行う必要がありません。相互補助も、スケジューリング競合も、クラスター形状についてのチーム間の運用調整もありません。
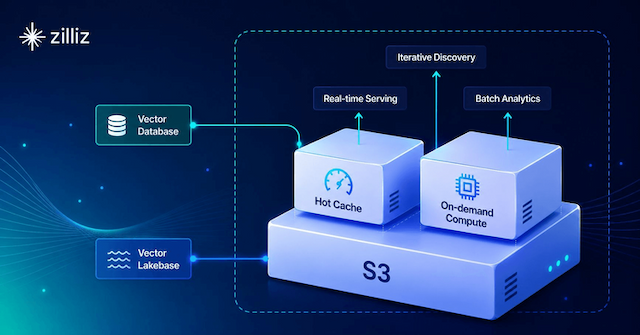
これは、データレイクと同じアーキテクチャパターンをベクトル検索に適用したものです: ストレージが共有基盤であり、コンピュートは各ワークロードが必要とする任意の形で接続します。
請求額、その後
同じ顧客ワークロードを3つの選択肢すべてで比較すると:
| 選択肢 | 月額請求 | お金の行き先 |
|---|---|---|
| Dedicated (24 CU Tiered) | $7,165 | コンピュートの99.6%は支払われているがアイドル状態 |
| Serverless | $10,784 | クエリプレミアム + $1,700 ストレージ + $3,000 書き込み |
| On-Demand | < $500 | 分単位のコンピュート + Dedicated レートのストレージ |
このワークロードにおける On-Demand は、Serverless の請求額の 1/20未満 に収まります。この差は価格設定のトリックではありません。実際の消費にコストを帰属させるのではなく、他のユーザーの変動をすべての単価に償却することの直接的な結果です。
On-Demand が適さない場面
On-Demand は Dedicated や Serverless の万能な代替ではありません。まばらでバースト的なワークロードに対して安価にする同じ設計上の選択が、他のワークロードには不向きにします。以下のグラフは、この顧客ワークロードについて、3つの選択肢すべてにおけるクエリ負荷に対する月額コストを示しています。
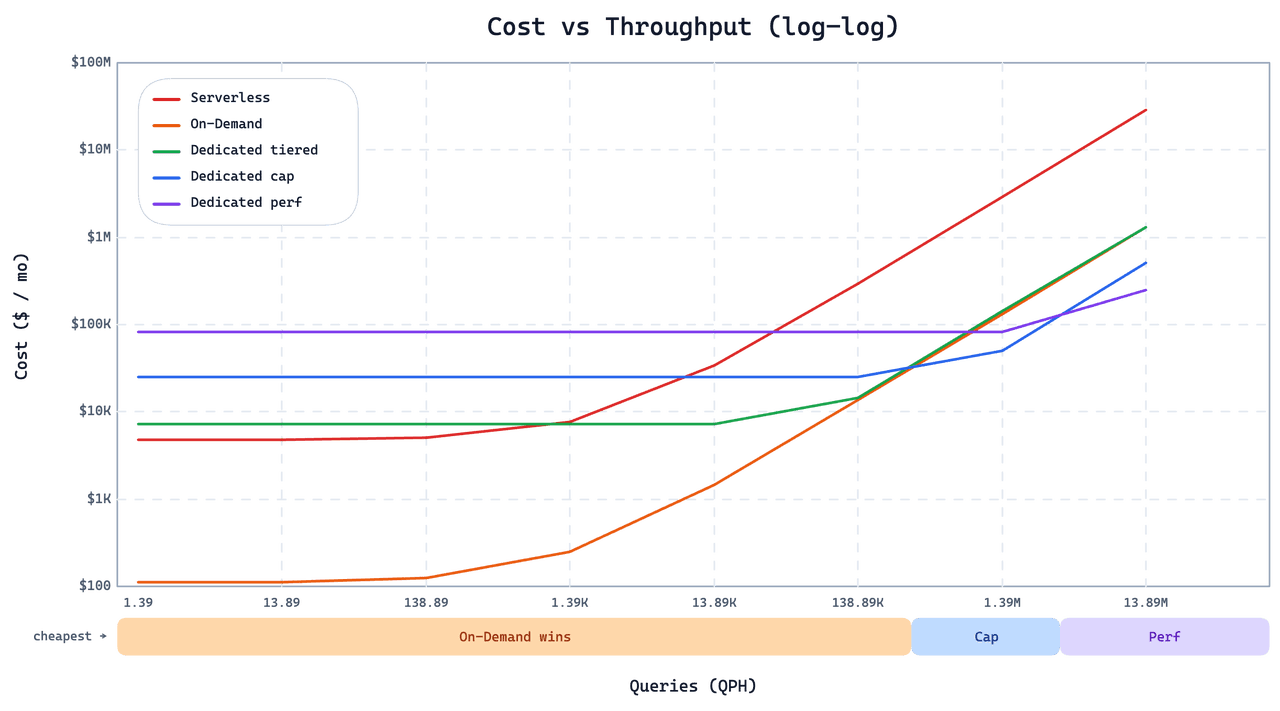
クロスオーバーより下では、On-Demand は大幅に安価です。QPS が数十に達すると、Dedicated Cap or Perf instances の方が安価かつ高速になります。2つの設計判断がこのクロスオーバーを説明します:
グラフインデックスなし。 コールドクエリの読み込みコストを低く抑えるため、On-Demand はグラフインデックスではなく IVF を使用します。グラフインデックスは大規模環境でより高い定常状態 QPS を実現しますが、コールドロードのコストは高くなります。数十 QPS を超えると、定常状態での優位性が決定的に勝ります。高 QPS のサービングには Dedicated を使用してください。
コールドクエリでの高いテールレイテンシ。 On-Demand はデータをプリロードしないため、コールドクエリは実行前に追加のフェッチが発生します。ウォームクエリは高速ですが、コールドクエリは明らかに遅く、テールレイテンシの分布は Dedicated や Serverless より広くなります。アプリケーションが、時折発生する秒単位(またはそれ以上に悪い、分単位)の応答を許容できない場合、On-Demand は適していません。そのようなワークロードには、Dedicated の Smart Autoscaling が、ウォーム状態のレイテンシを犠牲にすることなくアイドル容量を削減します。
On-Demand が適切なツールである領域: 大規模データセットに対するスパースアクセス、分析的反復処理、バッチマイニング — 高い同時実行性と厳密なレイテンシ一貫性が主要要件ではないワークロード。
Zilliz Vector Lakebase における位置づけ
この投稿の顧客事例は、より大きなパターンの一断面です。同じデータセットが、異なるワークロードによって異なる頻度でアクセスされ、各ワークロードが実際に必要とするコンピュート形状を得て初めて適切にサイジングされる、というパターンです。On-Demand はコンピュート形状の 1 つです。Zilliz Vector Lakebase は、それ以外を可能にするアーキテクチャです。
Vector Lakebase は、AI ワークロード向けのレイクネイティブなデータプラットフォームです。データは S3 上に置かれ、インデックスはコンピュートから分離され、異なるコンピュート形状がゼロコピーアクセスを通じて同じコレクションに接続します。リアルタイム検索、反復的ディスカバリー、バッチ分析という 3 つのワークロードモードを第一級の機能として扱い、それぞれのアクセスパターンに合ったコンピュート形状で提供します。ベクトル検索はこれまでも Zilliz Cloud 上の第一級ワークロードでした。Vector Lakebase のローンチにより、反復的ディスカバリーとバッチ分析のコンピュート形状が、同じデータ基盤上に加わります。
On-Demand は、分析的でバースト性のあるワークロード向けに構築されたコンピュート形状です。残りの 4 つの機能が、その他のモードをカバーします。
- Tiered Serving Solutions はリアルタイム検索向け — Performance-Optimized(1000+ QPS、1 桁ミリ秒レイテンシ、すべてメモリ上)、Capacity-Optimized(メモリ + ローカル NVMe で 100–500 QPS、100 ms 未満のレイテンシ)、Tiered-Storage(メモリ、NVMe、オブジェクトストアにまたがり 10–50 QPS、約 100 ms のレイテンシ)。パフォーマンス/コスト曲線上の異なるポイントで、同じサービングモードです。
- External Data Lake Search は、Lance、Iceberg、その他のレイクフォーマットにすでに存在するデータのインデックス作成と検索向け — 別のストアにコピーする必要はありません。
- Full-Spectrum Search は、1 つのクエリプレーン上でベクトル、テキスト、JSON、地理空間を扱うためのもので、ワイドテーブルデータモデル上でハイブリッド検索、フィルタリング、リランキングを提供します。
- Unified Lake-Native Storage は Vortex 上に構築されており、Lance や Parquet より高速なランダム読み取りを備えた次世代のオープンなカラムナフォーマットで、さらに列ごとのフォーマット柔軟性を提供します。
Zilliz Vector Lakebase は現在、Zilliz Cloud でパブリックプレビュー中です。完全なアーキテクチャとその他の機能については、Vector Lakebase deep-dive が標準的な解説です。
ご自身のワークロードで On-Demand を試すには、Zilliz Cloud にサインアップ し、コンソールまたは CLI から On-Demand クラスターを起動してください。この投稿の数値が、実行中の何かに当てはまる場合は、構築前に Zilliz チーム が喜んでワークロードについてご相談に乗ります。
読み続けて
A Few Notes from Databricks Data + AI Summit 2026: Why the Data Layer Matters Again
James Luan shares notes from Databricks Data + AI Summit 2026 on why production AI is pushing the data layer back to the center of infrastructure.
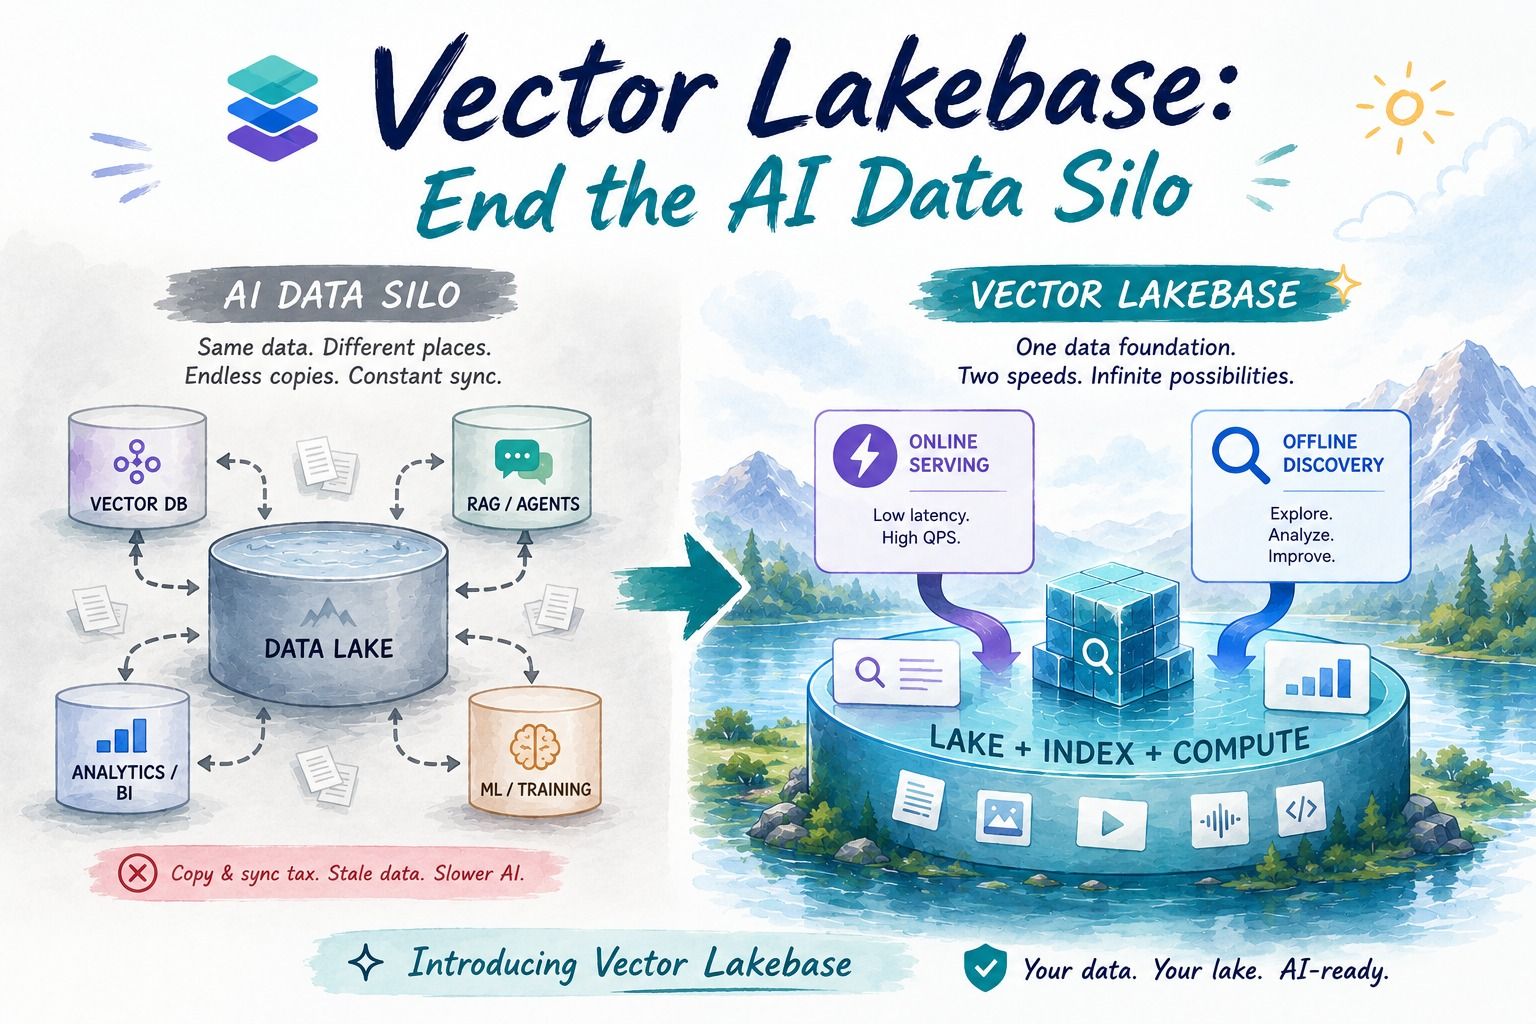
Vector Lakebase: End the AI Data Silo
Learn how Vector Lakebase unifies vector search, data lakes, and AI data operations so teams can serve RAG and agents without copy-and-sync pipelines.
Milvus/Zilliz + Surveillance: How Vector Databases Transform Multi-Camera Tracking
See how Milvus vector database enhances multi-camera tracking with similarity-based matching for better surveillance in retail, warehouses and transport hubs.