




Vespa vs Deep Lake AIアプリに適したベクターデータベースの選択
ベクターデータベースとは?
VespaとDeep Lakeを比較する前に、まずベクターデータベースの概念を探ってみましょう。
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、照会するように設計されています。ベクトルは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品の属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために外部知識を提供することで大規模言語モデル(LLMs)のパフォーマンスを向上させる技術である、検索拡張生成(RAG)でも重要な役割を果たしている。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Vespaは専用のベクターデータベースである。Deep Lakeは、ベクトル検索機能をアドオンとして持つ、ベクトル埋め込みに最適化されたデータレイクだ。この記事では、両者のベクトル検索機能を比較する。
Vespa概要とコアテクノロジー
Vespaは強力な検索エンジンとベクトルデータベースで、複数の種類の検索を一度に扱うことができます。ベクター検索、テキスト検索、構造化データによる検索に優れています。つまり、類似したアイテム(画像や商品など)を検索したり、テキスト内の特定の単語を検索したり、日付や数字に基づいて検索結果をフィルタリングしたりすることができます。Vespaは柔軟性があり、単純な数値から複雑な構造まで、さまざまな種類のデータを扱うことができます。
Vespaの際立った特徴のひとつは、ベクトル検索ができることです。ドキュメントにいくつでもベクトルフィールドを追加することができ、Vespaはそれらを素早く検索します。Vespaはテンソルと呼ばれる特殊なベクトルも扱うことができ、マルチパートのドキュメント埋め込みなどを表現するのに便利です。Vespaはこれらのベクトルをどのように保存し検索するかについてスマートなので、速度を落とすことなく本当に大量のデータを扱うことができます。
Vespaは超高速かつ効率的に構築されています。メモリを管理し、検索を行うためにC++で書かれた独自の特別なエンジンを使用しているため、複雑なクエリや大量のデータを扱ってもうまく動作します。新しいデータを追加したり、たくさんの検索を同時に処理したりしても、スムーズに動作し続けるように設計されています。そのため、多くのトラフィックやデータを処理する必要がある、大規模で現実的なアプリケーションに最適です。
Vespaのもう一つの優れた点は、より多くのデータやトラフィックを処理するために自動的にスケールアップできることです。Vespaのセットアップにコンピュータを追加すれば、自動的にそのコンピュータに作業を分散させることができる。これは、複雑なセットアップをすることなく、ニーズの成長に合わせて検索システムを成長させることができることを意味します。Vespaは、データ量やトラフィックの変化に対応するために自動的に調整することもでき、コスト削減に役立ちます。そのため、時間とともに成長する検索システムを必要とするビジネスには最適です。
ディープレイクとは?概要とコアテクノロジー
ディープレイク](https://github.com/activeloopai/deeplake)は、AIや機械学習で広く使用される画像、音声、動画、その他の非構造化データなどのベクトルデータやマルチメディアデータを扱うために構築された特殊なデータベースである。データレイクとしてもベクターストアとしても機能する:
- データレイクとして**:Deep Lakeは、非構造化データ(画像、音声、動画、テキスト、医療画像用のNIfTIのようなフォーマット)をバージョン管理された形式で保存・整理することをサポートします。このセットアップにより、深層学習タスクのパフォーマンスが向上する。データセットの高速な照会と視覚化が可能になり、AIモデル用の高品質なトレーニングセットの作成が容易になる。
- ベクターストアとして**:Deep Lakeは、vector embeddingsと関連するメタデータ(テキスト、JSON、画像など)の保存と検索のために設計されています。データはローカル、クラウド環境、または Deep Lake のマネージドストレージに保存できます。LangChainやLlamaIndexのようなツールとシームレスに統合され、RAG(Retrieval Augmented Generation)アプリケーションの開発を簡素化します。
Deep Lakeは、Hnswlibパッケージをベースに最適化を加えたHNSW(Hierarchical Navigable Small World)インデックスを、近似最近傍(ANN)検索に使用しています。これにより、3,500万以上の埋め込みデータを1秒未満で検索することができます。独自の機能として、より高速にインデックスを作成するためのマルチスレッディングや、RAM使用量を削減するためのメモリ効率的な管理があります。
デフォルトでは、Deep Lakeは10万行までのデータセットに対して線形埋め込み検索を使用します。それ以上のデータセットでは、精度とパフォーマンスのバランスを取るためにANNに切り替わる。APIにより、ユーザーは必要に応じてこの閾値を調整できる。
Deep Lakeのインデックスは、属性検索とベクトル検索を組み合わせた検索(現在は線形検索に依存している)には使用されないが、今後のアップデートでこの制限に対処し、機能をさらに向上させる予定だ。
ベクターストアとしての Deep Lake: Deep Lake は、vector embeddings と、テキスト、JSON、画像、音声、動画ファイルなどの関連メタデータを保存・検索するための堅牢なソリューションを提供します。ローカル、お好みのクラウド環境、またはDeep Lakeのマネージドストレージにデータを保存できます。また、Deep LakeはLangChainやLlamaIndexのようなツールとのシームレスな統合も提供しており、開発者は検索拡張世代(RAG)アプリケーションを簡単に構築することができます。
主な違い
ベクトル検索ツールとしてVespaとDeep Lakeのどちらを選ぶかを決めるとき、主要な次元にわたる違いを理解することは、ユースケースに適したものを選ぶのに役立ちます。ここでは、両者の長所とトレードオフについて説明します:
検索方法
Vespa:Vespaは、ベクトル検索、テキスト検索、構造化データクエリを1つのシステムに統合したマルチモーダル検索に優れています。構造化フィールド(日付やカテゴリなど)によるベクトルベースの結果のフィルタリングなど、高度な検索シナリオをサポートしています。Vespa独自のエンジンは高性能なベクトル検索に最適化されており、テンソルとして表現されるマルチパートのドキュメント埋め込みを含む複雑なクエリを処理することができます。
Deep Lake: Deep Lakeはマルチメディアデータ(画像、音声、動画など)のベクトル検索に特化している。近似最近傍(ANN)検索にHNSWアルゴリズムを使用しており、高速で大規模な類似検索に最適です。しかし、インデックス内でベクトルと属性フィルタを直接組み合わせることはサポートしていません。これは、構造化検索と非構造化検索の緊密な統合を必要とするアプリケーションにとっては制限となるかもしれない。
データの取り扱い
Vespa:Vespaは非常に汎用性が高く、構造化、半構造化、非構造化データを扱うことができます。カスタム・データモデルをサポートしているので、ベクトル検索以外にも、レコメンデーション・システムやeコマース・プラットフォームなど、幅広いアプリケーションに適しています。
**ディープレイクDeep Lakeはマルチメディアと非構造化データにフォーカスしている。特にAIや機械学習のワークフローにおいて、大規模なデータセットを保存・整理するためのデータレイクだ。バージョン管理されたフォーマットはコラボレーションやデータセットのキュレーションを容易にするが、堅牢な構造化データの取り扱いを必要とするアプリケーションには適さないかもしれない。
スケーラビリティとパフォーマンス
Vespa:Vespa はエンタープライズ規模向けに設計されています。分散アーキテクチャにより、大規模なデータセットや大量のクエリを処理できます。動的なスケーリングにより、データやトラフィックが増大してもリソースを効率的に利用できます。C++エンジンは高負荷時でも低レイテンシーを実現します。
Deep Lake:DeepLakeは大規模なベクトルデータセットのスケーラビリティに優れ、数千万のエンベッディングを秒以下のクエリタイムで処理できる。ベクトルベースの検索には適していますが、より小さなデータセットや複合検索に対する線形検索は、場合によってはパフォーマンスのボトルネックになるかもしれません。
柔軟性とカスタマイズ
Vespa:データモデリング、クエリ構築、ランキングアルゴリズムに多くのカスタマイズオプションがある。開発者はビジネスニーズに合わせて検索動作を調整できるので、Vespaは高度にカスタマイズされたアプリケーションに最適です。
**Deep Lake: AIワークフローを使いやすくするために設計されたDeep Lakeは、ストレージ、バージョン管理、クエリを組み込むための柔軟なAPIを備えている。しかし、検索ロジックのカスタマイズオプションはVespaよりも狭い。
統合とエコシステム
Vespa:Vespaは汎用のツールやフレームワークと統合できる。特定のAIワークフローに縛られることはないが、検索基盤を提供することでそれらを補完することができる。
Deep Lake: Deep LakeはAI/MLエコシステムと深く統合されており、LangChain、LlamaIndex、主要なディープラーニングフレームワークとシームレスに動作する。検索拡張世代(RAG)システムの構築に最適です。
使いやすさ
**ベスパ強力な機能には、より厳しい学習曲線が伴う。セットアップ、コンフィギュレーション、メンテナンスには、特に分散デプロイメントでは、ある程度の専門知識が必要です。
**ディープレイクDeep Lakeは、開発者がシンプルに使えるように設計されており、シンプルなAPIとAI実務者向けの明確なドキュメントが用意されている。マネージド・サービス・オプションにより、運用のオーバーヘッドを削減できます。
コスト
Vespa:コストはインフラとスケーリング要件に依存します。セルフホスティングはリソースを消費しますが、Vespaのリソース最適化は長期的なコスト削減に役立ちます。
Deep Lake: Deep Lakeの価格設定は、特にマネージドサービスを利用する場合、ストレージとクエリ量に基づく。大規模なベクトル検索を効率的に行うことで、運用コストの競争力を維持している。
セキュリティ
Vespa:エンタープライズグレードのセキュリティ、暗号化、認証、アクセスコントロール。高いセキュリティ要件が求められる組織に適しています。
**ディープレイクマネージドサービスのセキュリティ、データ暗号化、アクセス制御。セルフホスティングのセキュリティには別途作業が必要です。
Vespaを選択する場合
Vespaは、ベクター、テキスト、構造化データを一度に扱える検索システムが必要な場合に最適です。分散型でスケーラブルなVespaは、eコマース、レコメンデーションシステム、エンタープライズサーチのような高トラフィックかつ大規模な環境に最適です。属性フィルタリングやベクトル類似検索を含む複雑なクエリを使用する場合、またはビジネスニーズに合わせて多くのカスタマイズが必要な場合、Vespaは柔軟性とパフォーマンスを提供します。
ディープレイクを選ぶとき
Deep Lakeは、画像、音声、動画などの非構造化データやマルチメディアデータに大きく依存するAIや機械学習のワークフローに最適です。LangChainやLlamaIndexとの統合により、RAG(Retrieval-Augmented Generation)アプリケーションやその他のディープラーニングタスクに適しています。大規模なベクトル埋め込みデータを簡単に管理・照会し、データセットのバージョン管理を行いたい場合、Deep LakeのシンプルさとAIエコシステムへの注力は、AI実務者や研究者にとって合理的なソリューションです。
要約
Vespaは、複数のデータタイプを持つ複雑な分散検索シナリオに最適で、エンタープライズ規模のカスタマイズが可能です。Deep LakeはAIワークフローのためのベクトル検索やデータハンドリングに最適で、マルチメディアや非構造化データにはシンプルで効率的です。ユースケースに合わせてお選びください:Vespaは幅広い検索ニーズに、Deep Lakeはベクトル埋め込みとデータセット管理によるAI主導のプロジェクトに適しています。
VespaとDeep Lakeの概要についてはこちらをお読みいただきたいが、これらを評価するには、ユースケースに基づいて評価する必要がある。それに役立つツールの1つが、ベクターデータベースを比較するためのオープンソースのベンチマークツールであるVectorDBBenchだ。最終的には、独自のデータセットとクエリパターンで徹底的なベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力だが異なるこの2つのアプローチのどちらを選択するかの鍵となるだろう。
オープンソースのVectorDBBenchを使ってベクトルデータベースを評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのためのオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)のような異なるベクトルデータベースシステムを独自のデータセットを用いてテストし比較することができ、ユーザのユースケースに合うものを見つけることができます。VectorDBBenchを使えば、ユーザーはマーケティング上の主張や伝聞ではなく、実際のベクターデータベースのパフォーマンスに基づいて決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)**で主流のベクトルデータベースの性能を見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマークベクターデータベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: オープンソースベクターデータベースベンチマークツール](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
What Is a Vector Lakebase?
A Vector Lakebase is a unified, lake-native data architecture for AI that combines vector-database-grade serving with open lake storage, reusable lake-level indexes, and a shared semantic layer.
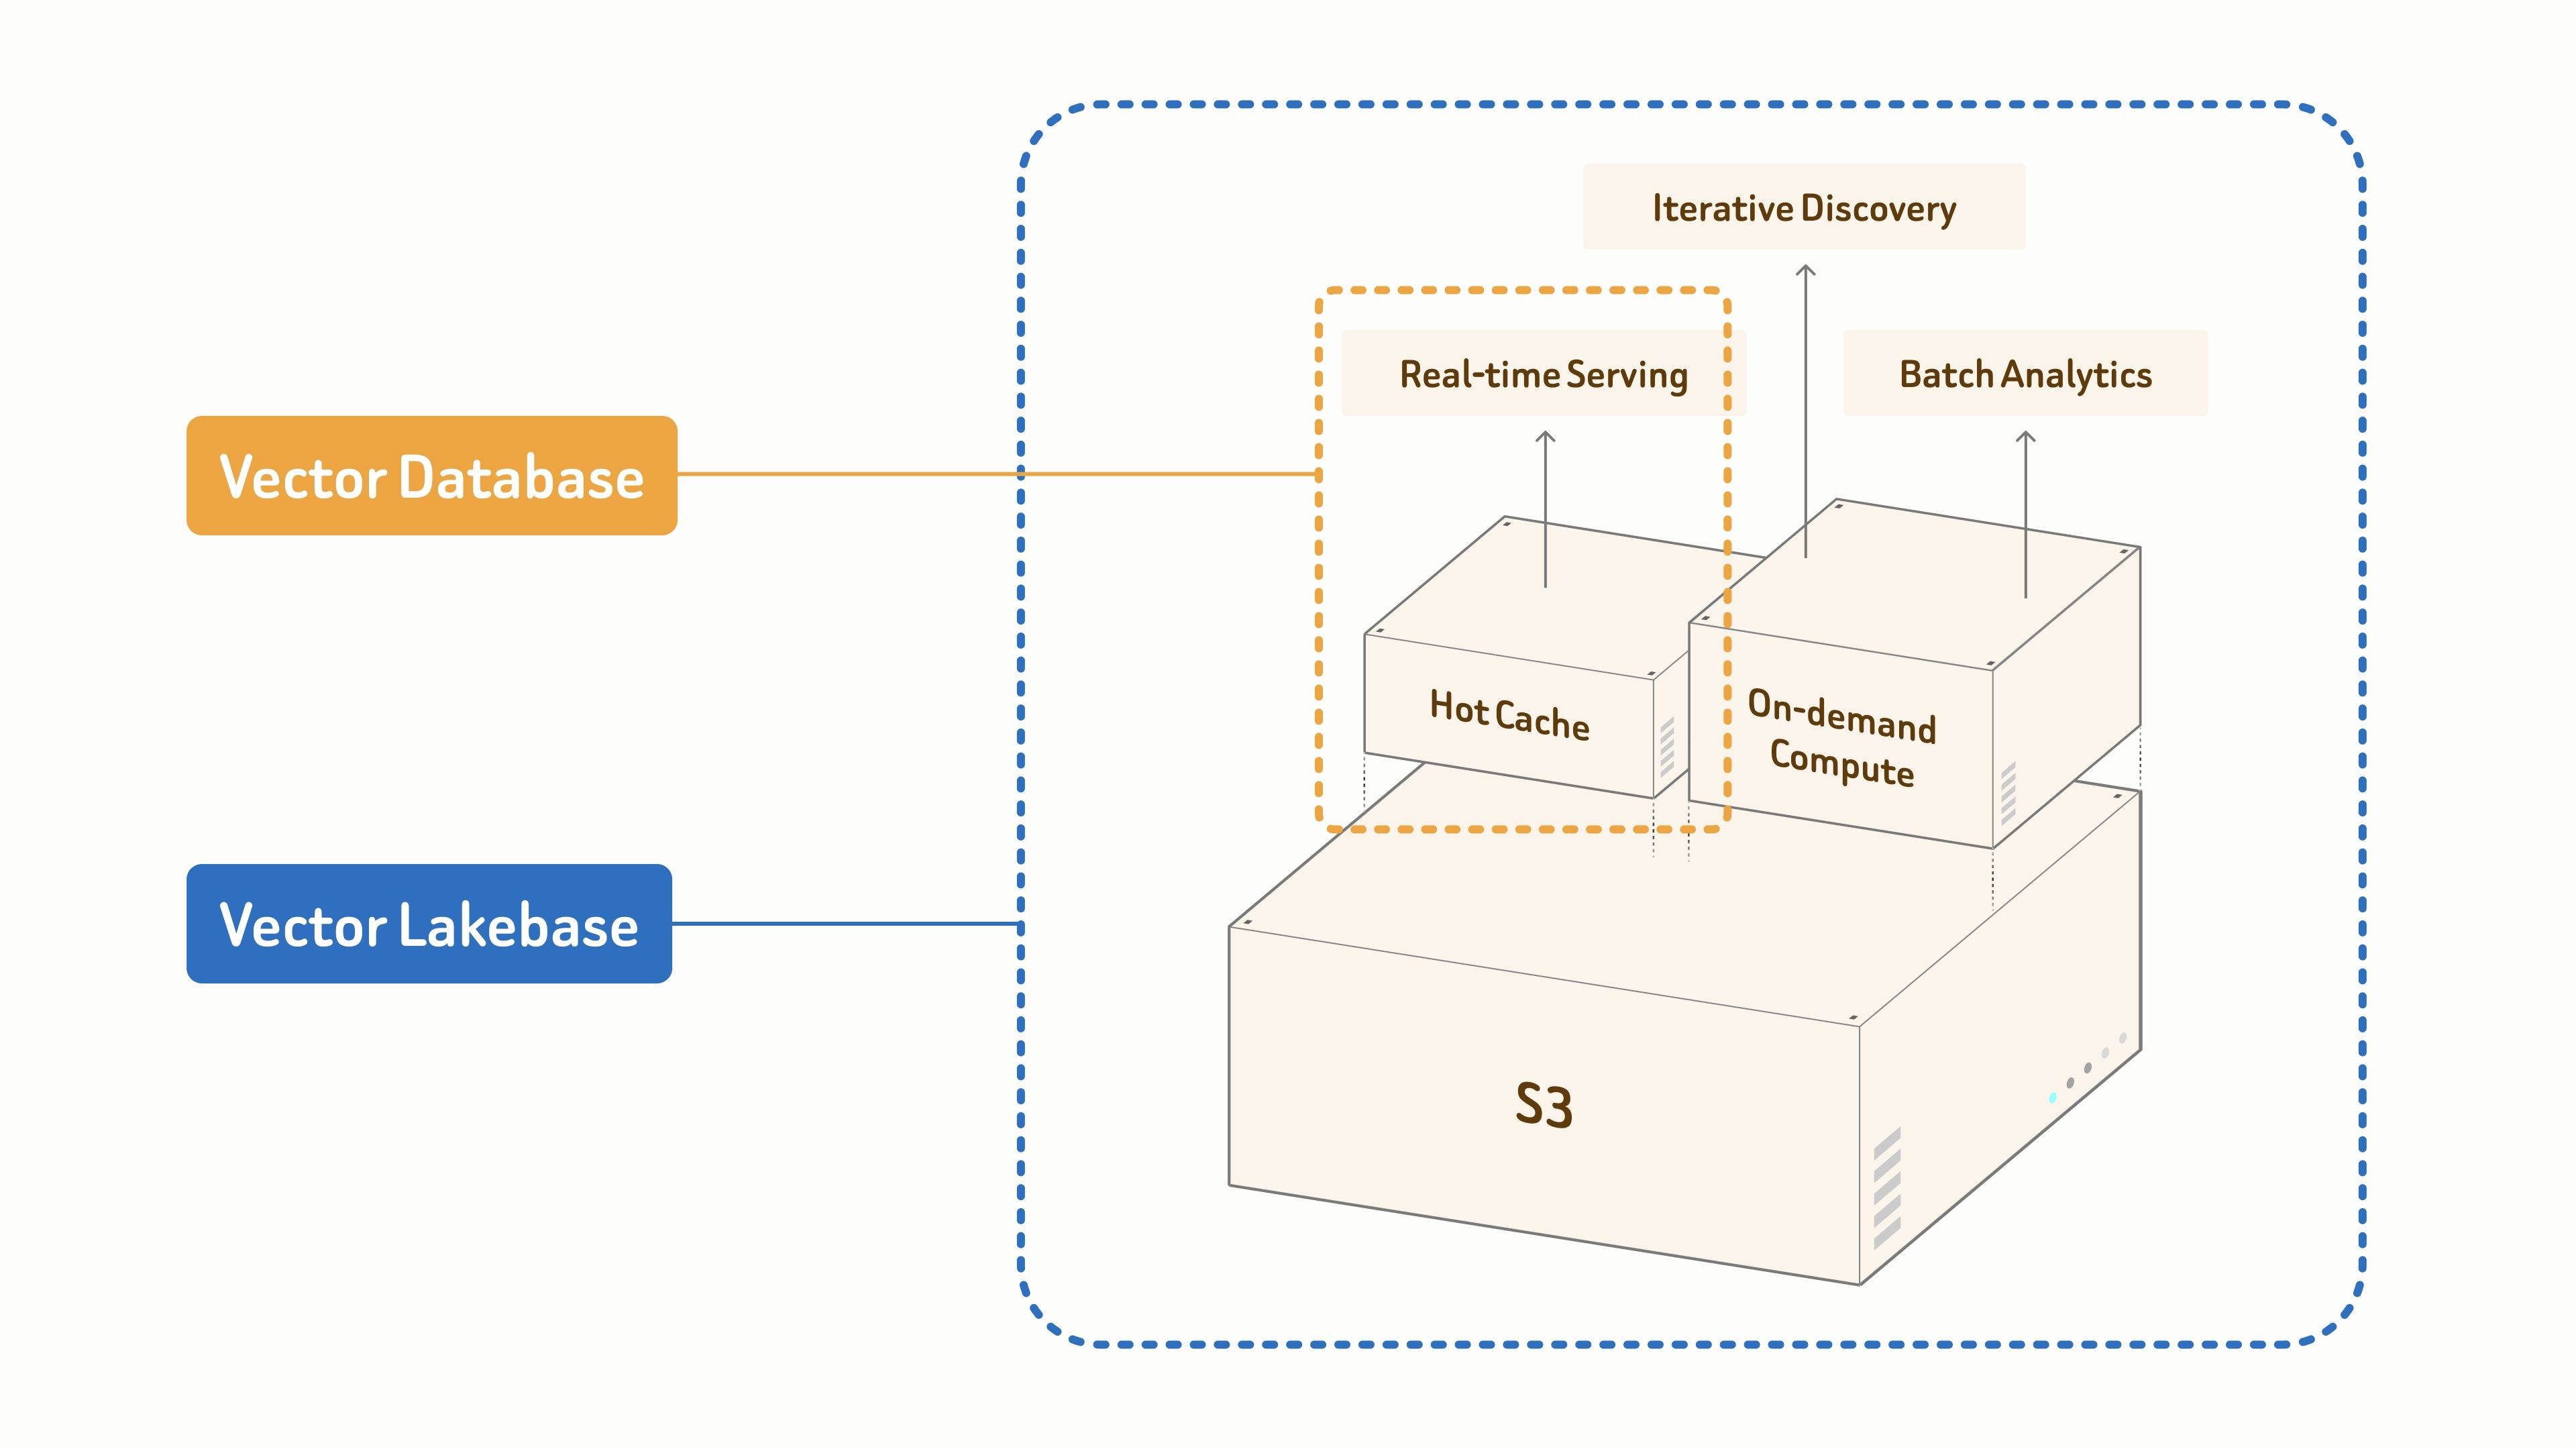
From Vector Database to Vector Lakebase
Zilliz offers a fully managed Vector Lakebase powered by Milvus, unifying real-time vector search, lake-scale discovery, and Al data operations.
Zilliz Cloud Now Available in Azure North Europe: Bringing AI-Powered Vector Search Closer to European Customers
The addition of the Azure North Europe (Ireland) region further expands our global footprint to better serve our European customers.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.