




Укрощение категориальных данных высокой кардинальности в агентной генерации SQL с помощью VectorDBs
Агентные рабочие процессы и большие языковые модели (LLMs) фундаментально изменили наш подход к системам text-to-SQL и позволяют пользователям запрашивать базы данных с помощью естественного языка как никогда раньше. По мере развития этих систем мы сталкиваемся с различными новыми вызовами при переводе человеческого намерения в точные SQL-запросы.
Одна из значительных проблем — обработка высококардинальных категориальных данных. В этой статье рассматривается, как интеграция векторных баз данных с агентными системами text-to-SQL может решить эту задачу. В частности, мы покажем, как сочетание Waii и Zilliz Cloud (полностью управляемой векторной базы данных Milvus) автоматически справляется с этой проблемой.
Проблема высококардинальных категориальных данных
Категориальные данные повсеместно встречаются в базах данных — представьте категории товаров, сегменты клиентов или типы транзакций. Во многих случаях количество уникальных значений (кардинальность) в этих категориях является управляемым. Например, столбец для штатов США будет иметь максимум 50 уникальных значений (плюс территории). Эти низкокардинальные столбцы относительно легко обрабатывать системам text-to-SQL, поскольку разрыв между запросами на естественном языке и значениями в базе данных невелик.
Проблема возникает, когда мы сталкиваемся с высококардинальными категориальными данными. Более чем в 60% баз данных, с которыми мы работали, есть примеры такой ситуации: представьте каталог товаров с миллионами уникальных идентификаторов товаров или финансовую базу данных с сотнями тысяч идентификаторов компаний.
Базам данных требуются точные, строгие поиски по этим категориям, но запросы на естественном языке часто бывают гибкими и неточными. Пользователь может попросить «популярные смартфоны» или «технологические компании, которые недавно хорошо показали себя», но перевод этих расплывчатых терминов в конкретные значения базы данных — именно та область, где традиционные подходы text-to-SQL оказываются недостаточными, оставляя огромное количество данных недоступным.
Почему существующие методы не работают
Часто системы text-to-SQL используют один из следующих двух методов при переводе запросов на естественном языке, включающих высококардинальные категориальные данные:
Методы предварительной обработки базы данных: Этот подход опирается на возможности традиционных баз данных, такие как текстовый поиск и регулярные выражения, в сочетании с предварительной обработкой ввода. Хотя он может обрабатывать простые совпадения, он часто слишком негибок, чтобы точно отразить намерение пользователя, особенно в сложных или нюансированных запросах. Жесткая природа этих методов с трудом преодолевает разрыв между вариативностью естественного языка и точными значениями базы данных.
Перевод на основе LLM: В этом методе система использует LLM для предсказания правильных категориальных значений на основе обучающих данных или примеров few-shot. Хотя LLM превосходно понимают контекст и естественный язык, они часто выдают неверные результаты при работе с высококардинальными данными. Это связано с тем, что LLM не обладает знанием полного (и часто частного) набора данных и испытывает трудности с точным воспроизведением миллионов уникальных идентификаторов, которые не были частью ее обучающих данных.
Для высококардинальных данных оба метода оказываются недостаточными. Методы предварительной обработки базы данных слишком негибки и буквальны, чтобы эффективно обрабатывать нюансы запросов на естественном языке. LLM, с другой стороны, могут понимать намерение запроса, но не способны надежно сопоставить его с правильными значениями в большом, специфическом наборе данных, на котором они не обучались. Это оставляет значительный пробел в переводе запросов на естественном языке в точные SQL-запросы для высококардинальных категориальных данных.
На сцену выходят векторные базы данных
Именно здесь в игру вступают векторные базы данных. Современный информационный поиск использует векторные эмбеддинги для выполнения семантического поиска, а не сопоставления по ключевым словам. Векторные базы данных предназначены для хранения и эффективного выполнения запросов к высокоразмерным векторным представлениям данных. В нашем контексте мы можем использовать их, чтобы связать запросы на естественном языке и категориальные данные с высокой кардинальностью.
Вот как это работает:
Создание векторных эмбеддингов: Создайте векторный эмбеддинг для каждого уникального значения в вашем столбце с высокой кардинальностью. Этот эмбеддинг отражает семантическое значение величины, отображая его в вектор в высокоразмерном пространстве.
Индексация в VectorDB: Сохраните эти эмбеддинги в векторной базе данных, такой как Milvus, которая оптимизирована для быстрого поиска по сходству в высокоразмерных пространствах.
Обработка запросов: Когда пользователь отправляет запрос на естественном языке, используйте LLM, чтобы понять намерение и сгенерировать предварительный SQL-запрос. Для столбцов с высокой кардинальностью вместо попытки сгенерировать конкретные значения LLM генерирует описание или характеристики желаемых значений.
Векторный поиск: Используйте эмбеддинг этого описания, чтобы выполнить поиск по сходству для эмбеддинга огромного количества уникальных значений в векторной базе данных, извлекая наиболее релевантные категориальные значения.
Уточнение: Затем LLM может уточнить эти результаты, отфильтровав любые нерелевантные совпадения на основе полного контекста пользовательского запроса.
Генерация SQL: Сгенерируйте финальный SQL-запрос, используя уточненный список категориальных значений для построения соответствующих фильтров и агрегатов.
Преимущества использования векторного поиска в Text-to-SQL
Этот подход, усиленный vectorDB, предлагает несколько преимуществ:
Масштабируемость: Он может обрабатывать категории с миллионами уникальных значений без существенного снижения производительности.
Точность: Объединяя семантическое понимание LLM с точным извлечением векторных баз данных, мы можем более точно преобразовывать намерение пользователя в конкретные значения базы данных.
Гибкость: Этот метод может адаптироваться к изменениям в базе данных без необходимости переобучения всей системы.
Вопросы реализации
Естественно, возможно построить потоки, необходимые для реализации описанного подхода, с нуля, но мы считаем, что сочетание Waii и Zilliz Cloud дает значительные преимущества.
Waii — это первый в мире text-to-SQL API, построенный на агентных рабочих процессах. Он сочетает технологию компиляторов с автоматически сгенерированным графом знаний для максимально точной генерации запросов.
Дополняя возможности Waii, Zilliz Cloud является векторной базой данных, лежащей в основе AI-процессов. Ее способность масштабироваться и выдавать точные результаты с низкой задержкой делает ее естественным выбором в AI-стеке.
Это сочетание дает вам масштабируемое решение из коробки:
Waii для интеллектуального Text-to-SQL
Автоматическое обнаружение: Waii автоматически определяет эти столбцы с высокой кардинальностью, устраняя необходимость в ручной настройке.
Умная генерация эмбеддингов: Он использует специализированные рабочие процессы для создания и обновления эмбеддингов для различных типов столбцов, оптимизируя как точность, так и эффективность использования ресурсов.
Адаптивные техники: Waii автоматически выбирает подходящие техники для различных типов столбцов, обеспечивая оптимальную производительность без необходимости глубоких экспертных знаний со стороны пользователя.
Zilliz Cloud для векторного семантического поиска
Масштабируемость: Zilliz Cloud может легко обрабатывать миллиарды векторов, что делает его идеальным для сценариев с данными высокой кардинальности.
Молниеносно быстрые запросы: Оптимизированное индексирование обеспечивает быстрый поиск по сходству, что критически важно для поддержания низкой задержки в производственных средах.
Безопасность и контроль доступа: Zilliz Cloud обеспечивает корпоративный уровень безопасности данных и соответствия требованиям конфиденциальности благодаря защищенным сетевым опциям и протоколам шифрования. Это обеспечивает безопасность данных как при передаче, так и в состоянии покоя. Кроме того, Zilliz Cloud предлагает продвинутый контроль идентификации и управление доступом, включая контроль доступа на основе ролей (RBAC) и OAuth 2.0 для безопасных централизованных возможностей единого входа (SSO).
Интеграция Waii и Zilliz Cloud
Бесшовный рабочий процесс: Сочетание автоматической предварительной обработки Waii и мощного векторного хранилища Zilliz создает плавное комплексное решение для обработки данных с высокой кардинальностью в системах text-to-SQL.
Готовность к продакшену: Эта связка разработана для реальных крупномасштабных задач, что делает ее подходящей для производственных развертываний в различных отраслях.
Используя автоматическое обнаружение Waii и генерацию эмбеддингов с Zilliz, вы можете реализовать надежное решение для обработки категориальных данных с высокой кардинальностью в вашей системе text-to-SQL без написания пользовательского кода для управления метаданными или генерации эмбеддингов.
Практический пример
Рассмотрим глобальную платформу управления мероприятиями с миллионами событий. Схема базы данных включает:
CREATE TABLE events (
    event_id INT PRIMARY KEY,
    event_name VARCHAR(255),
    event_date DATE,
    category VARCHAR(100),
    total_spent DECIMAL(10, 2)
);
event_name — это категориальный столбец с высокой кардинальностью, содержащий миллионы уникальных, описательных названий, таких как "Global AI Ethics Summit 2024", "Sustainable Living Expo: Greening Our Future" или "5th Annual Quantum Computing Breakthrough Conference".
Аналитик может спросить: "Сколько денег было потрачено на мероприятия по ИИ в прошлом месяце?"
Вот как разные подходы могут обработать это:
Традиционное сопоставление ключевых слов
В этом подходе мы используем термин, предоставленный пользователем, и подставляем его в запрос как поисковый термин. Здесь мы используем полнотекстовый поиск без учета регистра, но генерация фильтров равенства также распространена в этом сценарии.
SELECT SUM(total_spent)
FROM events
WHERE event_name ILIKE '%AI%'
  AND event_date >=
 DATE_TRUNC('month', CURRENT_DATE - INTERVAL '1 month')
  AND event_date <
 DATE_TRUNC('month', CURRENT_DATE);
Проблема: Этот подход пропускает события вроде "Machine Learning Symposium" или "Neural Network Workshop", которые связаны с ИИ, но не содержат "AI" в названии. Он также может ошибочно включать мероприятия вроде "HAIR styling convention".
Наивный подход с LLM
В этом подходе LLM генерирует несколько терминов, которые могут быть релевантны для поиска, и строит на их основе фильтр. При необходимости это можно делать с использованием примерных значений из столбца и дополнительного контекста о базе данных. Обычно это дает что-то вроде:
SELECT SUM(total_spent)
FROM events
WHERE (event_name ILIKE '%AI%'
       OR event_name ILIKE '%Artificial Intelligence%'
       OR event_name ILIKE '%Machine Learning%'
       OR event_name ILIKE '%Neural Network%')
  AND event_date >=
DATE_TRUNC('month', CURRENT_DATE - INTERVAL '1 month')
  AND event_date <
DATE_TRUNC('month', CURRENT_DATE);
Проблема: Хотя это охватывает больше событий, связанных с ИИ, подход по-прежнему ограничен заранее заданным списком терминов и может пропустить события с более специфическими или новыми названиями, связанными с ИИ. Проблема нахождения нерелевантных событий также сохраняется.
Подход с векторной БД + LLM
Следующая диаграмма показывает общий поток. Левая сторона — это предварительная обработка, выполняемая для таблицы events, правая сторона показывает поток генерации запроса.
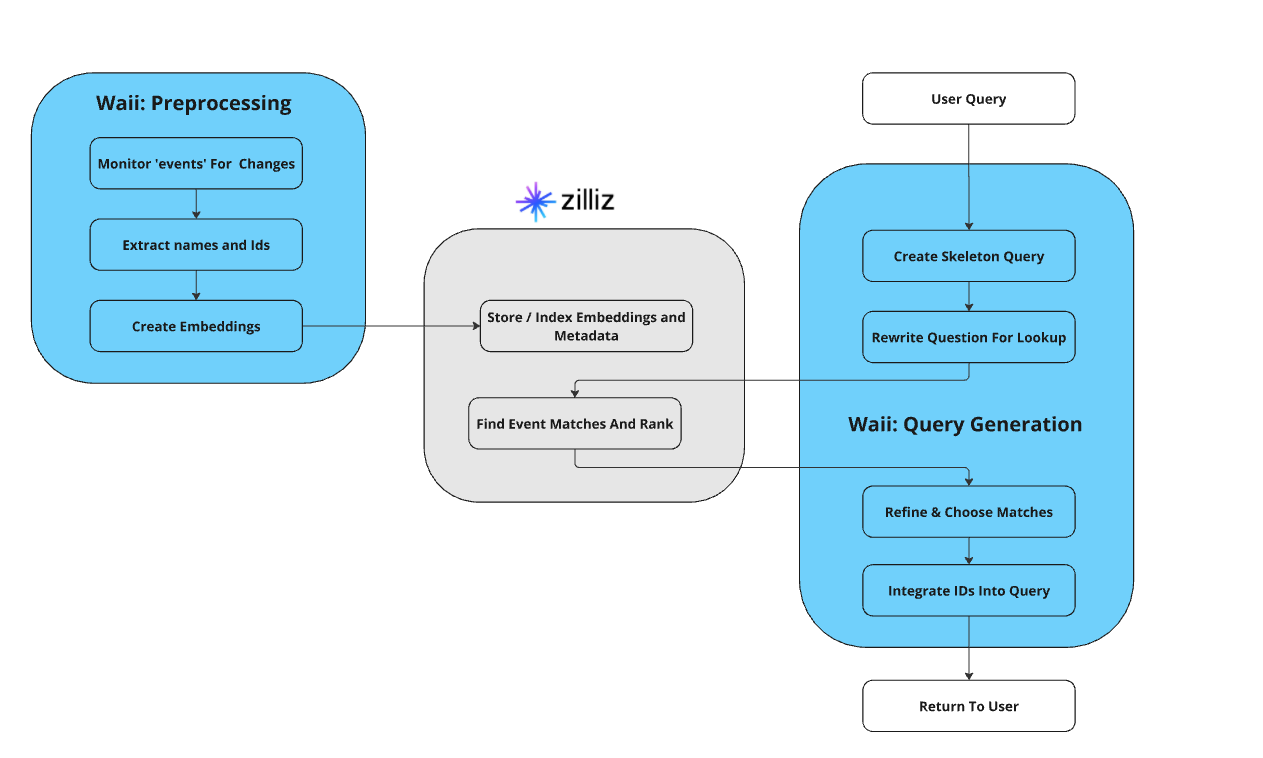 Рисунок — Как работает интеграция Zilliz Cloud и Waii
Поток генерации запроса выглядит так:
Waii интерпретирует запрос и переписывает описание: "События, связанные с искусственным интеллектом, машинным обучением, нейронными сетями и другими AI-технологиями."
Это описание используется для запроса к Zilliz Cloud, который возвращает список релевантных идентификаторов событий на основе семантического сходства.
Waii уточняет этот список, отфильтровывая любые события, не относящиеся к AI, которые могли быть случайно включены.
Waii использует агентный рабочий процесс, который включает эти идентификаторы событий в итоговый SQL-запрос:
SELECT SUM(total_spent)
FROM events
WHERE event_id IN (1234, 5678, 9101, 1121, 3141, 5161, 7181, 9202, 1222, 3242)
AND event_date >=
DATE_TRUNC('month', CURRENT_DATE - INTERVAL '1 month')
AND event_date <
DATE_TRUNC('month', CURRENT_DATE);
Этот подход может точно определять события, связанные с AI, даже если в них используется специализированная терминология или они не содержат очевидных ключевых слов. Он может охватывать такие события, как "3-й симпозиум по генеративно-состязательным сетям" или "Воркшоп по этическим аспектам обучения с подкреплением", которые другие подходы могли бы пропустить.
Используя поиск по векторному сходству, мы можем более точно интерпретировать намерение пользователя и сопоставлять его с названиями событий с высокой кардинальностью в нашей базе данных, обеспечивая более полные и точные результаты.
Заключение
Поскольку объемы данных продолжают расти, а ожидания пользователей в отношении интуитивного взаимодействия с данными повышаются, обработка категориальных данных с высокой кардинальностью в системах text-to-SQL будет становиться все более распространенной. Используя возможности Zilliz Cloud совместно с Waii, мы можем создавать более надежные, масштабируемые и точные системы.
Мы получили многообещающие результаты с этим подходом и считаем, что он будет полезен другим, кто сталкивается с похожими задачами. Пожалуйста, свяжитесь с нами и расскажите, пробовали ли вы этот или похожие подходы, а также поделитесь своими выводами.
 Jiang Chen
Jiang is currently Director of Technical GTM at Zilliz. He has years of experience in data infrastructures and cloud security. Before joining Zilliz, he had previously served as a tech lead and product manager at Google, where he led the development of web-scale semantic understanding and search indexing that powers innovative search products such as short video search. He has extensive industry experience handling massive unstructured data and multimedia content retrieval. He has also worked on cloud authorization systems and research on data privacy technologies. Jiang holds a Master's degree in Computer Science from the University of Michigan.
 Gunther Hagleitner
 is the current CEO and co-founder of Waii. He is a seasoned product and engineering leader with a 20+ year track record in SQL and analytics. Previously, as SVP at Cribl and CVP at Cloudera, he focused on simplifying data through innovation and open-source. Gunther excels at both scaling products and teams as well as new product introductions. He is passionate about creating user-centric solutions that solve real-world problems.
Читать далее
Why We Built Vector Lakebase: Rethinking Unstructured Data Architecture for AI
Vector Lakebase: a unified, lake-native data foundation for AI workloads — and an answer to what happens after vector databases succeed.
Vector Lakebase: End the AI Data Silo
Learn how Vector Lakebase unifies vector search, data lakes, and AI data operations so teams can serve RAG and agents without copy-and-sync pipelines.
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.