




フィードフォワードニューラルネットワーク(FNN)の理解:構造、利点、実世界での応用
要約:
フィードフォワードニューラルネットワーク(FNN)は、情報が入力層から隠れ層を通って出力層へと単一方向に流れ、ループやフィードバックを持たない人工ニューラルネットワークの一種です。この単純な構造は、画像や音声の分類のようなパターン認識タスクでよく使用されます。フィルターを使って空間的特徴を捉え、画像などの格子状データの処理に特化した畳み込みニューラルネットワーク(CNN)と比べると、FNNは空間的関係をそれほど効果的には扱えません。テキストや時系列のようなシーケンスデータを管理するためにフィードバックループを含むリカレントニューラルネットワーク(RNN)とは異なり、FNNには記憶がないため、静的データにより適しています。
フィードフォワードニューラルネットワーク(FNN)の理解:構造、利点、実世界での応用
画像認識ソフトウェアがどのように犬と猫を見分けているのか、不思議に思ったことはありませんか?あるいは、自動運転車は環境に基づいて何をすべきかをどのように判断しているのでしょうか?人工知能(AI)、特にフィードフォワードニューラルネットワーク(FNN)が、これらの画期的な成果を支えるエンジンです。現在私たちが使っている多くのAIアプリは、これらのネットワークを基盤として構築されています。
ここでは、フィードフォワードニューラルネットワークの構造、仕組み、利点と課題、そして幅広い応用について明らかにします。
フィードフォワードニューラルネットワーク(FNN)とは?
フィードフォワードニューラルネットワーク(FNN)は、情報が入力層から始まり、隠れ層を通過し、出力層で終わる単一の経路を流れるニューラルネットワークの一種です。データは前方向にのみ移動するため、FNNはカテゴリの識別(分類)や値の予測(回帰)など、各入力を個別に扱うタスクに適しています。
たとえば、銀行が使用する信用スコアリングシステムでは、FNNは収入、信用履歴、支出習慣などのユーザーの財務プロフィールを分析し、その信用力を判断できます。各情報はネットワークの層を通って流れ、そこでさまざまな計算が行われて最終的なスコアが生成されます。他のネットワークタイプとは異なり、FNNは以前の入力からの情報を保持しないため、各判断を独立して行えるシナリオに最適です。
フィードフォワードニューラルネットワークのアーキテクチャと層
フィードフォワードニューラルネットワークは、データが各層を順番に流れる、構造化された層状設計に依存しています。
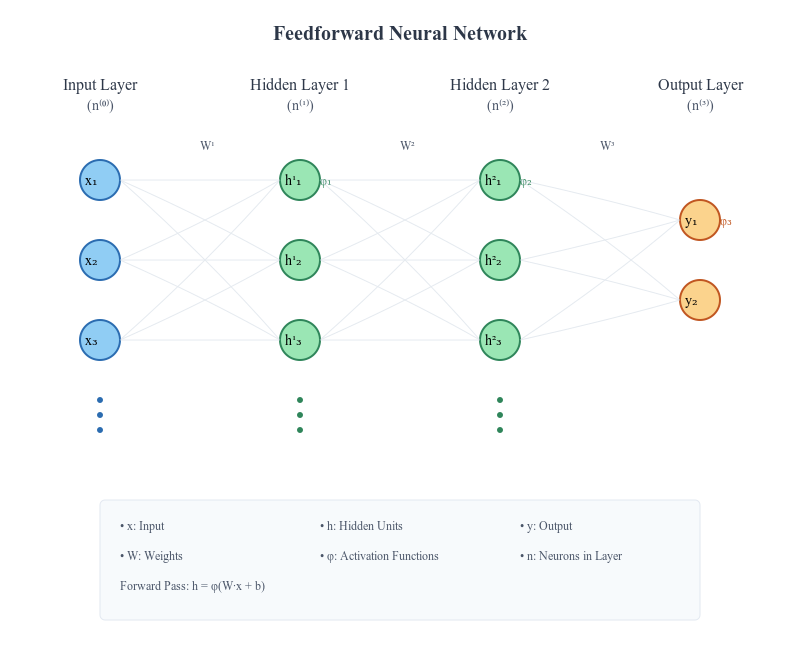 Figure 1- Feedforward Neural Network Architecture.png
図1:フィードフォワードニューラルネットワークのアーキテクチャ
入力層: データは入力層でネットワークに入ります。ここにある各ニューロンは、データの1つの特徴を表します。たとえば、入力が28x28のグレースケール画像である場合、この層には784個のニューロン(各ピクセルに1つ)が含まれます。
隠れ層: 隠れ層は入力層と出力層の間に位置し、ニューロンの密なネットワークを通じてデータを変換します。前後の層にあるニューロンは、各隠れ層ニューロンに接続されています。この場合、各ニューロンは入力の重み付き和を計算し、バイアスを加えた後に活性化関数を適用します。ネットワークがパターンを識別できるように、ニューロンはデータからより抽象的な要素を段階的に抽出します。
出力層: 出力層は最終結果を生成します。分類タスクでは、各ニューロンが潜在的なクラスを表し、それぞれに対する確率スコアを出力します。回帰タスクでは、温度や株価などの連続値を予測する場合があります。
ネットワークを通るデータの流れ
FNN内のデータは、入力層から始まり、隠れ層を通過して出力層に到達する体系的な経路をたどります。入力データは、入力層の各ニューロンによって部分的に処理された後、隠れ層を通過します。ニューロンは、重み、バイアス、活性化関数を使用して計算を行い、情報を洗練します。データが出力層に到達する頃には、ネットワークは予測または分類を生成しています。
たとえば、画像認識タスクでは、入力層のニューロンが画像のピクセルデータを処理する場合があります。その後、隠れ層が形状やテクスチャなどの特徴を識別し、最終的に出力層が「cat」や「dog」などの各カテゴリに確率を割り当てます。この明確な段階的フローにより、FNNは過去の入力を記憶することなくデータを処理できます。
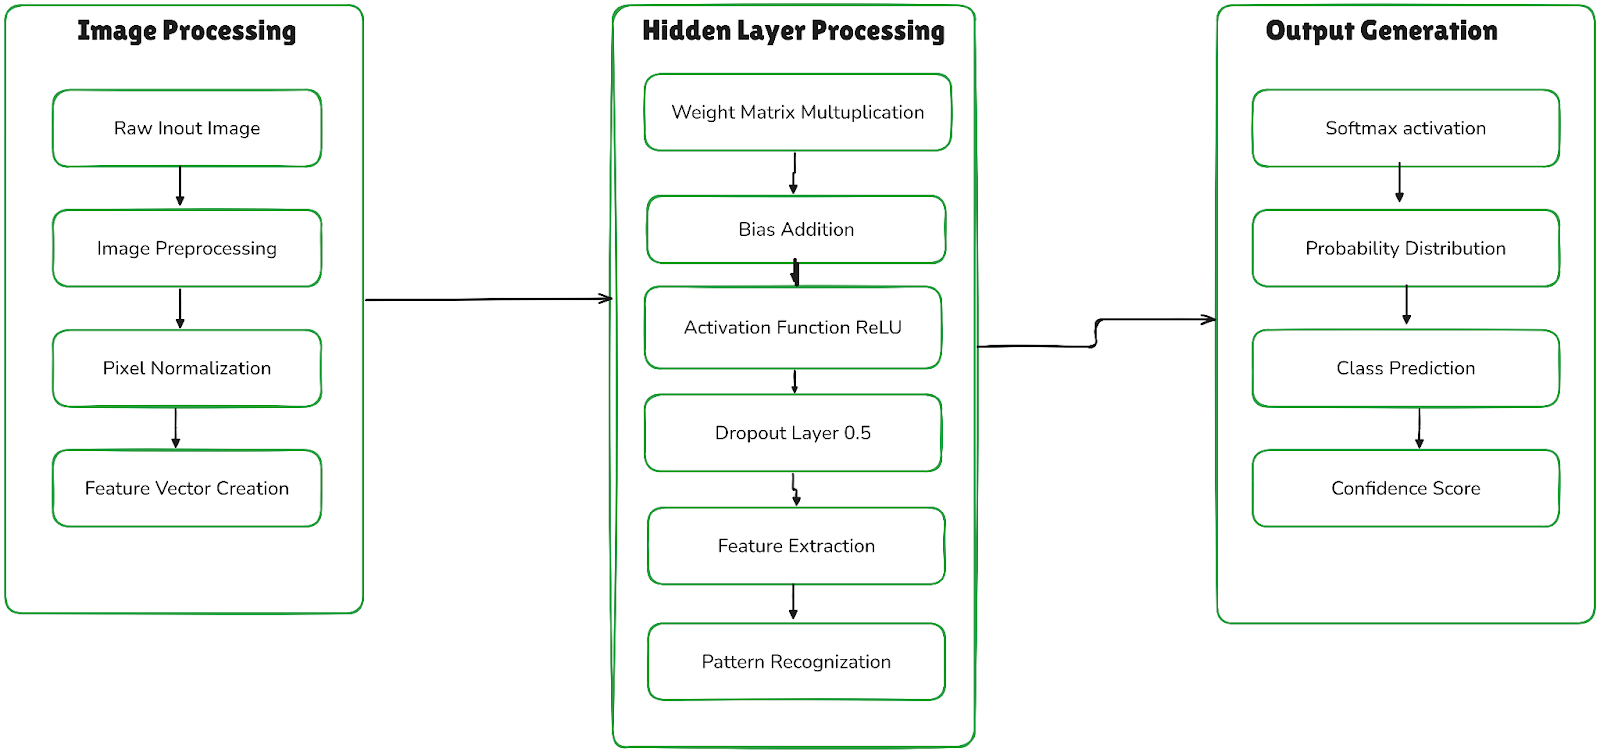 Figure 2- Data Flow and Processing in Neural Networks.png
図2:ニューラルネットワークにおけるデータフローと処理
フィードフォワードニューラルネットワークの主要概念
FNNがどのように機能するかを理解するために、学習と予測を可能にする主要なコンポーネントを見てみましょう。
ニューロン:計算の中核単位
ニューロンは、ニューラルネットワークの基本的な構成要素です。上位の層から入力を受け取った後、各ニューロンは重み付けされた合計を計算し、バイアスを適用します(重みとバイアスについては後ほど説明します)。その後、ネットワークは、非線形性を加える活性化関数を適用することで、より複雑なパターンを識別できるようになります。ニューロンは複数の層にわたって接続されるにつれて、入力内の関係性に対する理解を徐々に向上させ、ネットワークを最終的な出力へと導きます。
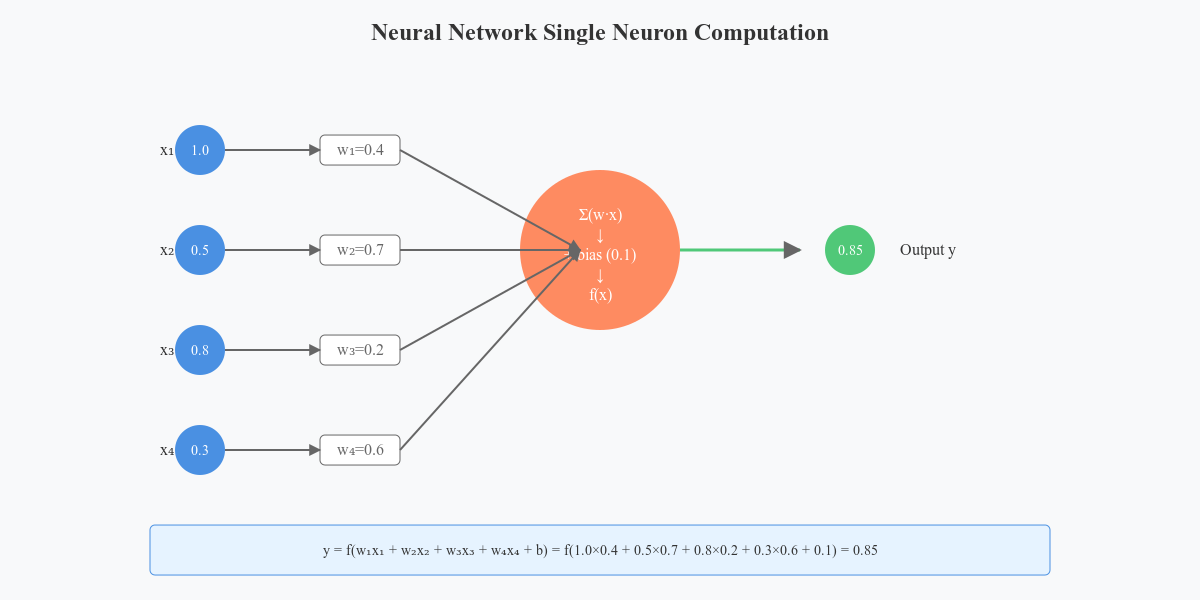 Figure 3- Neural Network Single Neuron Computation.png
図3:ニューラルネットワークにおける単一ニューロンの計算
重みとバイアス:学習のためのパラメータ
重みとバイアスは、ネットワークが学習に使用する中核的なパラメータです。
重み: 重みは、ニューロンに対する各入力の影響度や重要度を定義するネットワーク内のパラメータです。これらの値は、入力がニューロンの出力にどれだけ強く影響するかを決定します。 ネットワークは、予測出力と実際の結果との差を最小化するために、トレーニング中に重みを継続的に調整し、予測精度を高めます。
バイアス: バイアスは、入力の重み付き和に追加される追加パラメータであり、入力がゼロの場合でもニューロンが活性化できるようにします。この調整により、ネットワークはデータ内のより多くのパターンを捉えることができ、重みと同様に、バイアスもパフォーマンスを向上させるためにトレーニング中に微調整されます。
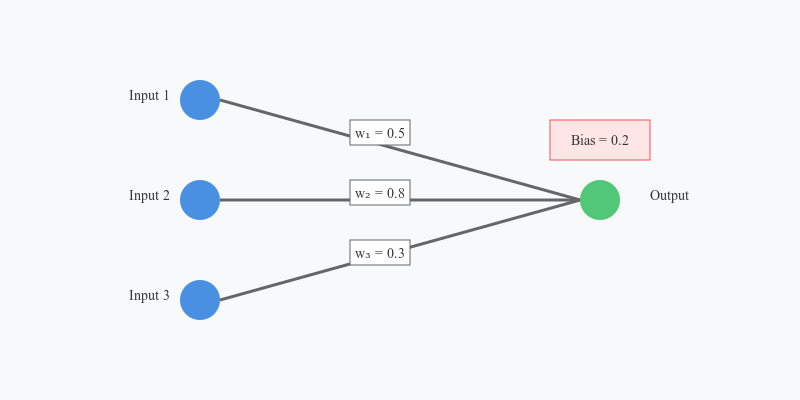 Figure 4 Weights and Biases- Parameters for Learning .png
図4 重みとバイアス:学習のためのパラメータ
活性化関数
活性化関数は、ネットワークに非線形性を導入するためにニューロンの出力に適用される数学関数です。活性化関数がなければ、FNNは線形関係しかモデル化できず、複雑なタスクに対する有用性が制限されます。
一般的な活性化関数には以下があります。
Sigmoid: 出力を0から1の間に圧縮します。確率のような出力を提供するため、二値分類によく使用されます。
ReLU (Rectified Linear Unit): 負の値に対してはゼロを出力し、正の値は変更せずに通過させることで、トレーニングを高速化し、勾配消失のリスクを低減します。
Tanh: 値を-1から1の間に写像し、出力を中心化します。勾配の流れを改善するために隠れ層でよく使用されます。
これらの関数により、FNNは非線形関係を捉えることができ、実世界のデータに対してより汎用的になります。
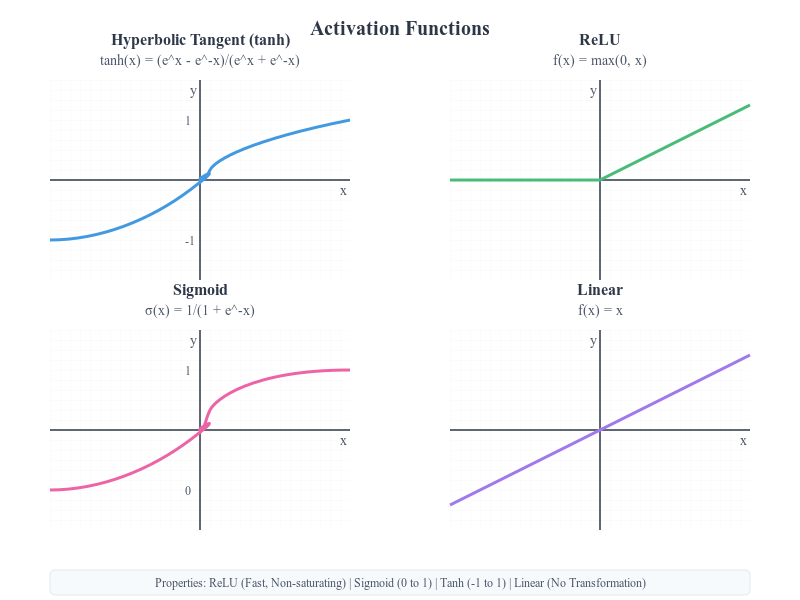 Figure 5 Activation Functions.png
図5 活性化関数
バックプロパゲーション:誤差修正による学習
バックプロパゲーションは、ニューラルネットワーク内の各接続が予測誤差にどれだけ寄与しているかを計算する学習アルゴリズムです。その後、これらの誤差を最小化し精度を向上させるために、ネットワークを逆方向にたどりながら、これらの接続(重みとバイアス)を体系的に調整します。バックプロパゲーションのプロセスにはいくつかの段階があります。
誤差を計算する: 出力層の予測後、ネットワークは予測出力と実際の値との差(誤差または損失として知られる)を計算します。分類タスクではクロスエントロピー損失が一般的に使用される一方、回帰タスクでは平均二乗誤差がよく使用されます。
誤差の逆伝播: 誤差はネットワークを通じて層ごとに逆方向へ伝播します。バックプロパゲーションは微積分の連鎖律を使用して、各重みとバイアスの誤差勾配を計算します。
重みとバイアスを修正する: 勾配は、誤差を減らすために重みとバイアスをどれだけ、どの方向に変更すべきかを示します。Adamや確率的勾配降下法(SGD)などの最適化手法が、誤差を最小化するためにこれらのパラメータを更新します。
収束するまで繰り返す: このプロセスは複数のエポックにわたって繰り返され、徐々に誤差を減らし、精度を向上させます。
バックプロパゲーションにより、ネットワークは誤りから学習し、各反復で予測を洗練させることができます。
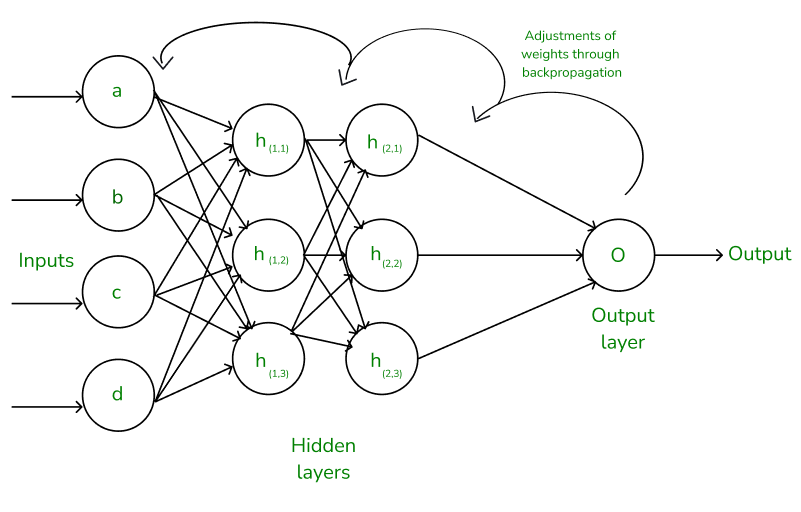 図6 ニューラルネットワークにおけるバックプロパゲーション.png
図6 ニューラルネットワークにおけるバックプロパゲーション](https://media.geeksforgeeks.org/wp-content/uploads/20240217152156/Frame-13.png)
他のニューラルネットワークとの比較
各タイプのニューラルネットワーク—フィードフォワード、リカレント、畳み込み—には、それぞれ独自の長所と短所があります。CNNやRNNは、FNNがあまり適していない特定の問題に対処するために作られていますが、FNNはAIタスクの出発点として頻繁に使用されます。
| 特徴 | フィードフォワードニューラルネットワーク(FNN) | リカレントニューラルネットワーク(RNN) | 畳み込みニューラルネットワーク(CNN) |
| データフロー | 入力から出力への一方向の流れ | 循環的で、データのフィードバックを可能にするループを含む | 主に一方向で、特殊な空間フィルターを持つ |
| 構造 | シンプルで、入力層、隠れ層、出力層が明確に分かれた階層構造 | 階層構造で、時間的依存関係とメモリセルを持つ | 空間データのために畳み込み層とプーリング層を使用 |
| ユースケース | 分類、回帰、単純な予測タスク | 時系列分析、自然言語処理(NLP) | 画像認識、物体検出、空間データ |
| メモリ | 過去の入力を記憶しない。各入力は独立している | 短期記憶により、以前の入力を保持できる | 明示的なメモリはない 層を通じて空間データを処理する。 |
| 複雑さ | 実装、解釈、学習が比較的容易 | シーケンス処理のため、より複雑 | 設計と計算要件における複雑さ |
| 制限事項 | 文脈理解が限定的で、メモリがない | 長いシーケンスでは勾配消失問題の影響を受けやすい | 非空間データやシーケンスベースのデータには効果的でない |
フィードフォワードニューラルネットワークの利点と課題
フィードフォワードニューラルネットワーク(FNN)には、特に複雑なデータ構造に依存せず、過去の入力を記憶しない単純なタスクにおいて、一定の利点があります。それでも、いくつかの制限があります。以下では、その両面を見ていきます。
利点
シンプルさ: FNNは、入力から出力へ一方向にデータを処理する、わかりやすい設計です。そのため、初心者でも理解しやすく適用しやすいです。ループやメモリコンポーネントがないため、各入力が独立して処理されるタスクに有効です。
効率性: 線形のデータフローにより、FNNは計算効率が高く、特にRNNのようなより複雑なネットワークと比べて効率的です。また、訓練が容易で使用するリソースも少ないため、リアルタイム活動やシステム容量が限られたシナリオにもより適しています。
汎用性: FNNは適応性が高く、分類、回帰、予測など、さまざまなタスクをサポートできます。金融、医療、小売業界で、多様なデータタイプを扱うために適用されています。たとえば、FNNは画像の分類、テキストの感情評価、信頼性の高い予測の作成によく使用されます。
課題
限定的な文脈理解: FNNは各入力を個別に処理するため、時系列分析や言語翻訳のように、以前の入力が出力に影響する、文脈や記憶に依存するタスクには適していません。
過学習のリスク: FNNは、特に訓練データが限られている場合、過学習する可能性があります。適切な正則化がないと、パターンを一般化するのではなく訓練データを記憶してしまい、新しいデータでの性能が低下する可能性があります。
記憶機構の欠如: RNNとは異なり、FNNは過去の入力を記憶できないため、以前の会話の文脈に基づいて応答するチャットボットのように、連続性を必要とするタスクには効果的ではありません。
Feedforward Neural Networksのユースケース
Feedforward Neural Networks(FNN)にはさまざまな用途があり、特に各データポイントを独立して扱うことができ、意思決定に文脈が必須ではないタスクで有用です。以下は最も一般的な応用例です。
画像分類
FNNは画像分類で広く使用されており、ネットワークが視覚データを処理して画像をあらかじめ定められたグループに分類します。たとえば、画像の特徴を用いて、FNNを車両、植物、犬、猫を区別するように訓練できます。Convolutional Neural Networks(CNN)は空間的な詳細を捉えるため、一般により複雑な画像タスクで好まれますが、FNNはより単純な画像分類や計算リソースが限られた状況では依然として有効です。
テキストの感情分析
FNNは感情分析のような 自然言語処理(NLP)タスクも処理できます。この場合、ネットワークは特定の単語や短いフレーズに基づいて、テキストを肯定的、否定的、または中立的にラベル付けするよう訓練されます。RNNやtransformersは単語の連なりを理解することにより優れていますが、長い文章ではなく個々の単語や短いテキスト断片に焦点を当てる場合、FNNは感情分析で十分に機能します。
不正検出
FNNは金融分野で、取引パターンを分析して不正行為を検出するために頻繁に使用されます。突然の支出の急増や予期しない場所で発生する取引など、通常とは異なるパターンを見つけることができます。構造化データを用いた分類と予測に優れているため、FNNは不正を迅速に検出し、リスクを管理するための効果的なツールです。
Feedforward Neural Networksに関するFAQ
- なぜFeedforward Neural Networksは特定のアプリケーションで効率的なのですか?
FNNの一方向のデータフローと単純な構造により、計算効率が高くなります。過去データの記憶を必要としないため、処理が簡素化され、リアルタイムアプリケーションやリソースが限られたシナリオで有用です。
- 隠れ層とは何で、FNNでどのような役割を果たしますか?
隠れ層は入力層と出力層の間に位置し、相互接続されたニューロンを通じてデータを変換します。これらの層は重み付き計算と活性化関数を適用し、データ内のパターンを段階的に識別します。
- FNNで活性化関数が使用されるのはなぜですか?
活性化関数は非線形性を導入し、FNNがデータ内の複雑な関係をモデル化できるようにします。一般的な関数にはReLU、Sigmoid、Tanhがあり、それぞれネットワーク内の異なる種類のタスクに適しています。
- どのようなシナリオではFNNが最適な選択ではない場合がありますか?
FNNは、言語翻訳や動画処理のように、記憶や逐次的な文脈を必要とするタスクには理想的ではない場合があります。過去の情報を保持しないためです。
- FNNは画像やテキストのような非構造化データをどのように扱いますか?
FNNは非構造化データを構造化されたベクトル形式に変換し、重要な特徴を捉えます。これらのベクトルは、分析、分類、または迅速な検索や比較のためのベクトルデータベース への保存に使用できます。
関連リソース