




Conditional Variational Autoencoders
特定のスタイルの猫の画像を作成するように、AI が条件に基づいて具体的でリアルな画像やデータをどのように生成できるのか、不思議に思ったことはありませんか?
変分オートエンコーダ(VAEs)は強力な生成モデルですが、データ属性を制御することはできません。条件付き変分オートエンコーダ(CVAEs)は、ラベルや属性などの条件をエンコーダとデコーダの両方に組み込むことで、この制限を克服します。これにより、CVAEs は特定の要件に合わせたデータを生成できるようになり、ターゲットを絞った画像作成やパーソナライズされたコンテンツ生成などのタスクに最適となり、さまざまな分野でその可能性を広げます。
条件付き変分オートエンコーダ(CVAEs)がどのように機能するのか、その利点、そしてさまざまな領域におけるデータ生成の方法をどのように変えるのかを見ていきましょう。
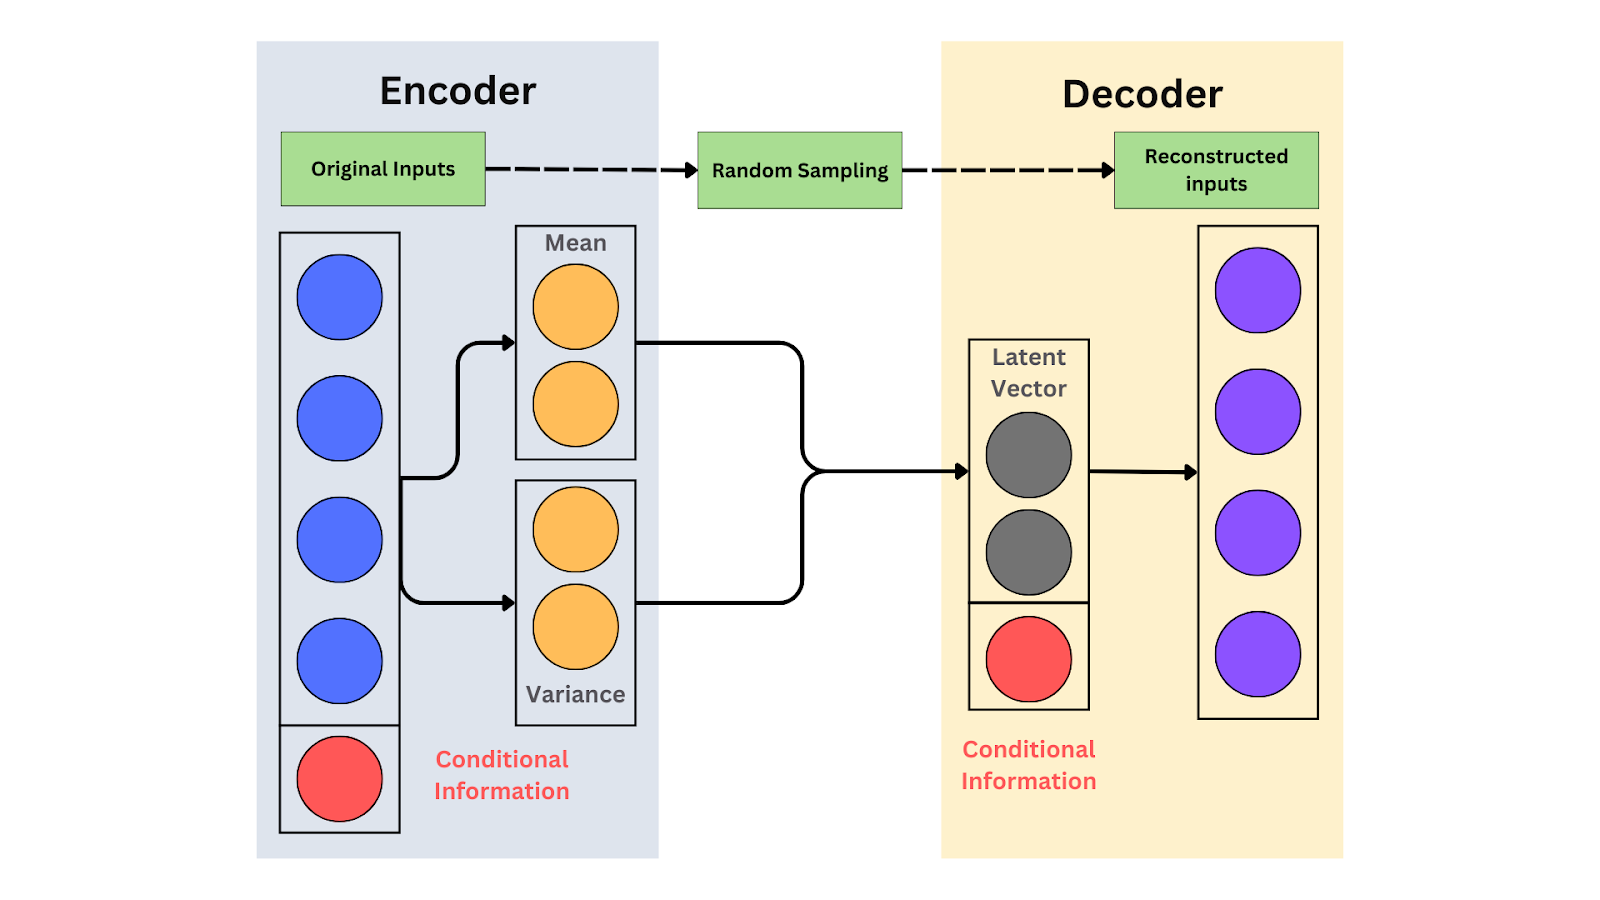 The schematic of a CVAE.png
CVAE の概略図
条件付き変分オートエンコーダ(CVAE)とは?
条件付き変分オートエンコーダ(CVAE)は、ラベルや属性などの条件入力を取り入れてデータ生成プロセスを導く、変分オートエンコーダ(VAE)の拡張です。モデルに条件を与えることで、生成されたデータは特定の要件を満たします。たとえば、猫や犬の画像を作成したい場合、生成を導くために「cat」または「dog」というラベルを提供できます。これにより、モデルは条件に基づいて望ましい出力を生成できます。
CVAEs が重要なのは、データ生成を制御できるためです。条件入力により、出力が事前定義された特徴と一致することが保証されます。これにより、モデルがさまざまな色やスタイルの衣服アイテムを作成できるファッションデザイン向けの画像生成や、特定の条件に基づいて特定のシナリオを生成する必要があるターゲット型シミュレーションなどのタスクに役立ちます。
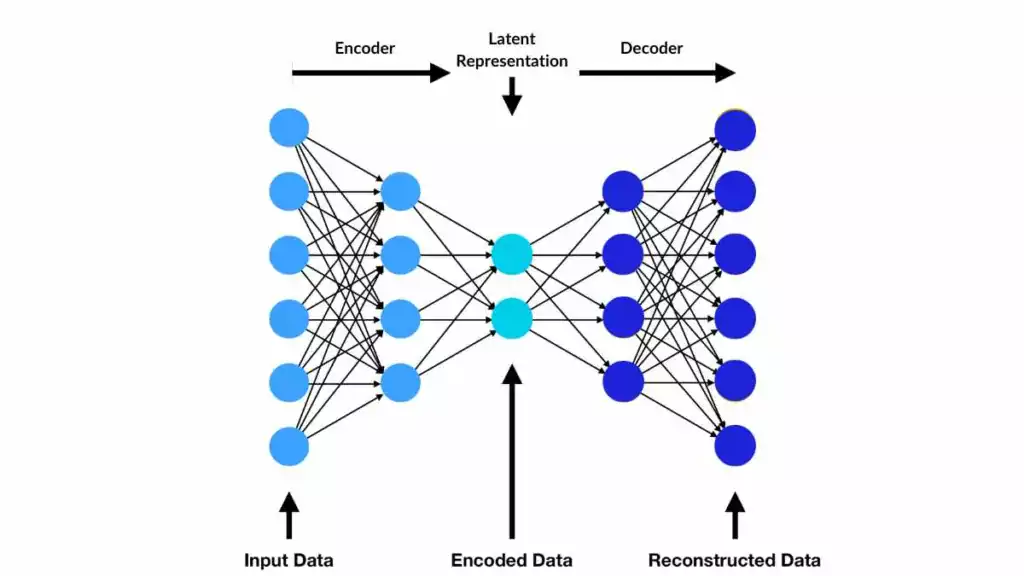 Autoencoder structure underlies VAEs and CVAEs.png
オートエンコーダ構造は VAEs と CVAEs の基盤です | 出典
変分オートエンコーダ(VAEs)の理解
CVAEs を詳しく掘り下げる前に、変分オートエンコーダ(VAEs)の概念について説明しましょう。VAEs は、新しいデータサンプルを生成するために、連続的な潜在空間で複雑なデータ分布を表現することを学習する生成モデルです。
VAEs には、エンコーダとデコーダという 2 つの主要なコンポーネントがあります。エンコーダは入力データを潜在空間に圧縮し、その重要な特徴を捉えます。デコーダはこの潜在表現から入力を再構成するか、新しいサンプルを生成します。損失関数は、再構成の精度と潜在空間の規則性のバランスを取ることで、学習において重要な役割を果たします。正則化により、潜在空間が滑らかで構造化され、一貫性のあるデータ生成が可能になります。
損失関数
変分オートエンコーダ(VAEs)の損失関数は、再構成損失と KL ダイバージェンスという 2 つの主要なコンポーネントで構成されます。
- 再構成損失は、モデルが入力データをどれだけうまく再現できるかを測定します。通常、平均二乗誤差(MSE)またはバイナリ交差エントロピーを使用して計算されます。再構成損失の式は次のとおりです。
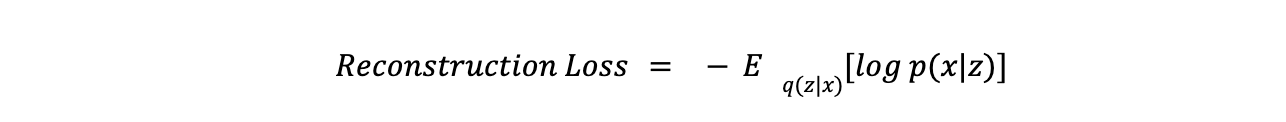
- KL ダイバージェンスは、Kullback-Leibler divergence の略で、ある確率分布がどの程度異なるかを示す統計的尺度です。VAEs の文脈では、潜在分布 𝒒(𝔃∣𝔁)(エンコーダによって学習される)が事前分布 𝒑(𝔃) に近い状態を保つことを保証します。これは通常、標準ガウス分布です。KL ダイバージェンスの式は次のとおりです。
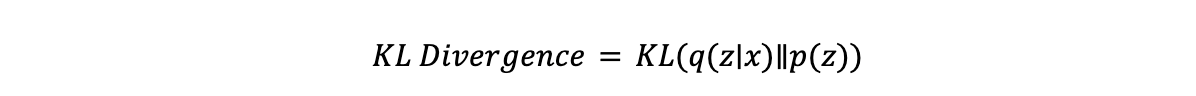
全体の損失関数は、これら 2 つの項の重み付き和です。
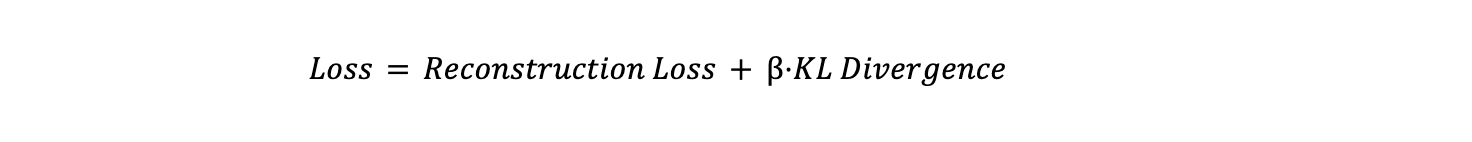
ここで β は、再構成損失と KL ダイバージェンスのトレードオフを制御するハイパーパラメータです。β が高いほど潜在空間の正則化がより重視され、一方で低い値ではモデルが正確な再構成により集中できます。このバランスは、モデルが正確なデータを生成すると同時に、意味のある、適切に振る舞う潜在空間を学習することを保証するうえで重要です。
正則化
正則化 は、Kullback-Leibler ダイバージェンスを使用して潜在空間を事前分布に合わせ、潜在変数がガウス分布に従うようにします。これにより潜在空間が滑らかになり、補間や意味のあるサンプリングが可能になります。潜在空間内で互いに近い点は、類似した出力を生成します。正則化はまた、モデルが訓練データに過学習するのを防ぐことで汎化性能を向上させます。たとえば、ファッションデザインでは、正則化により、現実的なパターンやスタイルを維持しながら多様な衣服デザインが生成されます。非現実的な出力を生成することなく、衣服の種類、色、質感にバリエーションを生み出すのに役立ちます。潜在空間を構造化された状態に保つことで、現在のトレンドに沿いながらもそれぞれ独自性のあるデザインを生成します。
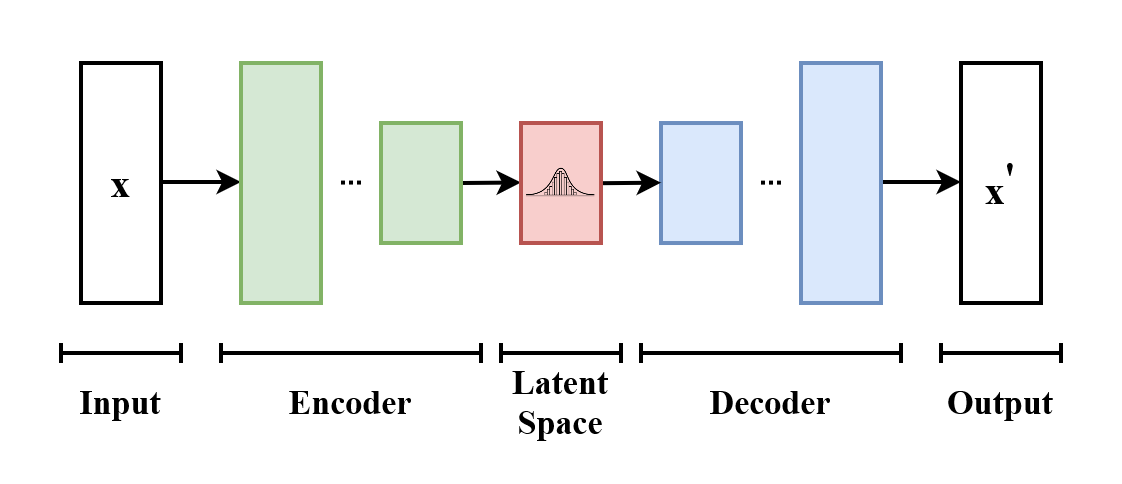 Structure of a Variational Autoencoder (VAE) |.png
Variational Autoencoder (VAE) の構造 | 出典

CVAE は条件付き入力によって VAE をどのように改善するのか?
CVAE は、クラスラベルなどの条件付き入力を追加してデータ生成を導くことで、VAE を拡張します。エンコーダは入力データと条件の両方を処理します。それらを結合した潜在空間にマッピングし、データと条件を組み合わせて捉えます。次にデコーダは、この潜在表現、すなわち圧縮されたデータ表現を条件とともに使用して、新しいサンプルを生成します。
たとえば、条件が「赤いスニーカー」の場合、デコーダは赤いスニーカーの画像を生成します。条件により、出力が特定の要件に一致することが保証されます。VAE と同様に、CVAE は KL ダイバージェンスを使用して潜在空間を正則化し、滑らかな分布を作成します。
VAE は入力データの変動のみに依存するため、出力の制御が制限されます。CVAE はラベルや属性を使用して生成プロセスを導きます。これにより、目的に応じた具体的な出力が可能になります。たとえば、MNIST で訓練された CVAE では、条件は「5」のような数字ラベルにできます。ラベルと入力が与えられると、モデルは特定の「5」を生成します。対照的に VAE は、潜在空間に応じて任意のランダムな数字を生成する可能性があります。
CVAE は、特定の特徴を持つ画像の生成やコンテンツのパーソナライズのようなタスクに最適です。たとえば、CVAE はユーザーの色、サイズ、スタイルの好みに基づいてスニーカーのデザインを生成でき、カスタマイズ性とユーザー体験を向上させます。
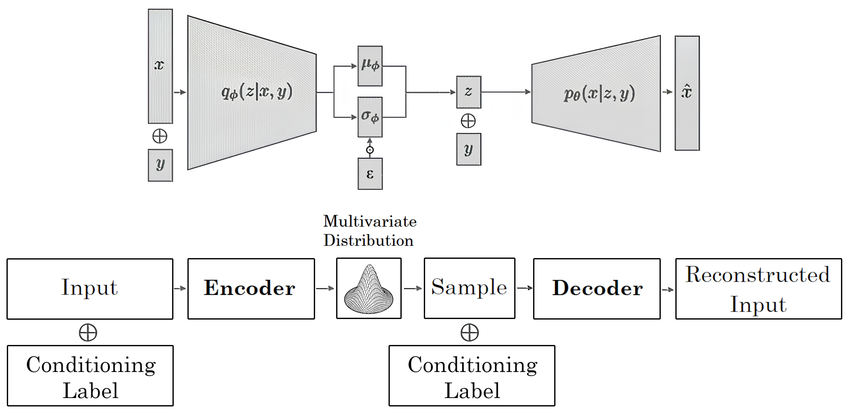 Conditional Variational Autoencoder (CVAE) Architecture.png
Conditional Variational Autoencoder (CVAE) アーキテクチャ | 出典
主要用語:
潜在空間: 潜在空間 は、データの高次元で圧縮された表現です。姿勢や色のような入力データの本質的な特徴を、コンパクトな形式で捉えます。たとえば、顔の画像は年齢や表情を表すベクトルに圧縮できます。この空間は通常、既知の分布(例: ガウス分布)に従うため、この分布からサンプリングすることで、新しい類似したデータ点を生成できます。この表現により、モデルはデータ点間を効果的に操作または補間できます。
エンコーダー: エンコーダーは入力データを確率的な潜在表現に変換します。入力 𝔁(画像など)を、潜在空間上の分布(平均 𝜇、分散 𝝈2)にマッピングします。たとえば、猫の画像の場合、エンコーダーは色や品種のような特徴の分布を出力します。この分布から潜在ベクトルがサンプリングされます。エンコーダーは、本質的な特徴を保持しながらデータを効率的に圧縮する方法を学習します。
デコーダー: デコーダーは潜在変数 𝔃 を受け取り、データを再構築または生成します。データの圧縮版である潜在ベクトルを、元のデータ空間にマッピングし直します。たとえば、デコーダーは猫の特徴を表す潜在ベクトルから猫の画像を生成します。この関数は 𝒑(𝔁∣𝔃) と表され、ここで 𝔁 は生成されたデータです。デコーダーは潜在変数から学習することで、未見のデータに対しても多様な出力を作成できます。
条件付き入力: 条件付き入力は、データ生成を導く追加情報(例:ラベル)を提供します。CVAEでは、「cat」のようなラベルが、猫の画像のような特定の出力を生成するのに役立ちます。エンコーダーとデコーダーはこれらの入力を使用して、制御された出力を作成します。たとえば、エンコーダーは 𝒒(𝔃∣𝔁,𝔂) となり、デコーダーは 𝒑(𝔁∣𝔃,𝔂) となります。これらの入力により、モデルは与えられた条件に合わせたデータを生成でき、柔軟性が向上します。
- KLダイバージェンス: KLダイバージェンスは、エンコーダーが学習した分布が事前分布(通常はガウス分布)とどれほど異なるかを測定します。これにより、エンコーダーは事前分布に近い潜在変数を生成するよう促され、構造化された潜在空間が確保されます。式は次のとおりです。
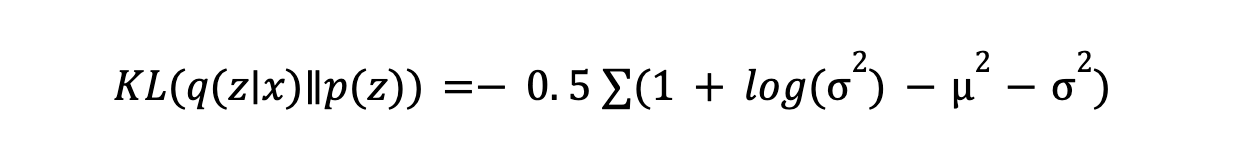
KLダイバージェンスを最小化することで、データ生成のために扱いやすい潜在空間を維持できます。この正則化手法により、潜在変数が、新しいデータ点のサンプリングと生成を信頼性高く行えるような形で分布することが保証されます。
CVAE vs. VAE vs. GAN
このセクションでは、変分オートエンコーダー(VAE)を条件付き変分オートエンコーダー(CVAE)および敵対的生成ネットワーク(GAN)と比較します。いずれも生成モデルですが、いくつかの重要な違いがあります。
次の表では、それらの仕組み、柔軟性、ユースケースの違いを示します。
| 側面 | VAE(変分オートエンコーダ) | CVAE(条件付き変分オートエンコーダ) | GANs(敵対的生成ネットワーク) |
| 中核メカニズム | 入力データを圧縮された潜在空間にエンコードし、新しいデータを生成する。 | VAEと同様に、条件付き入力(例:ラベル)を組み込んで生成を導く。 | 2つのネットワークで構成される:生成器がデータを作成し、識別器がそれを評価する。 |
| 入力データ | データ自体のみがエンコーダに入力される。 | 条件付きデータ(例:クラスラベルや属性)もエンコーダで使用される。 | 生成器への入力としてランダムノイズを使用し、識別器は生成されたデータを評価する。 |
| 潜在表現 | データ分布全体を表現し、滑らかで連続的な潜在空間を提供する。 | 潜在空間は入力データによって条件付けられ、生成される出力をより制御しやすくする。 | 潜在空間は訓練中に学習され、特定の特徴を明示的に制御することはできない。 |
| 生成制御 | 生成は純粋に潜在空間に基づき、外部からの制御はない。 | 条件付きデータにより、特定の属性に基づいたデータ生成が可能になる(例:「猫」や「犬」のような特定カテゴリの画像生成)。 | 生成器は識別器と「競争」し、識別器を「欺く」ことで生成データを改善する。 |
| 柔軟性 | 汎用的なデータ生成や異常検知に適している。 | 特定の属性に基づく制御された生成が必要なシナリオに理想的である。 | 現実的なサンプルの生成において非常に柔軟だが、特定の出力に対する制御は少ない。 |
| 訓練データ | 明示的な条件なしで、幅広いデータセットで訓練できる。 | 生成プロセスを導くために、追加のラベル付きデータまたは条件付きデータが必要である。 | 生成器と識別器の両方が競争する敵対的訓練が必要である。 |
| ユースケース | データ生成(例:顔の生成)、異常検知、データ点の補間。 | 制御された画像生成(例:特定のオブジェクトや、色・スタイルなどの条件の生成)、半教師あり学習。 | 高品質な画像生成、画像間変換、スタイル変換、データ拡張。 |
| 主な利点 | 訓練がより簡単で、外部条件を必要としない。 | 生成データをより適切に制御でき、高度に特定された出力の生成を可能にする。 | 明示的なラベルを必要とせず、非常に現実的な画像や多様なデータを生成する。 |
| 応用例 | 顔のランダム画像を生成する。 | 年齢、性別、表情などの特定の属性を持つ顔画像を生成する。 | 人間の顔のリアルな画像を生成する、アートを生成する、または画像をあるスタイルから別のスタイルへ変換する。 |
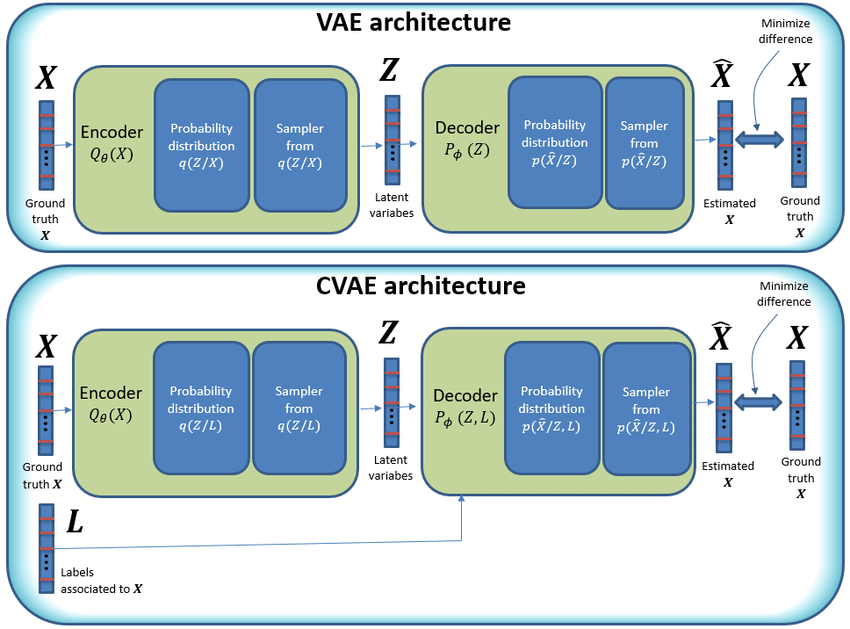 Comparison of CVAE with a typical VAE architecture.png
典型的なVAEアーキテクチャとCVAEの比較 | 出典
 Comparison of the architectures of (A) VAEs and (B) GANs.png
(A) VAEと(B) GANのアーキテクチャの比較 | 出典
変分オートエンコーダ(VAE)の利点と課題
変分オートエンコーダ(VAE)は生成モデリングにおいて大きな利点を提供しますが、対処すべき課題もあります。まず、VAEを使用する利点について説明します。
条件付き生成: CVAEは特定の条件に基づいて新しいサンプルを生成できるため、特定の特徴を持つ画像の生成やパーソナライズされたコンテンツの作成などのタスクに有用です。これにより、さまざまなアプリケーションに柔軟性と汎用性が加わります。
意味のある表現: 条件付きVAE(CVAE)は入力から意味のある潜在表現を学習し、データ構造のより良い理解と操作を可能にします。これは、特徴抽出や分析などのタスクに特に有益です。
カスタマイズ: CVAEは特定のニーズに合わせたデータを生成でき、カスタマイズされたレコメンデーションやターゲットを絞ったコンテンツを可能にします。これにより、広告やパーソナライズされたユーザー向けアプリケーションなどの分野で非常に価値があります。
データ拡張: CVAEは、多様で現実的な合成データを生成することでデータセットを拡張するために使用できます。この能力は、特にデータセットが限られている、または不均衡なシナリオにおいて、機械学習モデルの性能向上に役立ちます。
次に、VAEを使用する際に直面する課題について説明します。
モード崩壊: これは、モデルが少数の種類のサンプルのみを生成し、多様な出力ではなく反復的な出力につながる場合に発生します。過学習は、モデルが意味のある潜在表現を学習するのではなく、特定のパターンを記憶してしまうことで、この問題を悪化させる可能性があります。これは多くの場合、潜在空間の探索が不十分であること、またはトレーニングデータが不足している、もしくは代表性に欠けていることが原因で発生します。これに対処するには、ドロップアウトやバッチ正規化などの正則化手法を、Importance-Weighted Autoencoders(IWAE)のような高度なトレーニングアルゴリズムと併用できます。
高解像度画像生成: CVAEは高解像度画像を効果的に生成することに苦労します。モデルの潜在空間が十分な細かい詳細を捉えられず、ぼやけた、または歪んだ出力になる可能性があります。この制約は、潜在空間の容量の制限と高解像度出力における品質低下に起因します。この課題を緩和するには、より複雑な潜在空間や階層型VAEを使用する、CVAEをGANなどのモデルと組み合わせる、またはトレーニング中に解像度を段階的に上げるプログレッシブトレーニング手法を採用することが含まれます。
条件付き変分オートエンコーダ(CVAE)のユースケース
条件付き変分オートエンコーダ(CVAE)は、ディープラーニングにおける汎用性の高いツールであり、さまざまな領域にわたって応用されています。主なユースケースを以下に示します。
画像生成: CVAEは、スタイル、ポーズ、照明などの属性を条件として画像を生成します。デザインやファッションでは、衣服を異なるスタイルや色で可視化するために使用されます。ゲーム開発者は多様なキャラクターの外見を作成するために活用し、自動車メーカーは顧客向けにさまざまなカスタマイズを施した車両をレンダリングするために使用します。
コンテンツ推薦システム: CVAEは、ユーザーの好みを学習して関連性の高い推薦を提案することで、パーソナライゼーションを強化します。また、ユーザーのインタラクションに動的に適応し、時間の経過とともにエンゲージメントを向上させます。
創薬: CVAEは、望ましい特性に基づいて新規分子構造を生成することで、医療イノベーションを加速します。また、既存の化合物を最適化し、治療成果を向上させます。
異常検知: CVAEは、重要なシステムにおける異常なパターンを特定します。通常の運用パラメータからの逸脱を検出し、異常なネットワーク活動を検知することでサイバーセキュリティを強化します。
自然言語処理(NLP): CVAEは、文脈、スタイル、またはトーンに条件付けられた一貫性のあるテキスト生成などのタスクに貢献します。また、スタイル上の要件に合わせた繊細な言語翻訳を促進します。
アートと創造性: CVAEは、スタイル変換によって異なる美的表現でアート作品を再構想できるようにし、アーティストやクリエイターを支援します。また、特定のテーマやモチーフに基づいた新しい芸術作品の生成も支援します。
AI倫理と説明責任: CVAEは、制御されたデータ生成を通じてモデルの解釈可能性を向上させることで、責任あるAI開発を支援します。制御可能な出力を可能にすることで、AIシステムが倫理基準に沿うようにします。
ツール
ここでは、Conditional Variational Autoencoders(CVAEs)の実装とトレーニングを促進する一般的なツールやフレームワークをいくつか紹介します。
TensorFlow: CVAEを設計するための強力なフレームワークです。エンコーダー・デコーダーアーキテクチャの実装を簡素化し、TensorFlow Probabilityを通じてKLダイバージェンス項の計算をサポートします。GPU/TPUサポートにより、大規模データセットに対する効率的なトレーニングが可能になります。
PyTorch: 柔軟性と動的計算グラフにより広く使用されており、カスタムCVAE実装に最適です。モデルコンポーネントを精密に制御でき、PyroのようなライブラリはCVAEの損失関数向けに高度な確率的モデリング機能を追加します。
JAX と Flax: JAXは、そのニューラルネットワークライブラリであるFlaxと組み合わせることで、CVAE向けの効率的な計算を提供します。勾配計算をカスタマイズする柔軟性を提供し、複雑なCVAEタスク向けのスケーラブルなアーキテクチャをサポートします。
FAQ
CVAEは標準的なVAEと何が異なりますか? CVAEは条件付き入力を使用して出力特徴を制御します。標準的なVAEは入力分布のみに基づいてデータを生成します。
条件付けはCVAEの生成プロセスにどのように影響しますか? 条件付けは、特定の属性に一致するデータを生成するようモデルを導きます。出力に制御性と精度を加えます。
CVAEの一般的な用途は何ですか? CVAEは、カスタマイズされた画像、パーソナライズされたテキスト、拡張データセットを作成します。特定の特徴生成を必要とするタスクに適しています。
CVAEをトレーニングする際に直面する可能性のある課題は何ですか? トレーニングにはラベル付きデータと慎重なチューニングが必要です。また、安定性や複雑性に関する問題に直面することもあります。
GANと比較した場合のCVAEの限界は何ですか? CVAEは、より現実感の低い出力を生成する可能性があります。GANは多くの場合、より鮮明で詳細な結果を達成しますが、同じレベルの制御性には欠けます。