




Apache Cassandra vs Deep Lake:AIアプリケーションに適したベクターデータベースの選択
#はじめに
人工知能がデータ主導の世界を再定義し続ける中、ベクトル埋め込みなどの複雑なデータ構造を扱える堅牢なベクトルデータベースの必要性がますます明らかになってきています。このブログでは、2つの注目すべきデータベースを紹介し、比較します:Apache CassandraとDeep Lakeだ。それぞれ、AIアプリケーションに不可欠なベクトル埋め込みを扱うための特徴的なアプローチを提供しています。
ベクターデータベースとは?
Apache CassandraとDeep Lakeを比較する前に、まずはベクトル・データベースの概念を探ってみよう。
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするために設計されています。ベクトルは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または機械学習モデルを使用した製品属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースは、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなど、多くのユースケースで採用されている。また、AI幻覚のような問題を軽減するために外部知識を提供することによって、大規模言語モデル(LLMs)のパフォーマンスを向上させる技術である、検索拡張生成(RAG)でも重要な役割を果たしている。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 伝統的なデータベース** ** Apache Cassandraのようなベクトル検索アドオン付き。
Apache Cassandraを理解する
Apache Cassandra](https://cassandra.apache.org/doc/latest/)はオープンソースの分散型NoSQLデータベース・システムで、単一障害点のない多数のサーバーで大量のデータを処理できるように設計されています。元々は、多数のノードにまたがる大量の構造化データおよび半構造化データを効率的に処理するために開発された。Cassandraは、高いスケーラビリティ、フォールト・トレランス、ダウンタイムやパフォーマンスの低下を最小限に抑えて分散環境で動作する能力で知られています。
Cassandra 5.0](https://cassandra.apache.org/doc/latest/cassandra/vector-search/concepts.html)のリリースにより、Apache CassandraはNoSQLデータベースとしてのコア機能を超えて、ベクトル埋め込みとベクトル検索をサポートするように進化しています。Cassandraのベクトル検索機能は、既存のアーキテクチャに基づいて構築されています。これにより、ユーザーはベクトル埋め込みを他のデータと一緒に保存し、類似検索を実行できる。この統合により、Cassandraは大規模な分散データを扱う強みを維持しながら、AI主導のアプリケーションをサポートすることができる。
Cassandraのベクトル検索の重要なコンポーネントは、Storage-Attached Indexes(SAI)です。SAIは非常にスケーラブルでグローバルに分散されたインデックスで、あらゆるベクトル・データ型の列に列レベルのインデックスを追加します。ベクトル検索やその他の検索インデックスを使用するデータベースに比類ないI/Oスループットを提供します。SAIは広範なインデックス機能を提供し、クエリとコンテンツ(文書、単語、画像などの大規模な入力を含む)の両方にインデックスを付けてセマンティクスを取得することができます。
Vector Searchは、SAIの新しいモジュール性を活用した、SAIの拡張性を検証する最初の事例です。このVector SearchとSAIの組み合わせは、AIと機械学習のワークロードを処理するCassandraの機能を強化し、ベクトル・データベース分野における強力な候補となる。
ディープレイクを理解する
Deep Lake](https://github.com/activeloopai/deeplake)は、画像、音声、動画、その他の非構造化データなどのベクトル・マルチメディア・データの保存、管理、クエリを処理するために設計された特殊なデータベース・システムであり、AIや機械学習アプリケーションでますます使用されるようになっている。Deep Lakeはデータレイクとしてもベクターストアとしても利用できる:
データレイクとしてのDeep Lake: Deep Lakeは、画像、音声、動画、テキスト、NIfTIのような医療画像フォーマット、メタデータなどの非構造化データを、ディープラーニングのパフォーマンスを高めるために設計されたバージョン管理されたフォーマットで、効率的に保存・整理することができます。これにより、ユーザーはデータセットを迅速にクエリして視覚化することができ、高品質のトレーニングセットの作成が容易になります。
ベクターストアとしての Deep Lake: Deep Lake は、テキスト、JSON、画像、音声、動画ファイルなどの vector embeddings と関連するメタデータを保存・検索するための堅牢なソリューションを提供します。ローカル、お好みのクラウド環境、またはDeep Lakeのマネージドストレージにデータを保存できます。また、Deep LakeはLangChainやLlamaIndexのようなツールとのシームレスな統合も提供しており、開発者は検索拡張世代(RAG)アプリケーションを簡単に構築することができます。
Apache CassandraとDeep Lakeの主な違い
検索手法
Apache Cassandraは拡張機能を通じてベクトル検索を統合し、その伝統的なデータベース・アーキテクチャを新しいAI機能をサポートするために適応させている。対照的に、Deep Lakeはベクトル検索と管理にフォーカスして構築されており、高度なアルゴリズムをコア機能に直接組み込むことで、より効率的なベクトル操作を可能にしている。
データハンドリング
Cassandraは構造化および半構造化データの管理に長けていますが、非構造化ベクトル・データを効果的に扱うには追加の設定が必要です。一方、Deep Lakeは本質的に非構造化データを管理するように設計されており、マルチメディアコンテンツを中心としたアプリケーションに自然にフィットする。
パフォーマンスとスケーラビリティ
どちらの技術もスケーラブルだが、Cassandraは特に分散環境で非常に高い書き込み・読み込み負荷を処理できることで有名だ。Deep Lakeは、複雑なベクトル計算アプリケーションにとって重要なクエリ・パフォーマンスの最適化に重点を置いている。
柔軟性とカスタマイズ
Cassandraがデータ・モデリングにおいて幅広い柔軟性を提供し、さまざまなアプリケーション向けに幅広くカスタマイズできるのに対し、Deep Lakeは、一般的な柔軟性はやや劣るものの、ベクトル・データに特化したツールと機能を提供します。
統合とエコシステム
Cassandraは、SparkやHadoopのような他のApacheツールとうまく連携する。オープン・ソースのデータ・ツールの大きなエコシステムの一部であり、オープン・テクノロジーを好む開発者にとって大きな利点となる。
Deep Lakeは、LangChainやLlamaIndexのようなAIや機械学習のエコシステムとの統合が進んでおり、一般的に使用されるモデル形式や機械学習フレームワークをネイティブにサポートしている。
コストと使いやすさ
Cassandraは一般的に、大規模なデプロイメントに対して低コストのオプションを提示し、広範なドキュメントと強力なコミュニティによってサポートされている。Deep Lakeは、特にその機能が十分に活用されていない場合、コストが高くなる可能性がありますが、特化した機能のセットアップがよりシンプルになります。
各テクノロジーを選択するタイミング
Apache CassandraとDeep Lakeのどちらを選択するかは、特定のアプリケーションのニーズ、つまり従来のビッグデータタスクに傾倒しているか、特殊なベクトル処理機能に傾倒しているかによって大きく異なります。以下は主な検討事項をまとめたものです:
Apache Cassandraを選択するタイミング
以下の場合にApache Cassandraを選択します:
- 大規模な分散データセットを処理するために大規模なスケーラビリティが必要な場合。
- アプリケーションにとって高可用性と耐障害性が重要です。
- リアルタイム分析** または高い書き込みスループットを必要とするアプリケーションに重点を置いている。
- 構造化データおよび半構造化データの柔軟なデータ管理が必要です。
- ベクトル検索**のために、ネイティブ・サポートを必要とせず、外部ツールを統合できます。
ディープレイクを選択するタイミング
次のような場合に Deep Lake を選択します:
- プロジェクトにベクトルデータや機械学習やNLPのようなAIワークフローが含まれる場合。
- 大量のマルチメディアデータや非構造化データを扱う必要がある。
- データのバージョニングを伴うディープラーニングモデルのトレーニングに取り組んでいる。
- ネイティブの高次元ベクトル検索機能が必要です。
オープンソースのVectorDBBenchを使ってベクターデータベースを自分で評価・比較したい。
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのために設計されたオープンソースのベンチマークツールです。このツールにより、ユーザは独自のデータセットを用いてMilvusやZilliz Cloud(マネージドMilvus)などの異なるベクトルデータベースシステムの性能をテスト・比較し、ユースケースに最も適したものを決定することができます。VectorDBBenchを使用することで、ユーザーはマーケティング上の主張や逸話的証拠に頼るのではなく、実際のベクトルデータベースのパフォーマンスに基づいて情報に基づいた決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされている。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
- VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
- VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)**で主流のベクトルデータベースの性能を見てみましょう。
- ベンチマークベクターデータベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- 任意のベクトルデータベースと代替データベースを比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
Zilliz Cloud Now Available in 6 New Regions Across Japan and Europe
Zilliz Cloud is now available in new regions across Japan and Europe, including Tokyo on all three major clouds, bringing the total to 28 regions.
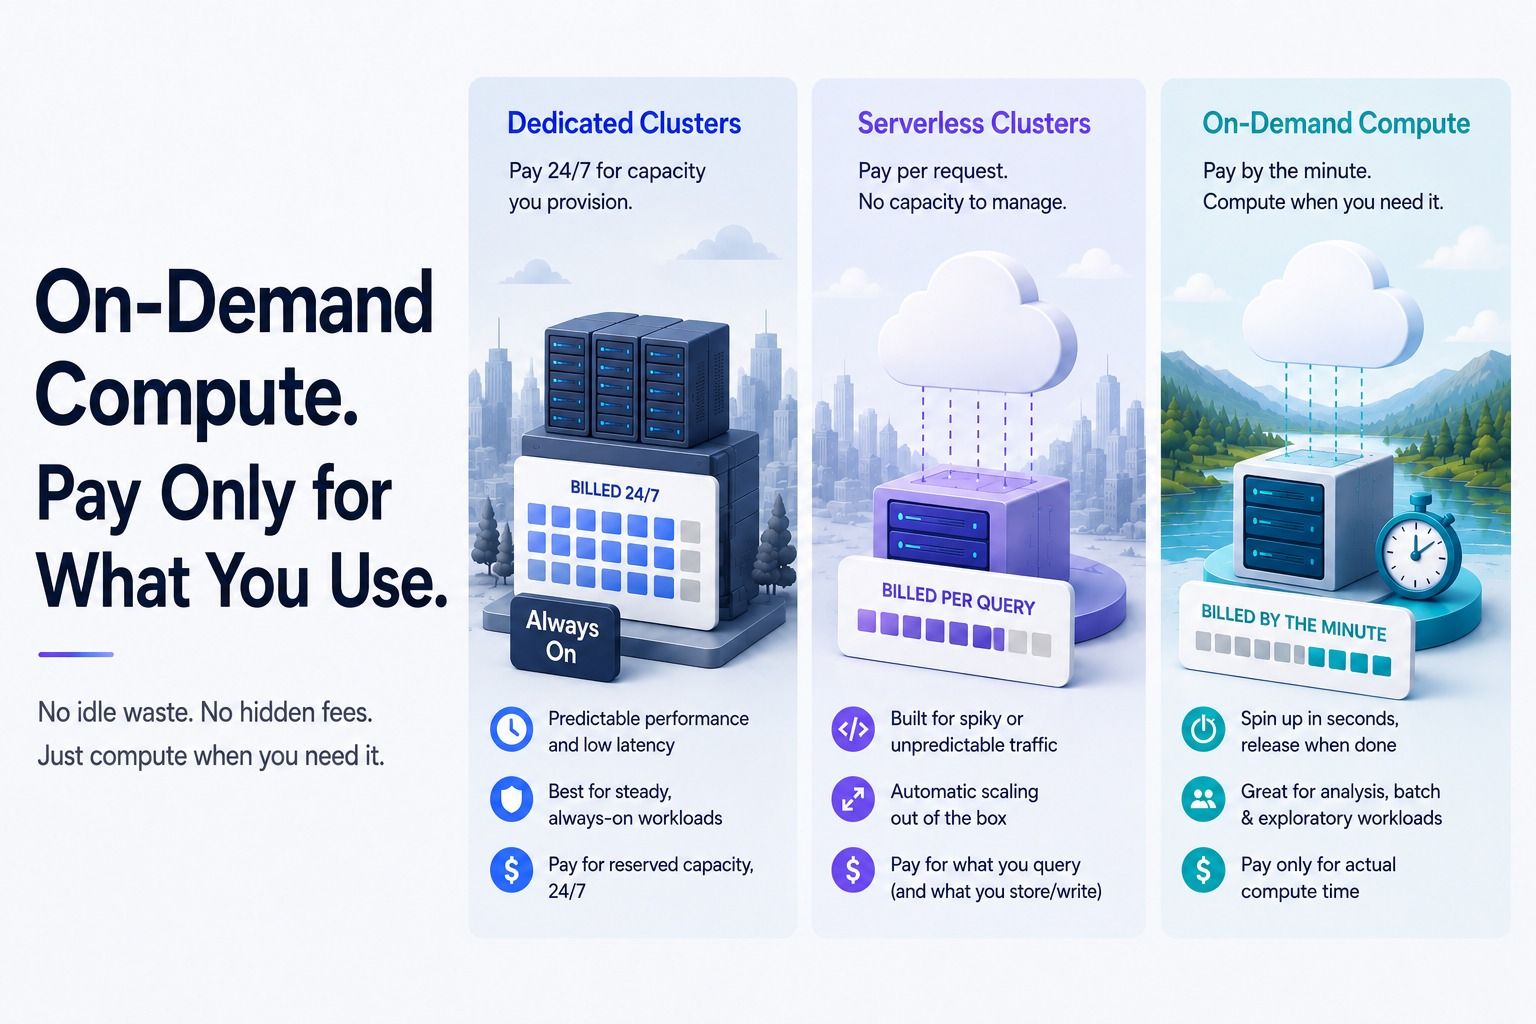
Zilliz Cloud On-Demand Compute: Pay Only for What You Use
The customer case behind Zilliz Cloud On-Demand: how a $10K vector search bill came down to under $500, and the engineering changes that made it possible.
How to Use Anthropic MCP Server with Milvus
MCP + Milvus: Streamline AI agent development with standardized data access, eliminating integration hassles while enhancing context and flexibility.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.