LlamaIndexを使ったデータサイエンスに向けたチャット
LlamaIndexを使ったデータサイエンスに向けたチャット

*この記事は、「データサイエンスに向けたチャット」ブログシリーズ(全4回)の2回目です。Zilliz Cloudでチャットボットを構築する方法については、前編を参照してください。
LlamaIndexはオープンソースを代表するデータ検索フレームワークですが、その理由はこれからわかります。社内のナレッジストアにアクセスできるチャットボットは、多くの企業で人気のユースケースです。ドキュメントが増えれば増えるほど、管理は難しくなります。このようなチャットボットを作るとなると、データをどのようにチャンクするか、どのようなメタデータを保存するか、クエリをどのようにルーティングするかという3つの主要な懸念事項があります。
これまでのチャットTDSプロジェクト
このチュートリアルは、前回のTowards Data Scienceのためのチャットボットの作り方をベースにしています。前回の投稿では、Milvus/Zillizだけを使って可能な限りシンプルなretrieval augmented generationチャットボットを作りました。それをフルマネージドのMilvusであるZilliz Cloudにアップしたので、複数のプロジェクトで同じベクターデータベースにアクセスできるようになった。このプロジェクトにはZilliz Cloudの無料版を使うこともできますし、Milvusのインスタンスを使うこともできます。Milvus Liteを使ってノートブックでスピンアップすることもできます。
前回、私たちは分割を調べ、多くの小さなテキストの塊があることを確認しました。大きな言語モデルとは何か」という質問に対して単純な検索を試したところ、返ってきたチャンクは意味的には似ていましたが、質問の答えにはなりませんでした。このプロジェクトでは、同じベクトル・データベースをバックエンドとして使いながら、異なる検索プロセスを使うことで、より良い結果を得ることができる。このケースでは、LlamaIndexを使って効果的な検索をオーケストレーションしている。
なぜチャットボットにLlamaIndexを使うのか?
LlamaIndexは、大規模な言語モデルの上でデータを扱うためのフレームワークです。LlamaIndexが提供する主要な抽象化の一つは、"インデックス "抽象化です。インデックスとは、データがどのように分散されているかのモデルである。その上、LlamaIndexはこれらのインデックスをクエリーエンジンに変える機能も提供している。クエリーエンジンは、大規模な言語モデルと埋め込みモデルを活用して、効果的なクエリーをオーケストレーションし、関連する結果を取得する。
LlamaIndexとMilvusによるデータサイエンスに向けたチャット
LlamaIndexはデータ検索のオーケストレーションに役立っていますが、Milvusはどのように役立っているのでしょうか?LlamaIndexによる永続的ベクトルストレージ](https://zilliz.com/learn/persistent-vector-storage-for-llamaIndex)のバックエンドとして使っているのがMilvusです。MilvusやZillizのインスタンスを使うことで、ベクターをあるフレームワークから別のフレームワークに移植することができます。今回のケースでは、Pythonネイティブのオーケストレーションなしアプリケーションから、LlamaIndexを利用した検索アプリケーションに移行している。
ZillizとLlamaIndexを使うためのノートブックのセットアップ
以前取り上げたように、この一連のプロジェクト(Chat with Towards Data Science)では、移植性を高めるためにZillizを使用しています。Zilliz Cloudへの接続とMilvusへの接続はほとんど同じです。Milvusに接続し、Milvusをローカルベクトルストアとして使用する方法の例については、ベクトルの埋め込みを比較するの例を参照してください。
このノートブックでは3つのライブラリをインストールする必要がありますが、これは pip install llama-index python-dotenv openai でインストールできます。環境変数の管理には python-dotenv を使いたい。
インポートを取得したら、load_dotenv()で .env ファイルをロードする必要がある。このプロジェクトで必要な環境変数は、OpenAIのAPIキー、Zilliz CloudクラスタのURI、Zilliz Cloudクラスタのトークンの3つだ。
pip install llama-index python-dotenv openai
import os
from dotenv import load_dotenv
インポート openai


load_dotenv()


openai.api_key = os.getenv("OPENAI_API_KEY")


zilliz_uri = os.getenv("ZILLIZ_URI")
zilliz_token = os.getenv("ZILLIZ_TOKEN")
既存のコレクションをLlamaIndexに持ってくる
このプロジェクトでは、既存のコレクションをLlamaIndexに持ってきます。これはユニークな挑戦です。LlamaIndexは、ベクターデータベースコレクションを作成し、アクセスするための独自の内部構造を持っています。しかし、今回はLlamaIndexを使って直接コレクションを構築するわけではありません。
LlamaIndexベクターストアのネイティブ・インターフェースと、独自のモデルを持ち込む場合の主な違いは、埋め込みとメタデータへのアクセス方法です。私は実際にこのプロジェクトを可能にするためのLlamaIndexの貢献!を書きました。
LlamaIndexはデフォルトでOpenAIのエンベッディングを使いますが、私たちはHuggingFaceモデルを使ってエンベッディングを生成しました。これは、正しい埋め込みモデルを渡さなければならないことを意味します。さらに、テキストを格納するために、異なるフィールドを使用しています。LlamaIndexはデフォルトで"_node_content "を使うのに対して、私たちは "paragraph "を使っています。
このセクションでは、LlamaIndexから4つのインポートが必要だ。まず、LlamaIndexでMilvusを使うためにMilvusVectorStoreが必要である。また、Milvusをベクトルストアのインデックスとして使用するための VectorStoreIndex モジュールと、使用したいサービスを渡すための service context モジュールが必要である。最後に必要なインポートは HuggingFaceEmbedding モジュールで、Hugging Faceのオープンソースのエンベッディングモデルを使うことができる。
まず、埋め込みモデルを取得することから始めよう。HuggingFaceEmbeddingオブジェクトを宣言し、モデル名を渡すだけです。この場合は、MiniLM L12モデルです。次に、サービスコンテキストオブジェクトを作成し、この埋め込みモデルを渡せるようにします。
from llama_index.vector_stores import MilvusVectorStore
from llama_index import VectorStoreIndex, ServiceContext
from llama_index.embeddings import HuggingFaceEmbedding


embed_model = HuggingFaceEmbedding(model_name="sentence-transformers/all-MiniLM-L12-v2")
service_context = ServiceContext.from_defaults(embed_model=embed_model)
また、Milvusベクターストアに接続する必要があります。コレクションのURI、コレクションにアクセスするためのトークン、使用したコレクション名(デフォルトでは "Llamalection")、使用した類似度メトリック、テキストを格納するメタデータフィールドに対応するキーである。
vdb = MilvusVectorStore(
    uri = zilliz_uri、
    token = zilliz_token、
    コレクション名 = "tds_articles"、
    similarity_metric = "L2"、
    text_key="paragraph"
)
LlamaIndexを使って既存のMilvusコレクションをクエリする
さて、既存のMilvusコレクションを接続し、必要なモデルを取り出したので、クエリをチェックしてみましょう。まず、Milvusベクターデータベースを渡すためのストレージコンテキストオブジェクトを作成します。次に、Milvusコレクションをベクトルストアのインデックスにします。また、ここで作成したサービスコンテキストオブジェクトを使って埋め込みモデルを渡します。
ベクトルストアのインデックスオブジェクトが初期化されたら、as_query_engine()関数を呼び出してクエリーエンジンにします。この例では、"大規模な言語モデルとは何か?"という前と同じ質問を使って、単純な意味検索とLlamaIndexクエリーエンジンの使い方の違いを比較します。
vector_index = VectorStoreIndex.from_vector_store(vector_store=vdb, service_context=service_context)
query_engine = vector_index.as_query_engine()
response = query_engine.query("大きな言語モデルとは何ですか?")
出力を見栄え良くするために、pprintをインポートし、レスポンスの表示に使用した。
from pprint import pprint
pprint(response)
これは、LlamaIndexを使って検索した結果です。単純なセマンティック検索よりもはるかに良い結果です!
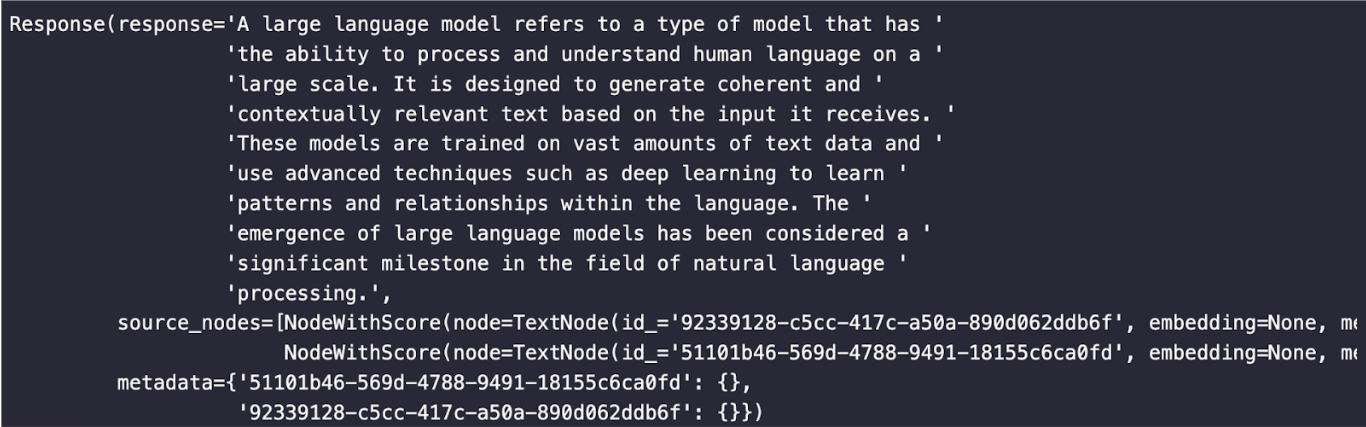 llamaindex-response.png
LlamaIndexでデータサイエンスを目指すチャットまとめ
データサイエンスに向かうチャット」プロジェクトのこのバージョンでは、LlamaIndexを既存のMilvusコレクションと共に使用し、最初のバージョンを改良した。最初のバージョンでは、ベクトル検索による単純な意味的類似性を使って答えを探しました。その結果はあまり良いものではありませんでした。LlamaIndexを使ってクエリーエンジンを実装することで、より良い結果が得られました。
このプロジェクトの最大の課題は、私たち自身の既存のMilvusコレクションを持ち込むことでした。私たちの既存のコレクションは、埋め込みベクトル次元とテキストを格納するためのメタデータフィールドのデフォルト値を使用していませんでした。この2つの違いは、Milvus Vector Storeオブジェクトを作成する際に、サービスコンテキストを通して特定の埋め込みモデルを渡し、正しいテキストフィールドを定義することで対処できます。
ベクターストアオブジェクトを作成したら、それを使用したHugging Faceエンベッディングでインデックスにしました。そして、そのインデックスをクエリーエンジンにしました。クエリーエンジンはLLMを活用し、質問の意味を理解し、回答を収集し、より良い回答を構築します。
Chat Towards Data Scienceシリーズをもう一度読むには、以下のリンクをクリックしてください:
 Yujian TangDeveloper Advocate at Zilliz
Yujian Tang is a Developer Advocate at Zilliz. He has a background as a software engineer working on AutoML at Amazon. Yujian studied Computer Science, Statistics, and Neuroscience with research papers published to conferences including IEEE Big Data. He enjoys drinking bubble tea, spending time with family, and being near water.