




Plaud、Zilliz Cloudで数十億規模のエージェントメモリを実現
200 ms
平均リコールレイテンシ
100億+
リージョンごとのベクターチャンク、拡張の余地あり
日々の中で
十億規模の履歴データバックフィル、サービス中断なし
ゼロダウンタイム
常時稼働アプリにおけるスキーマ変更とクラスターアップグレード
AI is moving from answering one-off questions to agents that remember, which makes AI memory the heart of consumer AI products. Zilliz Cloud gives us a solid foundation we can trust for agentic memory retrieval at a massive scale, so our team can put its energy into product innovation and user experience, not the plumbing beneath it.
Charles Liu
Plaudについて
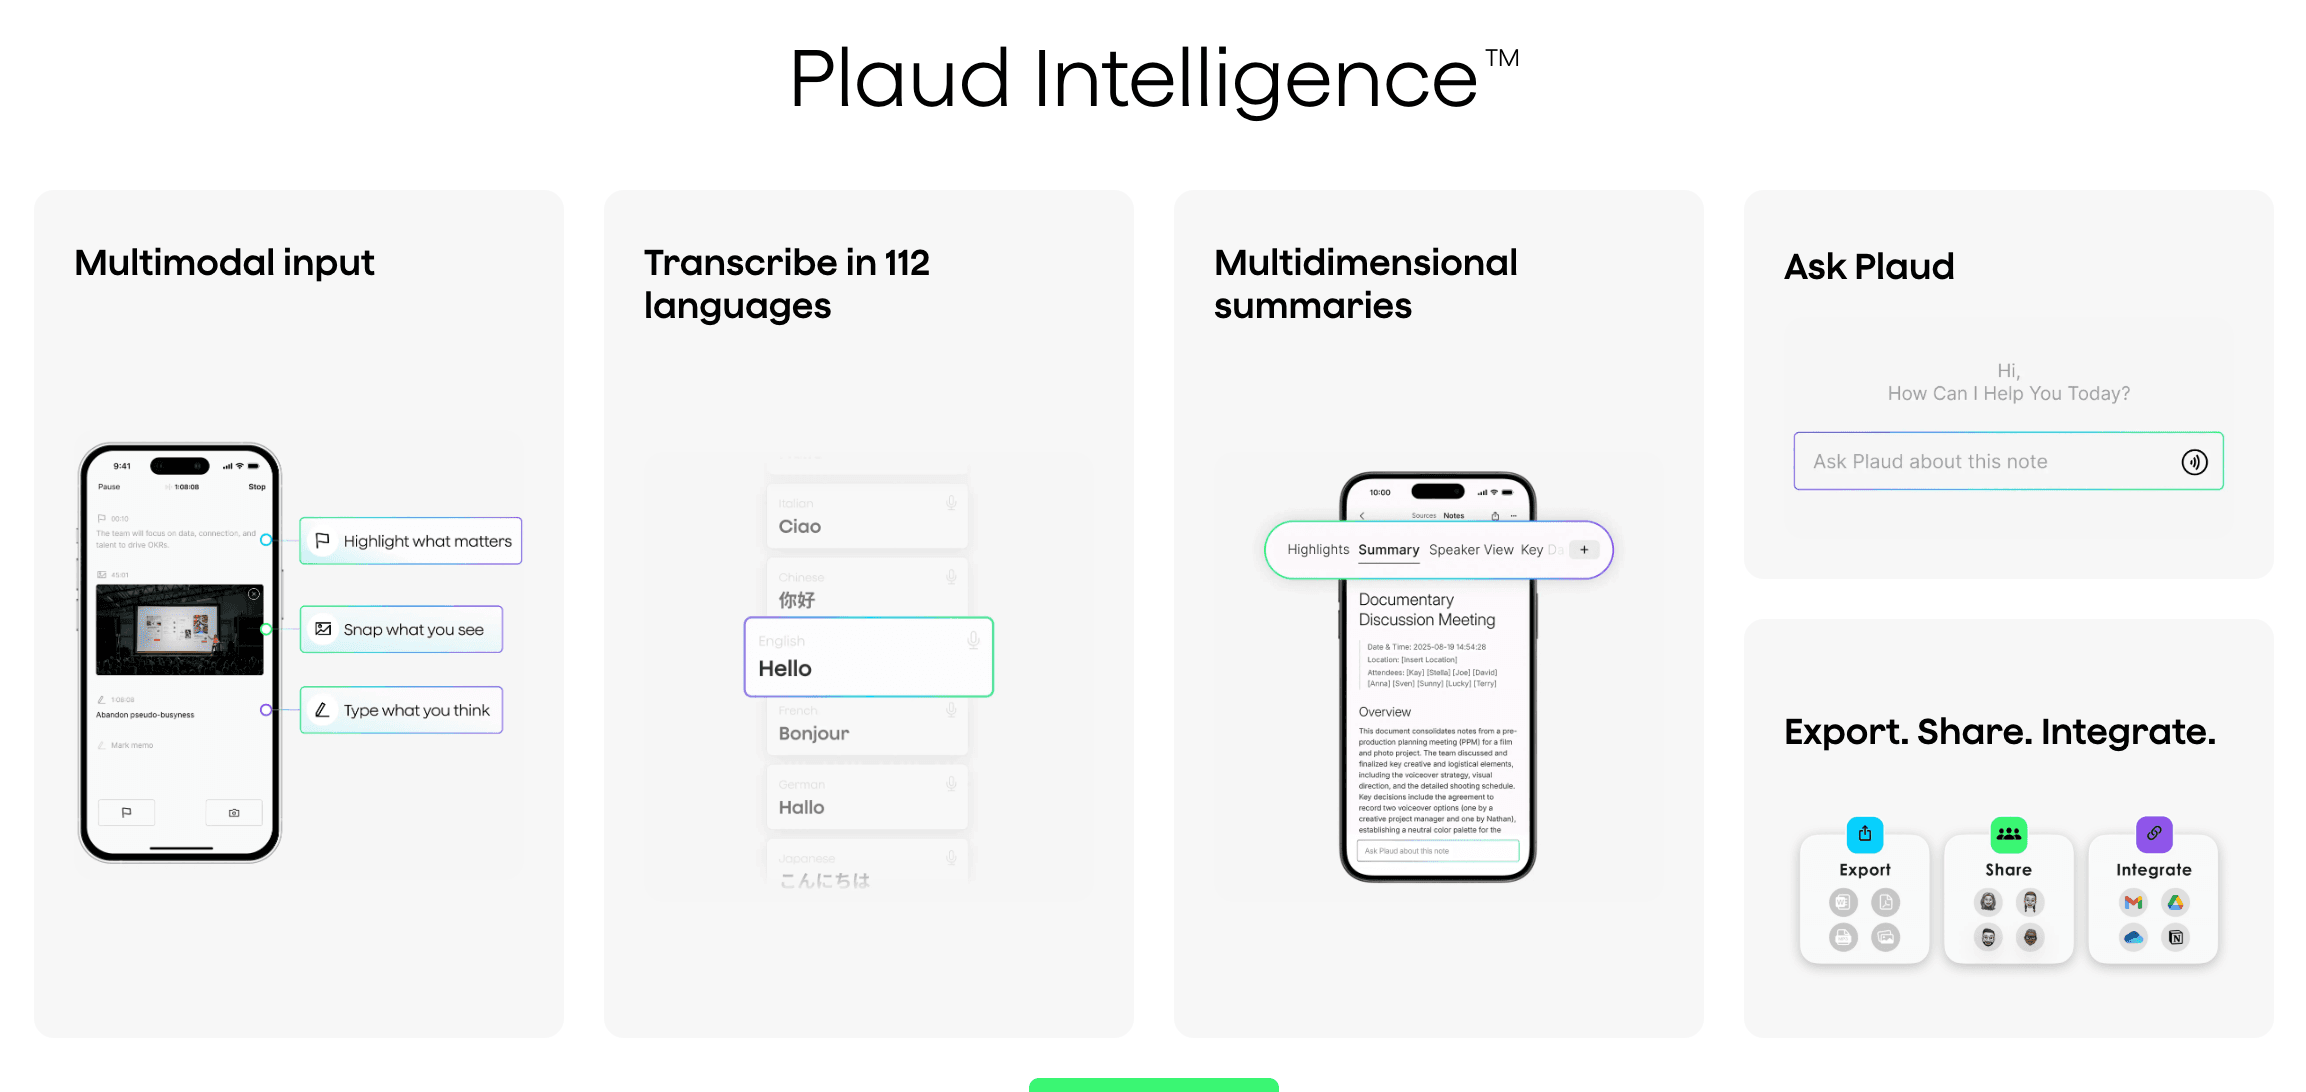
Plaud は、世界No.1のAIメモ帳ブランドです。そのハードウェア — クレジットカードサイズのAIメモ記録デバイスであるPlaud Note、Plaud Note Pro、そしてウェアラブルなPlaud NotePin S — は、Plaud Intelligence(アプリ、ウェブ、デスクトップで利用可能)と連携して、日常の会話を要約、To-Do項目、ビジネス価値に変換します。Plaudは3年足らずで、コンシューマー向けAIハードウェアを代表する企業の一つになりました。170以上の国々で200万台以上のデバイスを出荷し、年間経常収益を約2年間で100万ドルから1億ドル以上に成長させました。
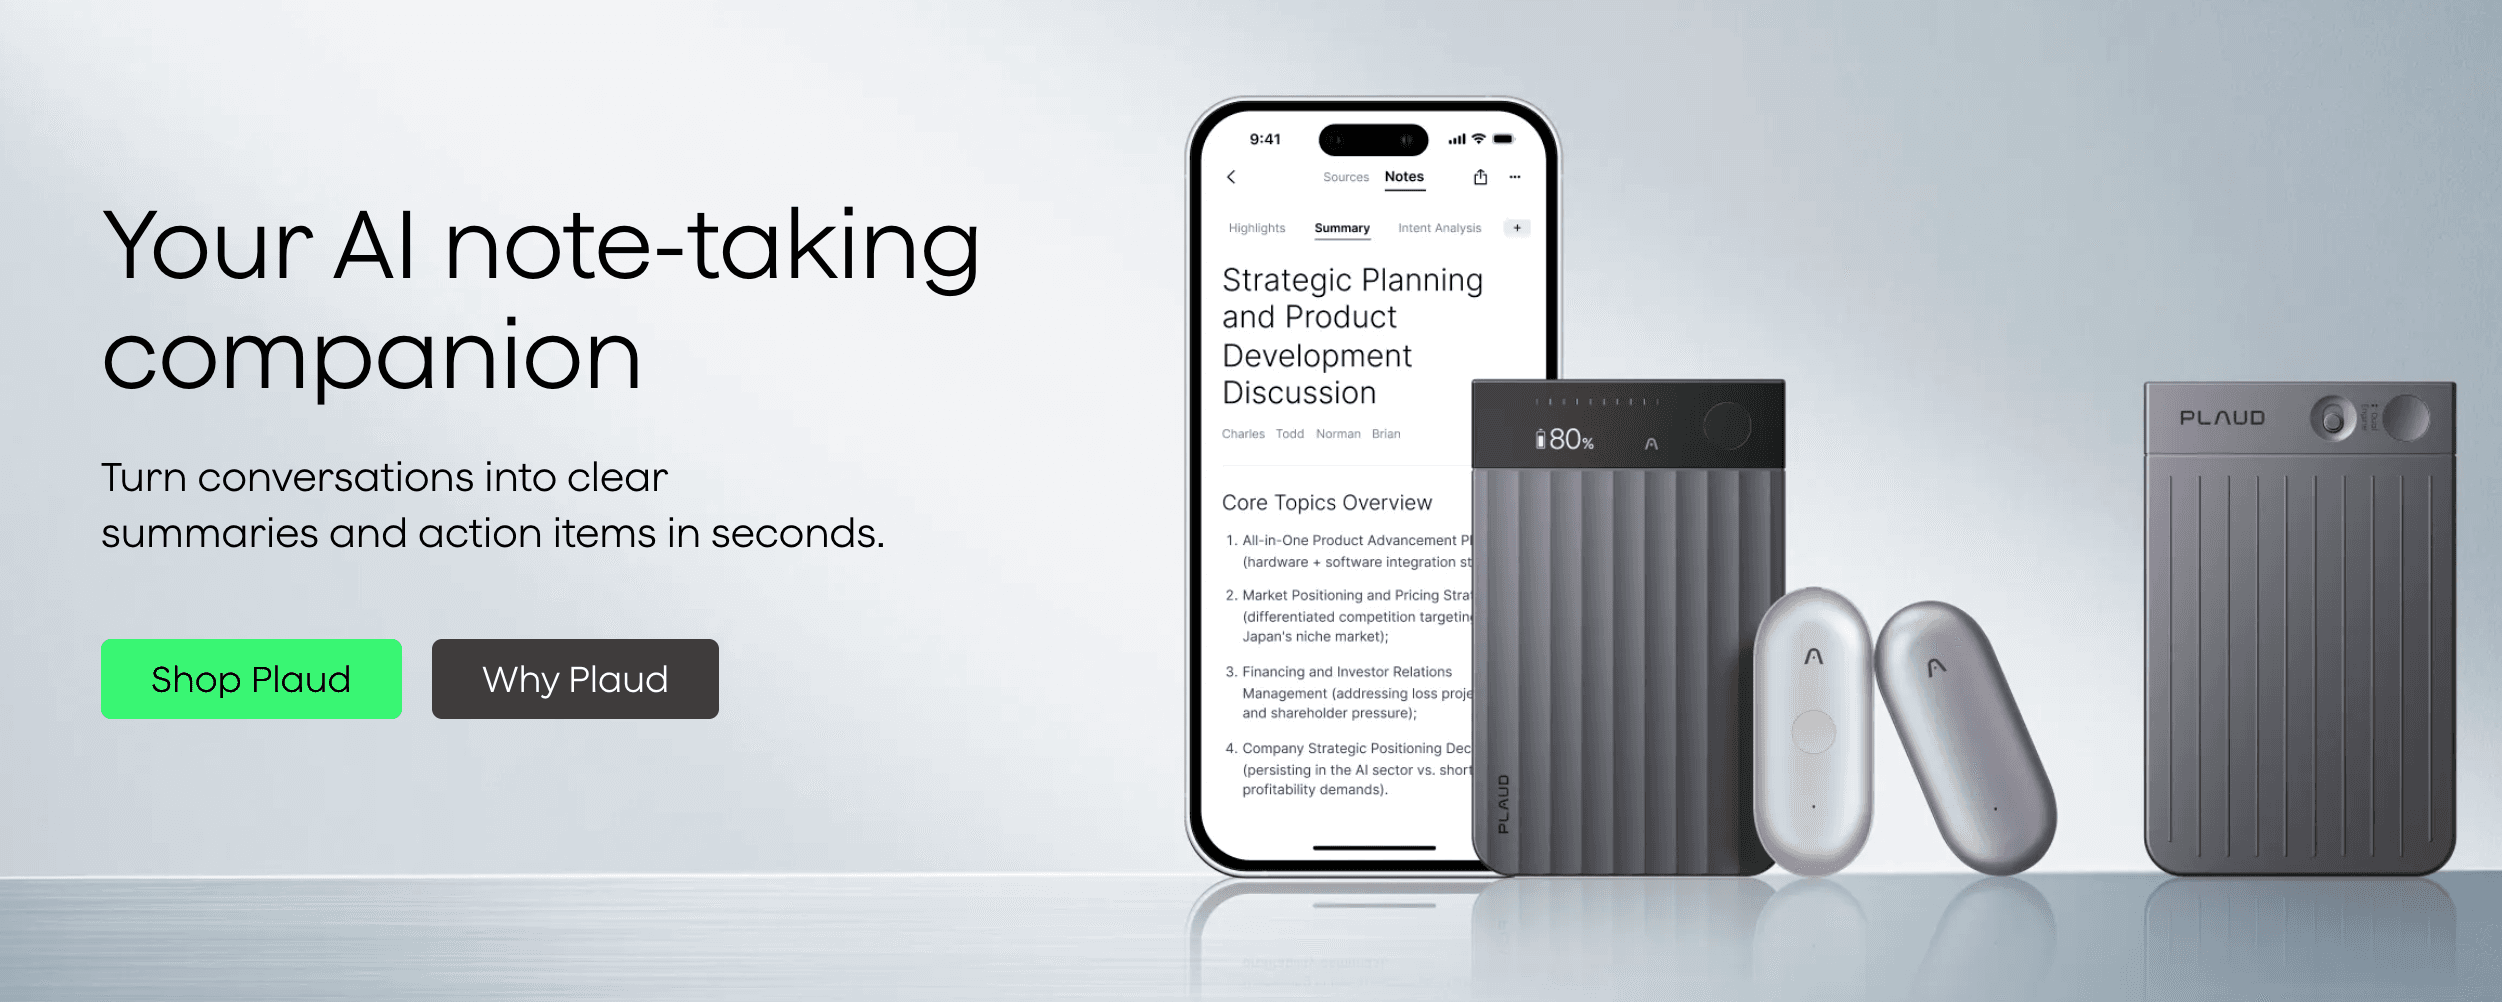
その体験の背後には、見た目以上に困難なタスクがあります。すべての録音は、ユーザーが即座に検索・質問できることを期待する長期的な個人メモリになります。それが急成長する世界的なユーザーベースによって何倍にもなります。そのメモリを大規模に保存・取得する仕事を、PlaudはZilliz Cloudに託しています。
課題
コンシューマースケールのAIメモリは、本番環境で最も要求の厳しい検索ワークロードの一つです。Plaudは当初、検索とログをうまく処理していたOpenSearch上に検索を構築しました。しかし、ワークロードが数十億規模のセマンティック検索とハイブリッド検索へと移行するにつれ、その規模でのOpenSearchの検索パフォーマンスとコストは追いつかなくなりました。その基盤を置き換えるということは、一度に3つの力に対処することを意味しました。
- 爆発的な、コンシューマースケールのデータ成長。 世界中で採用が加速するにつれ、Plaudのベクトル化されたメモリは、リージョンごとに数億から数十億のチャンクへと成長し、数百億に近づいています。各録音はまた、フィルタリングとランキングに使用されるリッチなスカラーメタデータを生成し、コンシューマー製品は膨大なロングテールの「コールド」メモリ(ユーザーが何ヶ月も無視した後、突然必要になる可能性のあるデータ)を生成します。このデータは、アクティブなクエリを遅くすることなく、低コストで保持し続ける必要があります。
- セマンティックでエージェント的なワークロード — 単なるキーワード検索ではありません。 Plaudの中心的なユースケースは、Agentic RAGとメモリです。それは、意味によって駆動される数十億規模の検索であり、Ask Plaudとそのエージェントに供給されます。これには、条件付きスカラーフィルタリングと組み合わせた真の高性能ベクトル検索、および低遅延リードと干渉せずに実行される大量の継続的ライトが必要です。関連性はまた、コンテンツタイプと新しさを尊重する必要があります。要約は生のトランスクリプトよりも優先され、最近のメモリが最初に表示されるべきです。
- グローバルで常時稼働、そして機密性の高い個人データ向けに構築されています。 世界的なユーザーベースにより、マルチリージョン展開とデータローカライゼーションが厳格な要件となります。録音は非常に個人的なものであるため、プラットフォームには顧客管理の暗号化と、平文が決してPlaudの外に出ないモデルが必要です。そして、製品が継続的に出荷されるため、検索レイヤー自体も進化する必要があります。新しいフィールド、新しいインデックス、バージョンアップグレードを、ゼロダウンタイムで実現します。
Zilliz Cloudを選ぶ理由
Plaudがこのワークロードの基盤としてZilliz Cloudを選んだ理由は3つあります。
数十億規模で実証されたパフォーマンスと安定性。 Plaudは、ベンチマークではなく、本番環境でデータが数十億に成長しても高速かつ安定したエンジンを必要としていました。Zilliz Cloudの分散アーキテクチャは、大規模な高性能検索と高スループットの書き込みを持続し、リードとライトを分離して、ワークロードの成長に伴うレイテンシーを予測可能に保ちます。
ユーザーコンテンツをPlaudに留めるプライバシーモデル。 PlaudがZilliz Cloudに送信するのは、検索に必要なものだけです。つまり、セマンティックベクトルと、タイムスタンプなどのフィルタリングに使用されるスカラーフィールドです。トランスクリプト、オーディオ、平文がPlaudの外に出ることは決してありません。顧客管理の暗号化キー(CMEK)と組み合わせることで、Plaudはユーザープライバシーに対して強力で検証可能な制御を得られます。
関連性の制御をPlaudに委ねるマネージド基盤。 Zilliz Cloudは、大規模な分散ベクトルストレージと検索という難しい部分を処理します。一方、Plaudは製品を差別化する部分(スパースベクトルとデンスベクトルの構築方法、マルチウェイリコールの実行、結果の融合とランキング)を保持します。
ソリューション
Plaud において、Zilliz Cloud は ContextOS を支える検索レイヤーであり、生の録音データを使えるメモリへ変換するシステムです。音声から回答に至る経路は、次の4つのステージで構成されています:
- キャプチャと前処理 — ユーザーが録音を終了すると、ファイルは Plaud のファイルシステムに入り、必要に応じて前処理が行われます(例:AIモデルによる音声テキスト変換やテキストの埋め込み化)。
- 理解と保存 — ContextOS はコンテンツを処理し、生のテキストではなく、セマンティックベクトルとスカラーフィルターフィールドとして Zilliz Cloud に書き込みます。
- 意図に基づく検索 — ユーザーが検索したり Plaud に質問したりすると、エージェントが意図を解釈してベクトルにエンコードし、Zilliz Cloud をバックエンドとする ContextOS から最も関連性の高いコンテキストを取得します。
- 生成 — 取得したコンテキストに基づいて、エージェントの回答が構成されます。
この基盤の上で、Zilliz Cloud は次の3つのプロダクトシナリオを支えています:
- 検索 — ユーザー自身の録音全体を横断検索。
- Ask Plaud(RAG) — 文字起こしとサマリーに基づく回答。
- MAG(Memory-Augmented Generation) — 長期的な個人メモリに基づく回答。
エンジニアリングの詳細:エージェントメモリ向けに設計
エージェントメモリは、静的なドキュメントセットに対する従来のRAGではありません。それは継続的に成長するユーザーごとの生きたコンテキストであり、新鮮でフィルタリング可能で、プライベートであることが求められます。この基準を満たすには特別なエンジニアリングが必要でした。以下は、Plaud チームが強調する機能です。
数十億規模の履歴データのバックフィルを、サービスを稼働させたまま実行
メモリプロダクトを成長させるには、大量の履歴データを絶えずロードし、再形成する必要があります。しかも、それに依存するユーザーの検索をオフラインにすることはできません。Zilliz Cloud により、Plaud は数十億規模の履歴バックフィルをオフラインバッチジョブとして数日で完了させ、その間も本番サービスは完全に読み取り可能な状態を維持します。大規模なメモリセットは、メンテナンスウィンドウなしで本番環境にデプロイされます。
ダウンタイムゼロのスキーマ進化とアップグレード
変化の激しいコンシューマーアプリは常に変更されます:保存すべき新しいメモリ属性、フィルタリングや検索対象の新しいフィールド、採用すべき新しいインデックスやエンジンバージョンなど。Zilliz Cloud により、Plaud は動的カラムの追加、新しいテキストフィールドでのキーワード(BM25)検索の有効化、インデックスとクラスタのアップグレードの展開を、すべてダウンタイムなしで行えます。Plaud は製品を出荷し続けながら、グローバルアプリは常時稼働を維持します。
データ居住性を備えたグローバルマルチリージョン
Plaud のユーザーは北米、ヨーロッパ、アジア太平洋に広がっており、データの高速性と地域内保存の両方を期待しています。Zilliz Cloud のネイティブなマルチリージョンサポートにより、Plaud は各ユーザーのメモリを、データ居住性と低レイテンシーを満たす適切なリージョンに配置できます。クロスクラスタのプライマリキー一意性により、これは大規模でも安全です — ユーザーとそのデータはリージョナルクラスタ間を移動でき、キーはグローバルに一意のままです — また、ダウンタイムゼロのレプリケーションにより、移行はユーザーから見えません。
メモリを意識したハイブリッド検索
個人メモリにおいて、最適な一致は必ずしも最も意味的に類似したものではありません。最近のメモは古いメモよりも重要であることが多く、サマリーは生の文字起こしよりも有用であることがよくあります。Zilliz Cloud のハイブリッド検索は、セマンティック検索とキーワード検索を、減衰ランキングとドキュメントタイプの重み付けと組み合わせるため、Ask Plaud とそのエージェントは、関連性があるだけでなく、タイムリーで適切な種類のメモリを表面化できます。
これらの主要な取り組みに加えて、Plaud のワークロードは、本番グレードのエージェントメモリシステムに必要な一連の基盤機能に依存しています:
| 機能 | Plaudにとって重要な理由 |
|---|---|
| ベクトル検索との条件付きスカラーフィルタリング | 個人メモリは常にユーザーとメタデータにスコープされるため、フィルタリングはセマンティック検索と一緒にフルスピードで実行される必要があります |
| 読み取り/書き込みの分離 | 継続的な大量取り込みが、低レイテンシのクエリと並行して実行され、互いのパフォーマンスを低下させません |
| 顧客管理暗号化 (CMEK) | Plaudとそのユーザーが鍵を保持します。鍵を失効させると、データはもはや復号化できません |
| コールド/ホット階層化 | ロングテールな「コールド」メモリは、保持コストを低く抑えられ、アクセス時に自動的に再ウォームされます |
| マネージドバックアップとリカバリ | データセット全体のバックアップは、本番クエリのパフォーマンスにほとんど影響を与えずに実行されます |
| 弾力性のあるキャパシティスケーリング | システムを再設計することなく、ユーザーベースに合わせてキャパシティが拡張されます |
結果と利点
- 大規模な低レイテンシ検索 — Recallは平均200ms未満、P99で800ms未満で返され、データが数十億に成長しても、エンドツーエンドのAsk AIパイプラインが応答性を維持できる余裕を生みます。
- 再設計不要の数十億ベクトル — Plaudはリージョンごとに数億から数十億のチャンクへと成長し、同じ基盤の上で数百億への明確な道筋もあります。検索がボトルネックになることはありません。
- 迅速なデータ運用、ゼロダウンタイム — 数十億規模の履歴バックフィルは数日で完了し、スキーマおよびクラスターのアップグレードはゼロダウンタイムで実行されるため、チームは常時稼働のグローバルアプリで継続的にリリースできます。
- グローバルなコンプライアンスとパフォーマンス — ネイティブなマルチリージョン展開により、各ユーザーのデータがリージョン内に保持され、データ居住要件を満たしつつ、世界中のユーザーに低レイテンシを提供します。
- 運用オーバーヘッドの削減 — フルマネージドサービスにより、セルフランのクラスター(セットアップ、チューニング、スケーリング、オンコール)の隠れたコストがなくなり、エンジニアリングはインフラではなく製品に集中できます。
最も明確な利点は戦略的なものです。信頼性が高くスケーラブルな基盤により、Plaudのエンジニアは 「インフラはもつのか?」 から、再び 「製品はどこまで良くできるのか?」 に注意を向けることができます。これにより、より大規模なセマンティックメモリ、より高度な検索戦略、そしてより迅速な機能開発が可能になります。
消費者向けAIシステムを構築するチームへのPlaudのアドバイス
成長曲線をすべて経験したPlaudのチームは、AIレコーディング、パーソナルAIメモリ、その他の消費者向けAI製品を構築するチームに向けて、4つの教訓を提供しています。
- 最終的な規模に見合ったインフラを選ぶ。 消費者向け製品が軌道に乗ると、データは数億から数十億のチャンクに跳ね上がります。スムーズにスケールする目的特化型エンジンを選び、後で高価な移行を避けましょう。
- スカラーフィルタリングとセマンティック検索を一緒にテストする。 条件付きフィルタリングとセマンティック検索の組み合わせは、実際のAIアプリケーションにおけるベクターエンジンの最も現実的であり、最も要求の厳しいテストです。
- 運用コストを帳簿に計上する。 セルフマネージドのシャーディング、スケーリング、オンコールは隠れた高コストです。フルマネージドオプションはそれらをゼロにし、チームは製品に集中できます。
- グローバル展開とコンプライアンスを早期に計画する。 グローバルなユーザーベースにとって、データ居住性とマルチリージョンの低レイテンシは、予想より早く厳格な要件になります。
今後の展望
Plaudは、Zilliz Cloudの利用を、現在のAgentic RAGとエージェントメモリから、エージェントコンテキストエンジニアリングにおける中心的な役割へと拡大する計画です。メモリレイヤーが数百億のベクトルへ、そしてその先へとスケールするにつれて。
"Plaudはまさに、コンシューマー向けAIのあるべき姿を再定義し、それを顕著なスピードで収益性高く実現している企業です。Zilliz CloudがPlaudの成功を支える検索基盤であることを誇りに思い、彼らがエージェンティックAIの次のステップへとスケールしていく中で、引き続き共に構築していけることを楽しみにしています。"
— Zilliz 最高技術責任者(CTO)James Luan
Zilliz Cloudを無料でお試しください
Zilliz Cloud は、エンタープライズ AI 向けの完全マネージド型ベクターデータベースおよびベクターレイクベースであり、Milvus APIs と互換性があります。高性能、エンタープライズグレードのセキュリティ、ゼロメンテナンス運用で、1000億規模のベクター検索を提供します。現在では、マルチモーダルデータレイクのオープン性、スケーラビリティ、経済性も備え、企業は本番 AI 向けの非構造化データを検索・分析・管理するための単一プラットフォームを手にすることができます。
RAG のスケーリングでも、エージェントメモリの構築でも、Zilliz Cloud は Plaud を支える同じ検索基盤を提供します。今すぐ Zilliz Cloud を無料で始める または チームに相談する。
Pick for the scale you'll end up at, not the one you have. Consumer data grows faster than anyone plans for, and a migration at that size is painful. Hand the retrieval infrastructure to specialists, and spend your own people on the product
The engineering team, Plaud