




Plaud обеспечивает память агентов миллиардного масштаба с помощью Zilliz Cloud
< 200 ms
Средняя задержка воспроизведения
10 млрд+
Векторные чанки на регион, с возможностью роста.
В дни
Обратное заполнение исторических данных в масштабе миллиардов без остановки сервиса
Нулевое время простоя
Изменения схемы и обновления кластера в постоянно работающем приложении
ИИ переходит от ответов на разовые вопросы к агентам, которые запоминают, что делает память ИИ сердцем потребительских ИИ-продуктов. Zilliz Cloud дает нам надежный фундамент, которому мы доверяем для агентного поиска в памяти в огромных масштабах, поэтому наша команда может сосредоточить энергию на инновациях продуктов и пользовательском опыте, а не на инфраструктуре под этим.
Charles Liu
О Plaud
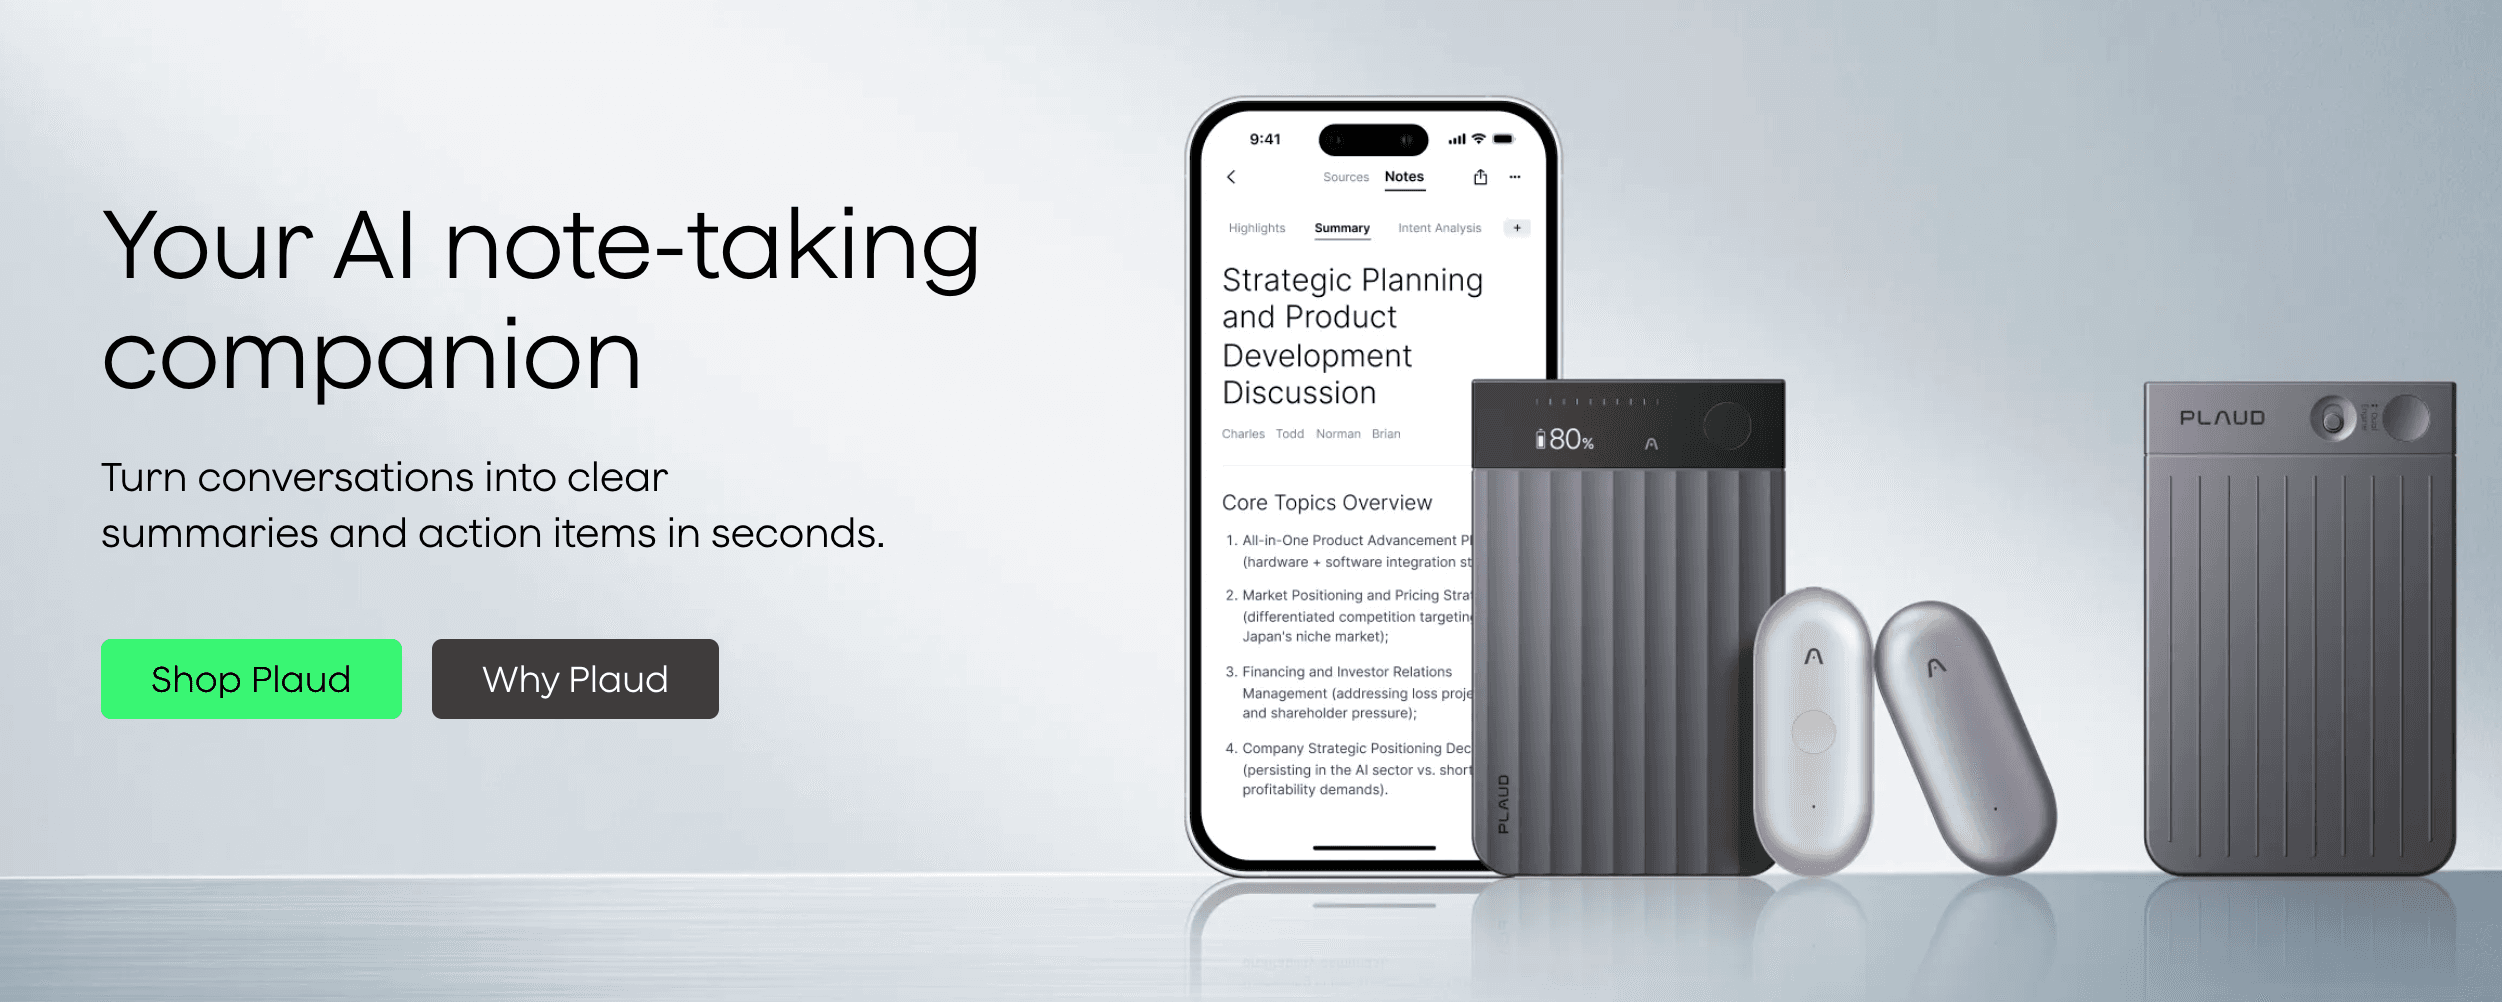
Plaud — мировой бренд №1 в области AI-заметок. Его аппаратное обеспечение — AI-записывающие устройства размером с кредитную карту Plaud Note, Plaud Note Pro и носимое устройство Plaud NotePin S — работает вместе с Plaud Intelligence (доступной в приложении, веб-версии и на десктопе), превращая повседневные разговоры в сводки, пункты задач и бизнес-ценность. Менее чем за три года Plaud стала одной из ключевых компаний в сфере потребительского AI-оборудования: она поставила более 2 миллионов устройств в более чем 170 стран и выросла с $1M до более чем $100M годовой регулярной выручки примерно за два года.
За этим опытом стоит более сложная задача, чем кажется. Каждая запись становится долговременной личной памятью, по которой пользователь ожидает мгновенно искать и задавать вопросы, — в масштабах быстро растущей глобальной пользовательской базы. Хранение и извлечение этой памяти в масштабе — задача, которую Plaud доверяет Zilliz Cloud.
Задача
AI-память потребительского масштаба — одна из самых требовательных рабочих нагрузок на поиск в производстве. Plaud изначально построила свой поиск на OpenSearch, который хорошо справлялся с поиском и журналами. Но когда рабочая нагрузка сместилась в сторону семантического и гибридного поиска миллиардного масштаба, производительность и стоимость OpenSearch при таком масштабе больше не выдерживали. Замена этой основы означала необходимость одновременно справиться с тремя факторами.
Взрывной рост данных потребительского масштаба. По мере ускорения внедрения по всему миру векторизованная память Plaud выросла с сотен миллионов до миллиардов чанков на регион, приближаясь к десяткам миллиардов. Каждая запись также генерирует богатые скалярные метаданные, используемые для фильтрации и ранжирования, а потребительский продукт создает огромный «длинный хвост» «холодной» памяти — данные, которые пользователь может игнорировать месяцами, а затем они внезапно могут понадобиться, — и эти данные должны оставаться недорогими для хранения, не замедляя активные запросы.
Семантическая агентная нагрузка — не просто поиск по ключевым словам. Основной сценарий использования Plaud — это Agentic RAG и память: извлечение, движимое смыслом, в миллиардном масштабе, питающее Ask Plaud и его агентов. Это требует по-настоящему высокопроизводительного векторного поиска в сочетании с условной скалярной фильтрацией, а также интенсивных непрерывных операций записи, работающих параллельно с чтением с низкой задержкой, без взаимных помех. Релевантность также должна учитывать тип контента и давность — сводка должна перевешивать сырую расшифровку, а недавние воспоминания должны появляться первыми.
Глобальная, постоянно работающая и созданная для чувствительных персональных данных. Глобальная пользовательская база делает многорегиональное развертывание и резидентность данных жесткими требованиями. Поскольку записи носят глубоко личный характер, платформе требуется шифрование, управляемое клиентом, и модель, в которой ни один открытый текст никогда не покидает Plaud. А поскольку продукт выпускается непрерывно, слой поиска сам должен развиваться — новые поля, новые индексы, обновления версий — без простоев.
Почему Zilliz Cloud
Plaud выбрала Zilliz Cloud в качестве основы для этой рабочей нагрузки по трем причинам.
Проверенная производительность и стабильность в миллиардном масштабе. Plaud требовался движок, который остается быстрым и стабильным, когда данные разрастаются до миллиардов в реальной эксплуатации, а не в бенчмарке. Распределенная архитектура Zilliz Cloud поддерживает высокопроизводительный поиск и высокопропускную запись в масштабе, при этом операции чтения и записи изолированы, чтобы задержка оставалась предсказуемой по мере роста нагрузки.
Модель конфиденциальности, которая сохраняет пользовательский контент у Plaud. Plaud отправляет в Zilliz Cloud только то, что необходимо для поиска, — семантические векторы и скалярные поля, используемые для фильтрации, например временные метки. Ни транскрипты, ни аудио, ни открытый текст никогда не покидают Plaud. В сочетании с управляемыми клиентом ключами шифрования (CMEK) это дает Plaud сильный и проверяемый контроль над конфиденциальностью пользователей.
Управляемая основа, оставляющая контроль над релевантностью за Plaud. Zilliz Cloud берет на себя сложную часть — распределенное векторное хранение и извлечение в масштабе, — а Plaud сохраняет то, что отличает ее продукт: как она строит разреженные и плотные векторы, выполняет многоканальный поиск, а также объединяет и ранжирует результаты.
Решение
Внутри Plaud Zilliz Cloud — это уровень поиска, обеспечивающий работу ContextOS — системы, которая превращает сырые записи в полезную память. Путь от голоса до ответа проходит четыре этапа:
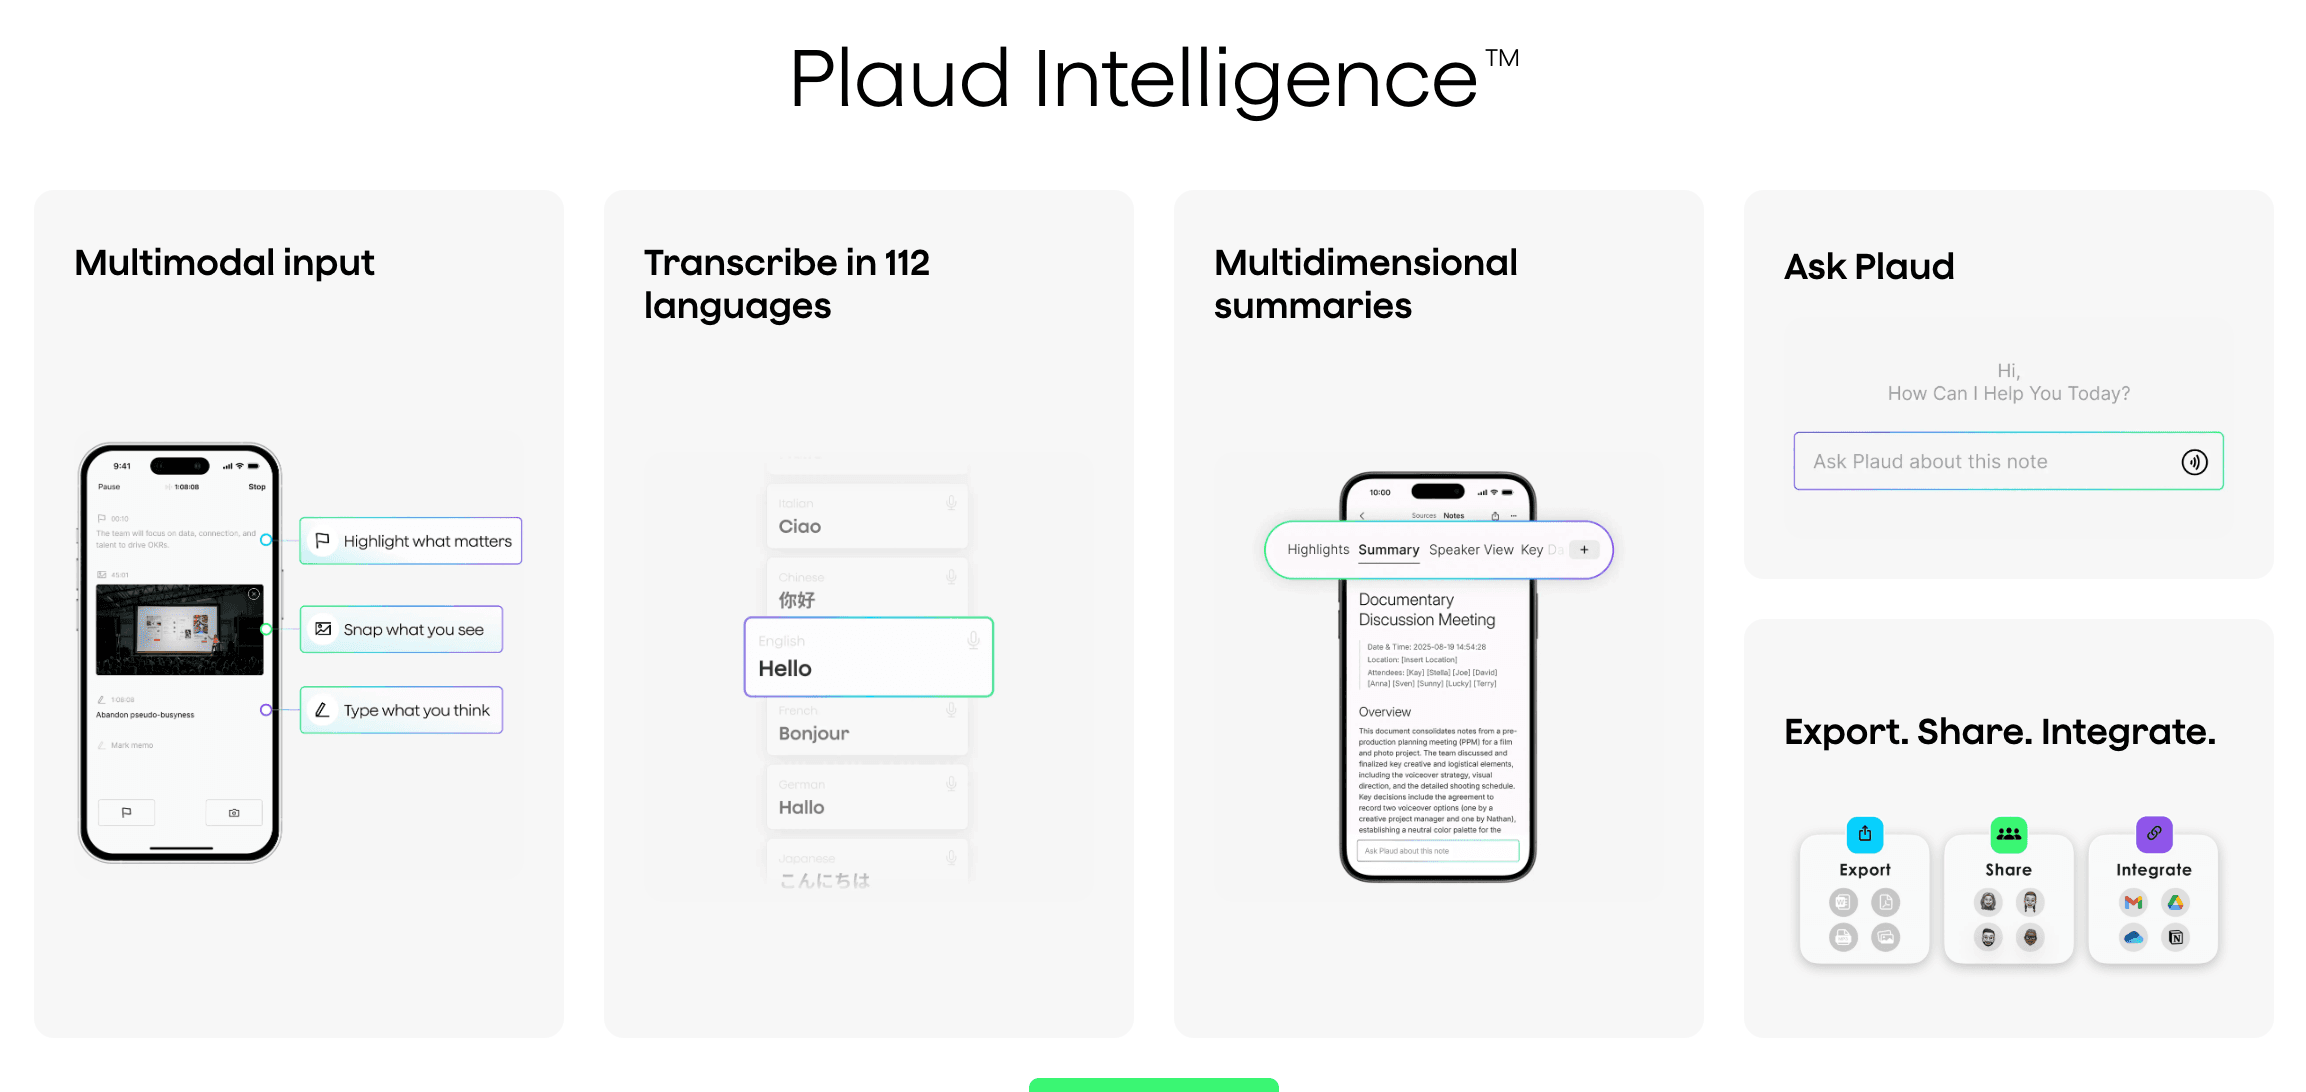
- Захват и предобработка — Пользователь завершает запись; файл попадает в файловую систему Plaud и проходит необходимую предобработку (например, распознавание речи и преобразование текста в эмбеддинги с помощью моделей ИИ).
- Понимание и хранение — ContextOS обрабатывает содержимое и записывает его в Zilliz Cloud в виде семантических векторов и полей скалярных фильтров — никогда не в виде сырого текста.
- Поиск по намерению — Когда пользователь ищет что-то или задаёт вопрос Plaud, агент интерпретирует намерение, кодирует его в векторы и извлекает наиболее релевантный контекст из ContextOS на базе Zilliz Cloud.
- Генерация — Извлечённый контекст служит основой для ответа агента.
На этом фундаменте Zilliz Cloud обеспечивает три продуктовых сценария:
- Поиск по собственным записям пользователя;
- Ask Plaud (RAG) — ответы, основанные на расшифровках и сводках;
- MAG (Memory-Augmented Generation) — ответы, основанные на долговременной личной памяти.
Инженерный анализ: создано для памяти агентов
Память агента — это не классический RAG по статическому набору документов. Это живой контекст для каждого пользователя, который постоянно растёт и должен оставаться актуальным, фильтруемым и приватным. Достичь этого уровня помогла особая инженерная работа — вот возможности, которые выделяет команда Plaud.
Обратная загрузка исторических данных миллиардного масштаба при работающем сервисе
Рост продукта памяти означает постоянную загрузку и преобразование больших объёмов исторических данных — без отключения поиска для пользователей, которые зависят от него. С помощью Zilliz Cloud Plaud выполняет историческую обратную загрузку миллиардного масштаба как офлайн-пакетные задания, которые завершаются за дни, при этом живой сервис остаётся полностью доступным для чтения. Огромные массивы памяти разворачиваются в продакшене без окна технического обслуживания.
Эволюция схемы и обновления без простоев
Быстро развивающееся потребительское приложение постоянно меняется: новые атрибуты памяти для хранения, новые поля для фильтрации и поиска, новые версии индексов и движков для внедрения. Zilliz Cloud позволяет Plaud добавлять динамические столбцы, включать поиск по ключевым словам (BM25) по новым текстовым полям и проводить обновления индексов и кластеров — всё без простоев. Plaud продолжает выпускать обновления, пока глобальное приложение остаётся всегда доступным.
Глобальная мультирегиональность с соблюдением требований к размещению данных
Пользователи Plaud находятся в Северной Америке, Европе и Азиатско-Тихоокеанском регионе и ожидают, что их данные будут и быстрыми, и хранящимися в соответствующем регионе. Встроенная мультирегиональная поддержка Zilliz Cloud позволяет Plaud размещать память каждого пользователя в нужном регионе для соблюдения требований и низкой задержки. Уникальность первичных ключей между кластерами делает это безопасным в масштабе — пользователи и их данные могут перемещаться между региональными кластерами, а ключи остаются глобально уникальными, — а репликация без простоев делает миграцию незаметной для пользователей.
Гибридный поиск с учётом памяти
В личной памяти лучший результат — это не всегда наиболее семантически похожий: свежая заметка обычно важнее старой, а сводка часто полезнее сырой расшифровки. Гибридный поиск Zilliz Cloud сочетает семантический и ключевой поиск с ранжированием по убыванию и взвешиванием типа документа, поэтому Ask Plaud и его агенты выдают память, которая не просто релевантна, но и своевременна, и нужного типа.
Помимо этих ключевых направлений, нагрузка Plaud опирается на набор базовых возможностей, необходимых любой продакшн-системе памяти агентов:
| Возможность | Почему это важно для Plaud |
|---|---|
| Условная скалярная фильтрация вместе с векторным поиском | Личная память всегда привязана к пользователю и метаданным, поэтому фильтрация должна работать вместе с семантическим поиском на полной скорости |
| Изоляция чтения и записи | Непрерывная высокообъёмная загрузка данных работает одновременно с низкозадержными запросами, не снижая производительность друг друга |
| Управляемое клиентом шифрование (CMEK) | Plaud и его пользователи хранят ключи; отзовите ключ — и данные больше нельзя будет расшифровать |
| Холодное/горячее многоуровневое хранение | «Холодная» память длинного хвоста остаётся недорогой в хранении и автоматически «прогревается» при обращении |
| Управляемое резервное копирование и восстановление | Полное резервное копирование данных выполняется с пренебрежимо малым влиянием на производительность живых запросов |
| Эластичное масштабирование ёмкости | Ёмкость растёт вместе с пользовательской базой без изменения архитектуры системы |
Результаты и преимущества
- Низкозадержный поиск в масштабе — поиск возвращает результаты в среднем менее чем за 200 мс и менее чем за 800 мс на уровне P99, что даёт сквозному конвейеру Ask AI запас для отзывчивости даже при росте данных до миллиардов.
- Миллиарды векторов без изменения архитектуры — Plaud вырос от сотен миллионов до миллиардов чанков на регион, с понятным путём к десяткам миллиардов, всё на том же фундаменте и без превращения поиска в узкое место.
- Более быстрые операции с данными, нулевое время простоя — исторические бэкфиллы миллиардного масштаба выполняются за дни, а обновления схемы и кластера проходят без простоев, поэтому команда непрерывно выпускает обновления глобального приложения, работающего 24/7.
- Глобальное соответствие требованиям и производительность — нативное мультирегиональное развёртывание хранит данные каждого пользователя в его регионе, удовлетворяя требованиям к резидентности данных и обеспечивая низкую задержку для пользователей по всему миру.
- Снижение операционных издержек — полностью управляемый сервис устраняет скрытые затраты на самостоятельно развёрнутые кластеры (настройку, оптимизацию, масштабирование и дежурства), поэтому инженеры фокусируются на продукте, а не на инфраструктуре.
Самое очевидное преимущество — стратегическое: надёжная и масштабируемая основа позволяет инженерам Plaud переключить внимание с вопроса "выдержит ли инфраструктура?" обратно на "насколько хорошим может быть продукт?" — что открывает путь к более объёмной семантической памяти, более совершенным стратегиям поиска и более быстрой итерации функций.
Советы Plaud командам, создающим потребительские AI-системы
Пройдя весь цикл роста, команда Plaud предлагает четыре урока для тех, кто создаёт AI-запись, личную AI-память или другие потребительские AI-продукты:
- Выбирайте инфраструктуру под свой конечный масштаб. Как только потребительский продукт взлетает, данные прыгают от сотен миллионов до миллиардов чанков. Выбирайте специализированный движок, который плавно масштабируется, и избегайте одной дорогой миграции в будущем.
- Тестируйте скалярную фильтрацию и семантический поиск вместе. Условная фильтрация в сочетании с семантическим поиском — самый реалистичный и самый требовательный тест векторного движка для реальных AI-приложений.
- Учитывайте операционные расходы в своих расчётах. Самостоятельное шардирование, масштабирование и дежурства — это скрытые и высокие издержки. Полностью управляемый вариант сводит их к нулю, позволяя команде сосредоточиться на продукте.
- Планируйте глобальный охват и соответствие требованиям заранее. Для глобальной пользовательской базы резидентность данных и низкая задержка в нескольких регионах становятся жёсткими требованиями раньше, чем вы ожидаете.
Что дальше
Plaud планирует расширить использование Zilliz Cloud — от сегодняшних Agentic RAG и памяти агентов до центральной роли в инженерии контекста агентов, поскольку его уровень памяти масштабируется до десятков миллиардов векторов и далее.
«Plaud — именно та компания, которая переопределяет возможности потребительского AI — и делает это прибыльно, с поразительной скоростью. Мы гордимся тем, что Zilliz Cloud является поисковой основой успеха Plaud, и рады продолжать совместную работу по мере их масштабирования к следующему этапу агентного AI.»
— Джеймс Луан, технический директор Zilliz
Попробуйте Zilliz Cloud бесплатно
Zilliz Cloud — это полностью управляемая векторная база данных и Vector Lakebase для корпоративного ИИ, совместимые с API Milvus. Платформа обеспечивает векторный поиск в масштабе ста миллиардов с высокой производительностью, безопасностью корпоративного уровня и эксплуатацией без технического обслуживания. Расширенная теперь за счет открытости, масштабируемости и экономичности мультимодальных озер данных, она предоставляет предприятиям единую платформу для поиска, анализа и управления неструктурированными данными для производственного ИИ.
Независимо от того, масштабируете ли вы RAG или создаете память для агентов, Zilliz Cloud предоставляет ту же поисковую основу, которая лежит в основе Plaud. Начните работать с Zilliz Cloud бесплатно прямо сейчас или свяжитесь с нашей командой.
Выбирайте масштаб, к которому вы придёте, а не тот, что у вас сейчас. Потребительские данные растут быстрее, чем кто-либо планирует, а миграция в таких масштабах — это боль. Передайте инфраструктуру поиска специалистам, а своих людей займите продуктом.
The engineering team, Plaud