Plaud propulse la mémoire d'agent à l'échelle du milliard avec Zilliz Cloud.
< 200 ms
Latence moyenne de rappel
10B+
Chunks vectoriels par région, avec de la marge pour évoluer
Dans les jours
Remontée de données historiques à l’échelle du milliard, sans interruption de service
Zéro temps d’arrêt
Modifications de schéma et mises à niveau de cluster sur une application toujours active
L'IA passe de la réponse à des questions ponctuelles à des agents dotés de mémoire, ce qui fait de la mémoire IA le cœur des produits grand public basés sur l'IA. Zilliz Cloud nous offre une base solide et fiable pour la récupération de mémoire agentique à très grande échelle, ce qui permet à notre équipe de concentrer son énergie sur l'innovation produit et l'expérience utilisateur, plutôt que sur l'infrastructure sous-jacente.
Charles Liu
À propos de Plaud
Plaud est la marque n°1 mondiale de prise de notes par IA. Son matériel — les assistants de prise de notes par IA de la taille d'une carte de crédit Plaud Note, Plaud Note Pro, et le dispositif portable Plaud NotePin S — fonctionne avec Plaud Intelligence (disponible sur application, web, bureau) pour transformer les conversations quotidiennes en résumés, tâches et valeur commerciale. En moins de trois ans, Plaud est devenue l'une des entreprises les plus marquantes du matériel IA grand public : elle a expédié plus de 2 millions d'appareils dans plus de 170 pays et a fait passer son chiffre d'affaires récurrent annuel de $1M à plus de $100M en environ deux ans.
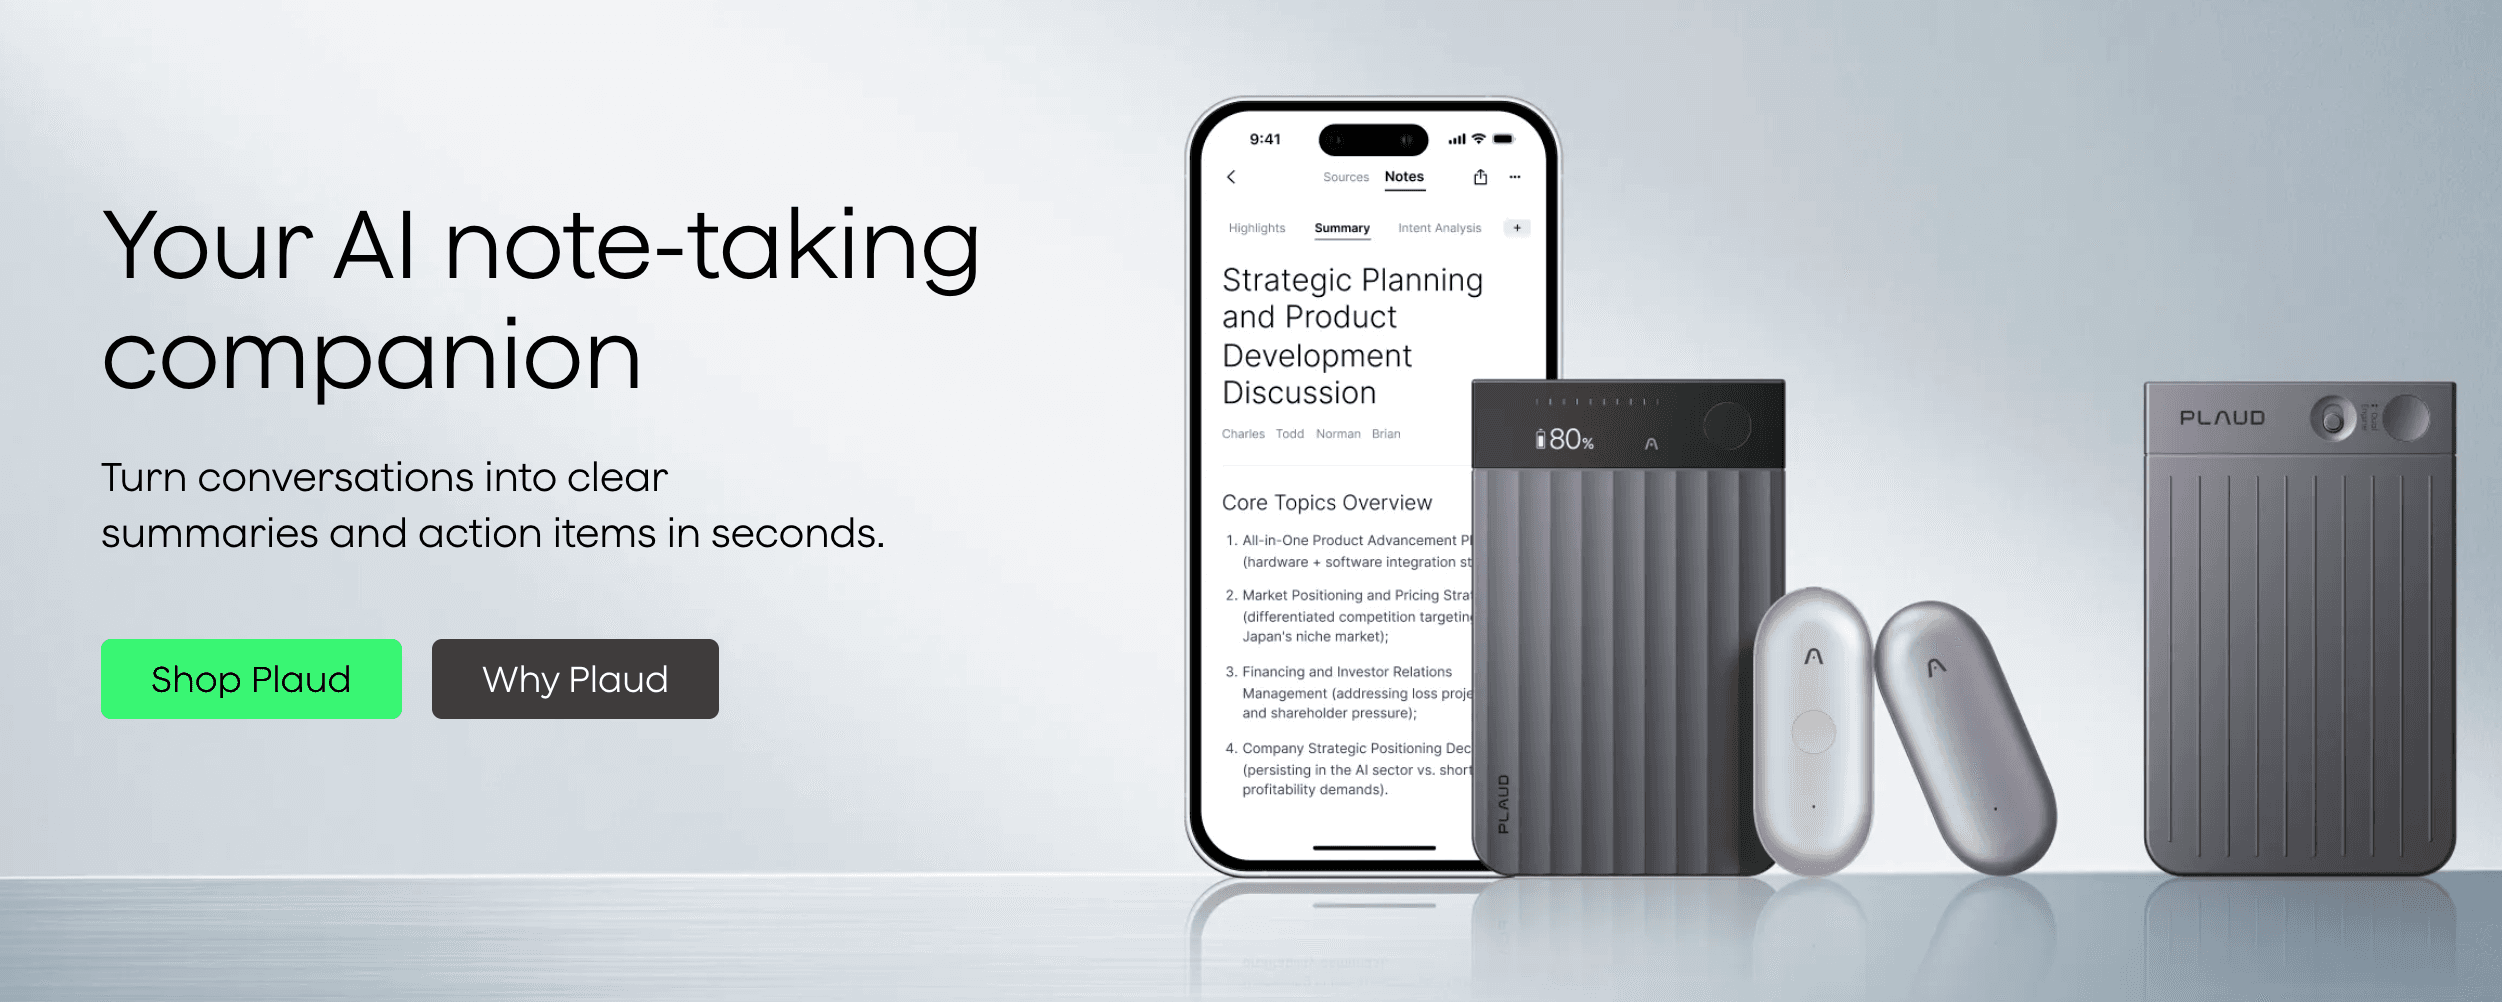
Derrière cette expérience se cache une tâche plus ardue qu'il n'y paraît. Chaque enregistrement devient une mémoire personnelle durable que l'utilisateur s'attend à pouvoir interroger et parcourir instantanément — multipliée par une base d'utilisateurs mondiale en forte croissance. Stocker et récupérer cette mémoire à grande échelle est la mission que Plaud confie à Zilliz Cloud.
Le défi
La mémoire IA à l'échelle grand public est l'une des charges de travail de récupération les plus exigeantes en production. Plaud a d'abord construit sa recherche sur OpenSearch, qui gérait bien la recherche et les journaux. Mais à mesure que la charge évoluait vers la recherche sémantique et hybride à l'échelle du milliard, les performances de récupération et le coût d'OpenSearch à cette échelle ne pouvaient plus suivre. Remplacer cette fondation signifiait résoudre trois forces à la fois.
- Croissance explosive des données à l'échelle grand public. Alors que l'adoption s'accélérait dans le monde entier, la mémoire vectorisée de Plaud est passée de centaines de millions à des milliards de segments par région, approchant les dizaines de milliards. Chaque enregistrement génère également de riches métadonnées scalaires utilisées pour le filtrage et le classement, et un produit grand public produit une énorme « mémoire froide » de longue traîne — des données qu'un utilisateur peut ignorer pendant des mois, puis dont il a soudainement besoin — qui doivent rester peu coûteuses à conserver sans ralentir les requêtes actives.
- Une charge de travail sémantique et agentique — pas seulement une recherche par mots-clés. Le cas d'usage principal de Plaud est le RAG agentique et la mémoire : une récupération guidée par le sens, à l'échelle du milliard, qui alimente Ask Plaud et ses agents. Cela exige une véritable recherche vectorielle haute performance combinée à un filtrage scalaire conditionnel, ainsi que des écritures continues intensives qui coexistent avec des lectures à faible latence sans interférence. La pertinence doit également respecter le type de contenu et la récence — un résumé doit l'emporter sur une transcription brute, et la mémoire récente doit remonter en premier.
- Mondial, toujours actif et conçu pour les données personnelles sensibles. Une base d'utilisateurs mondiale fait du déploiement multi-région et de la résidence des données des exigences strictes. Parce que les enregistrements sont profondément personnels, la plateforme nécessite un chiffrement contrôlé par le client et un modèle dans lequel aucun texte en clair ne quitte jamais Plaud. Et parce que le produit est livré en continu, la couche de récupération elle-même doit évoluer — nouveaux champs, nouveaux index, mises à niveau de version — sans interruption de service.
Pourquoi Zilliz Cloud
Plaud a choisi Zilliz Cloud comme fondation pour cette charge de travail pour trois raisons.
Performance et stabilité éprouvées à l'échelle du milliard. Plaud avait besoin d'un moteur qui reste rapide et stable à mesure que les données atteignent des milliards en production réelle — pas dans un benchmark. L'architecture distribuée de Zilliz Cloud maintient une recherche haute performance et des écritures à haut débit à grande échelle, avec des lectures et des écritures isolées pour garder une latence prévisible à mesure que la charge augmente.
Un modèle de confidentialité qui conserve le contenu utilisateur chez Plaud. Plaud n'envoie à Zilliz Cloud que ce dont la récupération a besoin — les vecteurs sémantiques et les champs scalaires utilisés pour le filtrage, tels que les horodatages. Aucune transcription, aucun audio, aucun texte en clair ne quitte jamais Plaud. Associé à des clés de chiffrement gérées par le client (CMEK), cela donne à Plaud un contrôle fort et vérifiable sur la confidentialité des utilisateurs.
Une fondation gérée qui laisse à Plaud le contrôle de la pertinence. Zilliz Cloud gère la partie difficile — stockage et récupération vectoriels distribués à grande échelle — tandis que Plaud conserve les éléments qui différencient son produit : la manière dont il construit les vecteurs denses et épars, exécute le rappel multi-voies, et fusionne et classe les résultats.
La solution
Dans Plaud, Zilliz Cloud est la couche de récupération qui alimente ContextOS, le système qui transforme les enregistrements bruts en mémoire exploitable. Le chemin de la voix à la réponse se déroule en quatre étapes :
- Capture et prétraitement — Un utilisateur termine un enregistrement ; le fichier entre dans le système de fichiers de Plaud et est prétraité si nécessaire (par exemple, transcription vocale et transformation du texte en embeddings à l'aide de modèles d'IA).
- Comprendre et stocker — ContextOS traite le contenu et l'écrit dans Zilliz Cloud sous forme de vecteurs sémantiques et de champs de filtrage scalaires — jamais de texte brut.
- Récupération sur intention — Lorsque l'utilisateur recherche ou demande quelque chose à Plaud, un agent interprète l'intention, l'encode en vecteurs et récupère le contexte le plus pertinent depuis ContextOS, soutenu par Zilliz Cloud.
- Génération — Ce contexte récupéré fonde la réponse de l'agent.
Sur cette base, Zilliz Cloud alimente trois scénarios produit :
- Recherche dans les propres enregistrements d'un utilisateur ;
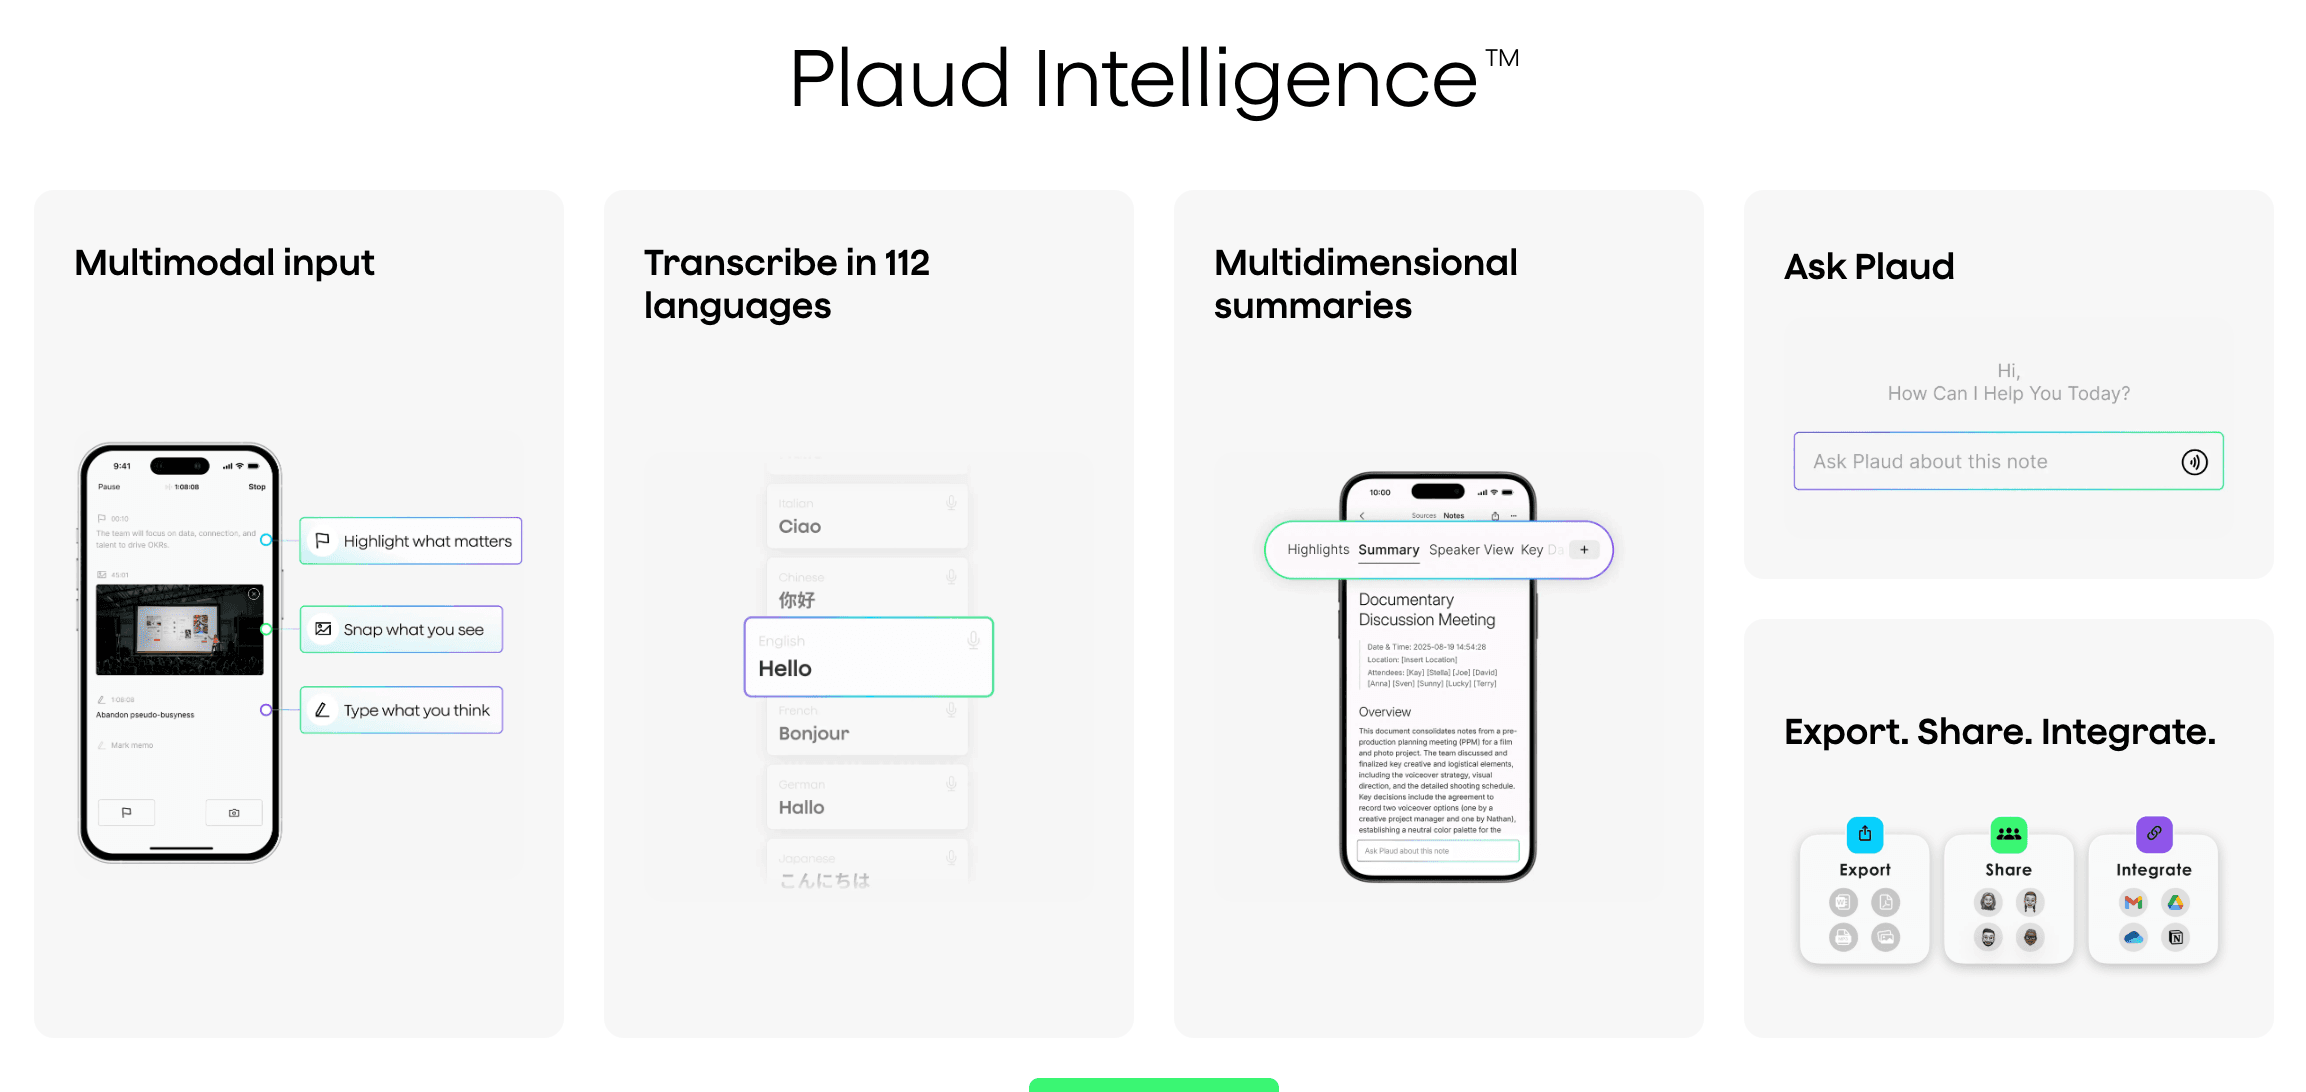
- Ask Plaud (RAG), des réponses fondées sur les transcriptions et les résumés ;
- MAG (Memory-Augmented Generation), des réponses fondées sur la mémoire personnelle à long terme.
Plongée technique : conçu pour la mémoire d'agent
La mémoire d'agent n'est pas un RAG classique sur un ensemble de documents statiques. C'est un contexte vivant, par utilisateur, qui croît continuellement et doit rester frais, filtrable et privé. Atteindre ce niveau a exigé une ingénierie spécifique — voici les capacités mises en avant par l'équipe Plaud.
Backfill historique à l'échelle du milliard, avec le service toujours actif
Faire croître un produit de mémoire signifie charger et remodeler constamment de grands volumes de données historiques — sans mettre la recherche hors ligne pour les utilisateurs qui en dépendent. Avec Zilliz Cloud, Plaud exécute des backfills historiques à l'échelle du milliard comme des tâches par lots hors ligne qui s'achèvent en quelques jours pendant que le service en direct reste entièrement lisible. Des ensembles de mémoire massifs sont déployés en production sans fenêtre de maintenance.
Évolution de schéma et mises à niveau sans interruption de service
Une application grand public qui évolue rapidement change constamment : de nouveaux attributs de mémoire à stocker, de nouveaux champs à filtrer et à rechercher, de nouvelles versions d'index et de moteur à adopter. Zilliz Cloud permet à Plaud d'ajouter des colonnes dynamiques, d'activer la recherche par mots-clés (BM25) sur de nouveaux champs texte, et de déployer des mises à niveau d'index et de cluster — le tout sans interruption de service. Plaud continue de livrer pendant qu'une application mondiale reste toujours disponible.
Multi-région mondial avec résidence des données
Les utilisateurs de Plaud se répartissent entre l'Amérique du Nord, l'Europe et l'Asie-Pacifique et s'attendent à ce que leurs données soient à la fois rapides et conservées dans leur région. Le support multi-région natif de Zilliz Cloud permet à Plaud de placer la mémoire de chaque utilisateur dans la bonne région pour la résidence et la faible latence. L'unicité des clés primaires entre clusters rend cela sûr à grande échelle — les utilisateurs et leurs données peuvent se déplacer entre les clusters régionaux tandis que les clés restent globalement uniques — et la réplication sans interruption de service rend la migration invisible pour les utilisateurs.
Récupération hybride tenant compte de la mémoire
Dans la mémoire personnelle, la meilleure correspondance n'est pas toujours la plus similaire sémantiquement : une note récente compte généralement plus qu'une ancienne, et un résumé est souvent plus utile qu'une transcription brute. La recherche hybride de Zilliz Cloud combine la récupération sémantique et par mots-clés avec un classement par décroissance temporelle et une pondération par type de document, de sorte que Ask Plaud et ses agents remontent une mémoire qui n'est pas seulement pertinente, mais aussi opportune et du bon type.
Au-delà de ces efforts phares, la charge de travail de Plaud s'appuie sur un ensemble de capacités fondamentales dont tout système de mémoire d'agent de niveau production a besoin :
| Capacité | Pourquoi c'est important pour Plaud |
|---|---|
| Filtrage scalaire conditionnel avec recherche vectorielle | La mémoire personnelle est toujours limitée à un utilisateur et à des métadonnées, le filtrage doit donc s'exécuter avec la recherche sémantique à pleine vitesse |
| Isolation lecture-écriture | L'ingestion continue à volume élevé s'exécute parallèlement aux requêtes à faible latence, sans que l'une ne dégrade l'autre |
| Chiffrement géré par le client (CMEK) | Plaud et ses utilisateurs détiennent les clés ; révoquez une clé et les données ne peuvent plus être déchiffrées |
| Niveaux de stockage à froid/chaud | La mémoire « froide » de longue traîne reste peu coûteuse à conserver et se réchauffe automatiquement à l'accès |
| Sauvegarde et restauration gérées | Les sauvegardes complètes de l'ensemble des données s'exécutent avec un impact négligeable sur les performances des requêtes en conditions réelles |
| Mise à l'échelle élastique de la capacité | La capacité croît avec la base d'utilisateurs sans réarchitecturer le système |
Résultats et avantages
- Récupération à faible latence à grande échelle — Le rappel renvoie les résultats en moins de 200 ms en moyenne et en moins de 800 ms au P99, laissant à la pipeline Ask AI de bout en bout la marge nécessaire pour rester réactive même lorsque les données comptent des milliards d'entrées.
- Des milliards de vecteurs sans réarchitecture — Plaud est passé de centaines de millions à des milliards de segments par région, avec une voie claire vers des dizaines de milliards, le tout sur la même base et sans que la récupération ne devienne un goulot d'étranglement.
- Des opérations de données plus rapides, zéro temps d'arrêt — Les backfills historiques à l'échelle du milliard sont terminés en quelques jours, et les mises à niveau de schéma et de cluster s'exécutent sans temps d'arrêt, ce qui permet à l'équipe de livrer en continu sur une application mondiale toujours disponible.
- Conformité et performances à l'échelle mondiale — Le déploiement natif multi-région conserve les données de chaque utilisateur dans sa région, satisfait aux exigences de résidence des données tout en offrant une faible latence aux utilisateurs du monde entier.
- Frais opérationnels réduits — Un service entièrement géré élimine le coût caché des clusters autogérés (installation, réglage, mise à l'échelle et astreinte), si bien que l'ingénierie se concentre sur le produit, pas sur la tuyauterie.
L'avantage le plus évident est stratégique : une base fiable et évolutive permet aux ingénieurs de Plaud de recentrer leur attention de « l'infrastructure tiendra-t-elle ? » vers « quelle qualité le produit peut-il atteindre ? » — ce qui permet une mémoire sémantique plus vaste, des stratégies de rappel plus sophistiquées et des itérations de fonctionnalités plus rapides.
Les conseils de Plaud aux équipes qui créent des systèmes d'IA grand public
Après avoir parcouru toute la courbe de croissance, l'équipe de Plaud offre quatre leçons aux équipes qui créent des solutions d'enregistrement IA, des mémoires personnelles IA ou d'autres produits d'IA grand public :
- Choisissez l'infrastructure en fonction de votre échelle cible. Dès qu'un produit grand public décolle, les données passent de centaines de millions à des milliards de segments. Choisissez un moteur spécialisé qui évolue en douceur et évitez une migration coûteuse par la suite.
- Testez ensemble le filtrage scalaire et la recherche sémantique. Le filtrage conditionnel combiné à la récupération sémantique est le test le plus réaliste — et le plus exigeant — d'un moteur vectoriel pour de vraies applications d'IA.
- Inscrivez les coûts opérationnels dans les comptes. Le sharding autogéré, la mise à l'échelle et l'astreinte sont des coûts cachés et élevés. Une option entièrement gérée les réduit à zéro afin que l'équipe puisse se concentrer sur le produit.
- Planifiez tôt la portée mondiale et la conformité. Pour une base d'utilisateurs mondiale, la résidence des données et la faible latence multi-région deviennent des exigences strictes plus tôt que vous ne le pensez.
Prochaines étapes
Plaud prévoit d'étendre son utilisation de Zilliz Cloud, qui couvre aujourd'hui le RAG agentique et la mémoire d'agent, jusqu'à un rôle central dans l'ingénierie de contexte de ses agents, à mesure que sa couche mémoire passe à l'échelle de dizaines de milliards de vecteurs et au-delà.
« Plaud est exactement le type d'entreprise qui redéfinit ce que l'IA grand public peut être — et qui le fait de manière rentable, à une vitesse remarquable. Nous sommes fiers que Zilliz Cloud soit la base de récupération qui sous-tend le succès de Plaud, et nous sommes ravis de continuer à construire ensemble à mesure qu'ils évoluent vers la prochaine étape de l'IA agentique. »
— James Luan, CTO de Zilliz
Essayez Zilliz Cloud gratuitement
Zilliz Cloud est une base de données vectorielle et un lakebase vectoriel entièrement gérés pour l'IA d'entreprise, compatible avec les API Milvus. Il offre une recherche vectorielle à l'échelle de centaines de milliards avec de hautes performances, une sécurité de niveau entreprise et des opérations sans maintenance. Désormais étendu avec l'ouverture, l'évolutivité et la rentabilité des data lakes multimodaux, il donne aux entreprises une plateforme unique pour rechercher, analyser et gouverner les données non structurées pour l'IA de production.
Que vous mettiez à l'échelle un RAG ou construisiez une mémoire d'agent, Zilliz Cloud fournit la même fondation de récupération qui alimente Plaud. Commencez gratuitement avec Zilliz Cloud dès maintenant ou parlez à notre équipe.
Choisissez en fonction de l'échelle que vous atteindrez, pas celle que vous avez. Les données des consommateurs croissent plus vite que personne ne le prévoit, et une migration à cette échelle est douloureuse. Confiez l'infrastructure de recherche à des spécialistes, et consacrez vos propres équipes au produit.
The engineering team, Plaud