Plaud impulsa memoria de agentes a escala de miles de millones con Zilliz Cloud
< 200 ms
Latencia media de recuperación
10 mil millones+
Fragmentos vectoriales por región, con margen de crecimiento.
En días.
Relleno de datos históricos a escala de miles de millones, sin interrupción del servicio
Cero tiempo de inactividad
Cambios de esquema y actualizaciones de clúster en una aplicación siempre activa
La IA está pasando de responder preguntas puntuales a agentes que recuerdan, lo que convierte la memoria de IA en el corazón de los productos de IA de consumo. Zilliz Cloud nos brinda una base sólida en la que podemos confiar para la recuperación de memoria de agentes a gran escala, de modo que nuestro equipo puede dedicar su energía a la innovación del producto y a la experiencia del usuario, no a la fontanería subyacente.
Charles Liu
Acerca de Plaud
Plaud es la marca número 1 del mundo en toma de notas con IA. Su hardware — los tomadores de notas con IA del tamaño de una tarjeta de crédito Plaud Note, Plaud Note Pro y el wearable Plaud NotePin S — funciona con Plaud Intelligence (disponible en app, web y escritorio) para convertir conversaciones cotidianas en resúmenes, tareas pendientes y valor de negocio. En menos de tres años, Plaud se ha convertido en una de las empresas definitorias del hardware de IA para consumidores: ha enviado más de 2 millones de dispositivos a más de 170 países y ha escalado de $1M a más de $100M en ingresos recurrentes anuales en aproximadamente dos años.
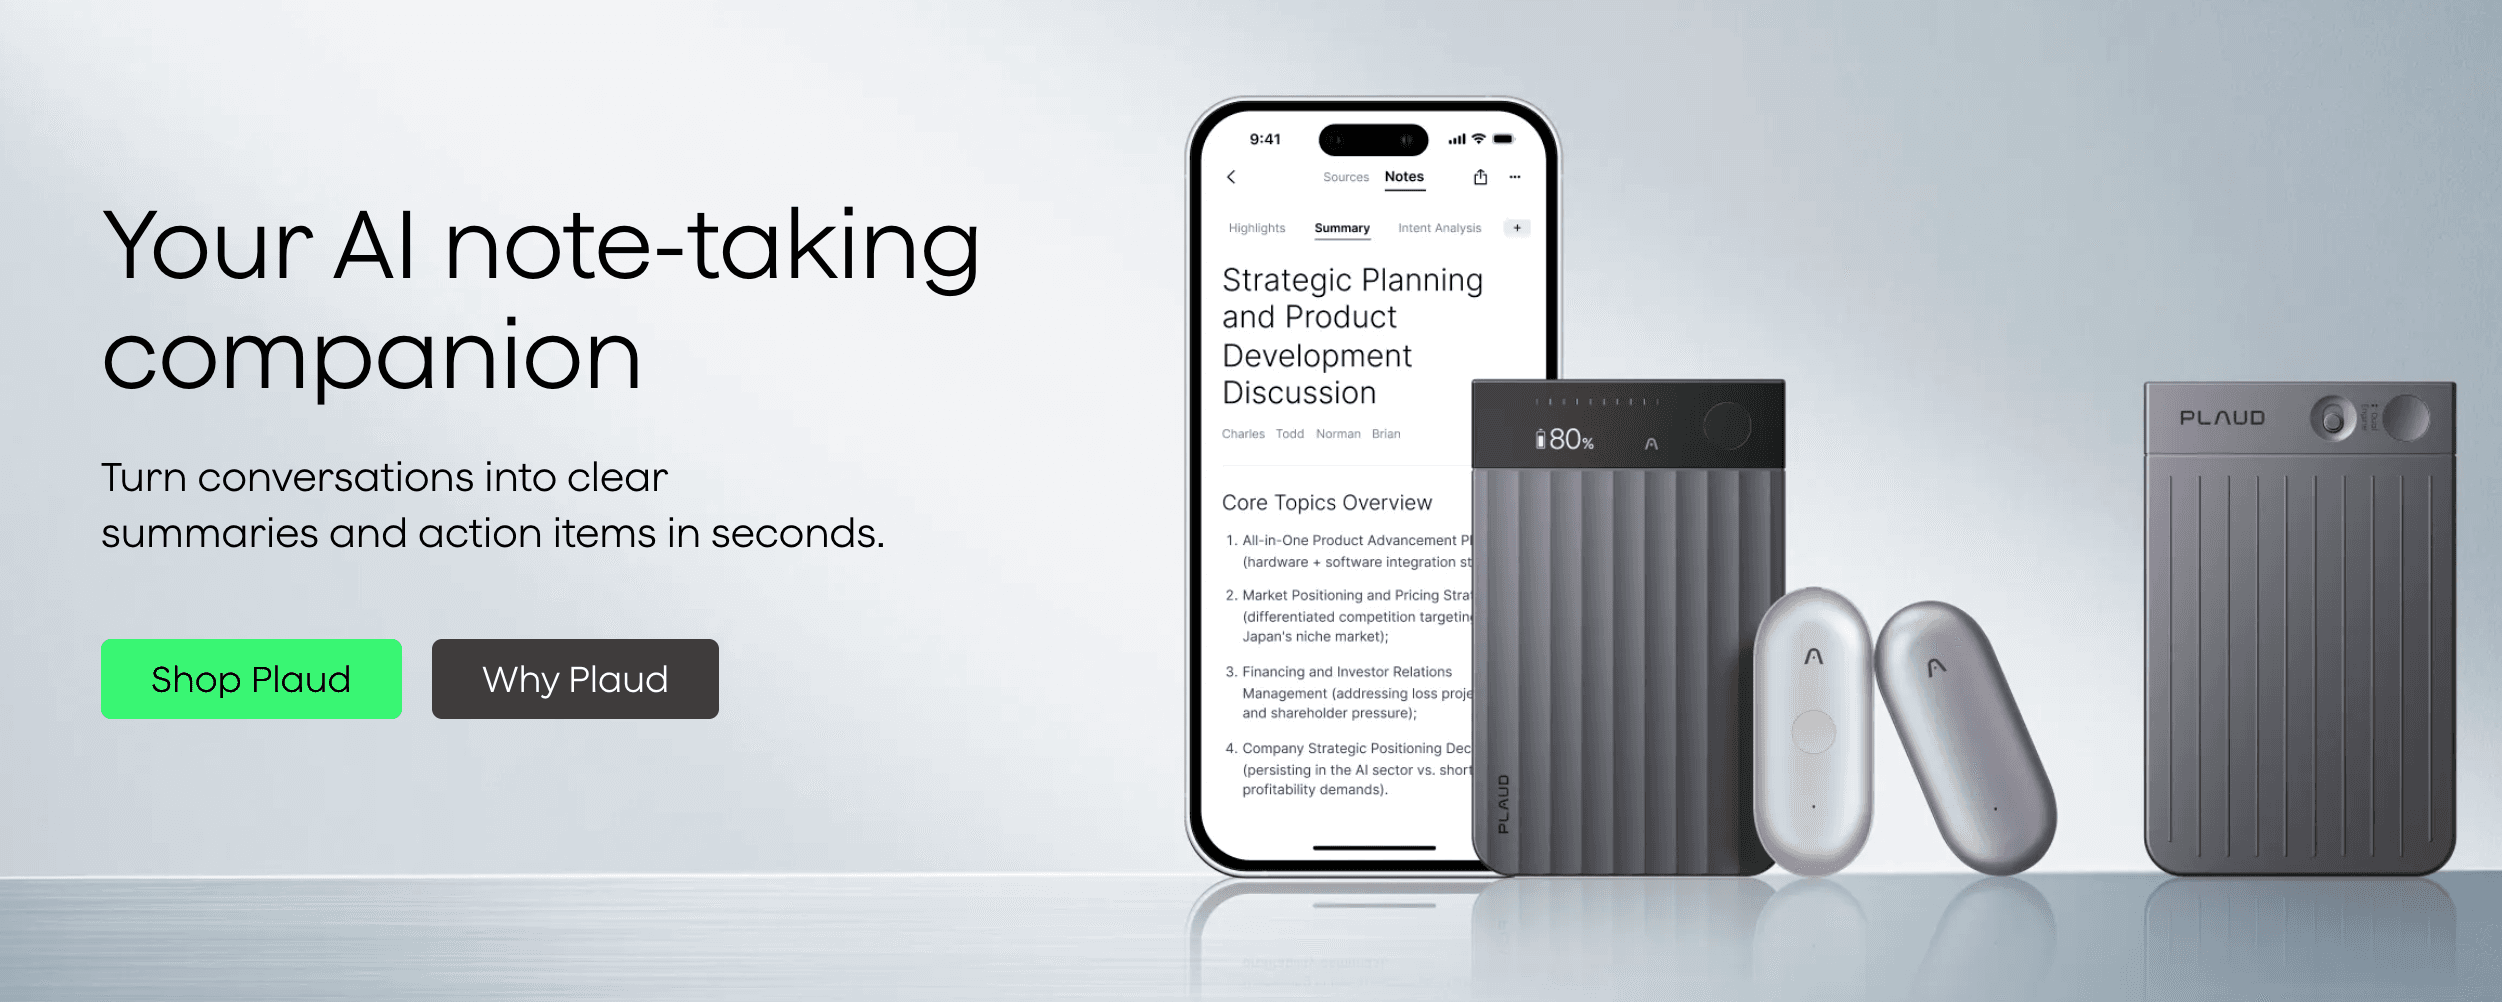
Detrás de esa experiencia hay una tarea más difícil de lo que parece. Cada grabación se convierte en una memoria personal de larga duración que el usuario espera poder buscar y consultar al instante — multiplicada por una base de usuarios global en rápido crecimiento. Almacenar y recuperar esa memoria a escala es la tarea que Plaud confía a Zilliz Cloud.
El desafío
La memoria de IA a escala de consumidor es una de las cargas de trabajo de recuperación más exigentes en producción. Plaud construyó inicialmente su recuperación sobre OpenSearch, que manejaba bien la búsqueda y los registros. Pero a medida que la carga de trabajo se orientó hacia la búsqueda semántica e híbrida a escala de miles de millones, el rendimiento de recuperación y el costo de OpenSearch a esa escala ya no podían mantenerse al día. Reemplazar esa base implicaba resolver tres fuerzas a la vez.
- Crecimiento explosivo de datos a escala de consumidor. A medida que la adopción se aceleraba en todo el mundo, la memoria vectorizada de Plaud creció de cientos de millones a miles de millones de fragmentos por región, acercándose a decenas de miles de millones. Cada grabación también genera metadatos escalares ricos utilizados para filtrado y clasificación, y un producto de consumo produce una enorme memoria "fría" de cola larga — datos que un usuario puede ignorar durante meses y luego necesitar de repente — que debe seguir siendo económica de retener sin ralentizar las consultas activas.
- Una carga de trabajo semántica y agéntica — no solo búsqueda por palabras clave. El caso de uso principal de Plaud es RAG agéntico y memoria: recuperación impulsada por el significado, a escala de miles de millones, que alimenta a Ask Plaud y sus agentes. Esto requiere búsqueda vectorial genuina de alto rendimiento combinada con filtrado escalar condicional, y escrituras continuas intensivas que se ejecutan junto con lecturas de baja latencia sin interferencias. La relevancia también debe respetar el tipo de contenido y la actualidad — un resumen debe pesar más que una transcripción en bruto, y la memoria reciente debe aparecer primero.
- Global, siempre activo y diseñado para datos personales sensibles. Una base de usuarios global convierte el despliegue multirregión y la residencia de datos en requisitos estrictos. Debido a que las grabaciones son profundamente personales, la plataforma necesita cifrado controlado por el cliente y un modelo en el que ningún texto plano salga jamás de Plaud. Y debido a que el producto se lanza continuamente, la capa de recuperación misma debe evolucionar — nuevos campos, nuevos índices, actualizaciones de versión — con cero tiempo de inactividad.
Por qué Zilliz Cloud
Plaud eligió Zilliz Cloud como base para esta carga de trabajo por tres razones.
Rendimiento y estabilidad probados a escala de miles de millones. Plaud necesitaba un motor que se mantuviera rápido y estable a medida que los datos crecen hasta los miles de millones en producción real — no en un benchmark. La arquitectura distribuida de Zilliz Cloud sostiene búsqueda de alto rendimiento y escrituras de alto rendimiento a escala, con lecturas y escrituras aisladas para mantener una latencia predecible a medida que crece la carga de trabajo.
Un modelo de privacidad que mantiene el contenido del usuario en Plaud. Plaud envía a Zilliz Cloud solo lo que la recuperación necesita — vectores semánticos y los campos escalares utilizados para el filtrado, como marcas de tiempo. Ninguna transcripción, audio o texto plano sale jamás de Plaud. Junto con claves de cifrado gestionadas por el cliente (CMEK), esto le da a Plaud un control sólido y verificable sobre la privacidad del usuario.
Una base gestionada que deja a Plaud el control de la relevancia. Zilliz Cloud se encarga de la parte difícil — almacenamiento y recuperación vectorial distribuida a escala — mientras que Plaud conserva las partes que diferencian su producto: cómo construye vectores dispersos y densos, ejecuta recuperación de múltiples vías, y fusiona y clasifica los resultados.
Dentro de Plaud, Zilliz Cloud es la capa de recuperación que impulsa ContextOS, el sistema que convierte grabaciones sin procesar en memoria útil. El camino de la voz a la respuesta pasa por cuatro etapas:
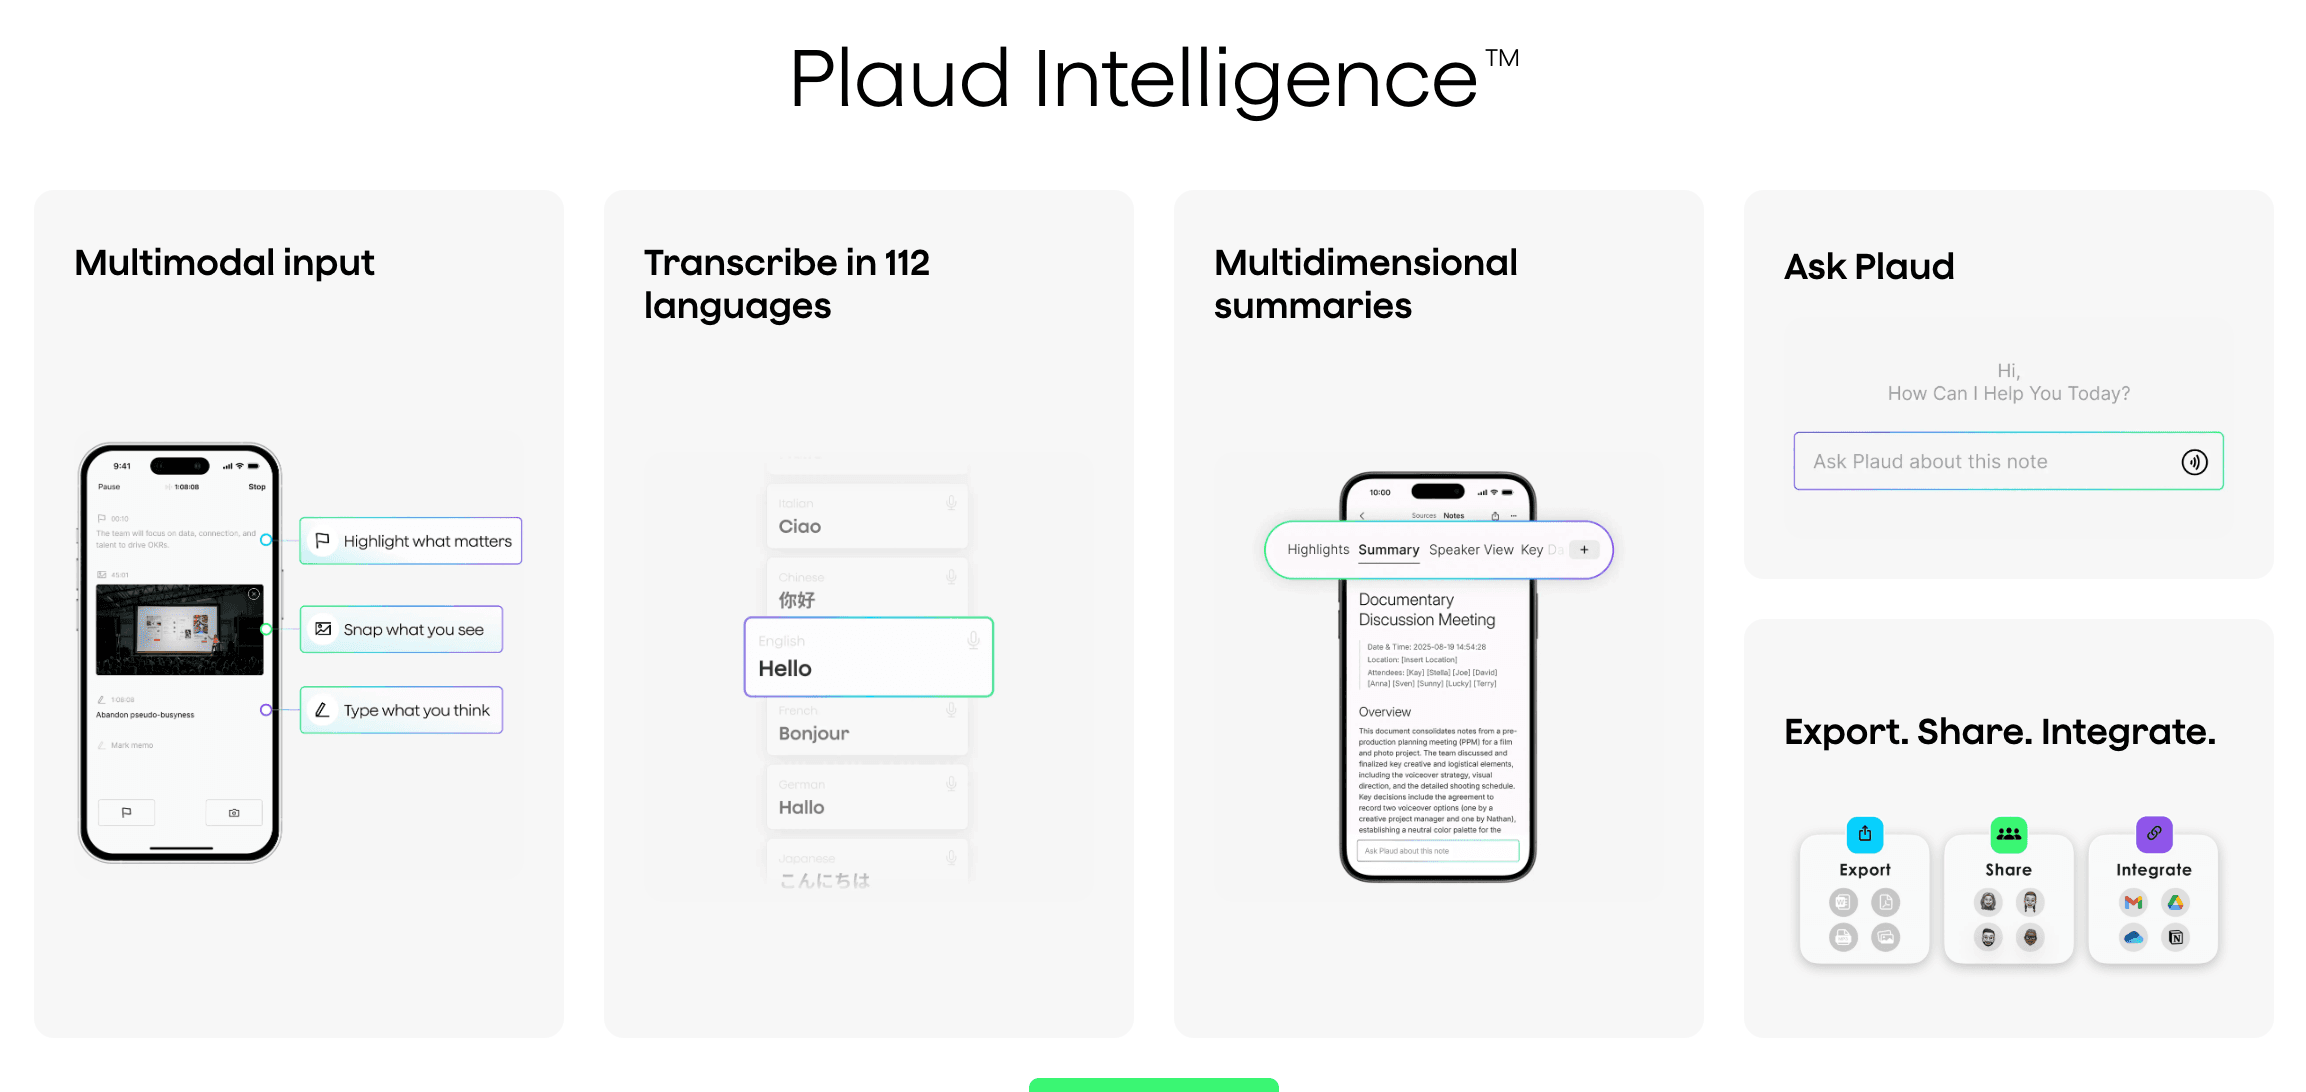
- Captura y preprocesamiento — Un usuario termina una grabación; el archivo entra en el sistema de archivos de Plaud y se preprocesa según sea necesario (por ejemplo, conversión de voz a texto y de texto a embeddings utilizando modelos de IA).
- Comprensión y almacenamiento — ContextOS procesa el contenido y lo escribe en Zilliz Cloud como vectores semánticos más campos escalares de filtro — nunca texto sin procesar.
- Recuperación por intención — Cuando el usuario busca o pregunta algo a Plaud, un agente interpreta la intención, la codifica en vectores y recupera el contexto más relevante de ContextOS, respaldado por Zilliz Cloud.
- Generación — Ese contexto recuperado fundamenta la respuesta del agente.
Sobre esta base, Zilliz Cloud impulsa tres escenarios de producto:
- Búsqueda en las grabaciones propias del usuario;
- Ask Plaud (RAG), respuestas fundamentadas en transcripciones y resúmenes;
- MAG (Memory-Augmented Generation), respuestas fundamentadas en la memoria personal a largo plazo.
Análisis técnico en profundidad: diseñado para la memoria de agentes
La memoria de agentes no es un RAG clásico sobre un conjunto de documentos estático. Es un contexto vivo, por usuario, que crece continuamente y debe mantenerse fresco, filtrable y privado. Alcanzar ese nivel requirió ingeniería específica — estas son las capacidades que el equipo de Plaud destaca.
Carga de datos históricos a escala de miles de millones, con el servicio aún en vivo
Desarrollar un producto de memoria implica cargar y remodelar constantemente grandes volúmenes de datos históricos — sin dejar la búsqueda fuera de línea para los usuarios que dependen de ella. Con Zilliz Cloud, Plaud ejecuta procesos de carga histórica a escala de miles de millones como trabajos por lotes fuera de línea que se completan en días mientras el servicio en vivo permanece totalmente disponible para lectura. Los conjuntos de memoria masivos se implementan en producción sin ventana de mantenimiento.
Evolución y actualizaciones de esquema sin tiempo de inactividad
Una aplicación de consumo en rápido movimiento cambia constantemente: nuevos atributos de memoria que almacenar, nuevos campos para filtrar y buscar, nuevos índices y versiones de motor que adoptar. Zilliz Cloud permite a Plaud añadir columnas dinámicas, habilitar la búsqueda por palabras clave (BM25) en nuevos campos de texto e implementar actualizaciones de índices y clústeres — todo sin tiempo de inactividad. Plaud sigue publicando actualizaciones mientras una aplicación global permanece siempre activa.
Multirregión global con residencia de datos
Los usuarios de Plaud abarcan Norteamérica, Europa y Asia-Pacífico, y esperan que sus datos sean rápidos y se mantengan en su región. El soporte nativo multirregión de Zilliz Cloud permite a Plaud ubicar la memoria de cada usuario en la región correcta para garantizar la residencia y la baja latencia. La unicidad de claves primarias entre clústeres hace que esto sea seguro a escala — los usuarios y sus datos pueden moverse entre clústeres regionales mientras las claves siguen siendo globalmente únicas — y la replicación sin tiempo de inactividad mantiene la migración invisible para los usuarios.
Recuperación híbrida consciente de la memoria
En la memoria personal, la mejor coincidencia no siempre es la más similar a nivel semántico: una nota reciente suele importar más que una antigua, y un resumen suele ser más útil que una transcripción en bruto. La búsqueda híbrida de Zilliz Cloud combina la recuperación semántica y por palabras clave con un ranqueo por decaimiento y ponderación por tipo de documento, de modo que Ask Plaud y sus agentes presentan memoria que no solo es relevante, sino oportuna y del tipo adecuado.
Más allá de estos esfuerzos principales, la carga de trabajo de Plaud se apoya en un conjunto de capacidades fundamentales que cualquier sistema de memoria para agentes de grado de producción necesita:
| Capacidad | Por qué es importante para Plaud |
|---|---|
| Filtrado escalar condicional con búsqueda vectorial | La memoria personal siempre está delimitada a un usuario y metadatos, por lo que el filtrado debe ejecutarse a la vez que la búsqueda semántica a toda velocidad |
| Aislamiento de lectura y escritura | La ingesta continua de alto volumen se ejecuta en paralelo con consultas de baja latencia sin que una degrade a la otra |
| Cifrado gestionado por el cliente (CMEK) | Plaud y sus usuarios conservan las claves; si se revoca una clave, los datos ya no se pueden descifrar |
| Almacenamiento por niveles en frío/caliente | La memoria "fría" de larga cola sigue siendo económica de conservar y se recalienta automáticamente al acceder a ella |
| Copia de seguridad y recuperación gestionadas | Las copias de seguridad de datasets completos se ejecutan con un impacto insignificante en el rendimiento de las consultas en vivo |
| Escalado elástico de capacidad | La capacidad crece con la base de usuarios sin necesidad de rediseñar el sistema |
Resultados y beneficios
- Recuperación de baja latencia a escala — La recuperación devuelve resultados en menos de 200 ms en promedio y menos de 800 ms en P99, lo que le da al pipeline integral de Ask AI margen para seguir respondiendo incluso cuando los datos crecen hasta miles de millones.
- Miles de millones de vectores sin rediseñar la arquitectura — Plaud ha pasado de cientos de millones a miles de millones de fragmentos por región, con un camino claro hacia decenas de miles de millones, todo sobre la misma base y sin que la recuperación se convierta en un cuello de botella.
- Operaciones de datos más rápidas, sin tiempo de inactividad — Los rellenos históricos a escala de miles de millones se completan en días, y las actualizaciones de esquema y de clúster se ejecutan sin tiempo de inactividad, por lo que el equipo publica de forma continua en una aplicación global siempre activa.
- Cumplimiento normativo y rendimiento globales — El despliegue nativo en múltiples regiones mantiene los datos de cada usuario dentro de su región, cumpliendo los requisitos de residencia de datos y ofreciendo baja latencia a usuarios de todo el mundo.
- Menor carga operativa — Un servicio completamente gestionado elimina el costo oculto de los clústeres autogestionados (configuración, ajuste, escalado y guardias), lo que permite al equipo de ingeniería centrarse en el producto, no en la infraestructura.
El beneficio más claro es estratégico: una base confiable y escalable permite a los ingenieros de Plaud pasar de preguntarse "¿aguantará la infraestructura?" a preguntarse "¿qué tan bueno puede llegar a ser el producto?", lo que posibilita una memoria semántica más amplia, estrategias de recuperación más sofisticadas y una iteración de funciones más rápida.
El consejo de Plaud para equipos que crean sistemas de IA para consumidores
Habiendo recorrido toda la curva de crecimiento, el equipo de Plaud ofrece cuatro lecciones para otros que construyan grabación con IA, memoria personal de IA u otros productos de IA para consumidores:
- Elige la infraestructura pensando en la escala final. En el momento en que un producto de consumo despega, los datos saltan de cientos de millones a miles de millones de fragmentos. Elige un motor creado específicamente para esa escala que escale sin problemas y evita una migración costosa más adelante.
- Prueba el filtrado escalar y la búsqueda semántica juntos. El filtrado condicional combinado con la recuperación semántica es la prueba más realista —y más exigente— de un motor vectorial para aplicaciones de IA reales.
- Incluye el costo operativo en los libros. La fragmentación ("sharding"), el escalado y las guardias autogestionados son costos ocultos y elevados. Una opción completamente gestionada los reduce a cero para que el equipo pueda centrarse en el producto.
- Planifica el alcance global y el cumplimiento normativo desde el principio. Para una base de usuarios global, la residencia de datos y la baja latencia en múltiples regiones se convierten en requisitos estrictos antes de lo que esperas.
Qué sigue
Plaud planea expandir su uso de Zilliz Cloud, del RAG agéntico (Agentic RAG) y la memoria de agentes actuales a un rol central en la ingeniería de contexto de sus agentes, a medida que su capa de memoria escale a decenas de miles de millones de vectores y más allá.
"Plaud es exactamente el tipo de empresa que está redefiniendo lo que la IA de consumo puede ser, y lo hace de manera rentable y a una velocidad notable. Estamos orgullosos de que Zilliz Cloud sea la base de recuperación detrás del éxito de Plaud, y estamos entusiasmados por seguir construyendo juntos mientras escalan hacia lo que viene en IA agéntica."
— James Luan, CTO de Zilliz
Prueba Zilliz Cloud gratis
Zilliz Cloud es una base de datos vectorial totalmente gestionada y un Vector Lakebase para IA empresarial, compatible con las API de Milvus. Ofrece búsqueda vectorial a escala de cien mil millones con alto rendimiento, seguridad de nivel empresarial y operaciones de mantenimiento cero. Ahora ampliado con la apertura, escalabilidad y economía de los lagos de datos multimodales, brinda a las empresas una plataforma única para buscar, analizar y gobernar datos no estructurados para IA en producción.
Tanto si está escalando RAG como si construye memoria de agentes, Zilliz Cloud proporciona la misma base de recuperación que impulsa Plaud. Comience con Zilliz Cloud gratis ahora o hable con nuestro equipo.
Elige por la escala a la que terminarás llegando, no por la que tienes ahora. Los datos de consumo crecen más rápido de lo que cualquiera planea, y una migración de ese tamaño es dolorosa. Entrega la infraestructura de recuperación a especialistas y dedica a tu propia gente al producto.
The engineering team, Plaud