Plaud ermöglicht Agentenspeicher im Milliardenmaßstab mit Zilliz Cloud
< 200 ms
Durchschnittliche Abruflatenz
10 Mrd.+
Vektor-Chunks pro Region, mit Raum zum Wachsen
In Tagen
Backfill historischer Daten im Milliardenmaßstab, ohne Dienstunterbrechung
Null Ausfallzeit
Schemaänderungen und Cluster-Upgrades bei einer Always-on-App
KI bewegt sich von der Beantwortung einmaliger Fragen hin zu Agenten, die sich erinnern, was das KI-Gedächtnis zum Herzstück von KI-Produkten für Verbraucher macht. Zilliz Cloud bietet uns eine solide Grundlage, der wir für den agentischen Gedächtnisabruf in großem Maßstab vertrauen können, sodass sich unser Team auf Produktinnovation und Benutzererfahrung konzentrieren kann, statt auf die darunterliegende Infrastruktur.
Charles Liu
Über Plaud
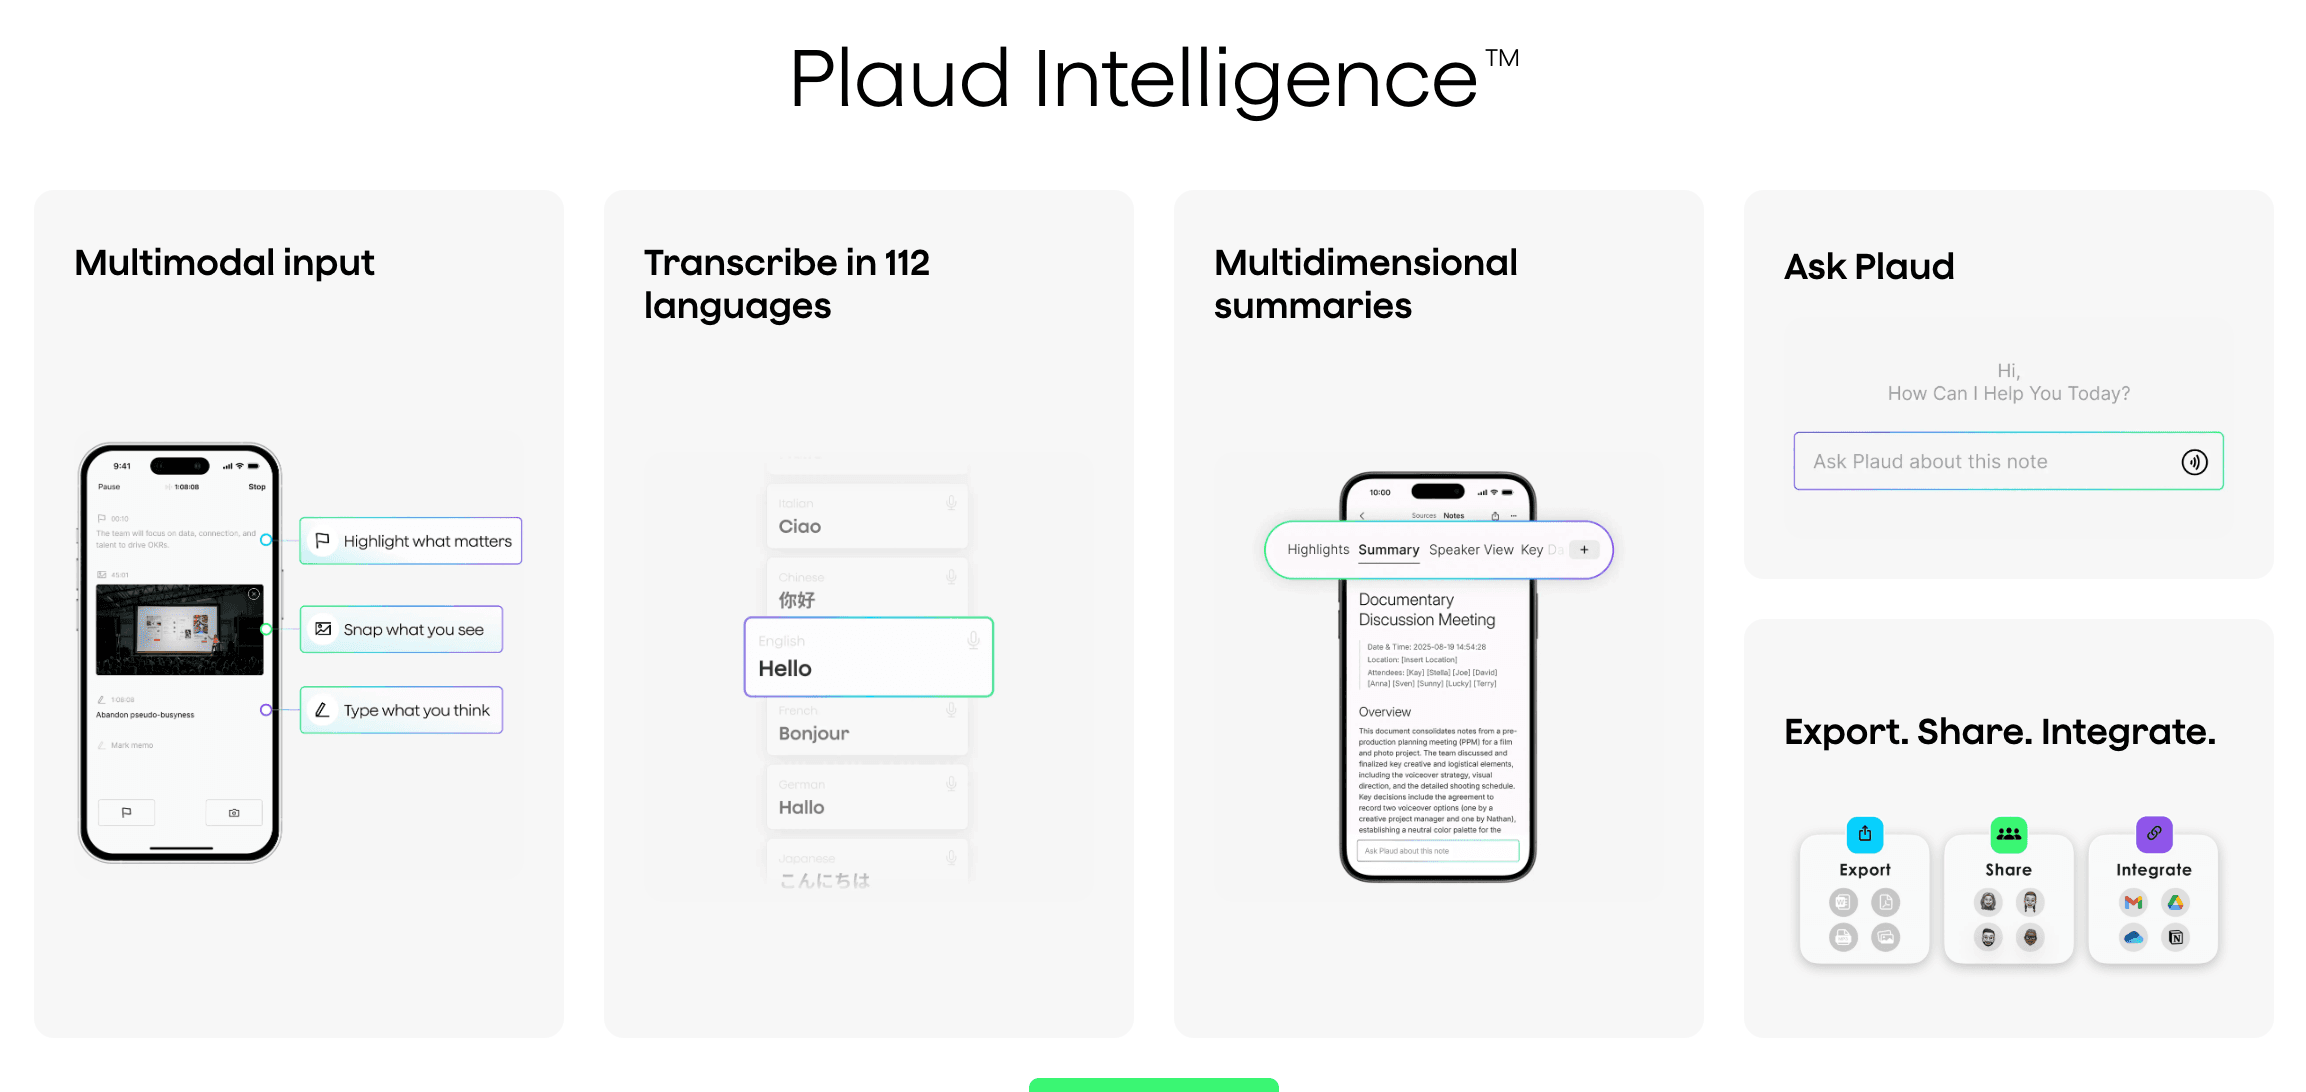
Plaud ist die weltweite Nr. 1 unter den KI-Notizmarken. Seine Hardware – die KI-Notizgeräte in Kreditkartengröße Plaud Note, Plaud Note Pro und das tragbare Plaud NotePin S – arbeitet mit Plaud Intelligence (verfügbar als App, Web und Desktop), um alltägliche Gespräche in Zusammenfassungen, Aufgaben und geschäftlichen Mehrwert zu verwandeln. In weniger als drei Jahren ist Plaud zu einem der prägenden Unternehmen im Bereich Consumer-KI-Hardware geworden: Es hat mehr als 2 Millionen Geräte in über 170 Ländern ausgeliefert und seinen jährlich wiederkehrenden Umsatz in etwa zwei Jahren von 1 Million US-Dollar auf über 100 Millionen US-Dollar gesteigert.
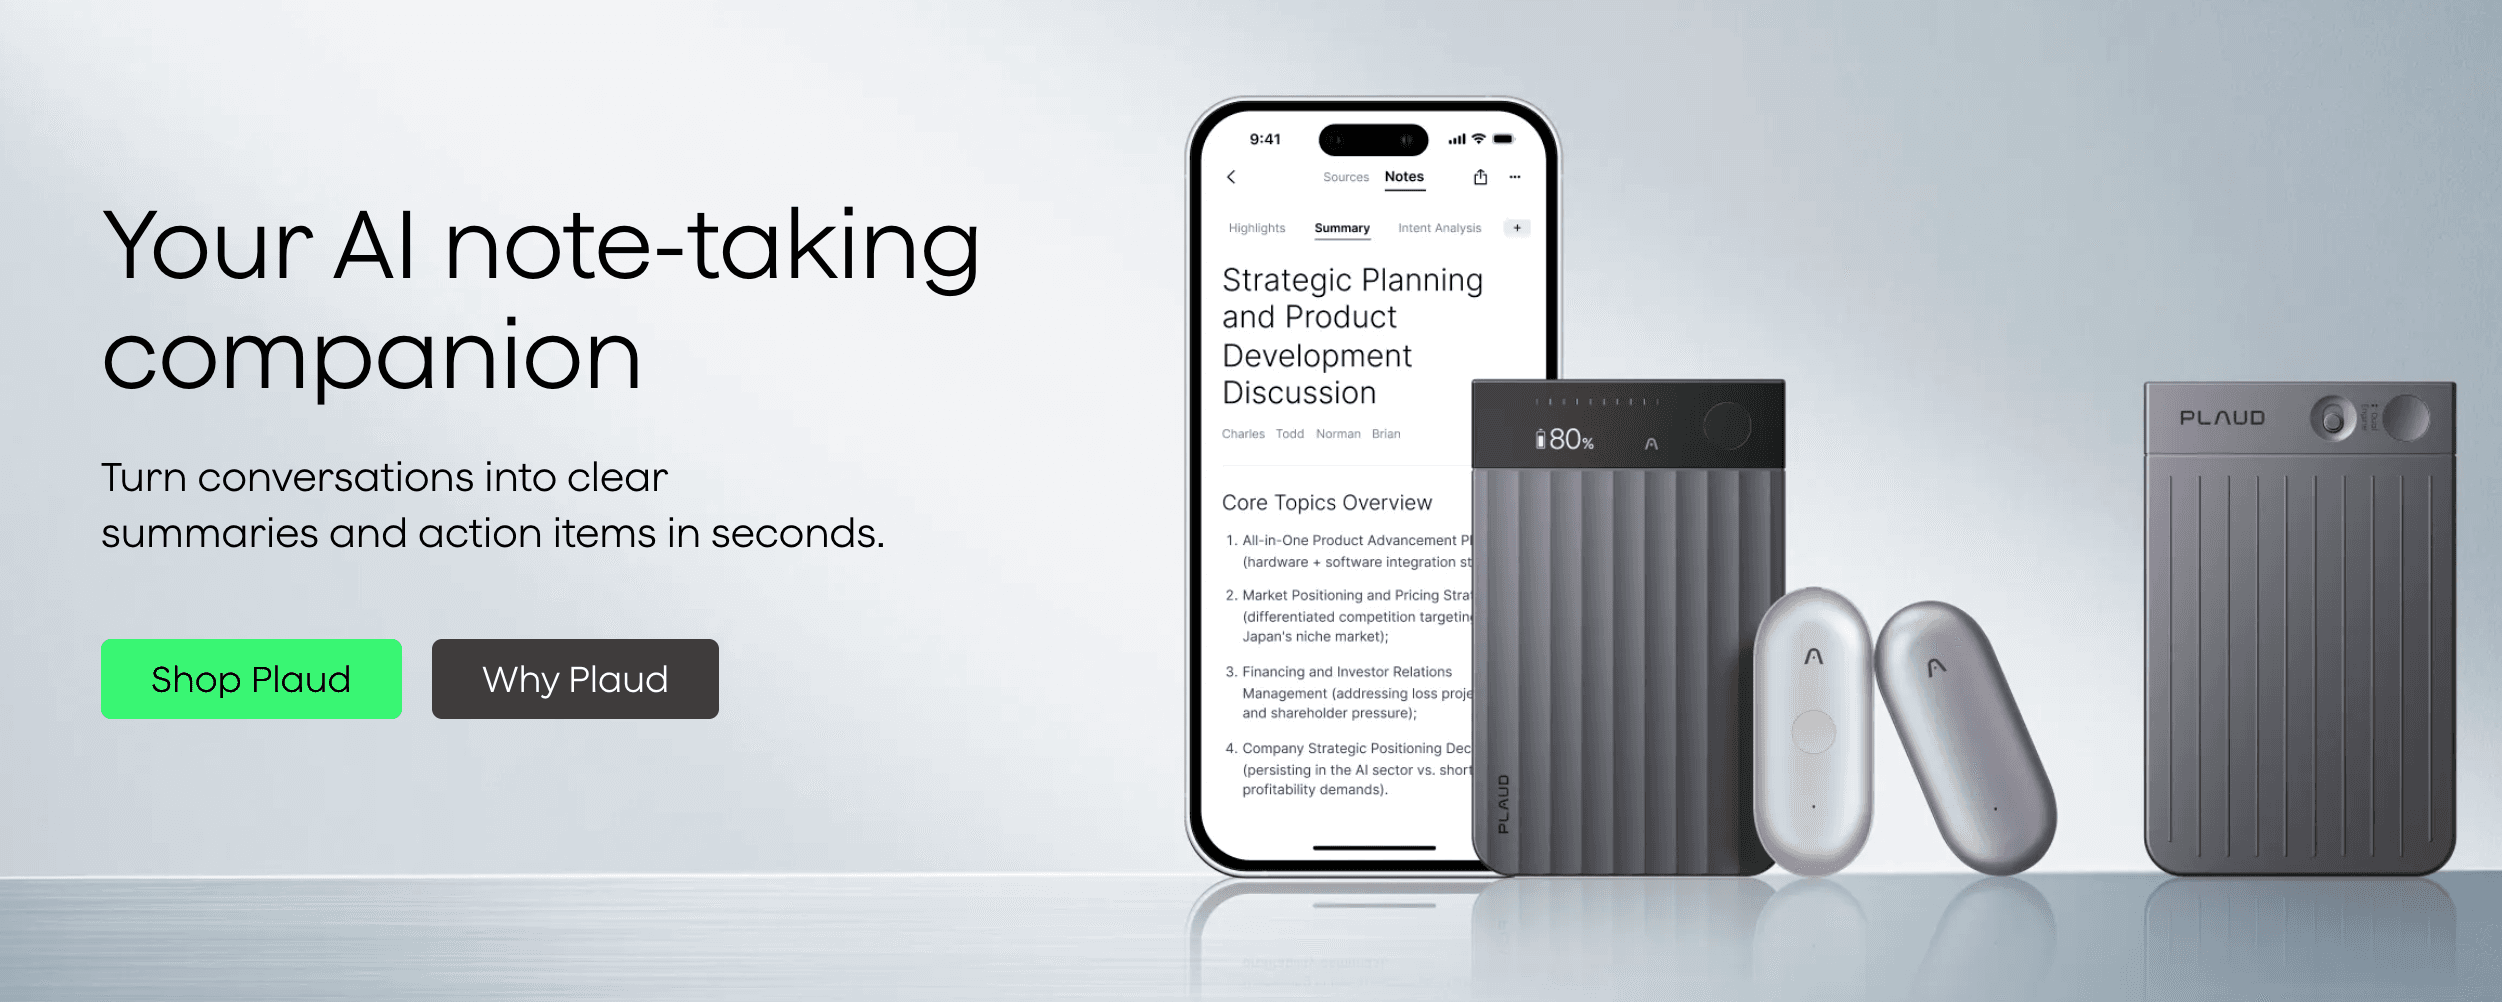
Hinter diesem Erlebnis steckt eine schwierigere Aufgabe, als es den Anschein hat. Jede Aufnahme wird zu einem langlebigen, persönlichen Gedächtnis, das ein Nutzer sofort durchsuchen und abfragen können muss – multipliziert mit einer schnell wachsenden globalen Nutzerbasis. Die Speicherung und Abfrage dieses Gedächtnisses in großem Maßstab ist die Aufgabe, die Plaud Zilliz Cloud anvertraut.
Die Herausforderung
KI-Speicher im Consumer-Maßstab ist eine der anspruchsvollsten Retrieval-Workloads in der Produktion. Plaud baute sein Retrieval zunächst auf OpenSearch auf, das Suche und Logs gut bewältigte. Doch als sich die Workload in Richtung semantischer und hybrider Suche im Milliardenmaßstab verlagerte, konnten OpenSearch's Retrieval-Leistung und -Kosten in diesem Maßstab nicht mehr mithalten. Die Ersetzung dieser Grundlage bedeutete, sich gleichzeitig mit drei Kräften auseinanderzusetzen.
- Explosives Datenwachstum im Consumer-Maßstab. Mit der weltweit beschleunigenden Verbreitung wuchs Plauds vektorisierter Speicher von Hunderten Millionen auf Milliarden von Chunks pro Region und nähert sich zig Milliarden. Jede Aufnahme erzeugt auch umfangreiche skalare Metadaten für Filterung und Ranking, und ein Consumer-Produkt erzeugt ein enormes Long-Tail-"Kaltgedächtnis" – Daten, die ein Nutzer monatelang ignoriert und dann plötzlich benötigt –, das kostengünstig aufbewahrt werden muss, ohne aktive Abfragen zu verlangsamen.
- Eine semantische, agentische Workload – nicht nur Stichwortsuche. Plauds Kernanwendungsfall ist Agentic RAG und Gedächtnis: bedeutungsgetriebenes Retrieval im Milliardenmaßstab, das Ask Plaud und seine Agenten speist. Dies erfordert echte Hochleistungs-Vektorsuche in Kombination mit bedingter Skalarfilterung sowie starke kontinuierliche Schreibvorgänge, die parallel zu Latenz-armen Lesevorgängen ohne Beeinträchtigung laufen. Die Relevanz muss auch Inhaltstyp und Aktualität berücksichtigen – eine Zusammenfassung sollte einen Roh-Transkript überwiegen, und neuere Erinnerungen sollten zuerst erscheinen.
- Global, immer verfügbar und für sensible persönliche Daten gebaut. Eine globale Nutzerbasis macht Multi-Region-Bereitstellung und Datenresidenz zu harten Anforderungen. Da Aufnahmen zutiefst persönlich sind, benötigt die Plattform kundenkontrollierte Verschlüsselung und ein Modell, in dem niemals Klartext Plaud verlässt. Und da das Produkt kontinuierlich ausgeliefert wird, muss sich auch die Retrieval-Ebene selbst weiterentwickeln – neue Felder, neue Indizes, Versions-Upgrades – ohne Ausfallzeiten.
Warum Zilliz Cloud
Plaud hat sich aus drei Gründen für Zilliz Cloud als Grundlage für diese Workload entschieden.
Bewährte Leistung und Stabilität im Milliardenmaßstab. Plaud brauchte eine Engine, die schnell und stabil bleibt, wenn die Daten in der Live-Produktion in die Milliarden wachsen – nicht in einem Benchmark. Die verteilte Architektur von Zilliz Cloud gewährleistet Hochleistungssuche und Schreibvorgänge mit hohem Durchsatz im großen Maßstab, wobei Lese- und Schreibvorgänge isoliert sind, um die Latenz auch bei wachsender Workload vorhersehbar zu halten.
Ein Datenschutzmodell, das Nutzerinhalte bei Plaud belässt. Plaud sendet an Zilliz Cloud nur das, was das Retrieval benötigt – semantische Vektoren und die für die Filterung verwendeten Skalarfelder wie Zeitstempel. Keine Transkripte, Audiodaten oder Klartexte verlassen jemals Plaud. Zusammen mit kundenseitig verwalteten Verschlüsselungsschlüsseln (CMEK) gibt dies Plaud eine starke, überprüfbare Kontrolle über den Datenschutz der Nutzer.
Eine verwaltete Grundlage, die Plaud die Kontrolle über die Relevanz lässt. Zilliz Cloud übernimmt den schwierigen Teil – verteilte Vektorspeicherung und Retrieval im großen Maßstab – während Plaud die Teile behält, die sein Produkt differenzieren: wie es Sparse- und Dense-Vektoren erstellt, Multi-Way-Recall durchführt und Ergebnisse fusioniert und rankt.
Die Lösung
Within Plaud ist Zilliz Cloud die Abrufschicht, die ContextOS antreibt, das System, das rohe Aufnahmen in nutzbare Erinnerungen verwandelt. Der Weg von der Stimme zur Antwort verläuft in vier Phasen:
- Erfassung & Vorverarbeitung — Ein Nutzer beendet eine Aufnahme; die Datei gelangt in Plauds Dateisystem und wird bei Bedarf vorverarbeitet (z. B. Spracherkennung und Text-zu-Embeddings mithilfe von KI-Modellen).
- Verstehen & Speichern — ContextOS verarbeitet den Inhalt und schreibt ihn als semantische Vektoren plus skalare Filterfelder in Zilliz Cloud — niemals als Rohtext.
- Intent-basiertes Abrufen — Wenn der Nutzer sucht oder Plaud etwas fragt, interpretiert ein Agent die Absicht, kodiert sie in Vektoren und ruft den relevantesten Kontext aus ContextOS ab, unterstützt von Zilliz Cloud.
- Generieren — Der abgerufene Kontext bildet die Grundlage für die Antwort des Agenten.
Auf dieser Grundlage unterstützt Zilliz Cloud drei Produktszenarien:
- Suche in den eigenen Aufnahmen eines Nutzers;
- Ask Plaud (RAG), Antworten, die auf Transkripten und Zusammenfassungen basieren;
- MAG (Memory-Augmented Generation), Antworten, die auf langfristigen persönlichen Erinnerungen basieren.
Engineering-Deep-Dive: entwickelt für das Agentengedächtnis
Agentengedächtnis ist kein klassisches RAG über einen statischen Dokumentsatz. Es ist lebendiger, nutzerspezifischer Kontext, der kontinuierlich wächst und aktuell, filterbar und privat bleiben muss. Diesen Standard zu erfüllen, erforderte spezielles Engineering — das sind die Fähigkeiten, die das Plaud-Team hervorhebt.
Backfill historischer Daten im Milliarden-Maßstab, während der Dienst weiterhin live bleibt
Ein Gedächtnisprodukt zu entwickeln bedeutet, ständig große Mengen historischer Daten zu laden und neu zu strukturieren — ohne die Suche für die Nutzer, die darauf angewiesen sind, offline zu nehmen. Mit Zilliz Cloud führt Plaud historische Backfills im Milliarden-Maßstab als Offline-Batch-Jobs aus, die in Tagen abgeschlossen werden, während der Live-Dienst vollständig lesbar bleibt. Massive Erinnerungsmengen werden ohne Wartungsfenster in die Produktion übernommen.
Schema-Evolution und Upgrades ohne Ausfallzeiten
Eine schnelllebige Verbraucher-App ändert sich ständig: neue Gedächtnisattribute, die gespeichert werden müssen, neue Felder zum Filtern und Durchsuchen, neue Index- und Engine-Versionen, die übernommen werden müssen. Zilliz Cloud ermöglicht es Plaud, dynamische Spalten hinzuzufügen, Stichwortsuche (BM25) für neue Textfelder zu aktivieren und Index- und Cluster-Upgrades auszurollen — alles ohne Ausfallzeiten. Plaud liefert weiterhin neue Funktionen aus, während eine globale App ständig verfügbar bleibt.
Globales Multi-Region mit Datenresidenz
Plauds Nutzer sind über Nordamerika, Europa und den Asien-Pazifik-Raum verteilt und erwarten, dass ihre Daten sowohl schnell abrufbar als auch in der Region gespeichert werden. Die native Multi-Region-Unterstützung von Zilliz Cloud ermöglicht es Plaud, die Erinnerungen jedes Nutzers in der richtigen Region für Datenresidenz und geringe Latenz zu platzieren. Die clusterübergreifende Eindeutigkeit der Primärschlüssel macht dies im großen Maßstab sicher — Nutzer und ihre Daten können sich zwischen regionalen Clustern bewegen, während die Schlüssel global eindeutig bleiben — und Replikation ohne Ausfallzeiten macht die Migration für Nutzer unsichtbar.
Gedächtnisbasiertes Hybrid-Retrieval
In persönlichen Erinnerungen ist der beste Treffer nicht immer der semantisch ähnlichste: Eine aktuelle Notiz ist in der Regel wichtiger als eine alte, und eine Zusammenfassung ist oft nützlicher als ein Rohtranskript. Die hybride Suche von Zilliz Cloud kombiniert semantisches und Stichwort-Retrieval mit Abkling-Ranking und Dokumenttyp-Gewichtung, sodass Ask Plaud und seine Agenten Erinnerungen hervorheben, die nicht nur relevant, sondern auch zeitgerecht und von der richtigen Art sind.
Über diese zentralen Maßnahmen hinaus stützt sich Plauds Workload auf eine Reihe grundlegender Fähigkeiten, die jedes produktionsreife Agentengedächtnissystem benötigt:
| Funktion | Warum es für Plaud wichtig ist |
|---|---|
| Bedingte Skalarfilterung mit Vektorsuche | Persönliches Gedächtnis ist immer auf einen Benutzer und Metadaten bezogen, daher muss die Filterung gemeinsam mit der semantischen Suche mit voller Geschwindigkeit laufen. |
| Lese-Schreib-Isolation | Kontinuierliche Erfassung mit hohem Volumen läuft parallel zu Abfragen mit geringer Latenz, ohne dass eine die andere beeinträchtigt. |
| Kundenseitig verwaltete Verschlüsselung (CMEK) | Plaud und seine Benutzer besitzen die Schlüssel; wird ein Schlüssel widerrufen, können die Daten nicht mehr entschlüsselt werden. |
| Kalt-/Heiß-Tiering | Das langfristige „kalte“ Gedächtnis bleibt kostengünstig zu speichern und wärmt sich bei Zugriff automatisch wieder auf. |
| Verwaltetes Backup & Recovery | Backups des gesamten Datensatzes laufen mit vernachlässigbarer Auswirkung auf die Leistung von Live-Abfragen. |
| Elastische Kapazitätsskalierung | Die Kapazität wächst mit der Benutzerbasis, ohne dass das System neu architektiert werden muss. |
Ergebnisse & Vorteile
- Latenzarme Abfrage im großen Maßstab — Der Abruf erfolgt im Durchschnitt in unter 200 ms und bei P99 in unter 800 ms, was der End-to-End-Ask-AI-Pipeline Raum gibt, reaktionsfähig zu bleiben, selbst wenn die Daten auf Milliarden anwachsen.
- Milliarden von Vektoren ohne Neuarchitektur — Plaud ist von Hunderten Millionen auf Milliarden von Chunks pro Region gewachsen, mit einem klaren Weg zu zig Milliarden, alles auf derselben Grundlage und ohne dass der Abruf zum Engpass wird.
- Schnellere Datenoperationen, null Ausfallzeit — Historische Backfills im Milliardenmaßstab sind in Tagen abgeschlossen, und Schema- und Cluster-Upgrades laufen ohne Ausfallzeit, sodass das Team kontinuierlich auf einer ständig verfügbaren, globalen App ausliefert.
- Globale Compliance und Leistung — Native Multi-Region-Bereitstellung hält die Daten jedes Benutzers in der Region, erfüllt die Anforderungen an die Datenresidenz und liefert gleichzeitig niedrige Latenz für Benutzer weltweit.
- Geringerer operativer Aufwand — Ein vollständig verwalteter Dienst beseitigt die versteckten Kosten selbst betriebener Cluster (Einrichtung, Tuning, Skalierung und Bereitschaft), sodass sich die Entwicklung auf das Produkt konzentriert und nicht auf Infrastruktur.
Der deutlichste Vorteil ist strategischer Natur: Eine zuverlässige, skalierbare Grundlage ermöglicht den Ingenieuren von Plaud, ihre Aufmerksamkeit von „Wird die Infrastruktur halten?" zurück auf „Wie gut kann das Produkt sein?" zu lenken – was ein größeres semantisches Gedächtnis, ausgefeiltere Abrufstrategien und schnellere Feature-Entwicklung ermöglicht.
Plauds Ratschläge für Teams, die Consumer-KI-Systeme bauen
Plauds Team hat die gesamte Wachstumskurve durchlaufen und bietet vier Lektionen für andere, die KI-Aufzeichnung, persönliches KI-Gedächtnis oder andere Consumer-KI-Produkte entwickeln:
- Wählen Sie die Infrastruktur für Ihre angestrebte Endgröße. Sobald ein Consumer-Produkt durchstartet, springen die Daten von Hunderten Millionen auf Milliarden von Chunks. Wählen Sie eine zweckgebaute Engine, die reibungslos skaliert, und vermeiden Sie so später eine teure Migration.
- Testen Sie Skalarfilterung und semantische Suche gemeinsam. Bedingte Filterung in Kombination mit semantischem Abruf ist der realistischste – und anspruchsvollste – Test einer Vektor-Engine für echte KI-Anwendungen.
- Setzen Sie operative Kosten auf die Rechnung. Selbstverwaltetes Sharding, Skalierung und Bereitschaft sind versteckte, hohe Kosten. Eine vollständig verwaltete Option macht sie zu null, sodass sich das Team auf das Produkt konzentrieren kann.
- Planen Sie frühzeitig für globale Reichweite und Compliance. Für eine globale Benutzerbasis werden Datenresidenz und Multi-Region-Niedriglatenz schneller zu harten Anforderungen, als Sie erwarten.
Was kommt als Nächstes
Plaud plant, seine Nutzung von Zilliz Cloud von der heutigen Agentic-RAG- und Agentengedächtnis-Nutzung zu einer zentralen Rolle im Kontext-Engineering seiner Agenten auszubauen, während seine Gedächtnisschicht auf zig Milliarden Vektoren und darüber hinaus skaliert.
"Plaud ist genau die Art von Unternehmen, die neu definiert, was Consumer-KI sein kann – und das profitabel, mit bemerkenswerter Geschwindigkeit. Wir sind stolz darauf, dass Zilliz Cloud die Abruf-Grundlage hinter Plauds Erfolg ist, und wir freuen uns darauf, weiter gemeinsam zu bauen, während sie auf das hinarbeiten, was als Nächstes in der agentischen KI kommt."
— James Luan, CTO von Zilliz
Zilliz Cloud kostenlos ausprobieren
Zilliz Cloud ist eine vollständig verwaltete Vektordatenbank und Vector Lakebase für Enterprise-KI, kompatibel mit Milvus-APIs. Sie bietet Vektorsuche im Maßstab von hundert Milliarden mit hoher Leistung, Sicherheit auf Unternehmensniveau und wartungsfreiem Betrieb. Jetzt erweitert um die Offenheit, Skalierbarkeit und Wirtschaftlichkeit von multimodalen Data Lakes, bietet sie Unternehmen eine einzige Plattform, um unstrukturierte Daten für Produktions-KI zu durchsuchen, zu analysieren und zu verwalten.
Ob Sie RAG skalieren oder Agent-Speicher aufbauen, Zilliz Cloud bietet dieselbe Retrieval-Grundlage, die auch Plaud antreibt. Jetzt kostenlos mit Zilliz Cloud starten oder sprechen Sie mit unserem Team.
Inhalte
Anwendungsfall
Branche
AI-SaaS
Wähle die Größenordnung, bei der du am Ende landen wirst, nicht die, die du gerade hast. Verbraucherdaten wachsen schneller, als irgendjemand plant, und eine Migration in dieser Größenordnung ist schmerzhaft. Übergib die Retrieval-Infrastruktur an Spezialisten und setze deine eigenen Leute für das Produkt ein.
The engineering team, Plaud