Plaud Potencializa Memória de Agente em Escala Bilionária com Zilliz Cloud
< 200 ms
Latência média de recall
10B+
Blocos de vetores por região, com espaço para crescer
Em dias
Backfill de dados históricos em escala de bilhões, sem interrupção de serviço
Zero tempo de inatividade
Alterações de schema e atualizações de cluster em um aplicativo sempre ativo
A IA está passando de responder perguntas pontuais para agentes que lembram, o que torna a memória de IA o coração dos produtos de IA para consumidores. O Zilliz Cloud nos fornece uma base sólida em que podemos confiar para recuperação de memória de agentes em escala massiva, para que nossa equipe possa dedicar sua energia à inovação de produto e à experiência do usuário, e não à infraestrutura subjacente.
Charles Liu
Sobre a Plaud
A Plaud é a marca nº 1 do mundo em anotações com IA. Seu hardware — os gravadores de notas com IA do tamanho de um cartão de crédito, Plaud Note, Plaud Note Pro, e o wearable Plaud NotePin S — funciona com a Plaud Intelligence (disponível no app, web e desktop) para transformar conversas do dia a dia em resumos, itens de ação e valor de negócio. Em menos de três anos, a Plaud se tornou uma das empresas mais representativas do hardware de IA para consumo: já enviou mais de 2 milhões de dispositivos para mais de 170 países e cresceu de US$ 1 milhão para mais de US$ 100 milhões em receita recorrente anual em aproximadamente dois anos.
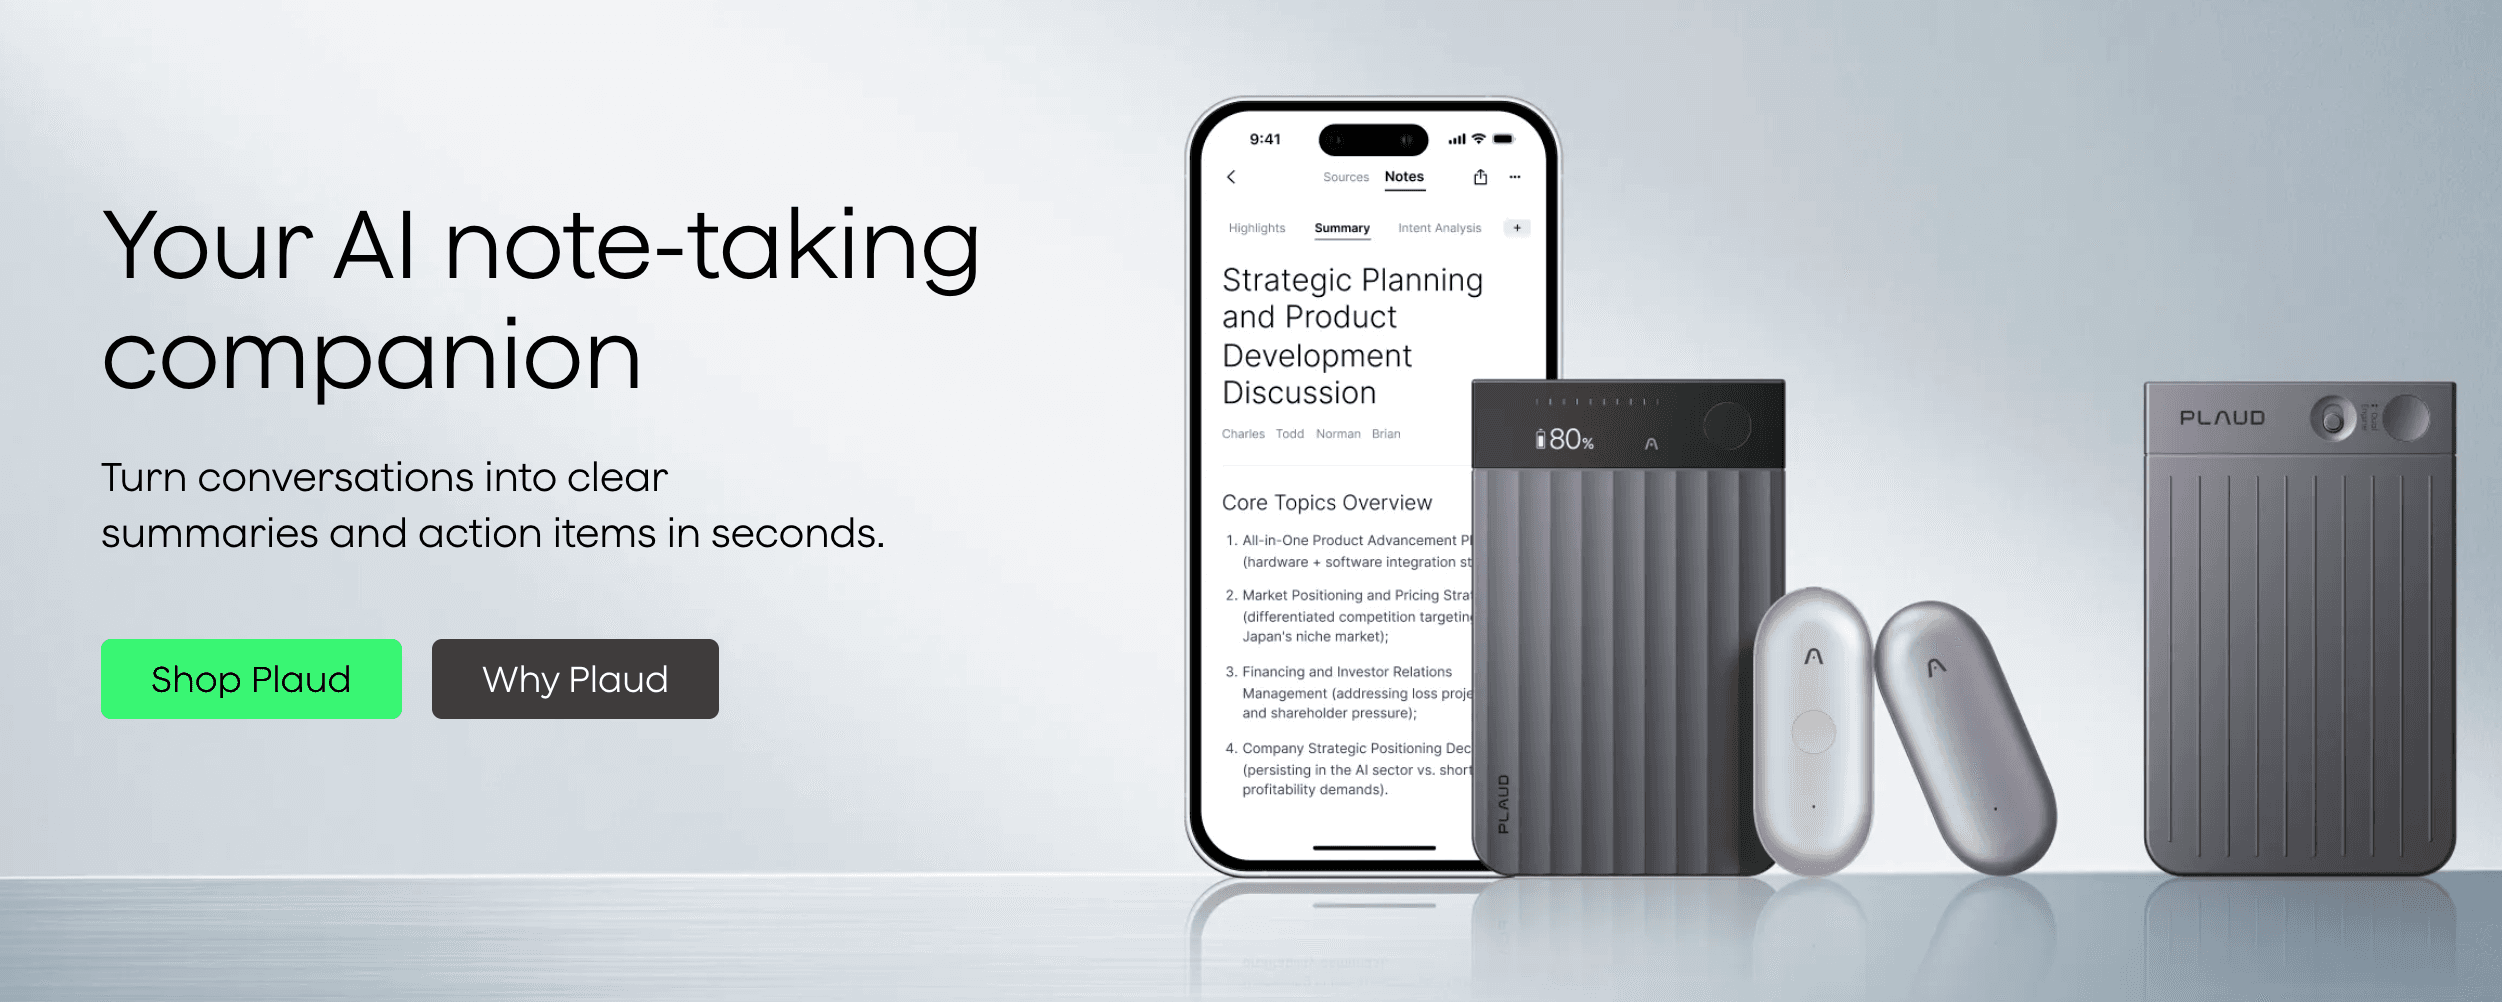
Por trás dessa experiência, há uma tarefa mais difícil do que parece. Cada gravação se torna uma memória pessoal de longo prazo que o usuário espera pesquisar e consultar instantaneamente — multiplicada por uma base global de usuários em rápido crescimento. Armazenar e recuperar essa memória em escala é o trabalho que a Plaud confia à Zilliz Cloud.
O Desafio
Memória de IA em escala de consumo é uma das cargas de trabalho de recuperação mais exigentes em produção. A Plaud inicialmente construiu sua recuperação sobre o OpenSearch, que lidava bem com busca e logs. Mas, à medida que a carga de trabalho migrou para busca semântica e híbrida em escala de bilhões, o desempenho de recuperação e o custo do OpenSearch nessa escala não acompanharam mais. Substituir essa base significava resolver três forças ao mesmo tempo.
- Crescimento explosivo de dados em escala de consumo. Com a aceleração da adoção mundial, a memória vetorizada da Plaud cresceu de centenas de milhões para bilhões de blocos por região, aproximando-se de dezenas de bilhões. Cada gravação também gera metadados escalares ricos, usados para filtragem e classificação, e um produto de consumo produz uma enorme "memória fria" de cauda longa — dados que o usuário pode ignorar por meses e, de repente, precisar — que deve permanecer barata de reter sem desacelerar consultas ativas.
- Uma carga de trabalho semântica e agêntica — não apenas busca por palavras-chave. O caso de uso central da Plaud é RAG agêntico e memória: recuperação orientada por significado, em escala de bilhões, alimentando o Ask Plaud e seus agentes. Isso exige busca vetorial de alto desempenho de verdade combinada com filtragem escalar condicional, além de muitas gravações contínuas rodando lado a lado com leituras de baixa latência, sem interferência. A relevância também deve respeitar o tipo de conteúdo e a recência — um resumo deve ter mais peso do que uma transcrição crua, e memórias recentes devem vir primeiro.
- Global, sempre ativo e criado para dados pessoais sensíveis. Uma base global de usuários torna a implantação em várias regiões e a residência de dados requisitos rígidos. Como as gravações são profundamente pessoais, a plataforma precisa de criptografia controlada pelo cliente e de um modelo no qual nenhum texto simples jamais saia da Plaud. E, como o produto é lançado continuamente, a camada de recuperação em si deve evoluir — novos campos, novos índices, atualizações de versão — com zero tempo de inatividade.
Por que a Zilliz Cloud
A Plaud escolheu a Zilliz Cloud como a base para essa carga de trabalho por três motivos.
Desempenho e estabilidade comprovados em escala de bilhões. A Plaud precisava de um mecanismo que permanecesse rápido e estável à medida que os dados crescem para bilhões em produção real — não em um benchmark. A arquitetura distribuída da Zilliz Cloud sustenta busca de alto desempenho e gravações de alta vazão em escala, com leituras e gravações isoladas para manter a latência previsível conforme a carga cresce.
Um modelo de privacidade que mantém o conteúdo do usuário com a Plaud. A Plaud envia para a Zilliz Cloud apenas o que a recuperação precisa — vetores semânticos e os campos escalares usados para filtragem, como carimbos de data/hora. Nenhuma transcrição, áudio ou texto simples jamais sai da Plaud. Combinado com chaves de criptografia gerenciadas pelo cliente (CMEK), isso dá à Plaud um controle forte e verificável sobre a privacidade do usuário.
Uma base gerenciada que deixa a Plaud no controle da relevância. A Zilliz Cloud cuida da parte difícil — armazenamento e recuperação vetorial distribuídos em escala — enquanto a Plaud mantém as partes que diferenciam seu produto: como ela constrói vetores esparsos e densos, executa recall de múltiplas vias e funde e classifica resultados.
A Solução
Dentro da Plaud, o Zilliz Cloud é a camada de recuperação que impulsiona o ContextOS, o sistema que transforma gravações brutas em memória utilizável. O caminho da voz até a resposta percorre quatro etapas:
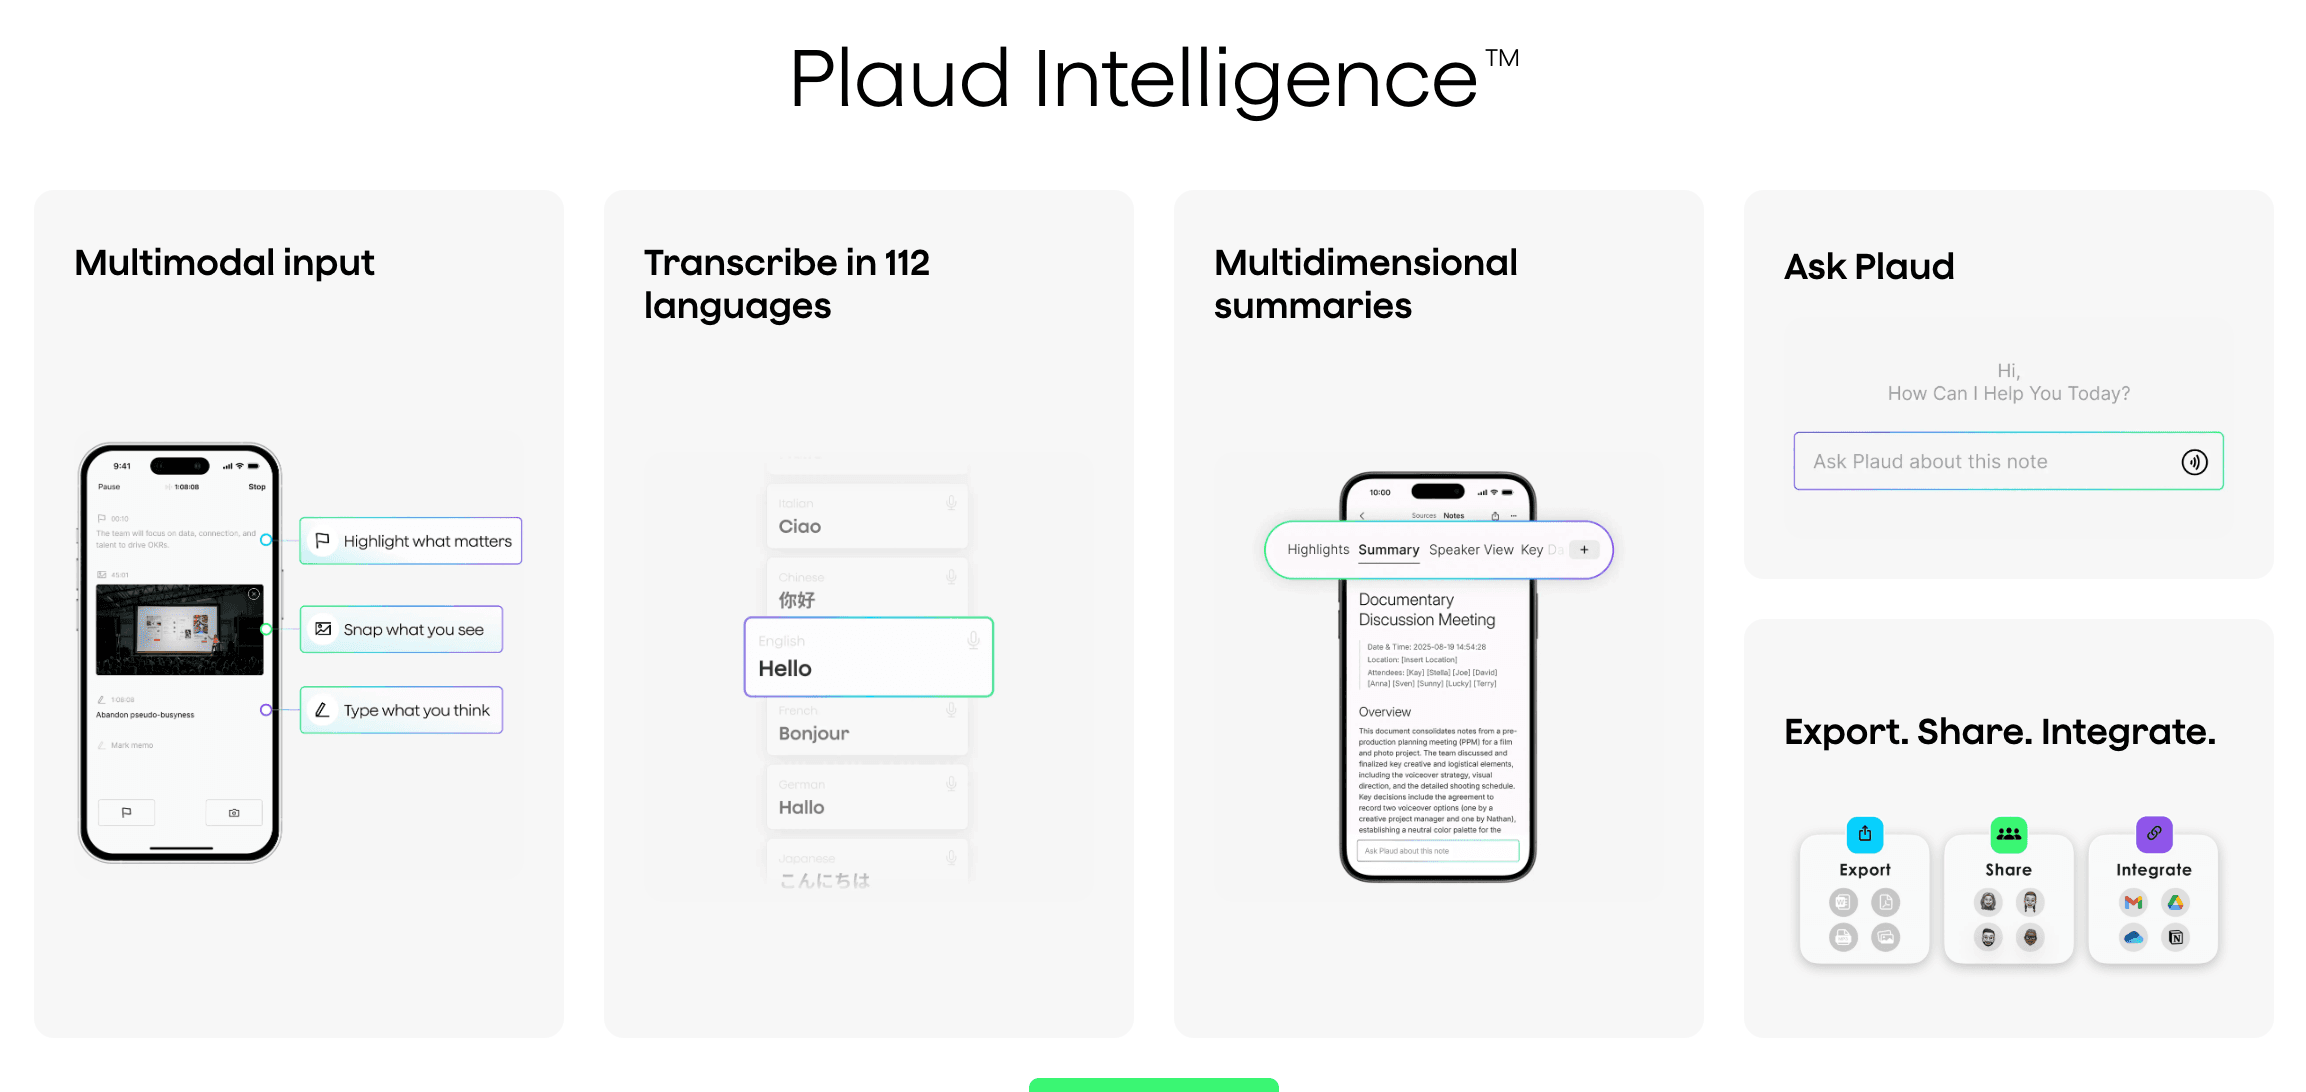
- Captura & pré-processamento — Um usuário termina uma gravação; o arquivo entra no sistema de arquivos da Plaud e é pré-processado conforme necessário (por exemplo, fala para texto e texto para embeddings usando modelos de IA).
- Compreensão & armazenamento — O ContextOS processa o conteúdo e o escreve no Zilliz Cloud como vetores semânticos e campos de filtro escalares — nunca texto bruto.
- Recuperação por intenção — Quando o usuário pesquisa ou pergunta algo ao Plaud, um agente interpreta a intenção, codifica-a em vetores e recupera o contexto mais relevante do ContextOS, com suporte do Zilliz Cloud.
- Geração — Esse contexto recuperado fundamenta a resposta do agente.
Com essa base, o Zilliz Cloud impulsiona três cenários de produto:
- Busca nas gravações do próprio usuário;
- Ask Plaud (RAG), respostas fundamentadas em transcrições e resumos;
- MAG (Memory-Augmented Generation), respostas fundamentadas na memória pessoal de longo prazo.
Análise aprofundada de engenharia: construída para memória de agente
A memória de agente não é RAG clássico sobre um conjunto estático de documentos. É um contexto vivo, por usuário, que cresce continuamente e precisa permanecer atual, filtrável e privado. Alcançar esse padrão exigiu engenharia específica — estas são as capacidades que o time da Plaud destaca.
Backfill de dados históricos em escala de bilhões, com o serviço ainda no ar
Crescer um produto de memória significa carregar e remodelar constantemente grandes volumes de dados históricos — sem tirar a busca do ar para os usuários que dependem dela. Com o Zilliz Cloud, a Plaud executa backfills históricos em escala de bilhões como tarefas em lote offline, concluídas em dias, enquanto o serviço ativo permanece totalmente legível. Conjuntos massivos de memória são implantados em produção sem janela de manutenção.
Evolução de esquema e upgrades com zero downtime
Um aplicativo de consumo em rápida evolução muda constantemente: novos atributos de memória para armazenar, novos campos para filtrar e pesquisar, novas versões de índice e mecanismo para adotar. O Zilliz Cloud permite que a Plaud adicione colunas dinâmicas, ative a busca por palavra-chave (BM25) em novos campos de texto e implemente upgrades de índice e cluster — tudo com zero downtime. A Plaud continua entregando atualizações enquanto um aplicativo global permanece sempre ativo.
Multi-região global com residência de dados
Os usuários da Plaud estão distribuídos pela América do Norte, Europa e Ásia-Pacífico e esperam que seus dados sejam rápidos e mantidos na região. O suporte multi-região nativo do Zilliz Cloud permite que a Plaud coloque a memória de cada usuário na região certa para residência e baixa latência. A exclusividade da chave primária entre clusters torna isso seguro em escala — usuários e seus dados podem se mover entre clusters regionais enquanto as chaves permanecem globalmente exclusivas — e a replicação com zero downtime mantém a migração invisível para os usuários.
Recuperação híbrida sensível à memória
Na memória pessoal, a melhor correspondência nem sempre é a mais semelhante semanticamente: uma nota recente geralmente importa mais do que uma antiga, e um resumo costuma ser mais útil do que uma transcrição bruta. A busca híbrida do Zilliz Cloud combina recuperação semântica e por palavras-chave com ranqueamento por decaimento e ponderação por tipo de documento, para que o Ask Plaud e seus agentes tragam à tona memórias que não são apenas relevantes, mas oportunas e do tipo certo.
Além dessas iniciativas de destaque, a carga de trabalho da Plaud se apoia em um conjunto de capacidades fundamentais que qualquer sistema de memória de agente de nível de produção precisa:
| Capacidade | Por que isso importa para a Plaud |
|---|---|
| Filtragem escalar condicional com busca vetorial | A memória pessoal é sempre delimitada a um usuário e a metadados, então a filtragem precisa ser executada junto com a busca semântica em alta velocidade |
| Isolamento de leitura–escrita | A ingestão contínua e de alto volume é executada em paralelo com consultas de baixa latência, sem que uma degrade a outra |
| Criptografia gerenciada pelo cliente (CMEK) | A Plaud e seus usuários detêm as chaves; revogue uma chave e os dados não poderão mais ser descriptografados |
| Camadas fria/quente | A memória "fria" de cauda longa permanece barata de reter e reaquece automaticamente no acesso |
| Backup e recuperação gerenciados | Backups completos do conjunto de dados são executados com impacto insignificante no desempenho das consultas em tempo real |
| Escalonamento elástico de capacidade | A capacidade cresce com a base de usuários sem precisar rearquitetar o sistema |
Resultados e Benefícios
- Recuperação de baixa latência em escala — Recall retorna em menos de 200ms em média e menos de 800ms no P99, dando à pipeline Ask AI de ponta a ponta espaço para continuar responsiva mesmo quando os dados crescem para bilhões.
- Bilhões de vetores sem rearquitetura — A Plaud cresceu de centenas de milhões para bilhões de chunks por região, com um caminho claro para dezenas de bilhões, tudo na mesma base e sem que a recuperação se torne o gargalo.
- Operações de dados mais rápidas, zero tempo de inatividade — Backfills históricos em escala de bilhões são concluídos em dias, e atualizações de schema e cluster são executadas com zero tempo de inatividade, então o time entrega continuamente em um aplicativo global sempre ativo.
- Conformidade e desempenho globais — A implantação nativa multirregião mantém os dados de cada usuário na própria região, atendendo aos requisitos de residência de dados e entregando baixa latência a usuários em todo o mundo.
- Menor custo operacional — Um serviço totalmente gerenciado elimina o custo oculto de clusters executados internamente (configuração, ajuste, escalonamento e plantão), então a engenharia foca no produto, não na infraestrutura.
O benefício mais claro é estratégico: uma base confiável e escalável permite que os engenheiros da Plaud mudem a atenção de "a infraestrutura vai aguentar?" para "quão bom o produto pode ser?" — permitindo uma memória semântica maior, estratégias de recuperação mais sofisticadas e iteração de recursos mais rápida.
Conselhos da Plaud para equipes que criam sistemas de IA para consumidores
Tendo vivido toda a curva de crescimento, o time da Plaud oferece quatro lições para outros que estão construindo gravação por IA, memória pessoal de IA ou outros produtos de IA para consumidores:
- Escolha a infraestrutura para a escala do seu estado final. No momento em que um produto de consumo decola, os dados saltam de centenas de milhões para bilhões de chunks. Escolha um mecanismo criado especificamente para essa finalidade que escale suavemente e evite uma migração cara no futuro.
- Teste filtragem escalar e busca semântica juntas. A filtragem condicional combinada com a recuperação semântica é o teste mais realista — e mais exigente — de um mecanismo vetorial para aplicações reais de IA.
- Coloque o custo operacional na contabilidade. Sharding, escalonamento e plantão autogerenciados são custos ocultos e altos. Uma opção totalmente gerenciada zera esses custos para que o time possa focar no produto.
- Planeje cedo para alcance global e conformidade. Para uma base de usuários global, residência de dados e baixa latência multirregião se tornam requisitos obrigatórios mais cedo do que você espera.
O que vem a seguir
A Plaud planeja expandir seu uso do Zilliz Cloud, hoje focado em Agentic RAG e memória de agente, para um papel central na engenharia de contexto de agente, à medida que sua camada de memória escala para dezenas de bilhões de vetores e além.
"A Plaud é exatamente o tipo de empresa que redefine o que a IA para consumidores pode ser — e fazendo isso de forma lucrativa, em uma velocidade notável. Temos orgulho de que o Zilliz Cloud seja a base de recuperação por trás do sucesso da Plaud, e estamos animados em continuar construindo juntos enquanto eles escalam em direção ao que vem a seguir na IA agêntica."
— James Luan, CTO da Zilliz
Experimente o Zilliz Cloud gratuitamente
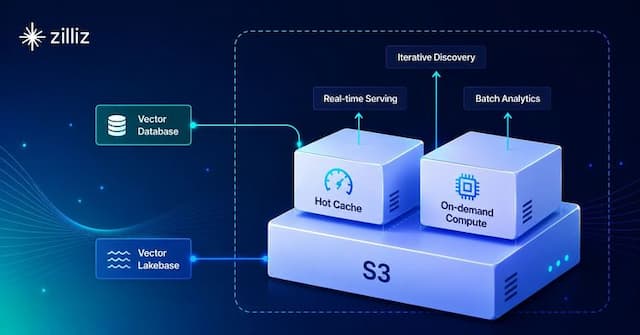
O Zilliz Cloud é um Vector Database e Vector Lakebase totalmente gerenciado para IA empresarial, compatível com as APIs do Milvus. Ele oferece busca vetorial em escala de centenas de bilhões, com alto desempenho, segurança de nível empresarial e operações sem manutenção. Agora estendido com a abertura, a escalabilidade e a economia de data lakes multimodais, ele oferece às empresas uma plataforma única para buscar, analisar e governar dados não estruturados para IA em produção.
Quer você esteja escalando RAG ou construindo memória de agentes, o Zilliz Cloud fornece a mesma base de recuperação que alimenta o Plaud. Comece a usar o Zilliz Cloud gratuitamente agora ou fale com nossa equipe.
- Sobre a Plaud
- O Desafio
- Por que a Zilliz Cloud
- A Solução
- Análise aprofundada de engenharia: construída para memória de agente
- Resultados e Benefícios
- Conselhos da Plaud para equipes que criam sistemas de IA para consumidores
- O que vem a seguir
- Experimente o Zilliz Cloud gratuitamente
Conteúdo
Caso de uso
Indústria
SaaS de IA
Escolha de acordo com a escala em que você vai acabar, não a que você tem. Os dados do consumidor crescem mais rápido do que qualquer um planeja, e uma migração desse porte é dolorosa. Entregue a infraestrutura de recuperação a especialistas e dedique suas próprias pessoas ao produto.
The engineering team, Plaud