Plaud Potenzia la Memoria degli Agenti su Scala Miliardaria con Zilliz Cloud
< 200 ms
Latenza media di richiamo
10B+
Blocchi vettoriali per regione, con spazio per crescere
Nei giorni
Backfill di dati storici su scala miliardaria, senza interruzione del servizio
Zero tempi di inattività
Modifiche allo schema e aggiornamenti del cluster su un'app sempre attiva
L'intelligenza artificiale sta passando dal rispondere a domande isolate ad agenti che ricordano, il che rende la memoria dell'IA il cuore dei prodotti di intelligenza artificiale per i consumatori. Zilliz Cloud ci offre una base solida di cui possiamo fidarci per il recupero della memoria agentica su larga scala, così il nostro team può concentrare le proprie energie sull'innovazione del prodotto e sull'esperienza utente, invece che sull'infrastruttura sottostante.
Charles Liu
Informazioni su Plaud
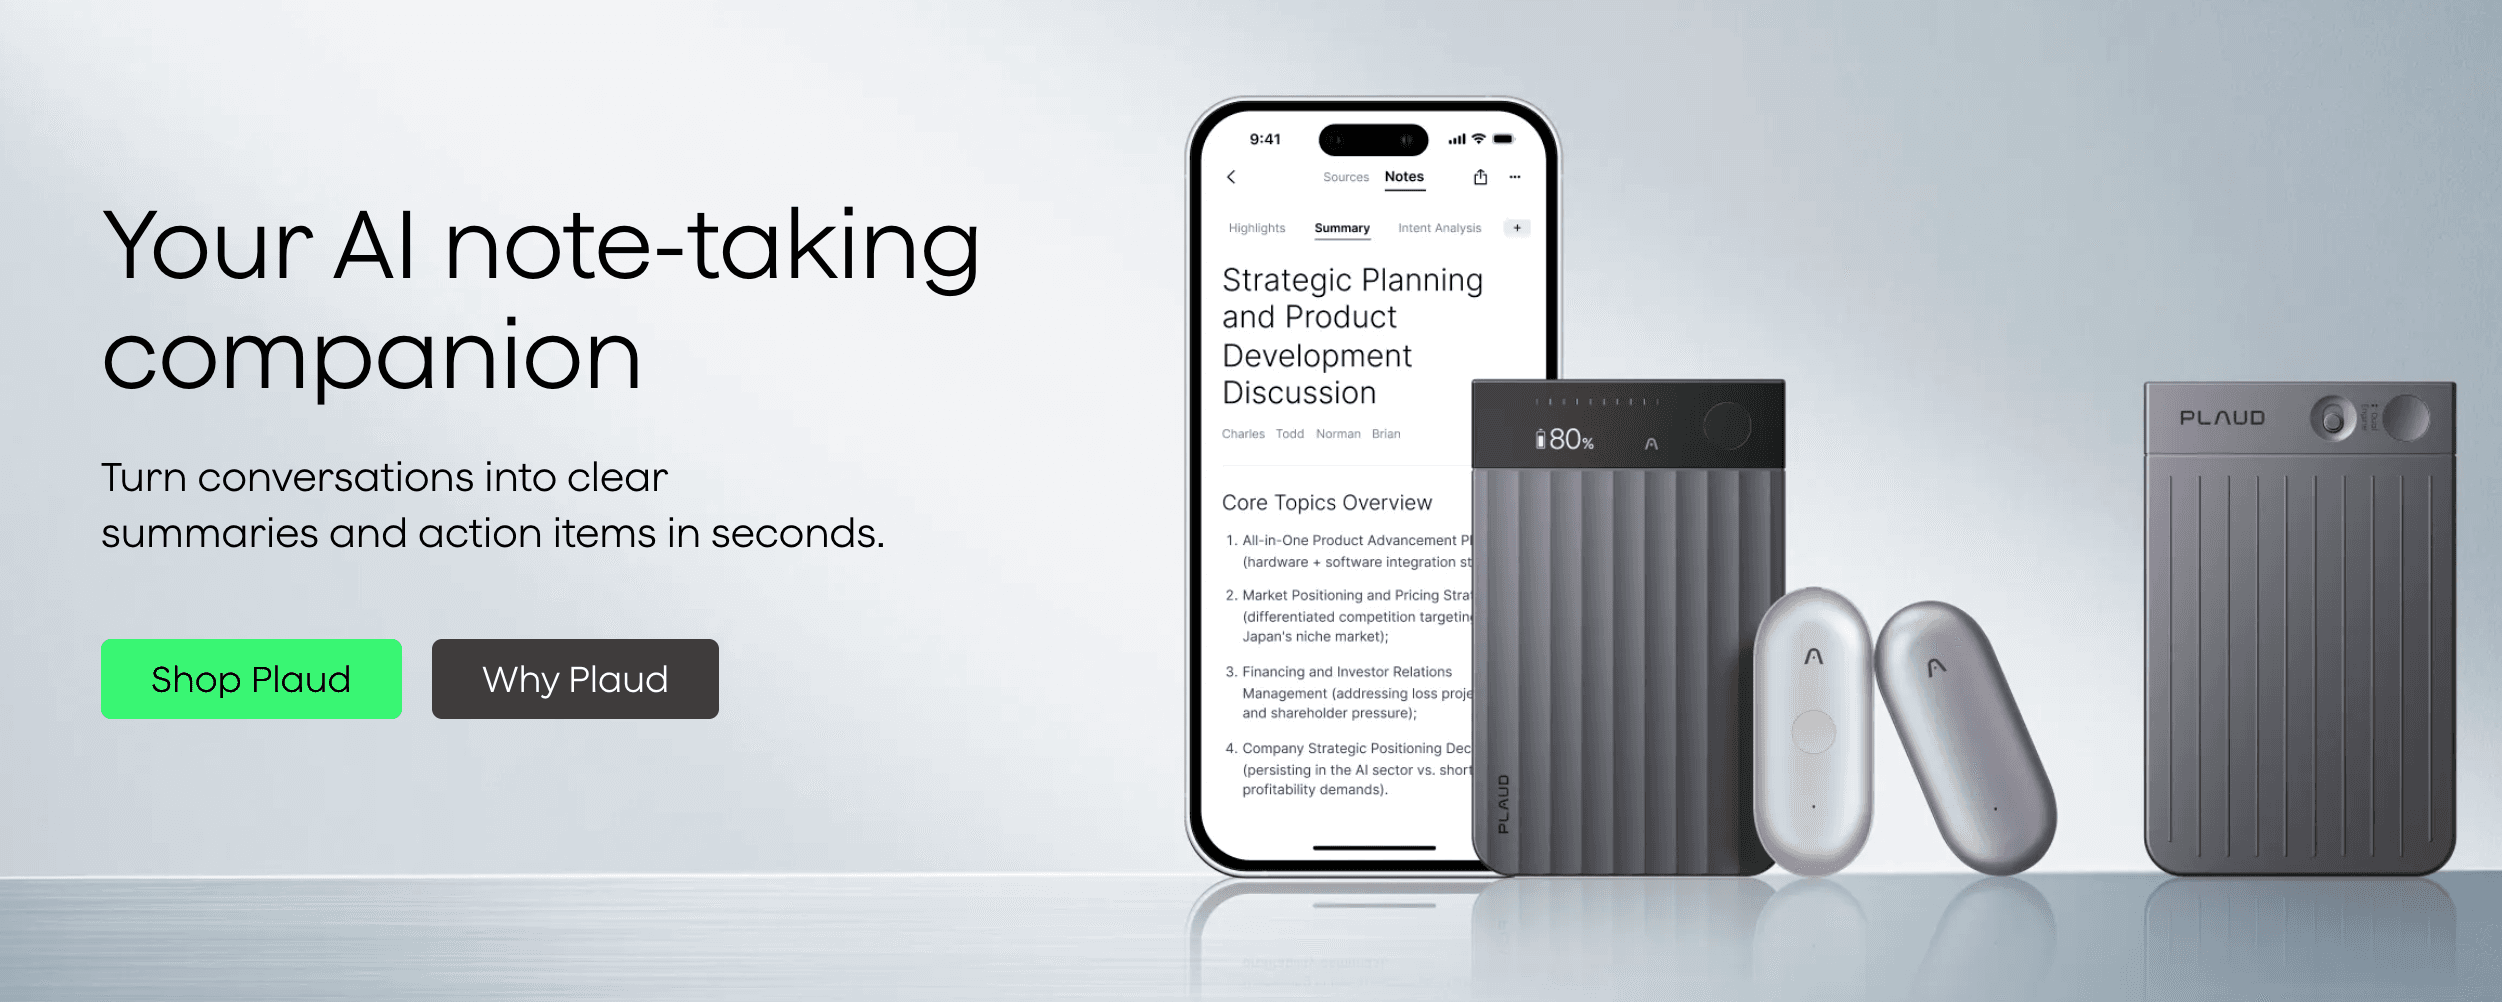
Plaud è il marchio n.1 al mondo per la presa di appunti basati sull'IA. Il suo hardware — gli assistenti AI per prendere appunti Plaud Note e Plaud Note Pro, grandi come una carta di credito, e il dispositivo indossabile Plaud NotePin S — funziona con Plaud Intelligence (disponibile su app, web e desktop) per trasformare le conversazioni quotidiane in riassunti, attività da svolgere e valore per il business. In meno di tre anni, Plaud è diventata una delle aziende di riferimento nell'hardware AI consumer: ha venduto più di 2 milioni di dispositivi in 170+ paesi ed è passata da $1M a oltre $100M di fatturato annuo ricorrente in circa due anni.
Dietro questa esperienza si nasconde un compito più difficile di quanto sembri. Ogni registrazione diventa una memoria personale di lunga durata che l'utente si aspetta di poter cercare e interrogare all'istante — moltiplicata per una base di utenti globale in rapida crescita. Archiviare e recuperare questa memoria su larga scala è il compito che Plaud affida a Zilliz Cloud.
La sfida
La memoria AI su scala consumer è uno dei carichi di lavoro di retrieval più impegnativi in produzione. Plaud ha inizialmente costruito il suo sistema di retrieval su OpenSearch, che gestiva bene ricerca e log. Ma quando il carico di lavoro si è spostato verso la ricerca semantica e ibrida su scala di miliardi, le prestazioni di retrieval e i costi di OpenSearch a quella scala non potevano più reggere il passo. Sostituire quella base significava risolvere tre forze contemporaneamente.
- Crescita esplosiva dei dati su scala consumer. Con l'accelerazione dell'adozione a livello mondiale, la memoria vettoriale di Plaud è passata da centinaia di milioni a miliardi di chunk per regione, avvicinandosi a decine di miliardi. Ogni registrazione genera inoltre ricchi metadati scalari utilizzati per filtraggio e ranking, e un prodotto consumer produce un'enorme memoria "fredda" di coda lunga — dati che un utente può ignorare per mesi, per poi averne improvvisamente bisogno — che devono rimanere economici da conservare senza rallentare le query attive.
- Un carico di lavoro semantico e agentico — non solo ricerca per parole chiave. Il caso d'uso principale di Plaud è Agentic RAG e memoria: un retrieval guidato dal significato, su scala di miliardi, che alimenta Ask Plaud e i suoi agenti. Ciò richiede una vera ricerca vettoriale ad alte prestazioni combinata con un filtraggio scalare condizionale, e scritture continue e intense che operano in parallelo a letture a bassa latenza senza interferenze. La rilevanza deve inoltre rispettare il tipo di contenuto e la recency — un riassunto dovrebbe avere la precedenza su una trascrizione grezza, e la memoria recente dovrebbe emergere per prima.
- Globale, sempre attivo e progettato per dati personali sensibili. Una base di utenti globale rende la distribuzione multi-regione e la residenza dei dati requisiti imprescindibili. Poiché le registrazioni sono profondamente personali, la piattaforma richiede una crittografia controllata dal cliente e un modello in cui nessun testo in chiaro esca mai da Plaud. E poiché il prodotto viene distribuito continuamente, il layer di retrieval stesso deve evolversi — nuovi campi, nuovi indici, aggiornamenti di versione — senza tempi di inattività.
Perché Zilliz Cloud
Plaud ha scelto Zilliz Cloud come base per questo carico di lavoro per tre motivi.
Prestazioni e stabilità comprovate su scala di miliardi. Plaud aveva bisogno di un motore che rimanesse veloce e stabile mentre i dati crescono fino ai miliardi in produzione reale — non in un benchmark. L'architettura distribuita di Zilliz Cloud sostiene ricerca ad alte prestazioni e scritture ad alta produttività su larga scala, con letture e scritture isolate per mantenere la latenza prevedibile mentre il carico di lavoro cresce.
Un modello di privacy che mantiene i contenuti degli utenti presso Plaud. Plaud invia a Zilliz Cloud solo ciò che serve al retrieval — vettori semantici e campi scalari utilizzati per il filtraggio, come i timestamp. Nessuna trascrizione, audio o testo in chiaro lascia mai Plaud. In combinazione con le chiavi di crittografia gestite dal cliente (CMEK), questo offre a Plaud un controllo forte e verificabile sulla privacy degli utenti.
Una base gestita che lascia a Plaud il controllo sulla rilevanza. Zilliz Cloud gestisce la parte difficile — storage vettoriale distribuito e retrieval su larga scala — mentre Plaud mantiene gli elementi che differenziano il suo prodotto: come costruisce vettori sparsi e densi, esegue il multi-way recall e fonde e classifica i risultati.
All'interno di Plaud, Zilliz Cloud è il livello di retrieval che alimenta ContextOS, il sistema che trasforma le registrazioni grezze in memoria utilizzabile. Il percorso dalla voce alla risposta si articola in quattro fasi:
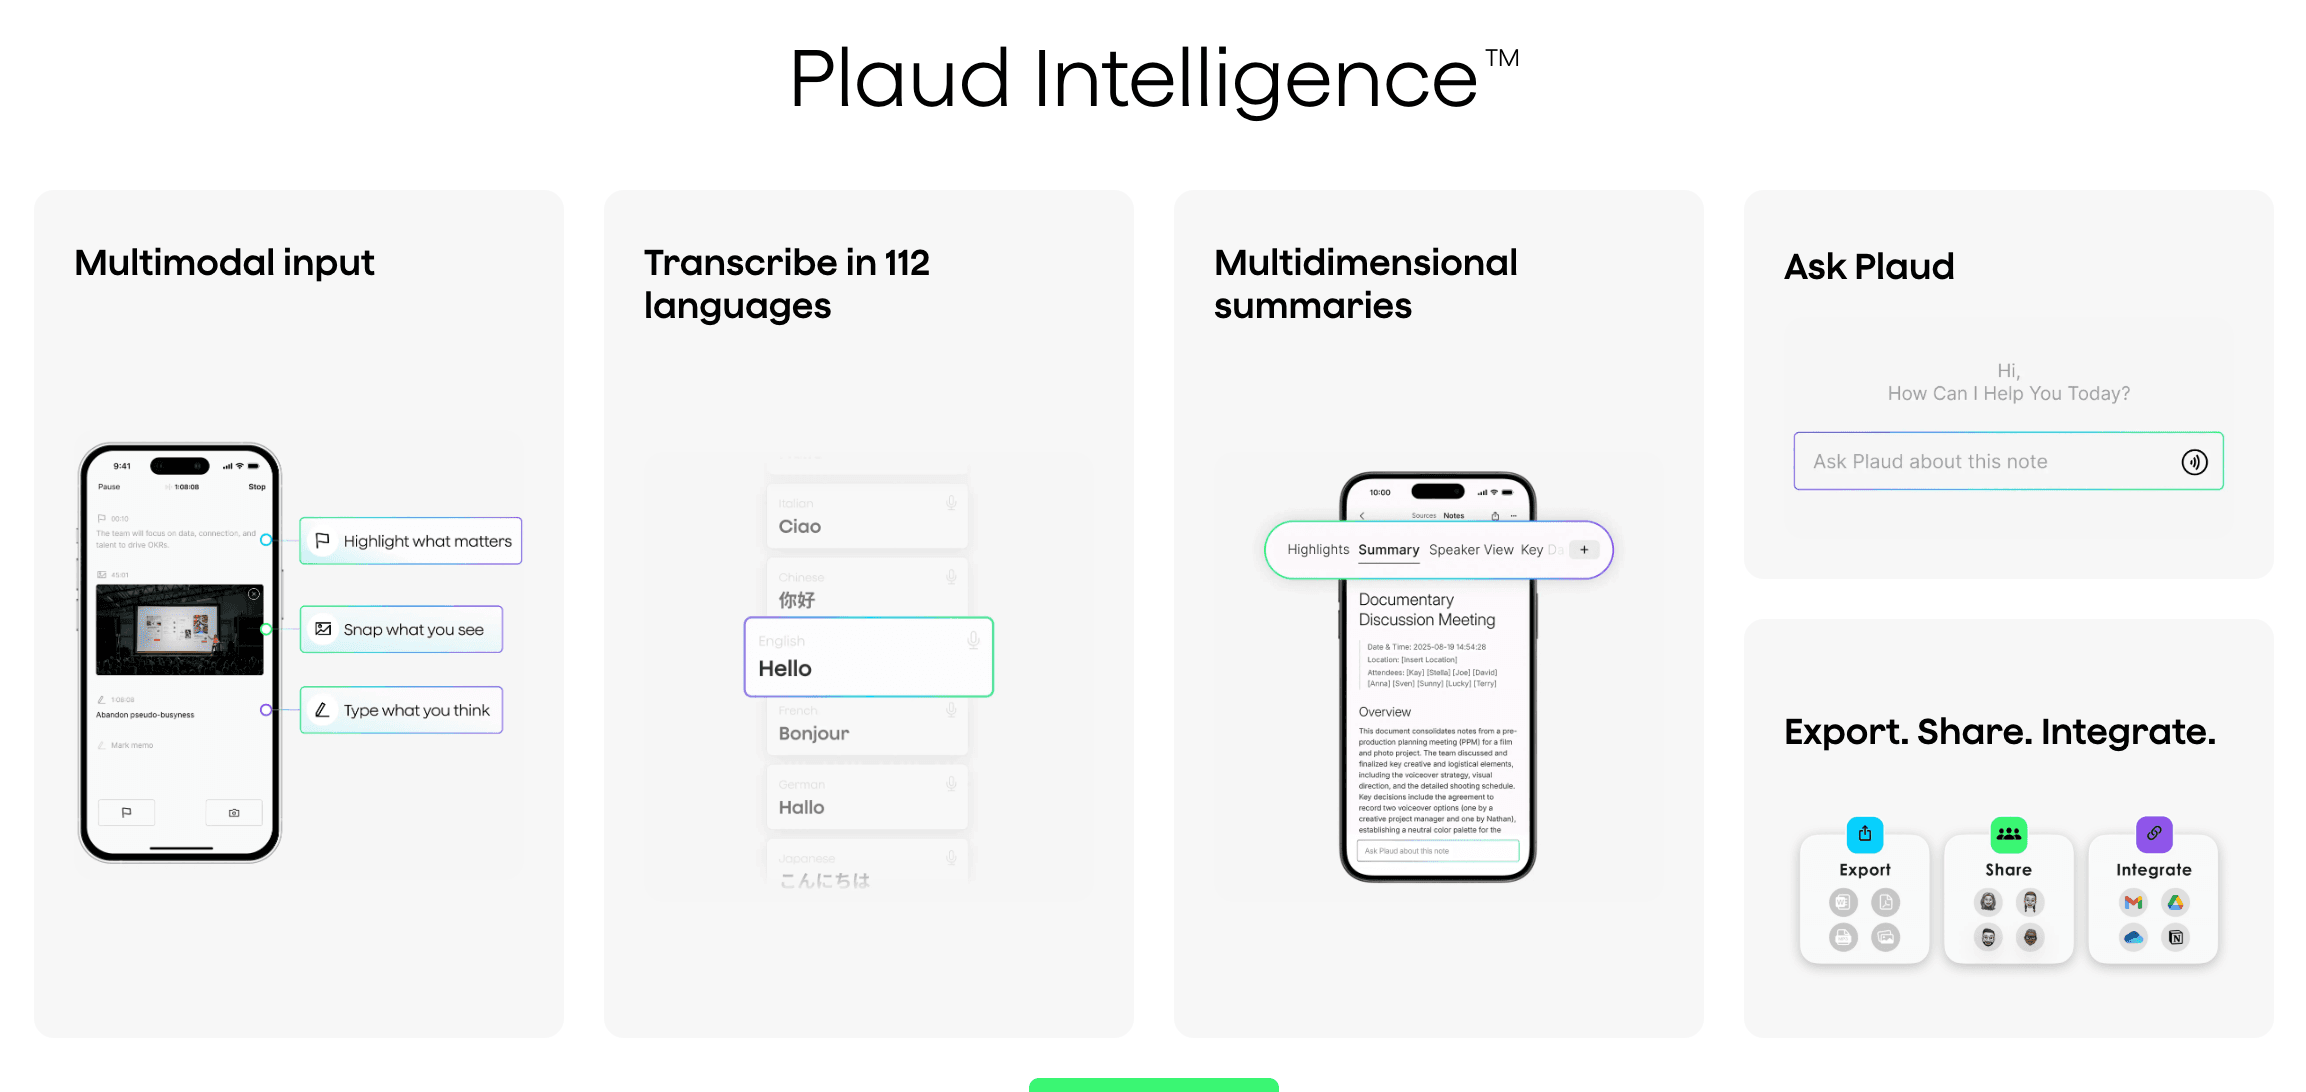
- Cattura e pre-elaborazione — L'utente termina una registrazione; il file entra nel filesystem di Plaud e viene pre-elaborato secondo necessità (ad esempio, speech-to-text e text-to-embeddings tramite modelli di intelligenza artificiale).
- Comprensione e archiviazione — ContextOS elabora il contenuto e lo scrive su Zilliz Cloud come vettori semantici più campi di filtro scalari — mai testo grezzo.
- Recupero su intento — Quando l'utente cerca o chiede qualcosa a Plaud, un agente interpreta l'intento, lo codifica in vettori e recupera il contesto più pertinente da ContextOS, con il supporto di Zilliz Cloud.
- Generazione — Il contesto recuperato funge da base per la risposta dell'agente.
Su queste fondamenta, Zilliz Cloud alimenta tre scenari di prodotto:
- Ricerca nelle registrazioni dell'utente;
- Ask Plaud (RAG), risposte basate su trascrizioni e riepiloghi;
- MAG (Memory-Augmented Generation), risposte basate sulla memoria personale a lungo termine.
Approfondimento tecnico: progettato per la memoria dell'agente
La memoria dell'agente non è il classico RAG su un insieme statico di documenti. È un contesto vivo, per singolo utente, che cresce continuamente e deve rimanere aggiornato, filtrabile e privato. Raggiungere questo livello ha richiesto un'ingegneria specifica — queste sono le capacità che il team di Plaud mette in evidenza.
Backfill di dati storici su scala miliardaria, con il servizio ancora attivo
Far crescere un prodotto di memoria significa caricare e rimodellare costantemente grandi volumi di dati storici — senza portare la ricerca offline per gli utenti che ne dipendono. Con Zilliz Cloud, Plaud esegue backfill storici su scala miliardaria come processi batch offline che si completano in giorni mentre il servizio live rimane pienamente leggibile. Set di memoria massicci vengono distribuiti in produzione senza finestra di manutenzione.
Evoluzione dello schema e aggiornamenti senza interruzioni
Un'app consumer in rapida evoluzione cambia costantemente: nuovi attributi di memoria da archiviare, nuovi campi su cui filtrare e cercare, nuove versioni di indici e motori da adottare. Zilliz Cloud consente a Plaud di aggiungere colonne dinamiche, abilitare la ricerca per parole chiave (BM25) su nuovi campi di testo e distribuire aggiornamenti di indici e cluster — tutto senza interruzioni. Plaud continua a rilasciare mentre un'app globale resta sempre attiva.
Multi-regione globale con residenza dei dati
Gli utenti di Plaud sono distribuiti tra Nord America, Europa e Asia-Pacifico e si aspettano che i propri dati siano veloci e conservati nella propria regione. Il supporto multi-regione nativo di Zilliz Cloud consente a Plaud di collocare la memoria di ciascun utente nella regione giusta per residenza e bassa latenza. L'unicità delle chiavi primarie tra cluster rende tutto ciò sicuro su larga scala — gli utenti e i loro dati possono spostarsi tra cluster regionali mentre le chiavi restano globalmente uniche — e la replica senza interruzioni rende la migrazione invisibile agli utenti.
Recupero ibrido consapevole della memoria
Nella memoria personale, la corrispondenza migliore non è sempre quella semanticamente più simile: una nota recente di solito conta più di una vecchia, e un riepilogo è spesso più utile di una trascrizione grezza. La ricerca ibrida di Zilliz Cloud combina il recupero semantico e per parole chiave con ranking a decadimento e ponderazione per tipo di documento, così Ask Plaud e i suoi agenti fanno emergere memoria che non è solo pertinente, ma anche tempestiva e del tipo giusto.
Oltre a queste iniziative principali, il carico di lavoro di Plaud si appoggia a una serie di capacità fondamentali di cui qualsiasi sistema di memoria per agenti di livello produttivo ha bisogno:
| Capacità | Perché è importante per Plaud |
|---|---|
| Filtraggio scalare condizionale con ricerca vettoriale | La memoria personale è sempre limitata a un utente e ai metadati, quindi il filtraggio deve funzionare insieme alla ricerca semantica a piena velocità |
| Isolamento lettura-scrittura | L'ingestione continua e ad alto volume opera insieme a query a bassa latenza senza che l'una degradi l'altra |
| Crittografia gestita dal cliente (CMEK) | Plaud e i suoi utenti detengono le chiavi; revocando una chiave, i dati non possono più essere decrittografati |
| Archiviazione a livelli freddo/caldo | La memoria "fredda" di coda lunga rimane economica da conservare e si riattiva automaticamente all'accesso |
| Backup e ripristino gestiti | I backup completi del dataset vengono eseguiti con un impatto trascurabile sulle prestazioni delle query in tempo reale |
| Scalabilità elastica della capacità | La capacità cresce con la base utenti senza riprogettare il sistema |
Risultati e benefici
- Recupero a bassa latenza su larga scala — I risultati vengono restituiti in meno di 200 ms in media e meno di 800 ms al P99, dando alla pipeline end-to-end di Ask AI spazio per rimanere reattiva anche mentre i dati crescono fino a miliardi.
- Miliardi di vettori senza riprogettazione — Plaud è passata da centinaia di milioni a miliardi di chunk per regione, con un percorso chiaro verso decine di miliardi, tutto sulla stessa base e senza che il recupero diventi il collo di bottiglia.
- Operazioni sui dati più veloci, zero downtime — I backfill storici su scala miliardaria vengono completati in giorni, e gli aggiornamenti di schema e cluster vengono eseguiti con zero downtime, così il team rilascia continuamente su un'app globale sempre attiva.
- Conformità globale e prestazioni — La distribuzione nativa multi-regione mantiene i dati di ogni utente nella propria regione, soddisfacendo i requisiti di residenza dei dati e offrendo al contempo bassa latenza agli utenti di tutto il mondo.
- Riduzione dell'onere operativo — Un servizio completamente gestito elimina i costi nascosti dei cluster autogestiti (configurazione, ottimizzazione, scalabilità e reperibilità), così il team di ingegneria si concentra sul prodotto, non sulle infrastrutture.
Il vantaggio più chiaro è strategico: una base affidabile e scalabile consente agli ingegneri di Plaud di spostare l'attenzione da "l'infrastruttura reggerà?" a "quanto può essere buono il prodotto?" — permettendo una memoria semantica più ampia, strategie di recupero più sofisticate e un'iterazione più rapida delle funzionalità.
I consigli di Plaud per i team che sviluppano sistemi di IA consumer
Avendo vissuto l'intera curva di crescita, il team di Plaud offre quattro insegnamenti a chi costruisce sistemi di registrazione basati su IA, memoria personale basata su IA o altri prodotti di IA consumer:
- Scegli l'infrastruttura per la scala del tuo stato finale. Nel momento in cui un prodotto consumer decolla, i dati passano da centinaia di milioni a miliardi di chunk. Scegli un motore progettato per scalare senza intoppi ed evita una migrazione costosa in seguito.
- Testa insieme il filtraggio scalare e la ricerca semantica. Il filtraggio condizionale combinato con il recupero semantico è il test più realistico — e più impegnativo — per un motore vettoriale in applicazioni di IA reali.
- Metti in conto i costi operativi. Lo sharding autogestito, la scalabilità e la reperibilità sono costi nascosti ed elevati. Un'opzione completamente gestita li azzera, così il team può concentrarsi sul prodotto.
- Pianifica presto la portata globale e la conformità. Per una base utenti globale, la residenza dei dati e la bassa latenza multi-regione diventano requisiti imprescindibili prima di quanto ti aspetti.
Prossimi passi
Plaud prevede di espandere il proprio utilizzo di Zilliz Cloud, passando dall'odierno Agentic RAG e memoria degli agenti a un ruolo centrale nell'ingegneria del contesto dei propri agenti, man mano che il suo livello di memoria scala a decine di miliardi di vettori e oltre.
"Plaud è esattamente il tipo di azienda che ridefinisce cosa può essere l'IA consumer — e lo fa in modo redditizio, a una velocità notevole. Siamo orgogliosi che Zilliz Cloud sia la base di recupero dietro il successo di Plaud, e siamo entusiasti di continuare a costruire insieme mentre scalano verso il futuro dell'IA agentica."
— James Luan, CTO di Zilliz
Prova Zilliz Cloud gratis
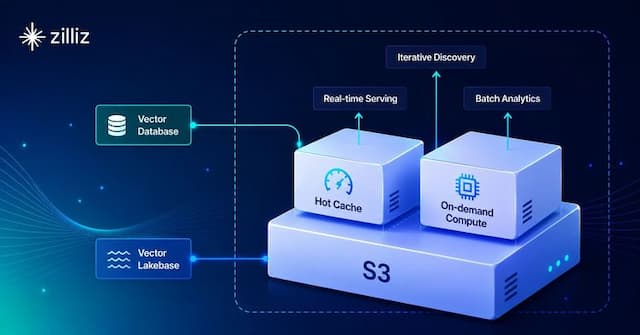
Zilliz Cloud è un Vector Database e Vector Lakebase completamente gestito per l'AI enterprise, compatibile con le API di Milvus. Offre una ricerca vettoriale su scala di centinaia di miliardi con elevate prestazioni, sicurezza di livello enterprise e operazioni a manutenzione zero. Ora esteso con l'apertura, la scalabilità e l'economicità dei data lake multimodali, offre alle aziende un'unica piattaforma per cercare, analizzare e governare i dati non strutturati per l'AI in produzione.
Che tu stia scalando la RAG o costruendo la memoria degli agenti, Zilliz Cloud fornisce la stessa base di retrieval che alimenta Plaud. Inizia ora gratuitamente con Zilliz Cloud o parla con il nostro team.
Scegli in base alla scala a cui arriverai, non a quella che hai. I dati dei consumatori crescono più velocemente di quanto chiunque pianifichi, e una migrazione di quella portata è dolorosa. Affida l'infrastruttura di recupero agli specialisti e impiega le tue persone sul prodotto.
The engineering team, Plaud