




オープンソースベクターデータベース トップ5:2025年版 包括的比較ガイド
はじめに
ベクトル検索は、ベクトル類似検索とも呼ばれ、実験的な技術から多くのAIアプリケーションに不可欠なコンポーネントへと急速に進化してきました。開発者や技術リーダーとして、従来のデータベースでは効率的に処理するように設計されていなかった類似性ベースのクエリを扱う方法を、私たちはますます求めるようになっています。
製品レコメンデーションシステムを構築している場合でも、セマンティック検索を実装している場合でも、根本的な課題は同じです。潜在的に巨大なデータセットの中から、クエリベクトルに対する「最近傍」をどのように効率的に見つけるか、ということです。そこでベクトル検索エンジンの出番です。
良いニュースは、オープンソースコミュニティが複数の高品質な選択肢を提供してきたことです。難しい部分は何でしょうか?自分の特定のユースケース、技術要件、チームの専門知識にどれが適しているかを見極めることです。
このガイドでは、現在利用可能な最も人気のあるオープンソースのベクトル検索エンジンを概観し、それぞれの強みと制限を比較し、十分な情報に基づいた意思決定に役立つ実践的な洞察を提供します。技術的な基礎から具体的な実装上の考慮事項まで、実世界のアプリケーションに焦点を当てて取り上げます。
ベクトル検索の理解:中核概念
特定のエンジンに踏み込む前に、ベクトル検索が実際に何を含むのかについて、共通理解を確立しましょう。
ベクトル埋め込みとは?
ベクトル検索の中核は、データをベクトルに埋め込むことに依存しています。つまり、情報(テキスト、画像、音声、その他あらゆるデータ型)を、意味を捉える浮動小数点数のリストに変換することです。これらのベクトルは通常、数十から数千の次元に及びます。
たとえば、テキスト埋め込みモデルは、"The weather is nice today" という文を384次元のベクトルにエンコードし、"It's a beautiful day" のような意味的に類似した文が、この高次元空間内で近くに位置するようにすることができます。
ベクトル検索と従来の検索
従来の検索エンジンは通常、転置インデックスと厳密なキーワード一致を使用します。対照的に、ベクトル検索は、厳密なキーワードの重複に関係なく、類似した項目を見つけるためにベクトル間の距離を測定します。
次のアプローチを考えてみましょう。
従来のキーワード検索は、"red leather jacket" を、まさにそれらの単語を含むドキュメントと一致させます。しかし、ベクトル検索は、厳密な用語一致を必要とするのではなく意味的類似性を理解するため、"scarlet biker coat" と説明されている場合でも、"red leather jacket" と概念的に類似した項目を一致させることができます。
主要なパフォーマンス指標
ベクトル検索エンジンを評価する際には、いくつかの指標が重要です。
クエリ速度はミリ秒または秒間クエリ数(QPS)で測定され、結果がどれだけ速く返されるかを示します。再現率は、本来取得されるべき関連結果と比較して、実際に取得された関連結果の割合を表します。インデックス構築時間は検索インデックスの作成にかかる時間を示し、メモリ使用量はインデックス作成とクエリ実行の両方におけるRAM要件を反映します。スケーラビリティは、パフォーマンス低下を経験することなく、増加するデータ量とクエリ負荷に対応するシステムの能力を指します。
これらの基礎を理解することで、特定のエンジンの探究に向けた枠組みが整います。
人気のベクトル検索ユースケース
ベクトル検索は単なる理論的概念ではありません。今日構築されている最も革新的なアプリケーションの一部を支えています。以下は、ベクトル検索エンジンが大きな影響を与えている主要なユースケースです。
検索拡張生成(RAG)
RAG は、ベクトル検索の最も一般的なアプリケーションの1つとなっており、大規模言語モデルの力と知識検索を組み合わせています。RAG の実装では、ドキュメントはベクトル埋め込みに変換され、Milvus、Faiss、Zilliz Cloud のようなベクトルデータベースに保存されます。クエリが届くと、システムはベクトル類似性に基づいて最も関連性の高いドキュメントを取得します。これらの取得されたドキュメントは LLM にコンテキストを提供し、より正確で最新の応答を可能にします。
このアプローチは、LLM におけるハルシネーション問題への対処に役立つと同時に、トレーニングデータに含まれていなかったドメイン固有の情報にアクセスできるようにします。
AI エージェントと知識検索
AI agents は、多くの場合、さまざまなソースに散在する関連情報に基づいて意思決定を行う必要があります。ベクトル検索により、これらのエージェントは大規模なナレッジベースからコンテキストに関連する情報を迅速に取得し、類似した過去のやり取りや意思決定を特定し、意味的類似性を理解するメモリシステムを構築できます。
AI エージェントを構築する開発者にとって、ベクトルデータベースの選択は、パフォーマンスと機能の両方に大きな影響を与える可能性があります。
レコメンデーションシステム
Eコマースプラットフォーム、ストリーミングサービス、コンテンツサイトは、エンゲージメントを高めるためにレコメンデーションエンジンに大きく依存しています。ベクトル検索は、ユーザーの好みやアイテムの特徴をベクトルとして表現し、ユーザーが以前に好んだアイテムに類似したアイテムを見つけ、類似した嗜好プロファイルを持つユーザーを特定することで、これらのシステムを支えています。
適切なベクトル検索エンジンは、ランダムに感じられるレコメンデーションと、ユーザーの好みを直感的に理解しているように見えるレコメンデーションとの違いを生み出すことができます。
セマンティック検索アプリケーション
単なるキーワードではなく意味を理解するテキスト検索は、私たちが情報とやり取りする方法を変革しています。ベクトル検索により、用語が異なる場合でも概念的に類似したドキュメントを見つけ、クエリの背後にあるユーザーの意図を理解し、言語を超えて概念が一致する多言語検索をサポートできます。
画像およびマルチメディア類似検索
テキストを超えて、ベクトル検索は類似した画像、音声、または動画の検索に優れています。この機能は、Eコマースで視覚的に類似した商品を特定する、類似した音響特性を持つ音楽を見つける、ほぼ重複するメディア資産を検出する、といったアプリケーションを支えています。
これらのアプリケーションには、多様な埋め込みタイプを効率的に処理できるベクトルエンジンが必要です。
ここまでで、ベクトル検索の本質と一般的なユースケースについて学びました。次に、特にオープンソースの選択肢を中心に、主要なベクトルデータベースを見ていきましょう。
Milvus
Milvus は、GitHub で 35,000 stars 以上を獲得している最も人気のあるオープンソースのベクトルデータベースです。2019年に初めて登場し、それ以来、開発者コミュニティで大きな注目を集めてきました。大規模な類似検索を処理するために特別に作られた Milvus は、ベクトルデータ管理特有の課題に対処するためにゼロから設計されました。
アーキテクチャと技術的機能
Milvus は、ストレージ層とコンピュート層を分離したクラウドネイティブアーキテクチャを使用しています。ステートレスなクエリノードが検索リクエストを処理し、ストレージノードがデータの永続性を管理し、コーディネーターノードがクラスター管理を担当します。この分離により、データ量とクエリ負荷が増加するにつれて Milvus は水平方向にスケールできます。これは本番環境へのデプロイにおいて重要な考慮事項です。
このプラットフォームは、HNSW(Hierarchical Navigable Small World)、IVF(Inverted File)、DiskANNなど、複数のインデックスタイプをサポートしており、開発者がさまざまなワークロードに合わせて最適化できる柔軟性を提供します。Milvusはまた、ベクトル類似性とスカラー フィルタリングおよび全文検索を組み合わせるハイブリッド検索機能も提供しており、検索で意味的類似性とキーワードマッチングの両方、さらにメタデータ制約を考慮する必要がある場合に有用です。
Milvusは、Euclidean、Cosine、Inner Productなど、複数の距離メトリクスをサポートしており、さまざまな埋め込みタイプや類似性の定義に適応できます。そのストレージアーキテクチャにはタイムトラベル機能が含まれており、特定時点のクエリやバックアップを可能にします。
Milvusは、Jupyter Notebooksでローカルに実行されるデモから、数百億のベクトルを処理する大規模なKubernetesクラスターまで、さまざまなタイプのAIアプリケーションの構築に使用できます。現在、Milvusのデプロイメントオプションは3つあります:Milvus Lite、Milvus Standalone、Milvus Distributedです。
パフォーマンス特性
ベンチマークでは、Milvusは百万規模のデータセットに対して通常1桁ミリ秒のクエリレイテンシを示し、リアルタイムアプリケーションに適しています。このプラットフォームは、完全な再現率と引き換えに大幅な速度向上を実現するANNS(Approximate Nearest Neighbor Search)アルゴリズムをサポートしており、これは実用的なアプリケーションにとって不可欠なトレードオフです。
Milvusのメモリ使用量は、メモリキャッシュを備えたディスクベースのストレージによって管理され、利用可能なRAMより大きいデータセットを処理できます。このアプローチにより、Milvusは純粋なインメモリソリューションと比較して、大規模なベクトルコレクションに対してよりコスト効率が高くなります。
ほとんどの本番ワークロードにおいて、Milvusは再現率の精度とクエリ速度のバランスを取り、特定の要件に合わせて調整可能なパラメーターを提供します。ただし、この柔軟性には、構成と最適化における複雑さの増加が伴います。
移行の簡単さ
Milvusの注目すべき利点は、他のベクトルデータベースからの移行パスがわかりやすいことです。Vector Transport Service (VTS) ツールのようなオープンソースの移行ツールを通じて、他のベクトル検索エンジンからMilvusへのデータ移行が簡素化されます。このツールは、転送プロセス中の自動スキーママッピング、増分データ移行、データ検証をサポートします。これにより、Milvusは現在のソリューションでは手狭になったチームや、単一プラットフォームへの標準化を望むチームにとって特に魅力的です。
とはいえ、移行には常に一定の労力とリスクが伴うため、これらのツールを使用する場合でも、徹底したテストは依然として必要です。
Zilliz Cloud:フルマネージドMilvus
オープンソースのMilvusはそれ単体でも強力ですが、本番レベルのアプリケーションを構築する際には、デプロイ、運用、保守のためにローカルマシンとエンジニアリングリソースが必要です。Milvusを支えるエンジニアリングチームであるZillizは、Zilliz Cloud上にフルマネージドのMilvusを作成し、顧客の運用上のオーバーヘッドをすべて取り除くことで、インフラ管理にすべてのリソースを割くのではなく、創造とビジネスにより多く投資できるようにしています。
このZilliz Cloudサービスは、追加の機能セット、簡素化されたデプロイと運用、自動スケーリングとリソース管理、高度なセキュリティ機能、SLAに裏付けられた信頼性を提供します。このマネージドサービスには継続的な更新と最適化も含まれており、社内の専門知識の必要性をなくします。
インフラストラクチャの管理よりもアプリケーションの構築に重点を置くチームにとって、Zilliz Cloud は運用上のオーバーヘッドなしに Milvus を活用する方法を提供します。
コミュニティとエコシステム
Milvus のエコシステムは大きく成長しており、定期的なリリースが行われる活発な GitHub リポジトリを備えています。このプロジェクトは、Python、Java、Go、その他の言語向けのクライアント SDK に加え、LangChain や LlamaIndex を含む人気の AI モデルや ML フレームワークとの統合を提供しています。さらに、成長を続けるコミュニティフォーラムと包括的なドキュメントも備えています。
このエコシステムの成熟度により、実装リスクが低減され、トラブルシューティングのための複数のリソースが提供されます。ただし、他のオープンソースプロジェクトと同様に、コミュニティサポートは有料サポートオプションと比較すると予測しにくい場合があります。
Faiss
Faiss は Facebook AI Similarity Search の略で、Facebook AI Research(現在の Meta)によって開発され、2017 年にオープンソース化された人気のベクトル検索ライブラリです。この比較における他のいくつかの選択肢とは異なり、Faiss は研究者によって研究者のために作成され、当初は学術的および実験的なワークロードに焦点を当てていましたが、その後本番システムにも採用されるようになりました。
技術概要
Faiss は、他のいくつかのベクトル検索ソリューションとは異なるアプローチを取っています。パフォーマンスのために Python バインディングを備えた C++ で実装されており、スタンドアロンのサービスではなくライブラリとして設計されています。際立った特徴の 1 つは、CPU と GPU の両方での実行に最適化されていることであり、特定のワークロードでは GPU ハードウェア上で劇的な高速化が見られます。
このライブラリは、さまざまなシナリオに合わせて調整された複数のインデックスタイプを提供します。IndexFlatL2 は、完全な精度を実現するために L2 距離による厳密検索を提供します。IndexIVFFlat は、クエリ速度を向上させるためにフラットストレージを備えた転置ファイルを実装します。IndexHNSW は、効率的な近似検索のために Hierarchical Navigable Small World グラフを活用します。IndexPQ は、メモリ効率のために product quantization を利用し、控えめなハードウェアでも数十億のベクトルを検索できるようにします。
強みと制限
Faiss の主な強みの 1 つは、生のパフォーマンスです。適切に構成すれば、インメモリのベクトル検索において最速の選択肢となることがよくあります。 このライブラリは、product quantization などの巧妙な圧縮技術によってメモリ効率を実現し、ベクトルストレージ要件を 1 桁削減できます。
Faiss は、さらに高速な処理を可能にするネイティブ GPU サポートでも際立っており、GPU リソースにアクセスできる研究環境に最適です。このライブラリは、ワークロードを最適化したいユーザー向けに、詳細なパラメータ調整オプションによるきめ細かな制御を提供します。
ただし、Faiss には顕著な制限があります。組み込みの永続化レイヤーがないため、開発者はインデックスの保存と読み込みを自分で処理する必要があります。サービスではなくライブラリであるため、ターンキーソリューションよりも多くの統合作業が必要です。Faiss はまた、追加のエンジニアリング作業なしでは分散デプロイメントにはあまり適していません。そのため、多くの開発者は実験やプロトタイピングに Faiss を使用しています。
おそらく最も重要なのは、Faiss は一部の代替手段よりも学習曲線が急であることです。ドキュメントは包括的ではあるものの、基礎となるアルゴリズムや技術についての深い理解を前提としています。
Annoy
Annoy は "Approximate Nearest Neighbors Oh Yeah" の略で、Spotify によって開発され、2013 年にオープンソース化されました。この比較の中では比較的古いソリューションの 1 つです。Spotify の音楽レコメンデーションシステムを支えるために特別に作成された Annoy は、比較的静的なデータを伴う読み取り主体のワークロードに最適化された独自のアプローチを取っています。
近似最近傍アプローチ
Annoyは、ランダム射影二分探索木をコアアルゴリズムとして使用します。各木はベクトル空間を異なる方法で分割し、真の最近傍を集合的にうまく近似する木のフォレストを作成します。フォレストに木が追加されるほど、真の最近傍を見つける確率が高まり、精度とリソース使用量の間でトレードオフが可能になります。
このアプローチは、多くの新しいベクトル検索エンジンで使用されているグラフベースの手法とは大きく異なります。
パフォーマンスのトレードオフ
Annoyは、より汎用的なソリューションとは一線を画す特定のトレードオフを行います。読み取りに最適化されており、クエリ時に非常に高速なパフォーマンスを提供しますが、その代償として書き込みの柔軟性が犠牲になります。一度構築されると、Annoyのインデックスは変更されません。新しいデータにはインデックスの再構築が必要です。
このシステムはディスクベースで、効率化のためにメモリマップできるインデックスを備えています。これにより、Annoyは良好なクエリパフォーマンスを維持しながら、利用可能なRAMより大きなデータセットを処理できます。ただし、Annoyは中核となる近似最近傍検索以外の機能が限られており、より包括的なソリューションに見られる多くの機能を欠いています。
これらの設計上の選択により、Annoyは頻繁な更新や複雑なクエリ向けに設計されたデータベースとは異なります。
統合オプション
Annoyはscikit-learn互換のPythonバインディングを提供しており、データサイエンティストやMLエンジニアが利用しやすくなっています。そのC++コアは、簡素化されたAPIにもかかわらず優れたパフォーマンスを提供します。このライブラリはインデックスのシリアライズとデシリアライズを容易にサポートし、オフラインでのビルドプロセスを促進します。
APIはシンプルで、最近傍検索のみに焦点を当てているため習得しやすいですが、機能は限定的です。より包括的なベクトルデータベースとは異なり、Annoyでは永続化、スケーリング、クエリフィルタリングなどの機能に追加のインフラストラクチャが必要です。
Weaviate
Weaviateは、ベクトル検索への異なるアプローチとして2019年に登場しました。純粋なベクトルデータベースとは異なり、Weaviateはベクトル検索機能とナレッジグラフを組み合わせ、類似性クエリに文脈理解を追加するよう設計されたハイブリッドシステムを作成します。
Weaviateを際立たせているのは、そのグラフベースのデータモデルです。Weaviateでは、データオブジェクトを意味的な関係で接続でき、これらの接続がベクトルベースのクエリにコンテキストを追加します。これにより、クエリはベクトル類似性とグラフトラバーサルを組み合わせることができ、単純な最近傍マッチングよりも高度な検索をサポートします。たとえば、あるデプロイメントでは商品埋め込みを保存し、商品、カテゴリ、ブランド間の関係もモデル化する場合があります。ユーザーのクエリは、類似したアイテムだけでなく、共有属性や行動を通じて接続されたアイテムも返すことができます。
このハイブリッドモデルは表現力豊かなクエリを可能にしますが、データモデリングとインデックス作成に追加の複雑さももたらします。開発者はベクトル埋め込みとグラフ関係の両方を管理する必要があり、学習曲線と運用上のオーバーヘッドが増える可能性があります。
Weaviateは効率的なベクトル検索のためにHNSWベースのインデックスを使用し、検索前または検索後に適用できる柔軟なフィルタリングをサポートします。シャーディングによってスケールし、増大するデータセットとクエリ負荷を処理できます。ただし、分散構成は、特に大規模になると設定と運用がより複雑になる可能性があります。
Weaviateはさまざまなユースケースで良好に機能しますが、純粋なベクトル検索ベンチマークで常に最高性能を示すとは限りません。追加のグラフ機能は強力である一方、ベクトル検索と複数の関係トラバーサルを組み合わせた複雑なクエリを実行する際には応答時間が遅くなる可能性があります。そのため、高スループットのベクトルのみのワークロードで超低レイテンシを必要とするアプリケーションよりも、文脈的な強化の恩恵を受けるアプリケーションにより適しています。
Qdrant
Qdrant(「quadrant」と発音)は、ベクトルデータベース分野への比較的新しい参入者で、2021年に初めて登場しました。Qdrantはデータベースとやり取りするためのREST APIとgRPC APIの両方を提供しており、事実上あらゆるプログラミング言語からアクセスできます。そのストレージは、従来のデータベースにおけるテーブルに似たコレクションとして分離されており、異なるデータ型の論理的な分離を提供します。このアーキテクチャは、データの信頼性のためにポイントインタイムの一貫性保証とACID準拠の操作を提供します。このアプローチにより、従来のデータベースのバックグラウンドを持つ開発者にとってQdrantはより馴染みやすくなり、学習曲線が緩和されます。
Qdrantの大きな強みは、ベクトル検索と従来型のフィルタリングを組み合わせられる点です。このプラットフォームは、検索プロセスの一部として効率的に実行される豊富なフィルター式を提供します。ペイロードベースのフィルタリングは、後処理ステップとして適用されるのではなく、検索に直接統合されます。また、複数のフィールドにまたがるAND、OR、NOT操作を含む複雑なブール条件をサポートし、特定のフィルター条件に基づいて結果をブーストすることもできます。これは、ハイブリッド検索におけるきめ細かなランキングに役立ちます。
ただし、このフィルタリングの柔軟性にはトレードオフがあります。フィルター式が複雑になったりデータセットが拡大したりすると、特に高カーディナリティのフィールドに多数のフィルターが適用される場合、クエリ性能が低下する可能性があります。さらに、Qdrantは分散デプロイメントをサポートしているものの、その水平スケーリング機能は、より成熟したシステムと比較するとまだ進化途上であり、大規模クラスタリングに関する運用ツールも比較的限られています。これらの要素は、高スケールまたは非常に動的なワークロード向けにQdrantを評価する際に考慮すべきです。
比較表:主要ベクトル検索エンジンの主な機能
| エンジン | アーキテクチャ | フィルタリング | マネージドオプション | 分散 | 更新頻度 |
| Milvus | クラウドネイティブ、ストレージ/コンピュート分離 | 優秀 | Zilliz Cloud | はい | リアルタイム |
| Faiss | ライブラリ、Pythonバインディング付きC++ | 限定的 | いいえ | 手動 | バッチ |
| Annoy | バイナリツリーのフォレスト | なし | いいえ | いいえ | オフラインのみ |
| Weaviate | ナレッジグラフ + ベクトルDB | 良好 | Weaviate Cloud | はい | リアルタイム |
| Qdrant | Rustベース、コレクション | 良好 | Qdrant Cloud | はい | リアルタイム |
その他の注目すべきベクトル検索オプション
上で取り上げた主要な専用オプション以外にも、多くの従来型データベースがアドオンとしてベクトル検索機能を提供し始めています。
ベクトル検索を備えたElasticsearch
テキスト検索で既に広く採用されているElasticsearchは、最近のバージョンでベクトル検索機能を追加しました。この機能は、ElasticsearchエコシステムにkNN(k-Nearest Neighbors)検索を導入し、組織がベクトル検索要件に既存のインフラストラクチャを活用できるようにします。
既存のElasticsearch機能との統合により、チームは単一のプラットフォーム上で、従来型のテキスト検索、ファセット、集計とベクトル類似度を組み合わせることができます。馴染みのあるAPIにより、既にElasticsearchを使用しているチームの学習曲線が緩和されます。
このアプローチは、まったく新しいデータベースを採用せずにベクトル機能を追加する必要がある、Elasticエコシステムに既に投資している組織に適しています。ただし、大規模なベクトル専用ワークロードでは、性能が専用のベクトルデータベースに匹敵しない可能性があります。
Vespa
VespaはYahooのオープンソース検索エンジンで、従来型検索、ベクトル検索、高度なランキングを単一のプラットフォームで組み合わせます。リアルタイムのインデックス作成と検索を提供し、バッチ処理やインデックスの再構築を必要とする一部のソリューションとは異なり、更新は即座にクエリで利用可能になります。
このプラットフォームは、ベクトル類似度、テキスト関連性、ビジネスルールなど、複数のシグナルを組み合わせられる高度なランキングフレームワークを提供します。分散アーキテクチャにより大規模なデプロイメントに対応し、大手インターネット企業の本番環境で実戦投入されてきました。
Vespaの包括的な機能セットは複雑な検索アプリケーションに適していますが、その分、より特化したソリューションと比べて複雑性が増します。よりシンプルなベクトル検索オプションよりも、デプロイと保守に多くのリソースを必要とします。
pgvector
pgvectorは、PostgreSQLにベクトルデータ型と演算を追加する拡張機能で、従来型のリレーショナルデータベース内でベクトル検索を可能にします。ベクトル列に対する効率的な類似検索のために、IVFやHNSWを含む複数のインデックスタイプをサポートしています。
主な利点は、ベクトルデータとリレーショナルデータを組み合わせたSQLクエリを使用できることで、別個のデータベースを採用することなく既存のアプリケーションにベクトル検索を簡単に追加できます。この選択肢は既存のPostgreSQLインフラストラクチャと専門知識を活用するため、運用上のオーバーヘッドを削減できる可能性があります。
主な制限は、非常に大規模なベクトルコレクションや高いクエリ量に対して、パフォーマンスが専用のベクトルデータベースに及ばない可能性があることです。これは、ベクトルのみのワークロードに最適化されたソリューションというより、現実的な妥協案を示しています。最も重要なのは、将来的にAIワークロードにSQLは本当に必要なのか?
新たに登場している選択肢
ベクトルデータベースの分野は、新しいプロジェクトの参入により進化し続けています。ChromaはLLMアプリケーション向けの埋め込みに特化しており、RAG実装のための簡素化されたAPIを提供します。Marqoはシンプルさとクラウドネイティブな運用を重視し、ベクトル検索の運用負担を軽減することを目指しています。LanceDBは組み込み型のベクトル検索機能を提供し、エッジデバイスやオフラインで動作する必要のあるアプリケーションを対象としています。
これらの新興の選択肢は、この分野でイノベーションが継続していることを示していますが、一般的には、より確立されたソリューションの本番運用の実績やエコシステムの成熟度には及びません。
適切なベクトル検索エンジンの選択
非常に多くの選択肢がある中で、適切なベクトル検索エンジンを選ぶには、具体的なニーズと制約を慎重に検討する必要があります。
意思決定フレームワーク
ベクトル検索エンジンを評価する際は、まずスケール要件を検討することから始めます。現在および将来にわたって、どれだけの数のベクトルを保存し、クエリするのかという点です。エンジンごとにスケーリング特性や得意な領域は異なります。
次に、クエリパターンを評価します。純粋なベクトル検索を行うのか、それともベクトル類似度をフィルタリング、関係のトラバーサル、その他の操作と組み合わせる必要があるのか。純粋なベクトル検索には優れていても、複雑なハイブリッドクエリには苦労するエンジンもあります。
更新頻度も重要な検討事項です。データが頻繁に変化する場合やリアルタイム更新が必要な場合、インデックスの再構築を必要とするAnnoyのようなソリューションは問題になります。逆に、データが比較的静的であれば、よりシンプルなアーキテクチャがパフォーマンス上の利点をもたらす場合があります。
統合のニーズも重要です。スタンドアロンのサービスが必要なのか、アプリケーションに組み込むライブラリなのか、それとも既存データベースへの拡張機能なのか。現在のインフラストラクチャとチームの専門知識によっては、特定の選択肢が他よりも実用的になる場合があります。
最後に、特定の技術に関するチームの専門知識を考慮してください。紙の上で最も優れた技術的ソリューションであっても、チームがそれを効果的に実装し維持するスキルを持っていなければ、最良の選択とは限りません。
スケーリングに関する考慮事項
エンジンによってスケーリングへのアプローチは異なり、これらの違いを理解することは長期的な成功を達成するうえで極めて重要です。Milvus はストレージとコンピュートを分離した水平スケーリングを提供し、ニーズの変化に応じて異なるコンポーネントを個別にスケーリングできます。Faiss は垂直スケーリング、特に GPU アクセラレーションに優れていますが、分散デプロイメントにはより多くのカスタム作業が必要です。
予想される成長軌道は選択に影響を与えるべきであり、段階的なスケーリングに適したソリューションもあれば、成長に伴って大幅な再アーキテクチャが必要になる可能性のあるソリューションもあります。
総所有コスト
ベクトル検索エンジンを選定する際は、総所有コストのあらゆる側面を考慮してください。インフラストラクチャコストには RAM や CPU の要件が含まれ、これらはソリューションによって大きく異なります。最適なパフォーマンスのために大量のメモリを必要とするエンジンもあれば、より控えめなリソースで効果的に動作できるものもあります。
運用の複雑さは継続的な保守コストに影響します。デプロイメント、監視、保守に必要な労力は大きく異なり、専門的な知識を必要とするソリューションもあれば、標準的な DevOps プラクティスとより容易に統合できるものもあります。
開発時間も重要な要素です。エンジンごとの学習曲線や統合の複雑さは、プロジェクトのタイムラインや成功率に大きく影響する可能性があります。より優れたドキュメント、豊富な例、より直感的な API を備えたソリューションは、通常、より迅速な実装につながります。
サポートオプションは、コミュニティフォーラムから商用サポート契約までさまざまです。選択肢を評価する際には、応答時間やサポート保証に関する組織の要件を考慮してください。
最後に、潜在的な移行コストを考慮してください。ニーズが変化した場合、別のソリューションへ切り替えることはどれほど難しいでしょうか。標準 API やエクスポート機能を備えたエンジンは、将来の柔軟性をより多く提供します。
将来性の確保
ベクトル検索技術は急速に進化しているため、変化するニーズに適応できるソリューションを選択することが重要です。継続的な開発状況を評価するために、コミュニティの活動状況やリリース頻度を確認してください。定期的なアップデートと活発なディスカッションフォーラムを持つプロジェクトは、関連性と最新性を維持しやすい傾向があります。
企業による支援や持続可能性は、長期的な存続可能性にとって重要です。確立された企業や財団によって支援されているプロジェクトは、一般的により安定した開発軌道を持ちます。
機能ロードマップを予想されるニーズと整合させることで、そのソリューションがユースケースに有益な方向へ成長することを確保しやすくなります。最後に、要件の変化に応じて適応できる柔軟性は、プロジェクト要件の予期せぬ変化に対する保険となります。
実世界のワークロードによるベンチマーク
ベンチマーク結果は、チームがベクトル検索エンジンを比較する際に最初に注目することが多いものですが、公開されている多くのベンチマークは実世界の利用状況を反映できていません。合成テストは、固定データセット、均一なクエリ、読み取り中心のワークロードといった理想化された条件に焦点を当てる傾向があり、実際のアプリケーションの複雑さを無視しています。本番環境では、システムが頻繁な更新、同時クエリ、マルチモーダルフィルタリング、構造化データと非構造化データにまたがるハイブリッド検索をサポートする必要があるかもしれません。これらの課題は、実際のパフォーマンス、スケーラビリティ、信頼性に大きな影響を与える可能性があります。
十分な情報に基づいて選択するには、想定されるワークロードパターンを可能な限り忠実に再現するベンチマークを優先してください。実データセット、現実的なクエリ量、運用上の制約を用いたテストにより、ベクトル検索エンジンが自分たちの環境でどのように機能するかについて、より正確な全体像を得ることができます。
VDBBench は、本番環境の現実をシミュレートすることを前提に一から設計されたオープンソースのベンチマークです。シナリオを都合よく選別する合成テストとは異なり、VDBBench は実際の本番ワークロードと同様に、継続的な取り込み、厳格なフィルタリング条件、多様なシナリオを通じてデータベースに負荷をかけます。
VDBBench GitHub: https://github.com/zilliztech/VectorDBBench.
結論と次のステップ
ベクトル検索は、ニッチな用途を超えて、多くの現代的なアプリケーションにとって基礎的な構成要素となりました。オープンソースのエコシステムには、それぞれに明確な利点とトレードオフを持つ、複数の強力な選択肢があります。
ベクトル検索を始めたばかりのほとんどのチームにとって、Milvus は機能、性能、運用のシンプルさのバランスに優れています。その包括的な機能と成長中のエコシステムにより、幅広いユースケースに適しており、Zilliz Cloud のようなフルマネージドの選択肢は運用上の負担を軽減します。
特定のニーズに対しては、Faiss(性能重視)、Weaviate(ナレッジグラフ統合)、Qdrant(フィルタリング機能)、Annoy(読み取り最適化ワークロード)などの代替手段のほうが適している場合があります。
何を選ぶにせよ、小さく始め、特定のワークロードに対して十分にベンチマークを行い、本番環境へのデプロイに踏み切る前に前提を検証してください。ベクトル検索技術は急速に進化し続けているため、選択したソリューションを取り巻くコミュニティに関わり続けることが、長期的な成功には不可欠です。
始める準備はできましたか?これらのプロジェクトのほとんどは、優れたクイックスタートガイド、手軽に試せる Docker コンテナ、そして新規参加者を積極的に支援する活発なコミュニティを提供しています。評価する最良の方法は、実際のデータとクエリパターンを使って小さな概念実証を構築することです。
検索を楽しんでください!

読み続けて
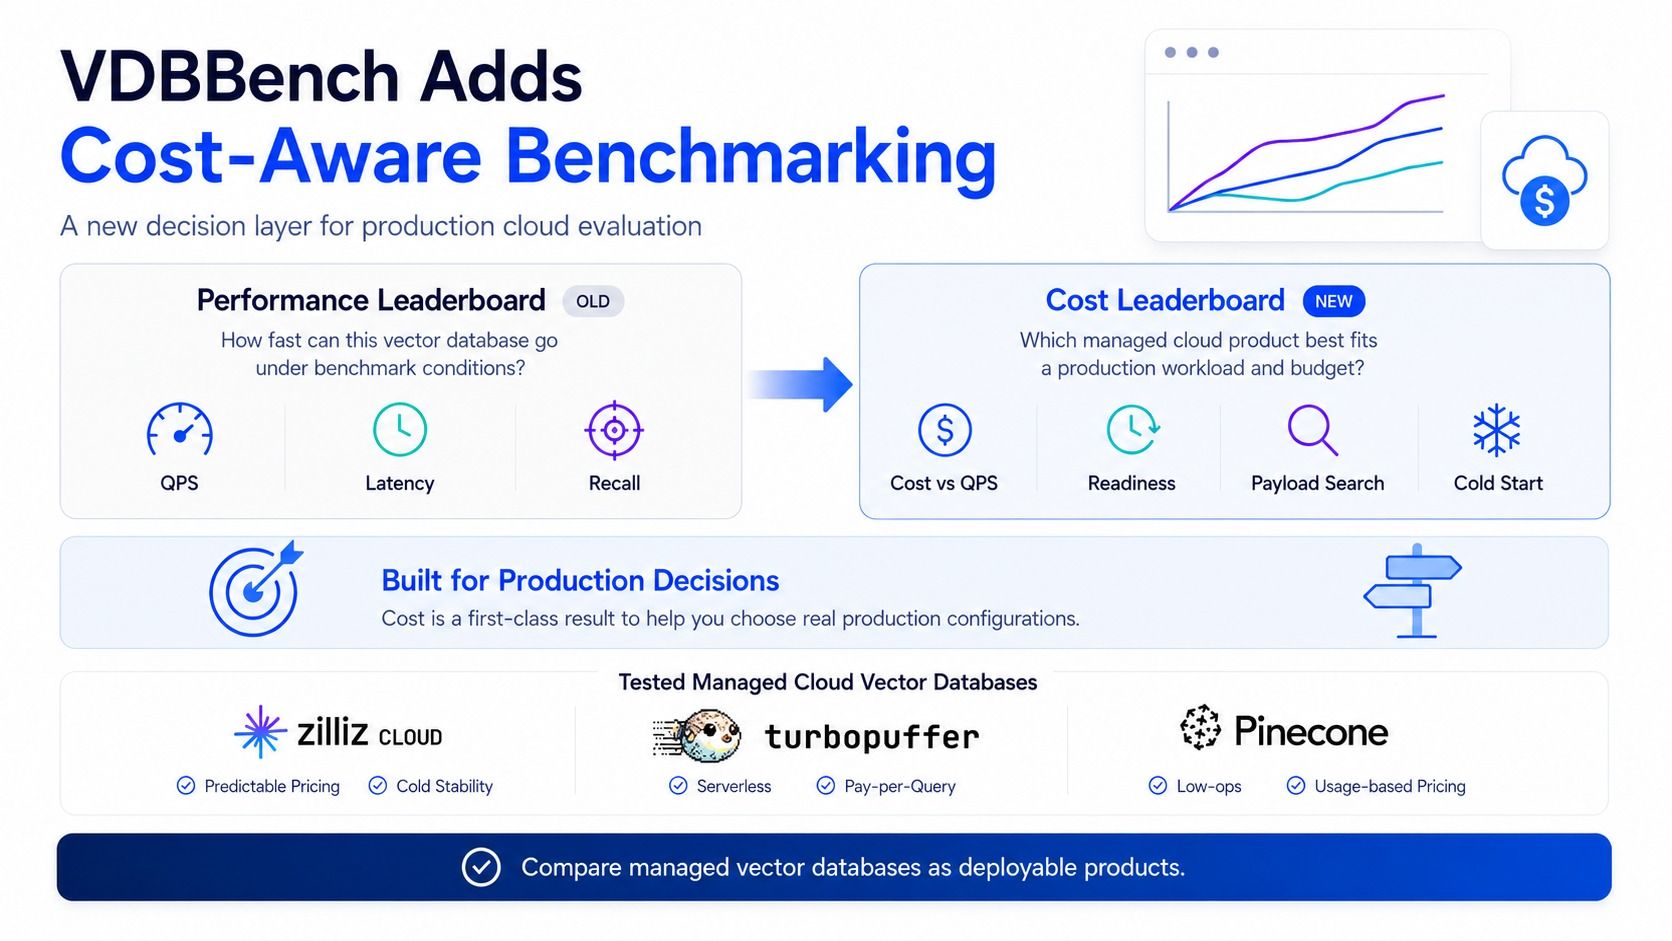
VDBBench Adds Cost-Aware Benchmarking for Vector Databases
Compare Zilliz Cloud, Pinecone, and turbopuffer with VDBBench cost-aware vector database benchmarks across latency, freshness, multitenancy, and cold starts.
A Developer's Guide to Exploring Milvus 2.6 Features on Zilliz Cloud
Milvus 2.6 marks a shift from “vector search + glue code” to a more advanced retrieval engine, and it is now Generally Available (GA) on Zilliz Cloud (a managed Milvus service).
How to Improve Retrieval Quality for Japanese Text with Sudachi, Milvus/Zilliz, and AWS Bedrock
Learn how Sudachi normalization and Milvus/Zilliz hybrid search improve Japanese RAG accuracy with BM25 + vector fusion, AWS Bedrock embeddings, and practical code examples.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.