SingleStore vs Weaviate AIアプリに適したベクターデータベースの選択
ベクターデータベースとは?
SingleStoreとWeaviateを比較する前に、まずベクターデータベースの概念について説明します;
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするために設計されています。ベクトルは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品属性などの複雑な情報を符号化する。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLM)の性能を向上させる技術であるRAG(Retrieval Augmented Generation) において重要な役割を果たす。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
SingleStoreは分散、リレーショナル、SQLデータベース管理システムで、ベクトル検索をアドオンとして備えている。この記事では両者のベクトル検索機能を比較します。
SingleStore:概要とコアテクノロジー
SingleStoreは、データベース自体にベクター検索機能を搭載することで、ベクター検索を可能にしました。ベクターは通常のデータベーステーブルに格納され、標準的なSQLクエリで検索することができます。例えば、価格帯でフィルタリングしながら類似の商品画像を検索したり、特定の部門に結果を限定しながらドキュメントの埋め込みを検索したりすることができます。システムは、ベクトルインデックスにFLAT、IVF_FLAT、IVF_PQ、IVF_PQFS、HNSW_FLAT、HNSW_PQを、類似性マッチングにドット積とユークリッド距離を使用したセマンティック検索の両方をサポートしている。これは、推薦システム、画像認識、AIチャットボットなど、類似性マッチングが高速なアプリケーションに超便利である。
SingleStoreの中核は、パフォーマンスとスケールのために構築されている。データベースは複数のノードにデータを分散させるので、大規模なベクトルデータ操作に対応できます。データが大きくなっても、ノードを追加すれば問題ありません。クエリプロセッサーはベクトル検索とSQLオペレーションを組み合わせることができるので、複数のクエリを別々に実行する必要がありません。ベクターのみのデータベースとは異なり、SingleStoreはこれらの機能を完全なデータベースの一部として提供するため、複数のシステムを管理したり、複雑なデータ転送に対応したりすることなく、AI機能を構築することができます。
SingleStoreのベクトルインデックスには2つのオプションがあります。1つ目は厳密なk-最近傍(kNN)検索で、クエリベクトルに最も近いk個の近傍集合を正確に見つけます。しかし、非常に大きなデータセットや高い同時実行性の場合、SingleStoreはベクトルインデックスを使用した近似最近傍(ANN)検索もサポートします。ANN検索は、厳密なkNN検索よりもはるかに高速にk近傍を見つけることができます。速度と精度はトレードオフの関係にあり、ANNは高速ですが、正確なk個の最近傍セットを返すとは限りません。インタラクティブな応答時間が必要で、絶対的な精度を必要としない数十億のベクトルを扱うアプリケーションには、ANN検索が適しています。
SingleStoreにおけるベクトルインデックスの技術的実装には特別な要件があります。これらのインデックスはカラムストアテーブルにのみ作成可能で、ベクトルデータを格納する単一のカラムに作成する必要があります。システムは現在Vector Type(dimensions[, F32])フォーマットをサポートしており、F32は唯一サポートされている要素タイプです。この構造化されたアプローチにより、SingleStoreは大規模な言語モデルからのベクトルを使用した意味検索、焦点を絞ったテキスト生成のためのRAG(retrieval-augmented generation)、ベクトル埋め込みに基づく画像マッチングなどのアプリケーションに最適です。これらを従来のデータベース機能と組み合わせることで、SingleStoreは開発者がパフォーマンスとスケールを維持しながら、SQL構文を使用して複雑なAIアプリケーションを構築することを可能にします。
Weaviate:概要とコアテクノロジー
Weaviateは、AIアプリケーション開発を簡素化するために設計されたオープンソースのベクトルデータベースです。ビルトインのベクトルおよびハイブリッド検索機能、機械学習モデルとの容易な統合、データプライバシーへの配慮を提供します。これらの機能は、様々なスキルレベルの開発者がAIアプリケーションをより効率的に作成、反復、拡張できるようにすることを目的としています。
Weaviateの強みの一つは、高速かつ正確な類似検索である。HNSW(Hierarchical Navigable Small World)インデックスを使用し、大規模データセットでのベクトル検索を可能にしている。Weaviateはまた、ベクトル検索と従来のフィルタを組み合わせることもサポートしており、意味的類似性と特定のデータ属性の両方を活用した強力なハイブリッドクエリを可能にしている。
Weaviateの主な特徴は以下の通り:
1.PQ 圧縮による効率的な保存と検索 2.BM25検索とベクトル検索の間を調整するアルファ・パラメータを持つハイブリッド検索。 3.エンベッディングとリランキング用のプラグインを内蔵しており、開発が容易。
Weaviateは、開発者がベクトル検索を試すためのエントリー・ポイントである。簡単なセットアップと十分に文書化されたAPIにより、開発者に優しいアプローチを提供する。GenAIエコシステムと深く統合されているため、小規模なプロジェクトや概念実証に適している。Weaviateの対象者は、AIアプリケーションを構築するソフトウェアエンジニア、大規模データセットを扱うデータエンジニア、機械学習モデルを展開するデータサイエンティストである。Weaviateは、セマンティック検索、推薦システム、コンテンツ分類、その他のAI機能を簡素化します。
Weaviate は水平方向に拡張できるように設計されており、クラスタ内の複数のノードにデータを分散することで、大規模なデータセットや高負荷のクエリを処理できる。マルチモーダルデータをサポートし、使用するベクトル化モジュールに応じて様々なデータタイプ(テキスト、画像、音声、動画)を扱うことができる。WeaviateはRESTful APIとGraphQL APIの両方を提供しており、開発者が柔軟にデータベースとやり取りできるようになっている。
しかし、大規模なプロダクション環境においては、いくつかの留意点がある:
1.エンタープライズグレードのセキュリティ機能の制限 2.数十億ベクトル・データセットに対するスケーラビリティの潜在的課題 3.新しくリリースされた階層型ストレージ・オプションには手動管理が必要 4.水平方向のスケールアップには、Weaviate のエンジニアのサポートが必要であり、自動的には行えない。
この最後の点は特に注目すべき点である。つまり、組織は事前に計画を立て、スケーリングオペレーションのための時間を割り当て、適切な準備なしにシステムの限界に近づかないようにする必要があるということだ。
主な違い
検索方法
SingleStoreはデータベースにベクトル検索を組み込んでおり、SQLクエリと一緒に類似アイテムを検索することができます。FLAT、IVF_FLAT、IVF_PQ、HNSWアルゴリズムなどのオプションで、正確なk-最近傍(kNN)検索と近似最近傍(ANN)検索をサポートしています。正確なkNNは正確だがリソースを大量に消費し、ANNは高速だが、高速な対話的クエリを必要とする大規模データセット向けである。
WeaviateはHNSW(Hierarchical Navigable Small World)インデックスを使用し、大規模データセットでの効率的なベクトル検索を実現する。また、ハイブリッド検索機能を備えているため、ベクトルベース検索と従来のキーワード検索を混在させることができる。この柔軟性により、Weaviateはセマンティック理解と構造化フィルタリングの両方を必要とするアプリケーションに最適です。
データ
SingleStore は、構造化データや半構造化データに最適です。ベクター検索はリレーショナルデータベースの一部です。ベクターはカラムストア・テーブルに格納され、SQLを介してアクセスされるため、AIアプリケーションとの統合が容易です。
Weaviateはより幅広く、テキスト、画像、音声、動画などのマルチモーダルデータをサポートする。様々なベクトル化モジュールと統合できるため、非構造化データにも対応できる。しかし、構造化データのユースケースでは、データの取り扱いに追加設定が必要になる場合がある。
スケーラビリティ
SingleStoreは複数のノードにデータを分散するため、大規模なデータセットでもシームレスです。ノードの追加も簡単で、データが大きくなってもパフォーマンスは安定しています。ベクトル検索と SQL 操作を組み合わせることで、クエリの複雑さを軽減します。
Weaviateは水平方向にスケールし、データはクラスタに分散される。Weaviateは大規模なデータセットをサポートするが、スケーリングには手作業が必要であり、Weaviateのエンジニアと緊密に連携する必要がある。このため、高速なスケーリングが必要な企業にとっては、スケーリングが遅れる可能性がある。
柔軟性とカスタマイズ性
SingleStoreのSQLベースのアプローチは、データモデリングとクエリに柔軟性を与えます。開発者は、ベクトル検索を従来のデータベース操作と組み合わせることで、最小限のシステム統合作業で複雑なAIアプリケーションを実現できます。
Weaviateは、RESTful APIとGraphQL APIによる柔軟性を備えているため、様々な好みの開発者に対応できる。ハイブリッド検索機能と様々な埋め込みモデルとの統合により、セマンティック検索やコンテンツ分類のような特定のユースケースのためのカスタマイズオプションが提供される。
統合とエコシステム
SingleStoreは既存のデータパイプラインや分析ワークフローと統合できます。従来のデータと共にベクトルを保存し、クエリできるため、AIアプリケーションの統一プラットフォームとなる。
Weaviateはエコシステムのサポートに優れており、一般的なエンベッディングやリランキング技術用のモジュールがあらかじめ組み込まれている。しかし、SingleStoreに比べると企業向けの統合は限られており、完全な導入には追加開発が必要になるかもしれない。
使いやすさ
SingleStoreのSQLファーストのアプローチと優れたドキュメントは、リレーショナルデータベースに精通した開発者にとって使いやすいものです。特にSQLの専門知識を持つチームにとっては、セットアップとメンテナンスが簡単です。
Weaviateは、明確なAPIとドキュメントにより、開発者フレンドリーなセットアップが可能です。小規模なチームやベクトル検索を模索するプロジェクトには最適だが、大規模な環境ではスケーリングや運用の安定性に手間がかかるかもしれない。
コスト
SingleStoreはベクターデータベースとリレーショナルデータベースを統合しているため、別々のシステムを用意する必要がなく、コストを削減することができます。運用コストは規模やノード構成によって異なります。
Weaviateのオープンソースモデルは、初期費用を抑えることができるが、企業への導入にはサポートとスケーリングのための追加費用が発生する。階層型ストレージのような新しくリリースされた機能は、手動での管理が必要なため、運用上のオーバーヘッドが増える。
セキュリティ機能
SingleStoreはエンタープライズグレードのセキュリティ、暗号化、認証、アクセスコントロールを備えています。これらはデータセキュリティを優先する企業にとって重要です。
Weaviateのセキュリティは限定的である。基本的なアクセスコントロールはサポートされているが、エンドツーエンドの暗号化やきめ細かな認証メカニズムといった高度な機能は成熟していないため、エンタープライズユースケースでは懸念材料となる。
それぞれを選択する場合
SingleStoreは、特にベクトル検索と構造化データクエリを組み合わせた場合に高いパフォーマンスとスケーラビリティを発揮する。堅牢なSQLとエンタープライズグレードのセキュリティにより、レコメンデーションシステム、財務分析、AIビジネスインテリジェンスなどの大規模な分散データ環境に最適です。
Weaviateは、特にテキスト、画像、動画などの非構造化データを扱う際に、ハイブリッド検索やマルチモード検索の機能を必要とするプロジェクト向けです。特にテキストや画像、動画などの非構造化データを扱う場合、ハイブリッド検索やマルチモード検索機能を必要とするプロジェクトに最適です。セットアップや実験のしやすさが重要な、概念実証のAIアプリケーション、コンテンツ分類、セマンティック検索に取り組む開発者に最適です。
概要
SingleStoreは、構造化データのベクトル検索、堅牢なスケーラビリティ、エンタープライズグレードのセキュリティ、SQLベースの操作に適している。Weaviateは、マルチモーダル、開発者フレンドリーなセットアップ、ハイブリッド検索に最適です。最終的には、ユースケース、データタイプ、パフォーマンスのニーズ次第です。お客様のプロジェクト要件を見極めて、最適なものをお選びください。
SingleStoreとWeaviateの概要についてはこちらをお読みいただきたいが、これらを評価するには、ユースケースに基づいて評価する必要がある。それに役立つツールの一つが、ベクターデータベースの比較のためのオープンソースのベンチマークツールであるVectorDBBenchです。最終的には、独自のデータセットとクエリパターンで徹底的なベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力だが異なるこの2つのアプローチのどちらを選択するかの鍵となるだろう。
オープンソースのVectorDBBenchを使ってベクトルデータベースを評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのためのオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)のような異なるベクトルデータベースシステムを独自のデータセットを使ってテストし比較し、自分のユースケースに合うものを見つけることができます。VectorDBBenchを使えば、ユーザーはマーケティング上の主張や伝聞ではなく、実際のベクターデータベースのパフォーマンスに基づいて決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースの性能を簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: Open-Source Vector Database Benchmark Tool](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
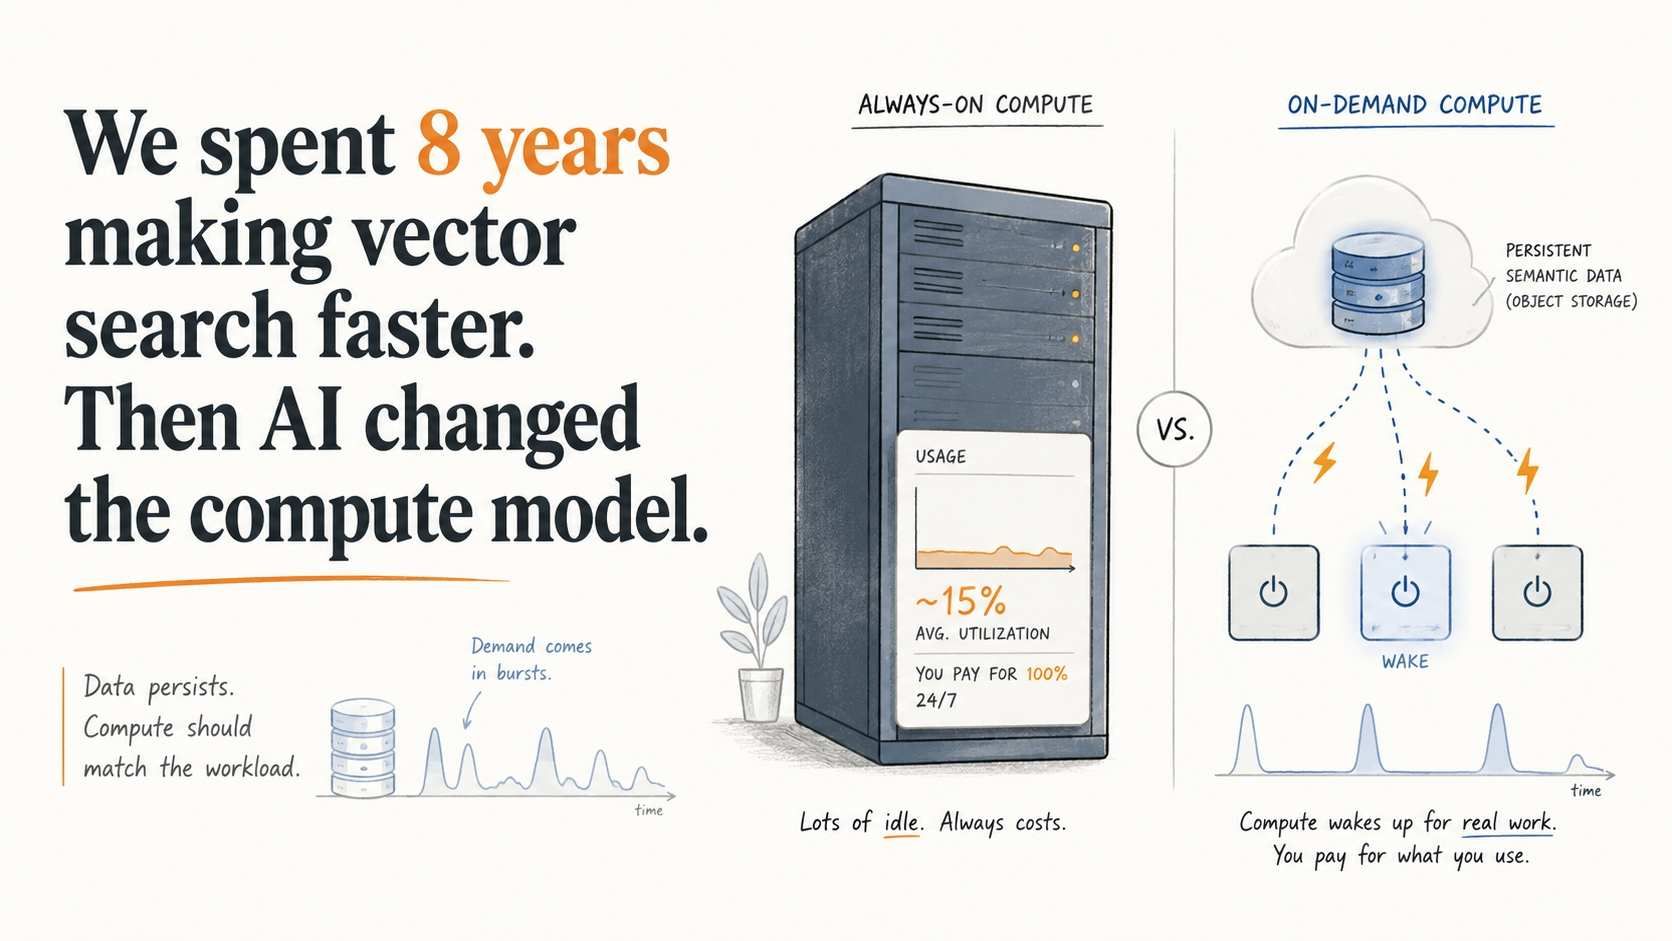
We spent 8 years making vector databases faster. Then we stopped.
Rarely queried embeddings still need to stay searchable. See how Vector Lakebase enables on-demand vector search without always-on compute costs.
Zilliz Cloud Now Available in AWS Europe (Ireland)
Zilliz Cloud launches in AWS eu-west-1 (Ireland) — bringing low-latency vector search, EU data residency, and full GDPR-ready infrastructure to European AI teams. Now live across 30 regions on five cloud providers.
Zilliz Cloud Introduces Advanced BYOC-I Solution for Ultimate Enterprise Data Sovereignty
Explore Zilliz Cloud BYOC-I, the solution that balances AI innovation with data control, enabling secure deployments in finance, healthcare, and education sectors.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.