AIにおける高密度ベクトル:機械学習におけるデータの可能性の最大化
この記事では、密なベクトルに焦点を当て、疎なベクトルと比較した場合の利点と、様々な分野のMLアルゴリズムで密なベクトルがどのように使用されているかを明らかにする。

高密度ベクトル入門
機械学習では、データをアルゴリズム処理に適した形式にする必要があり、多くの場合、生の入力を数値ベクトルに変換する。生データを高次元配列であるベクトルに変換することは、MLアルゴリズムの重要な構成要素となります。この点で、我々は2つの一般的なベクトル表現を見ることができます:スパースとデンスです。スパースベクトル](https://zilliz.com/learn/sparse-and-dense-embeddings)は主にゼロで埋め尽くされ、要素がないことに焦点が当てられますが、密なベクトルはコンパクトで、豊かな表現を提供します。
密なベクトルは、複雑なデータを高次元の数値表現に符号化するための基礎となる。この記事では、密なベクトルにズームインし、疎なベクトルと比較したその利点と、様々な領域のMLアルゴリズムでどのように広く使用されているかを明らかにする。
密なベクトルを理解する
機械学習における密なベクトルとは、各要素が重要な値を持つ配列のことです。例えば、"king "は3次元の密なベクトル [0.2, -0.1, 0.8]を表すかもしれません。この配列の各要素(例えば、0.2, -0.1, 0.8)は、データから学習された意味的特徴や文脈的特徴を符号化する。ほとんどの要素がゼロであるスパース・ベクトルとは異なり、密なベクトルのすべての要素は意味があり、表現に寄与する。
数学的には、密なベクトルは高次元空間を占め、これらの配列上のベクトル加算やドット積のような演算は、データ間の関係を捉えることができる。この広大な空間の中で、密なベクトルは類似性と非類似性の正確な測定を可能にし、その結果、クラスタリング、分類、回帰のようなタスクをより高い精度で容易にします。例えば、"king - man + woman = queen "という単語のベクトル演算は、密なベクトルのおかげで可能になる。
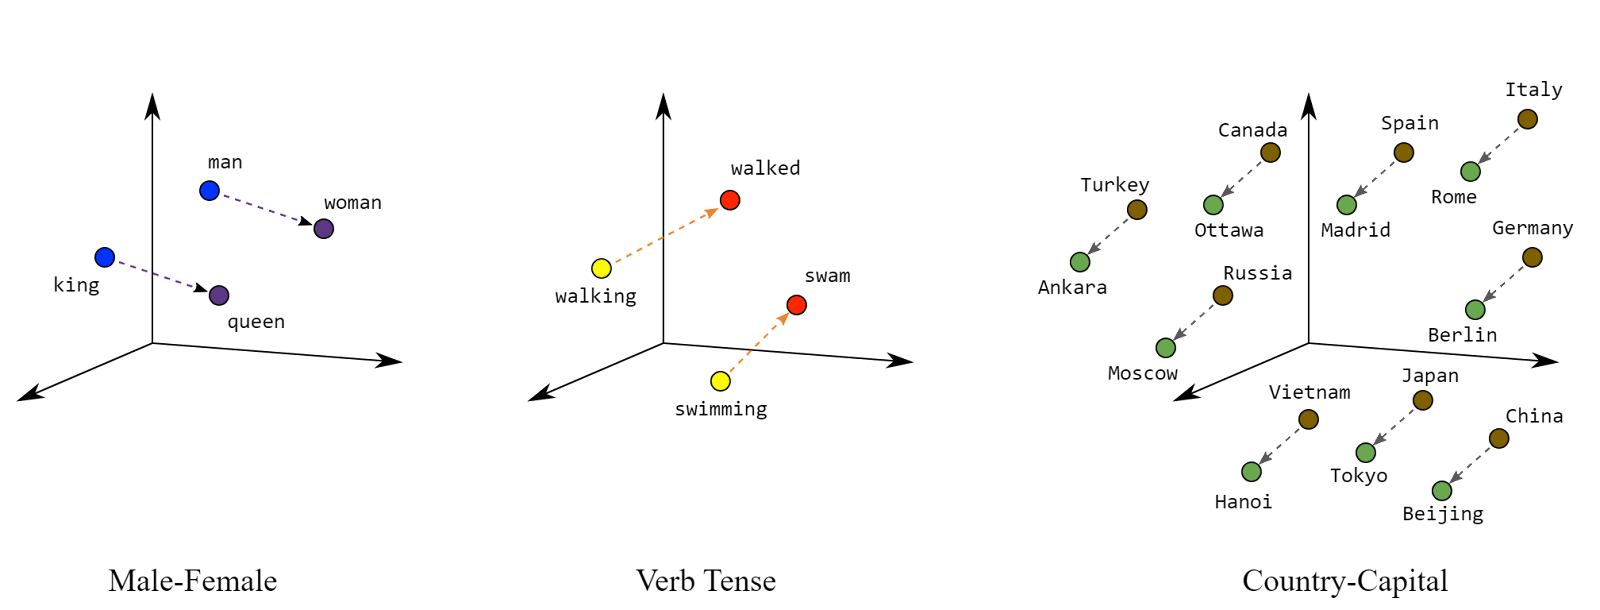
図:密なベクトルは様々な意味的関係を捉えることができる。出典:Google DevelopersGoogle Developers.
AIにおける高密度ベクトルの役割
高密度ベクトルは、複雑なデータを、AIモデルが容易に咀嚼できるリッチで詳細なフォーマットに変える。画像の複雑なパターンを理解するにしても、チャットボットで次の単語を予測するにしても、高密度ベクトルはAIシステムがより賢く、より直感的になるのに役立ちます。コンピュータ・ビジョンでは、Vision Transformers(ViT)のようなモデルは、密なベクトルを活用して画像とテキストを同じベクトル空間にエンコードし、類似性の高いベクトルによる画像とテキストのマッチングを可能にします。
NLP](https://zilliz.com/learn/A-Beginner-Guide-to-Natural-Language-Processing)では、Word2Vecを考えてみよう。単語は密なベクトルに変換されるため、「王」と「女王」はベクトル空間内で密接に配置され、その意味的関係を正確に反映するかもしれない。BERT は、文脈を考慮した埋め込みを生成することで、これをさらに推し進める。例えば、"river bank "の "bank "と "bank account "の "bank "は、単語の文脈的な意味を捉える異なるベクトルを持つことになり、センチメント分析や言語翻訳のようなタスクにとって極めて重要になる。
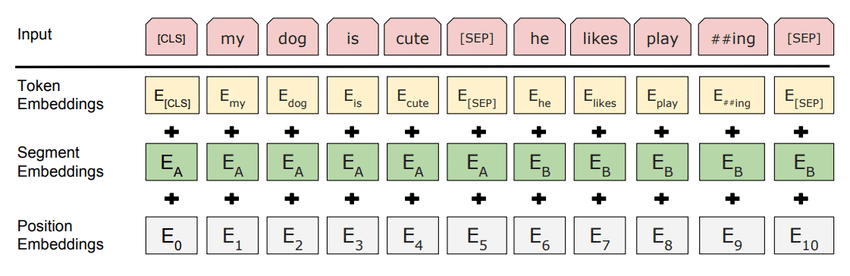
図:BERT Embeddingsは、テキスト入力を変換するために密なベクトルを利用する。出典: BERT論文。
アプリケーションと使用例
高密度ベクトルは、AIアプリケーションを全面的に変革している。テキスト分類では、密なベクトルを採用したGoogleのT5モデルは、検索結果と言語理解の精度を大幅に向上させます。テキスト生成では、OpenAIのGPT-4のようなツールは、ニューラルネットワークを介して処理された高密度ベクトルを使用して、ニュアンスのあるテキストを理解し、作成します。ユーザーとアイテムを同じベクトル空間で表現する推薦システムにおける密なベクトルは、ユーザーの嗜好とアイテムの特徴に基づいて商品を推薦するための効率的な類似性計算を可能にする。例えば、Spotifyの推薦システムは、密なベクトルを活用してパーソナライズされた音楽プレイリストを提供している。
密なベクトルによる最適化
密なベクトル埋め込みによるAIモデルの最適化には、いくつかのベストプラクティスがある。次元削減は重要であり、PCAのような方法はベクトルサイズを縮小し、計算効率を高めながら重要な情報を維持するのに役立つ。ベクトルの正規化は、ベクトルを一貫した長さに標準化します。これは、距離計算に依存するモデルにとって特に重要です。
エンベッディングの微調整は、エンベッディングを特定のタスクに合わせて調整するものであり、特にドメイン固有のコンテキストにおいて効果的である。この場合、事前に訓練された埋め込みを新しいデータに適応させ、モデルの精度をより手頃な価格で迅速に向上させることができます。
しかし、特に高次元ベクトルや大規模なデータセットでは、計算効率の課題が大きい。効率的なアルゴリズムとベクトルデータベースは、この問題を軽減することができます。密なベクトルは疎なベクトルよりもデータの疎密性に優れていますが、モデルが関連する特徴に確実に焦点を当てることは依然として重要であり、オーバーフィッティングを避けることができます。ドロップアウトや正則化などのテクニックは、この文脈で役立ちます。
将来のトレンドとイノベーション
AIと機械学習の新たなトレンドは、高密度ベクトルの使用における大きな進歩を示している。我々は、ベクトルの表現力を高める革新的な埋め込み技術を目の当たりにしている。例えば、Word2Vecのような静的なモデルから発展した文脈的で動的な埋め込みは、言語のニュアンスをより正確に捉えることができます。
変換モデル(BERT、GPT)のような技術は、高密度のベクトルがコンテキストとセマンティクスを理解する方法に革命をもたらしました。
将来的には、言語のニュアンスを捉え、テキスト、画像、音声を組み合わせたマルチモーダルデータを統合する、より洗練された埋め込み技術が登場するかもしれない。これにより、複雑なデータセットをより深く、より全体的に理解できるようになるかもしれない。さらに、将来の密なベクトルモデルは、異なるドメインや言語をまたいで知識を伝達することに長けてくるかもしれない。これは、より少ないドメイン固有の訓練データを必要とする、より汎用性の高いAIシステムを作るための重要な一歩となるだろう。
一方、重要な情報を失うことなく密なベクトルの次元を削減する進歩は、AIモデルをより効率的にし、リソースに制約のある環境での展開を可能にするかもしれない。
高密度ベクトルの概要
高密度ベクトルはAIの基礎として登場し、機械学習ソリューションの有効性を大幅に改善した。これらのベクトルはデータ内の複雑なパターンとニュアンスを捉え、自然言語処理からヘルスケア分析まで、様々な領域にわたってより包括的な理解を提供する。イノベーションを推進し、よりニュアンスのあるAIアルゴリズムを促進する上で、その役割は誇張しすぎることはない。
密なベクトル埋め込みを統合することは、AIイニシアチブを強化しようとする読者にとって最も重要である。このテクノロジーを活用することで、未加工の乱雑なデータからより深い洞察を引き出し、プロジェクトを新たなパフォーマンスの高みへと押し上げることができる。
 Nuri TasFreelance Technical Writer