RAGアプリケーションのためのウェブサイト・チャンキングと埋め込み入門ガイド
この記事では、ウェブサイトからコンテンツを抽出し、それをRAGアプリケーションのLLMのコンテキストとして使用する方法について説明する。しかし、その前にウェブサイトの基礎を理解する必要がある。

#はじめに
大規模言語モデル(LLMs)の進歩は、テキスト生成から高度に文脈化された回答を提供するパーソナライズされたチャットボットまで、洗練された自然言語アプリケーションの広い範囲を開いている。
しかし、ChatGPT、LLAMA、Mistralのような一般的なLLMの限界の1つは、知識が学習されたデータに限定されることです。例えば、ChatGPTは2023年4月までのデータで学習されているため、学習データよりも新しい情報に対しては正確な回答を提供できない可能性があります。
この問題を軽減する1つの方法が、RAG(Retrieval Augmented Generation)(RAG)です。一言で言えば、RAGでは、LLMにリアルタイムでクエリと一緒に追加の文脈情報を提供し、関連性の高い回答を提供できるようにする。書籍や社内文書などの他の情報源の中でも、ウェブサイトからの情報は、LLMに文脈を追加するための一般的な選択肢である。
 LLMの幻覚を軽減するRAGの仕組み.png
RAGがLLMの幻覚を軽減する方法_|日本経済新聞社
この投稿では、ウェブサイトからコンテンツを抽出し、RAGアプリケーションでLLMのコンテキストとして使用する方法を説明します。しかし、その前にウェブサイトの基礎を理解する必要があります。
ウェブアーキテクチャの基礎
インターネット上のさまざまなウェブサイトを探索すると、レイアウト、フォント、情報構造など、多種多様なものに遭遇する。この多様性は、ウェブサイトが一般的に特定のアーキテクチャに基づいて構築されていることに起因しています。ウェブ・アーキテクチャは、ウェブサイトがどのように構成され、ユーザーとどのように関わり、他のシステムとどのように統合されるかを決定します。
ウェブサイトは3つの主要コンポーネントで構成されている:HTML、CSS、JavaScriptである。
HTML(Hypertext Markup Language)はウェブページの構造と内容を定義し、ウェブサイトのレイアウトと構成の基礎を築きます。
CSS(Cascading Style Sheets)は、ウェブページの視覚的なスタイルとレイアウトを制御し、色、フォント、その他の視覚的要素によってユーザー体験を向上させます。
JavaScript(ジャバスクリプト)は、ウェブページにインタラクティブな機能を追加し、ユーザーがウェブサイトを利用したり、フォーム送信やデータ操作などのタスクを実行できるようにします。
ユーザーフレンドリーなウェブサイトを作成し、そのコンテンツを抽出するには、ドキュメント・オブジェクト・モデル(DOM)の概念も理解する必要があります。
DOMは、ウェブページのHTMLコードを解析する際にブラウザが生成するツリー状のデータ構造としてHTML要素を表します。DOMはウェブページを動的に反映し、ユーザーの操作に応じてリアルタイムに更新されます。
DOMはいくつかの主要なコンポーネントで構成されています:
1.要素はDOMの構成要素で、見出し、段落、画像などの個々のHTML要素を表します。
2.属性は、画像のsrc属性や要素のid属性など、要素に情報を追加します。
3.テキストは、HTML要素内のテキスト・コンテンツを指します。これらのテキスト・ノードは属性や子ノードを持たず、DOMツリーのリーフ・ノードとみなされます。

これらの要素を理解することは、効果的なウェブスクレイピングを行う上で非常に重要であり、次のセクションで説明するように、ウェブサイトのコンテンツを抽出することができる。
ウェブスクレイピングの基礎と課題
RAG のアプリケーションでは、Wikipedia、Common Crawl、Google BigQuery Public Datasets、Wayback Machine など、様々なウェブサイトを情報源として利用することができる。ウェブスクレイピングとは、要するにこれらのウェブサイトからコンテンツを抽出することである。
ウェブサイトをスクレイピングする最も簡単な方法の一つは、そのAPIを利用することである。ウェブサイトがAPIを提供していれば、開発者はそれを活用して便利なフォーマットでコンテンツを抽出することができる。しかし、すべてのウェブサイトがAPIを提供しているわけではなく、APIを提供している場合でも、データが希望するフォーマットで利用できるとは限らない。そこで、ウェブスクレイピングツールの出番となる。
数多くのウェブスクレイピングツールがオンラインで利用可能だが、RAGアプリケーションの場合、BeautifulSoup、Selenium、ScrapyのようなオープンソースのPythonウェブスクレイピングライブラリを使用するのが、後で他のフレームワークやライブラリと統合しやすいという点で良い選択だ。
しかし、ウェブスクレイピングはいくつかの理由により、実施するのが難しい場合がある:
ウェブサイトはそれぞれ、異なるユニークなHTML構造を持っている。したがって、欲しい特定のコンテンツを取得するためには、一般的にウェブサイトごとにユニークなスクレイパースクリプトが必要になる。
安定性:*** 特定のウェブサイトから必要なコンテンツを取得するためにスクレーパーを構築しても、そのウェブサイトはある時点で変更される可能性があります。そのため、スクレーパーのスクリプトをエラーなく使い続けるためには、常に調整する必要がある。
ウェブコンテンツの抽出:ウェブスクレイピングからベクトル埋め込みまで
この投稿では、ウェブサイトをスクレイピングし、RAGアプリケーションのためにコンテンツを前処理するステップバイステップのガイドを提供します。このプロセスには、Webスクレイピング、チャンキング、各チャンクの埋め込み生成などが含まれます。まず、Webスクレイピングから始めましょう。
ウェブスクレイピングによるウェブコンテンツの抽出
前述の通り、WebスクレイピングではWebサイトからコンテンツや情報を抽出します。Webサイトをスクレイピングするには様々な方法がありますが、今回はBeautifulSoupライブラリとrequestsライブラリを組み合わせてWebスクレイピングに活用します。
- requests`:HTTPリクエストを行うためのPythonライブラリ。
- BeautifulSoup`:WebスクレイピングとHTML解析を可能にするPythonライブラリで、Web上のテキストコンテンツを効率的に抽出できる。
RAGのケースでは、ウィキペディアの記事を主な情報源として使用する。次のセクションでは、Wikipediaの記事からテキスト情報を取得するためにこれらのライブラリを利用する方法を示します。
データサイエンスに関するウィキペディアの記事からテキスト情報を抽出する例を考えてみよう。そのためには、 requests ライブラリを使って記事のURLに HTTP リクエストを送ります。
import requests
from bs4 import BeautifulSoup

response = requests.get(
    url="<https://en.wikipedia.org/wiki/Data_science>"、
)
次に、この記事の内容をスクレイピングする準備ができました。ウィキペディアの記事の要素を調べると、ウィキペディアの各記事が同じようなDOM(Document Object Model)構造を共有していることに気づくでしょう。しかし、私たちは記事のテキスト情報を抽出しようとしているので、bodyContent_というid attributeを持つdiv elementに焦点を当てることができます。このdivには、以下の図にあるように、ウィキペディアの記事のすべてのテキストコンテンツが含まれています:

BeautifulSoup`ライブラリを使えば、このdiv要素内のテキストを簡単に抽出することができる:
soup = BeautifulSoup(response.content, 'html.parser')

# id = bodyContent の div 内のテキストコンテンツを取得する。
content = soup.find(id="bodyContent")
print(content.text)

"""
出力される:
フリー百科事典『ウィキペディア(Wikipedia)』より

データから知識や洞察を導き出す学際的な研究分野。
情報科学と混同しないように。

NEOWISE彗星(ここでは一連の赤い点として描かれている)の存在は、宇宙望遠鏡である広視野赤外線サーベイ・エクスプローラーによって取得された天文サーベイデータを分析することによって発見された。
データサイエンスは学際的な学術分野[1]であり、統計学、科学計算、科学的手法、プロセス、アルゴリズム、システムを用いて、潜在的にノイズの多い、構造化または非構造化データから知識や洞察を抽出または推定する[2]。
データサイエンスは多面的であり、科学、研究パラダイム、研究手法、学問分野、ワークフロー、専門職として表現される[4]。
"""
我々がすべきことはそれだけだ!テキストコンテンツを手に入れたら、それをvector embeddingsに変換する必要がある。vector embeddingsは、テキストデータ内の意味、文脈、相関関係を数値で表現したものである。
しかし、この長いテキストをベクトル埋め込みに変換する前に、チャンキングという中間ステップが必要です。
ウェブのチャンキング
チャンキングは、Wikipediaの記事のような膨大なテキストデータを扱うときに必要です。テキスト全体を単一のベクトルに直接変換することは、いくつかの理由から最も効果的なアプローチではないかもしれない。第一に、何百万もの次元を持つ高次元ベクトルになり、保存と処理にかなりの計算資源を必要とする。第二に、文書全体を単一のベクトルに凝縮すると、微妙な意味情報や文脈が失われ、その後のタスクのパフォーマンスが低下する危険性がある。さらに、この方法では文書の内容が単純化されすぎ、曖昧さが生じたり、重要な詳細が見落とされたりする可能性がある。
その代わりに、テキストをチャンク(塊)に分割し、それぞれがテキストの一部から得られる粒度の細かい重要な情報で構成されるようにする。チャンキングには、固定サイズの長さのチャンキングや、文脈を考慮したチャンキングなど、いくつかの方法がある。
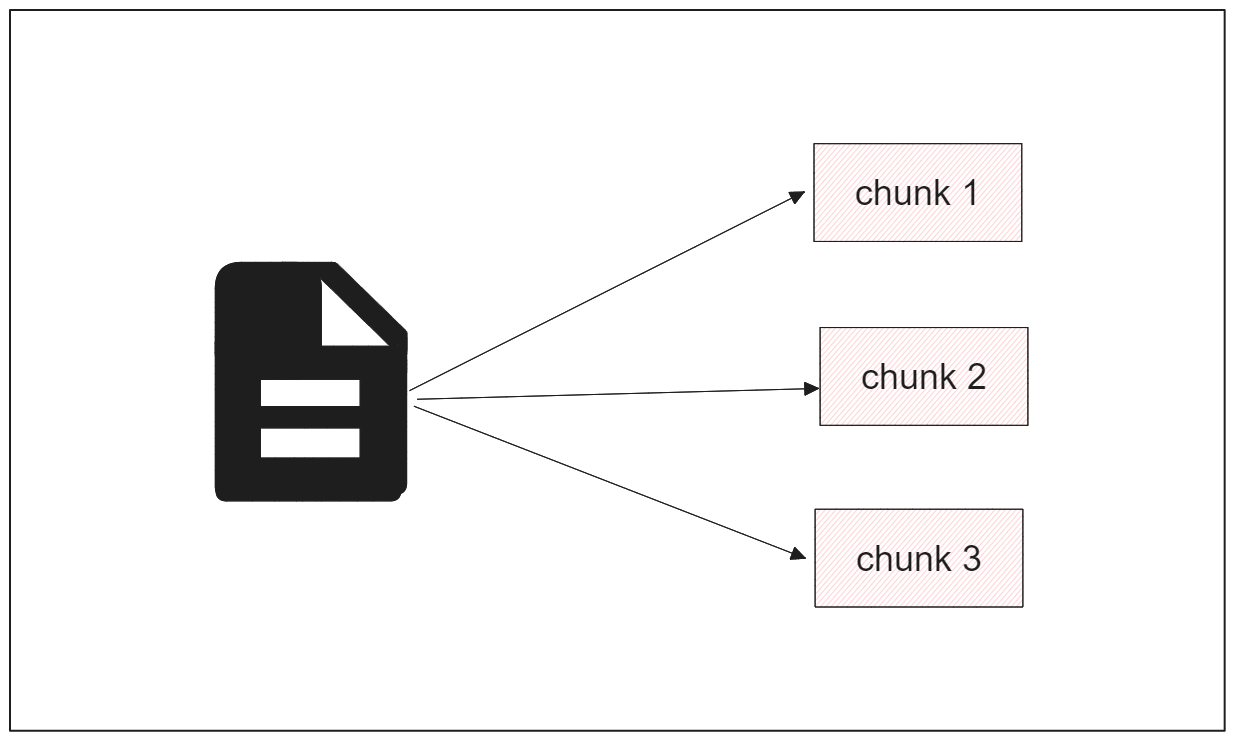
固定長チャンキングでは、各チャンクの長さをあらかじめ定義しておく必要があり、チャンキング処理は定義された長さに従って実行される。その結果、各チャンクは同じ長さになります。
一方、内容を考慮したチャンキングでは、各チャンク間の長さが異なる。この方法では、あらかじめ設定された特定の区切り文字に基づいてテキストを分割する。区切り文字には、ピリオド、カンマ、空白、コロン、改行など、何でも使うことができる。
この例では、あらかじめ設定されたチャンクサイズに基づいて再帰的な方法で記事を分割します。つまり、段落、改行、空白、文字の順で、チャンクサイズが事前定義値と等しくなるまで、テキストの分割処理が行われます。テキストを再帰的にチャンクに分割するには、LangChainの RecursiveharacterTextSplitter を使います:
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size = 512、
    length_function=len、
    is_separator_regex=False、
)

chunk_text = text_splitter.split_text(content.text)
print(len(chunk_text))
print(chunk_text[3])

"""
出力:
67
データサイエンスとは、データを用いて「実際の現象を理解し分析する」ための「統計学、データ分析、情報学、およびそれらに関連する手法を統合する概念」である[5]。数学、統計学、コンピュータサイエンス、情報科学、ドメイン知識[6]の文脈の中で、多くの分野から引き出された技術や理論を使用する。チューリング賞受賞者であるジム・グレイは、データサイエンスを科学の「第4のパラダイム」(経験的、
"""
上で見たように、データサイエンスWikipediaの記事のテキストコンテンツを再帰的な方法に基づいて分割すると、67のチャンクになる。
ウェブチャンクからベクターへの埋め込み
さて、記事全体のテキストをチャンクに変換したので、各チャンクをベクトル埋め込みに変換してみよう。このアプローチにより、RAGアプリケーションのLLMのコンテキストとして、最も関連性の高いチャンクを抽出することができる。
ベクトル埋め込みは、実世界では2つのタイプが一般的に適用されている:密な埋め込みと疎な埋め込み
密な埋め込みは、OpenAIやSentence Transformersのようなディープラーニングモデルによって生成される。このタイプの埋め込みは、ほとんどの要素が非ゼロであるコンパクトなフォーマットでテキストを表現します。
一方、スパース埋め込みは、TF-IDFやBM25のようなBag-of-wordsタイプのモデルによって生成されます。このタイプの埋め込みは、密な埋め込みよりも次元が高く、ほとんどの要素がゼロであるため、"スパース "と呼ばれています。
しかし、従来のスパース手法の代替として、SPLADEのような、より高度なスパース埋め込みモデルを利用することもできます。SPLADEは、BERTをアーキテクチャに統合することで、チャンクの各単語に文脈情報を追加し、従来のアプローチと比較して情報量の多いスパースベクトルを生成します。
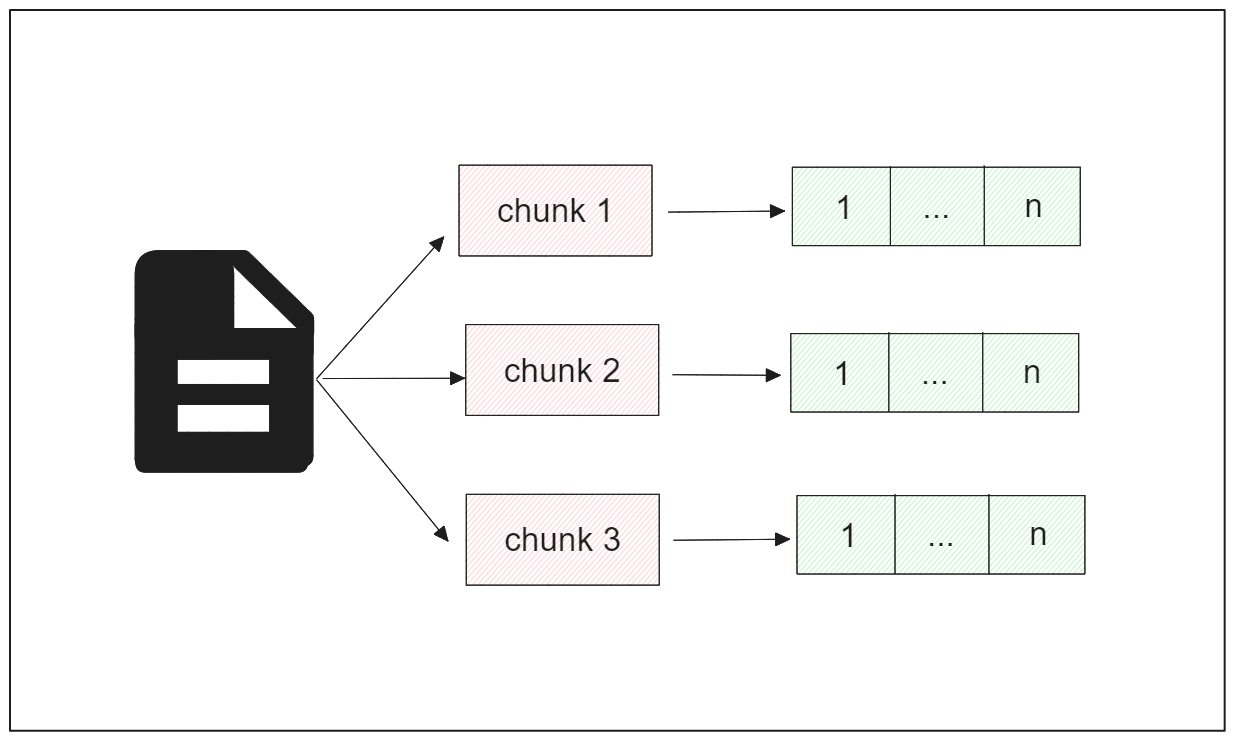
チャンクを埋め込みに変換するには、好きな埋め込みモデルを使うことができますが、この記事ではSentence TransformersのオールMiniLM-L6-v2モデルを使います。このモデルは、各チャンクを表現するために384次元の密な埋め込みを生成します。このモデルを使って、LangChainの助けを借りて埋め込みを生成します。
All-MiniLM-L6-v2モデルをインスタンス化して埋め込みを生成するには、LangChainから SentenceTransformerEmbeddings クラスを呼び出し、使用するモデル名を指定するだけです。
embeddings = SentenceTransformerEmbeddings(model_name="all-MiniLM-L6-v2")
次に、各チャンクの埋め込みベクトルを embed_documents メソッドで生成します。
chunk_embedding = embeddings.embed_documents([chunk_text[3]])
print(len(chunk_embedding[0]))

"""
出力:
384
"""
これで完了だ。これで各チャンクのベクトル埋め込みができた。次に、すべての埋め込みをMilvusのようなベクトルデータベースに入れて、RAGに使う必要がある。
ベクターデータベースとMilvusによるRAGの統合
これまで、Wikipediaから記事をスクレイピングし、すぐに使える埋め込みに変換するまでの前処理の例を見てきました。では、同じプロセスを5つのWikipedia記事に適用してみましょう。
ここでは、データサイエンス、機械学習、映画「Dune 2」、iPhone、ロンドンの5つのWikipedia記事のURLを取得する。コードの実装はこの ノートブックにある。
以下のコードは、これら5つの記事の内容をスクレイピングし、それぞれをチャンクに変換する:
# ライブラリを読み込む
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores.milvus import Milvus
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain.embeddings import SentenceTransformerEmbeddings
from langchain_core.prompts import PromptTemplate
from langchain_openai import ChatOpenAI

インポートリクエスト
from bs4 import BeautifulSoup

wiki_articles = ["Data_science", "Machine_learning", "Dune:_Part_Two", "IPhone", "London"].

# 各Wikipedia記事のテキストコンテンツを抽出する
texts = ""
for article in wiki_articles:
    response = requests.get(
        url=f"<https://en.wikipedia.org/wiki/{article}>"、
    )
    soup = BeautifulSoup(response.content, 'html.parser')

    # すべてのテキストを取得する
    all_texts = soup.find(id="bodyContent")
    text += all_texts.text

# テキストをチャンクに分割する
chunk_text = text_splitter.split_text(texts)
次に、各チャンクをエンベッディングに変換し、エンベッディングをMilvusに格納する。
Milvusはオープンソースのベクトルデータベースで、ベクトルの埋め込みを保存し、ベクトル検索、意味的類似性、質問応答などの様々なタスクを実行することを簡素化します。
LangChainの助けを借りてMilvusデータベースに全ての埋め込みデータを格納することで、後で簡単にRAGオーケストレーションを行うことができる。
vector_db = Milvus.from_texts(texts=chunk_text, embedding=embeddings, collection_name="rag_milvus")
そして、すべての埋め込みを'_rag_milvus'というデータベースに入れたので、これでRAGを実行する準備ができた。
次に、データベースをretrieverに変換する必要があります。つまり、vectorデータベースは、入力クエリを受け取り、選択した埋め込みモデルを使用して埋め込みに変換し、関連する答えを生成できるように、LLMのコンテキストとしてデータベース内の最も類似したチャンクを取得します。
retriever = vector_db.as_retriever()
次のステップは、クエリに対するレスポンスを生成するLLMを定義することです。この目的のために、ChatGPT 3.5 Turboモデルを使います。これはLangChainのOpenAIラッパーを使って呼び出すことができます。このモデルを使うには、OpenAIアカウントから取得できる固有のOpenAI APIキーが必要です。
import getpass
import os

os.environ["OPENAI_API_KEY"] = getpass.getpass()
llm = ChatOpenAI(model="gpt-3.5-turbo-0125")
次に、LLMのプロンプトを定義する必要があります。プロンプトは、LLMの回答を希望するフォーマットに従って誘導するために使用されるテクニックの1つです。RAGアプリケーションでは、プロンプトを試して、モデルが希望する形式で回答を生成することを確認することができます。
この投稿では、LLMの回答を導くために使用できる基本的なプロンプトの例を提供します。
template = """最後の質問に答えるために、以下の文脈を使用してください。
答えがわからない場合は、ただわからないと答え、答えを作ろうとしないでください。
最大3つの文章で、できるだけ簡潔に答えましょう。
答えの最後には必ず「Thanks for asking!

文脈

質問{質問}

役に立つ答え:""
custom_rag_prompt = PromptTemplate.from_template(テンプレート)
最後に、LangChainを使ってRAGパイプラインを定義しましょう。このステップでは、コンテキストのソース(我々の場合はMilvusベクトルデータベース)、クエリのソース、LLMのプロンプト、使用するLLM(我々の場合はChatGPT 3.5 Turboモデル)など、RAGアプリケーションに必要な情報を提供します。
提供されたコンテキストとクエリに基づいてレスポンスを生成するようにこれらの要素を設定することで、完全なRAGパイプラインを設定することができる。
def format_docs(docs):
    return " \nănănăn".join(doc.page_content for doc in docs)

rag_chain = (
    {"context": retriever | format_docs, "question":RunnablePassthrough()} | custom_rag_prompt
    | custom_rag_prompt
    | llm
    | StrOutputParser()
)
これでRAGを実行する準備ができました。次のような質問があるとしよう:データ・サイエンティストとは何ですか?"_とすると、以下のコードでベクトル・データベースが提供するコンテキストに基づいてLLMの回答を得ることができる:
for chunk in rag_chain.stream("What is a Data Scientist?"):
    print(chunk, end="", flush=True)

"""
出力:
データサイエンティストとは、プログラミングコードと統計的知識を組み合わせ、データから洞察を生み出す専門家である。データ・サイエンティストは、データの収集、クリーニング、分析、分析手法の選択、予測モデルの展開を担当する。データサイエンティストは、複雑な問題を解決し、隠れたパターンを発見するために、数学、コンピュータサイエンス、および専門領域の交差点で働きます。

ご質問ありがとうございました!
"""
そして、LLMから正確な返答を得ることができた!LLMの返答の最後には、私たちのプロンプトに対応する文章"Thank you for asking"も含まれていることにお気づきだろうか。
LLMが応答を生成するためにチャンクのどの部分がコンテキストとして使用されたかを知りたければ、invokeメソッドを呼び出し、引数として質問を与えることができます。
contexts = retriever.invoke("What is a Data Scientist?")
print(contexts)
"""
出力
[Document(page_content='A data scientist is a professional who creates programming code and combines it with statistical knowledge to create insights from data.[9]', metadata={'pk':450048016754672937}), Document(page_content='The professional title of "data scientist" has been attributed by DJ Patil and Jeff Hammerbacher in 2008.[32] Though it was used by the National Science Board in their 2005 report "Long-Lived Digital Data Collections:21世紀の研究と教育を可能にする "という2005年のNational Science Boardの報告書で使用されたが、デジタルデータコレクションの管理におけるあらゆる重要な役割を広く指している[33]', metadata={'pk':450048016754672955}), Document(page_content='データ分析が既存のデータから洞察を抽出することに重点を置いているのに対して、データサイエンスは情報に基づいた意思決定を行うための予測モデルの開発と実装を取り入れることで、それを超えている。データサイエンティストは多くの場合、データの収集とクリーニング、適切な分析手法の選択、実世界のシナリオにおけるモデルの展開を担当する。複雑な問題を解決し、隠れたパターンを発見するために、数学、コンピュータサイエンス、専門分野の交差点で働く', metadata={'pk':450048016754672963})]
"""
ご覧のように、LLMがレスポンスを生成するために使用する最初のチャンクは、質問に対する回答に非常に関連しています。これは、LLMが内部文書からの情報を照会する場合でも、正確で文脈に沿った応答を生成するのに役立ちます。
私たちのプロンプトでは、LLMに提供されたコンテキストのみに基づいて回答を提供し、提供されたコンテキストに質問に対する回答が含まれていない場合は、どのような回答も作り出さないように指示しました。
このステップを評価するために、LLMに「インセプションのプロットを要約してください」と尋ねてみましょう。すると、次のような答えが返ってくるはずだ:
for chunk in rag_chain.stream("Summarize the plot of Inception"):
    print(chunk, end="", flush=True)

"""
出力:
申し訳ありませんが、提供された文脈から『インセプション』のプロットに関する情報を提供することはできません。ご質問ありがとうございます!
"""
contexts = retriever.invoke("インセプションのプロットを要約する")
print(contexts)
"""
出力
[Document(page_content='Plot[edit]', metadata={'pk': 450048016754673364}), Document(page_content='映画監督スティーヴン・スピルバーグは、この映画を「私が今まで見た中で最も素晴らしいSF映画の1つ」と賞賛し、さらに「深く深く描かれたキャラクターで満たされている。しかし、映画の上映時間に比例して、セリフは非常に少ない。そんな映画だ。ショットはとても絵画的で、でも気取ったアングルや設定は一つもない」[159][160], metadata={'pk':450048016754673473})]
"""
私たちのLLMの回答は、まさに私たちが望んでいるものである。
結論
この投稿では、RAGアプリケーションでLLMの回答のコンテキストとしてウェブサイトのデータを使用するためのステップバイステップのガイドを学びました。
まず、利用可能なウェブスクレイピングツールとBeautifulSoupのようなPythonライブラリを使用して、ウェブサイトのコンテンツをスクレイピングした。次に、抽出したコンテンツをチャンクに分割してコンテンツの粒度を上げ、LLMからの応答の質を向上させた。次に、各チャンクをベクトル埋め込みに変換した。最後に、これらの埋め込みをMilvusのベクトルデータベースに格納し、このデータベースをRAGシナリオのリトリーバーとして使用した。
クエリを渡すと、ベクトルデータベースは選択した埋め込みモデルを用いて埋め込みに変換し、データベース内の最も類似したチャンクをLLMのコンテキストとして検索し、高度にコンテキスト化された答えを生成する。
この投稿でデモしたコードは全てこの notebook にあります。
 Ruben WinastwanFreelance Technical Writer