




Massive Text Embedding Benchmark (MTEB)
テキスト埋め込みは、多くの場合、1つのタスクからの少数のデータセットでしかテストされておらず、他のタスクでどの程度うまく機能するかは示されません。Semantic Textual Similarity(STS)に最適な埋め込みが、クラスタリングやリランキングのようなタスクでも同じようにうまく機能するかどうかは明確ではありません。そのため、新しいモデルや埋め込みが一貫したテストなしに一般的に評価され、絶えず提案されているため、この分野の進歩を把握することが難しくなっています。
この問題に対処するため、研究者たちはMassive Text Embedding Benchmark(MTEB)を作成しました。MTEBは、112言語の58データセットにわたる8つの埋め込みタスクをカバーしています。研究者たちは、MTEB上で33モデルを対象に8つの埋め込みタスクをテストし、これまでで最も包括的なテキスト埋め込みのベンチマークとしました。
彼らは、すべてのタスクに最適な単一の埋め込み手法は存在しないことを発見しました。これは、すべての埋め込みタスクに最適に機能する汎用的なテキスト埋め込み手法は、規模を拡大してもまだ開発されていないことを示唆しています。また、要件に最も適した埋め込みモデルを選ぶために、十分なデューデリジェンスを行うことの重要性も強調しています。
MTEBには、オープンソースコード、公開リーダーボード、そしてどのモデルがより良い文書を取得するか、より優れたクラスタリングを行うかなどについて投票できる楽しいMTEB Arenaが付属しており、いずれもHugging Faceのウェブサイト上にあります。このベンチマークは、コミュニティが新しい手法を一貫してテストし、テキスト埋め込み技術の改善を追跡するのに役立ちます。
背景と動機
テキスト埋め込みは、多くのNatural Language Processing(NLP)タスクの重要な一部になっています。これらの埋め込みは、単語、文、または文書を、その意味を捉えた数値表現に変換します。機械翻訳、固有表現認識、質問応答、感情分析、要約など、さまざまなアプリケーションで使用されています。
長年にわたり、研究者たちはこれらの埋め込みをテストするために多くのデータセットやベンチマークを作成してきました。有名なものには、SemEval、GLUE, SuperGLUE、Big-Bench、WordSim353、SimLex-999などがあります。これらは通常、標準的な単語埋め込みや文脈的単語埋め込みの評価に焦点を当てています。
しかし、テキスト埋め込みの評価方法には、まだいくつかのギャップがあります。
単語埋め込みと文埋め込みの両方をカバーするベンチマークはほとんどありません。
多くの評価は、埋め込みがテキスト全体の意味をどの程度捉えているかではなく、特定のNLPタスクに焦点を当てています。
既存のベンチマークでは、埋め込みが実際のアプリケーションでどのように使用される可能性があるかを考慮していないことがよくあります。
幅広いテキスト理解タスクを評価できる包括的なベンチマークが必要です。このベンチマークは、NLP研究者と実用的なアプリケーションに取り組む人々の両方にとって有用であるべきです。Massive Text Embedding Benchmark(MTEB)は、このギャップを埋めることを目指しています。
テキスト埋め込み
テキスト埋め込みとは、テキストを数値のリストとして表現する方法です。これらの数値は、単一の単語、文、あるいは文書全体を表すことができます。このリストは通常、数百個の数値で構成されます。
テキスト埋め込みは、多くのNLPタスクで使用されています。単語の場合、スペルチェックや単語間の関係の発見などに使われます。より長いテキストの場合、文章の感情を把握したり、新しいテキストを生成したりするタスクで使われます。
テキスト埋め込みを作成する方法は数多くあります。一般的な手法には次のようなものがあります。
ELMo のように、さまざまなNLPタスクで学習された手法
word2vecやGloVeのような単語ベースの手法。これらはコンピュータビジョン研究でよく使用されます
研究者たちは多くの異なる埋め込みを作成しており、比較対象は少なくとも165あります。また、これらの埋め込みの長所と短所を理解するために、15種類の異なるツール(決定木やRandom Forestsなど)も作成しています。
しかし、これらすべての異なる埋め込みを比較する標準的な方法はありません。これが、Massive Text Embedding Benchmark(MTEB)が解決しようとしている問題です。
Massive Text Embedding Benchmarkの設計と実装
MTEBは、いくつかの重要な目標を念頭に置いて設計されました。
多様性: MTEBは、多くの異なるタスクで埋め込みモデルをテストします。8種類のタスクが含まれており、それぞれ最大15のデータセットがあります。合計58のデータセットのうち、10は複数言語に対応しており、合計112言語をカバーしています。このベンチマークは、短い(文レベル)テキストと長い(段落レベル)テキストの両方をテストし、異なるテキスト長でモデルがどのように機能するかを確認します。
シンプルさ: MTEBは使いやすいです。テキストのリストを受け取り、数値表現(ベクトル)のリストを生成できるモデルであれば、どのようなモデルでもテストできます。つまり、多くの異なる種類のモデルを比較できます。
拡張性: MTEBに新しいデータセットを追加するのは簡単です。既存のタスクの場合、タスクを説明し、Hugging Face上でデータが保存されている場所を示すファイルを追加するだけで済みます。新しい種類のタスクを追加するにはもう少し作業が必要ですが、MTEBは成長を支援するコミュニティからの貢献を歓迎しています。
再現性: MTEBは実験の再現を容易にします。データセットとソフトウェアの異なるバージョンを追跡します。MTEB論文の結果はJSONファイルとして利用できるため、誰でも確認または使用できます。
これらの特徴により、MTEBは、合計で幅広いタスクと言語をカバーするタスク全体にわたってtext embedding modelsを評価するための包括的で柔軟なツールとなっています。
Massive Text Embedding Benchmarkにおけるタスクと評価
Massive Text Embedding Benchmarkには、埋め込みモデルをテストするための8種類のタスクが含まれています。各タスクの簡単な内訳は次のとおりです。
Bitext Mining: 2つの異なる言語で一致する文を見つけます。主な指標はF1スコアです。
Classification: 埋め込みを使用してテキストをカテゴリに分類します。主な指標は正解率です。
Clustering: 類似したテキストをグループ化します。主な指標はv-measureです。
Pair Classification: 2つのテキストが類似しているかどうかを判断します。主な指標は平均適合率です。
Reranking: クエリとの一致度に基づいてテキストのリストを並べ替えます。主な指標はMAP(Mean Average Precision)です。
Retrieval: 指定されたクエリに関連する文書を見つけます。主な指標はnDCG@10です。
Semantic Textual Similarity(STS): 2つの文がどれだけ似ているかを測定します。主な指標はSpearman相関です。
Summarization: 機械生成された要約を人間が書いた要約と比較してスコア付けします。主な指標もSpearman相関です。
各タスクに対して、MTEBは埋め込みモデルを使用してテキストをベクトル埋め込みに変換します。次に、コサイン類似度やロジスティック回帰などの手法を使用してタスクを実行し、スコアを計算します。
MTEBには、各タスク向けに多くのデータセットが含まれており、さまざまな言語やテキストの長さをカバーしています。これにより、埋め込みモデルがさまざまな状況でどれだけうまく機能するかをテストできます。
これらの多様なタスクとデータセットを使用することで、Massive Text Embedding Benchmarkは、さまざまなテキスト埋め込みモデルを評価し比較するための包括的な方法を提供します。
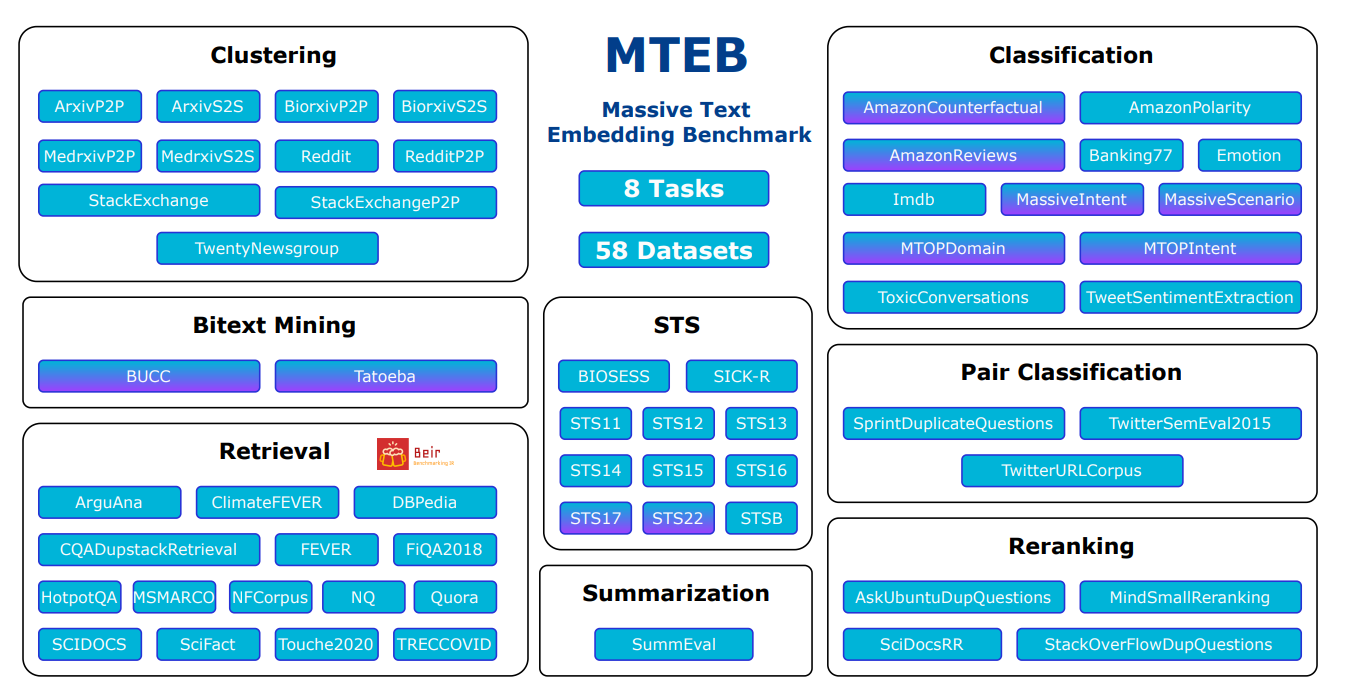 MTEBにおけるタスクとデータセットの概要
出典: MTEB: Massive Text Embedding Benchmark
Massive Text Embedding Benchmarkのデータセット
Massive Text Embedding Benchmarkは、特定のテキスト埋め込み手法やモデルをテストするために、多くの異なるデータセットを使用します。これらのデータセットは、比較されるテキストの長さに基づいて、主に3つのタイプに分類されます。
Sentence to Sentence (S2S): これは、1つの文を別の文と比較する場合です。たとえば、Semantic Textual Similarityタスクでは、2つの文がどれほど似ているかを判断することが目標です。
Paragraph to Paragraph (P2P): これは、より長いテキスト同士を比較するものです。MTEBはこれらの長さに制限を設けておらず、必要に応じてモデルが長いテキストを処理できるようにしています。クラスタリングのような一部のタスクは、S2S(タイトルのみを比較)とP2P(タイトルと内容を比較)の両方で行われます。
Sentence to Paragraph (S2P): これは一部の検索タスクで使用され、短いクエリ(文)をより長いドキュメント(段落)と比較します。
MTEBには56種類のデータセットが含まれています。これらのデータセットの中には、互いに似ているものもあります。
同じ基盤となるテキストデータを使用するものがあります(ClimateFEVERやFEVERなど)。
類似したタスク向けのデータセット(CQADupstackやSTSの異なるバージョンなど)は、似ている傾向があります。
同じデータセットのS2S版とP2P版は、多くの場合似ています。
類似したトピック(科学論文など)に関するデータセットは、異なるタスク向けであっても似ている傾向があります。
このように幅広いデータセットを使用することで、MTEBは、埋め込みモデルがさまざまな種類のテキストやさまざまなタスクでどれだけうまく機能するかをテストできます。これにより、各モデルの強みと弱みをより完全に把握できます。
Massive Text Embedding Benchmarkの初期ベンチマーキングにおけるモデル
MTEBを使用した最初のテストでは、研究者たちは最高であると主張するモデルや、Hugging Face Hubで人気のあるモデルを調査しました。つまり、多くのtransformer modelsをテストしたということです。研究者たちは、人々が自分のニーズに最適なモデルを選びやすくするために、モデルを3つのタイプに分類しました。
最速モデル: Gloveのようなモデルは非常に高速ですが、文脈を十分に理解できません。つまり、MTEB全体ではそれほど高いスコアを出せません。
バランス型モデル: all-mpnet-base-v2やall-MiniLM-L6-v2のようなモデルは、最速のものより少し遅いですが、はるかに優れた性能を発揮します。速度と品質の良いバランスを提供します。
最高性能モデル: ST5-XXL、GTR-XXL、SGPT-5.8B-msmarcoのような、数十億のパラメータを持つ大規模モデルは、MTEBで最も優れた結果を出します。ただし、速度が遅く、より多くのストレージが必要になる場合があります。たとえば、SGPT-5.8B-msmarcoは4096個の数値を持つ埋め込みを作成するため、より多くの容量を使用します。
モデルの性能は、特定のタスクやデータセットによって大きく変わる可能性があることに注意することが重要です。研究者たちは、単一のタスクや特定のニーズにどのモデルが最適かを確認するために、MTEB leaderboardを確認することを提案しています。
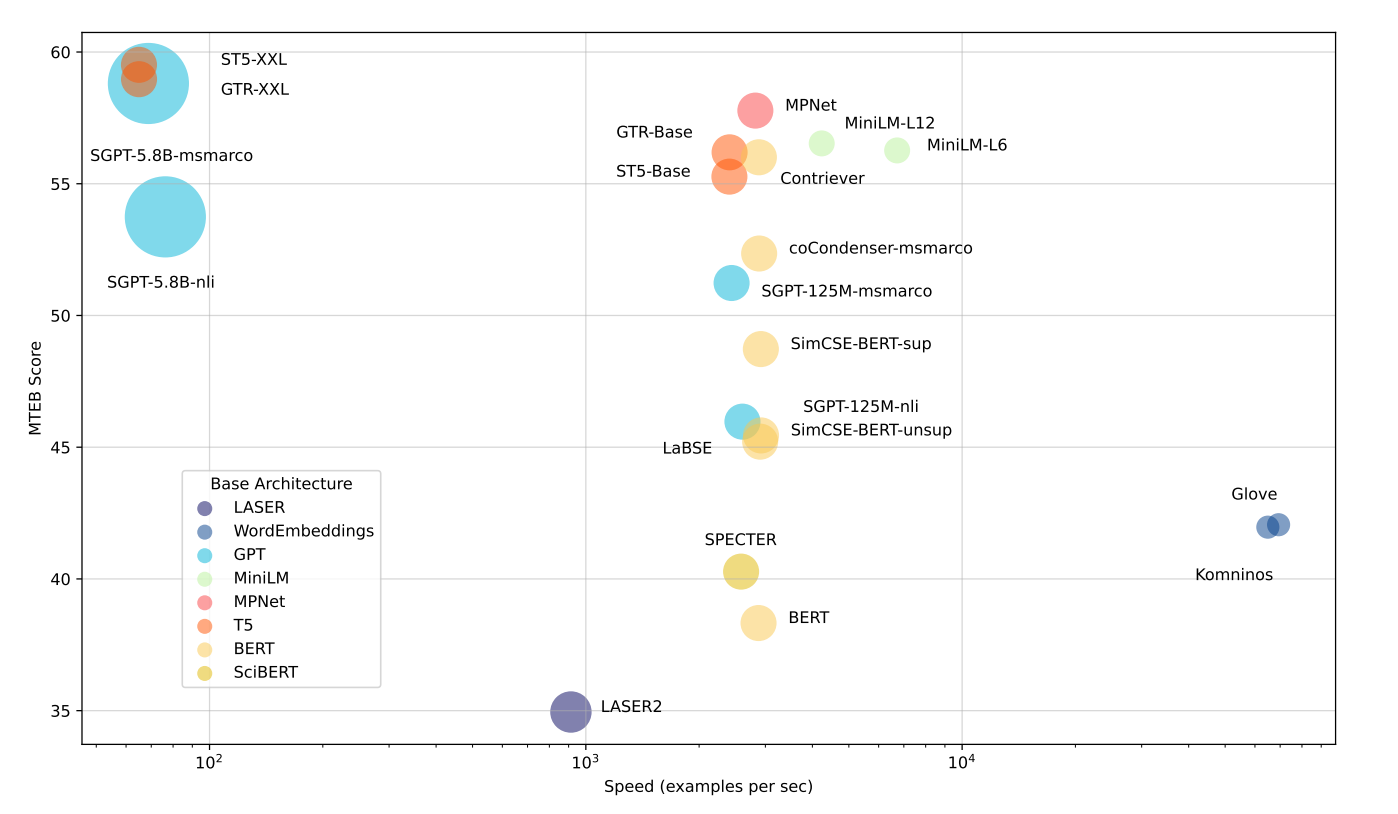 初期テストのベンチマーク結果
出典: MTEB: Massive Text Embedding Benchmark
このテスト手法は、さまざまな埋め込みモデルにおける速度と性能のトレードオフを明確に示し、ユーザーが自分の具体的な要件に基づいて十分な情報を得たうえで判断できるようにします。自分で試してみたい場合は、vector embeddingsを生成する任意のモデルのベンチマーク方法を説明している、Huggigng Face の優れたブログがあります。
Massive Text Embedding Benchmark を使うべきタイミング
MTEB は、テキスト埋め込みモデルが多くの異なるタスクでどれほどよく機能するかをテストするためのツールです。いくつかの状況で役立ちます:
自分のモデルをテストする: 新しい埋め込みモデルを作成した場合、MTEB を使って他のモデルと比較できます。結果を公開リーダーボードに追加でき、自分のモデルが他のモデルと比べてどの程度の位置にあるかを確認するのに役立ちます。
適切なモデルを選ぶ: タスクによって、より適したモデルは異なります。MTEB のリーダーボードは、さまざまなタスクでモデルがどのように機能するかを示し、具体的なニーズに最適なモデルを選ぶのに役立ちます。
MTEB の改善に貢献する: MTEB はオープンソースであり、誰でも貢献できます。新しいタスク、データセット、性能測定方法、またはモデルを作成した場合、それを MTEB に追加できます。これにより、ベンチマークをさらに改善できます。
研究: テキスト埋め込みを研究している場合、MTEB はモデルをテストするための包括的な方法を提供します。現在の最良モデルで何ができるのか、また改善の余地がどこにあるのかを示してくれます。
多くのタスクでモデルをテストする標準的な方法を提供することで、MTEB は研究者や開発者がテキスト埋め込み技術を理解し、改善するのを支援します。テキスト埋め込みを扱う人、または研究する人にとって価値のあるツールです。
Massive Text Embedding Benchmark リーダーボードの使い方
まず、MTEB スコアに惑わされないでください!
MTEB は有用なツールですが、その限界を理解することが重要です。スコアは表示されますが、スコア間の差に意味があるかどうかは示していません。多くの上位モデルは平均スコアが非常に近く、それらは多くの異なるタスクから得られていますが、これらのスコアがどの程度ばらつくかについての情報はありません。最上位のモデルは優れているように見えるかもしれませんが、その差は重要ではない可能性があります。ユーザーは生の結果を取得して、自分で確認できます。一部の研究者は、特定の言語ベンチマークにおける複数の上位モデルが、統計的に見れば実際には同等に優れていることを発見しています。平均スコアだけを見るのではなく、意図したユースケースに似たタスクでモデルがどのように機能するかに注目するほうがよいでしょう。これは、総合スコアよりも、特定のアプリケーションでモデルがどのように機能するかについて、より多くの洞察を与えてくれる可能性があります。データセットを詳細に調べる必要はありませんが、どのような種類のテキストが含まれているかを知っておくことは有益です。この情報は通常、データセットの説明や、いくつかの例をざっと見ることで得られます。Massive Text Embedding Benchmark は便利なツールですが、完璧ではありません。結果について批判的に考え、それが具体的なニーズにどのように当てはまるかを考えることが重要です。単に総合スコアが最も高いモデルを選ぶのではなく、目の前のタスクに最適なモデルを見つけるために、より深く調べるほうがよいでしょう。
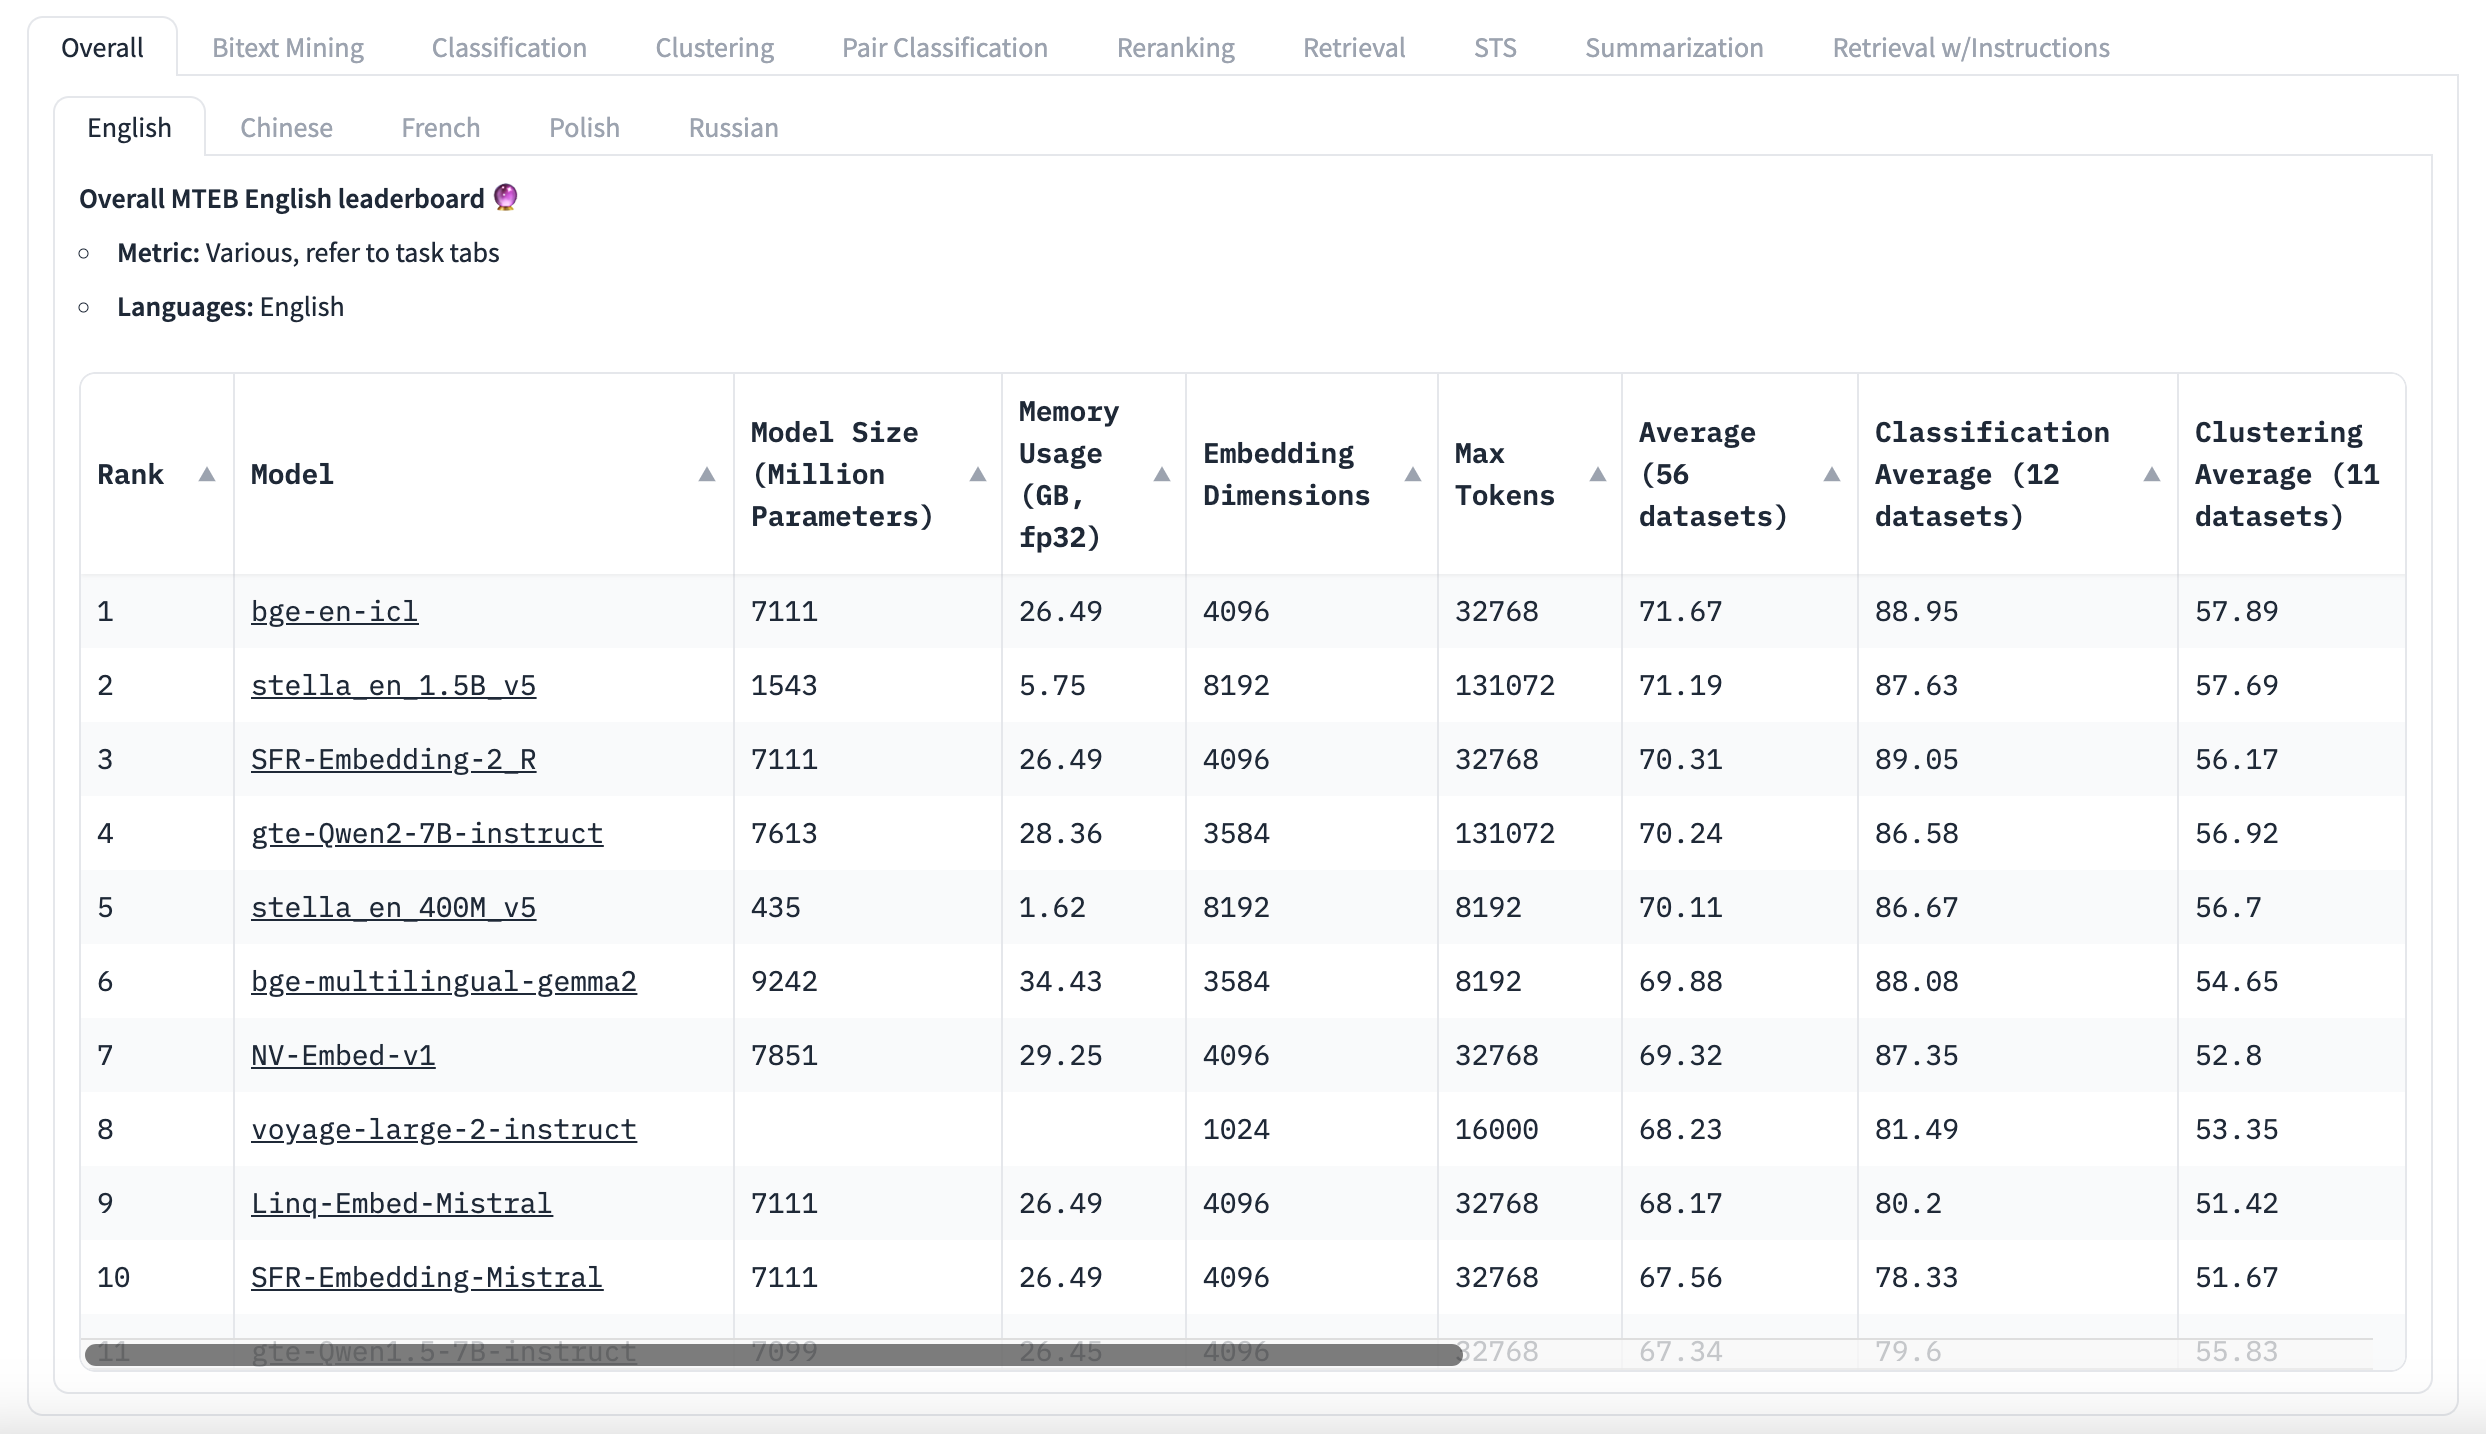 MTEB Leaderboard English
アプリケーションのニーズを考慮することを忘れないでください
すべてのタスクに万能なモデルはありません。だからこそ Massive Text Embedding Benchmark が存在します。つまり、具体的なニーズに合った適切なモデルを選ぶのを支援するためです。Massive Text Embedding Benchmark リーダーボードを見るときは、アプリケーションが何を必要としているかを考えることが重要です。考慮すべき点をいくつか挙げます:
言語: そのモデルは、あなたが扱っている言語をサポートしていますか?
専門用語: 金融や法律のテキストを扱う場合は、分野固有の用語を理解するモデルが必要になります。
モデルサイズ: モデルをどこで実行するかを考えてください。ノートパソコンに収まる必要がありますか?
メモリ使用量: モデルにどれだけのコンピュータメモリを割り当てられますか?
最大入力長: 扱うテキストの長さはどのくらいですか?
タスクにとって何が重要かが分かったら、これらの特徴に基づいて MTEB リーダーボード上のさまざまなモデルを並べ替えることができます。これにより、性能が高いだけでなく、実務上の要件にも合うモデルを見つけやすくなります。
性能と実務上のニーズの両方を考慮することで、特定の状況に最適なモデルを選択できます。
Zilliz AI Model リソース
Massive Text Embedding Benchmark からテキスト埋め込みモデルを選択したので、次はそれを活用して、オープンソースの Milvus または Zilliz Cloud に保存・検索するためのテキスト埋め込みを作成しましょう。Zilliz のウェブサイトでは、より人気のあるマルチモーダルモデルやテキスト埋め込みモデルの一部を一覧表示している AI Models ページを見つけることができます。
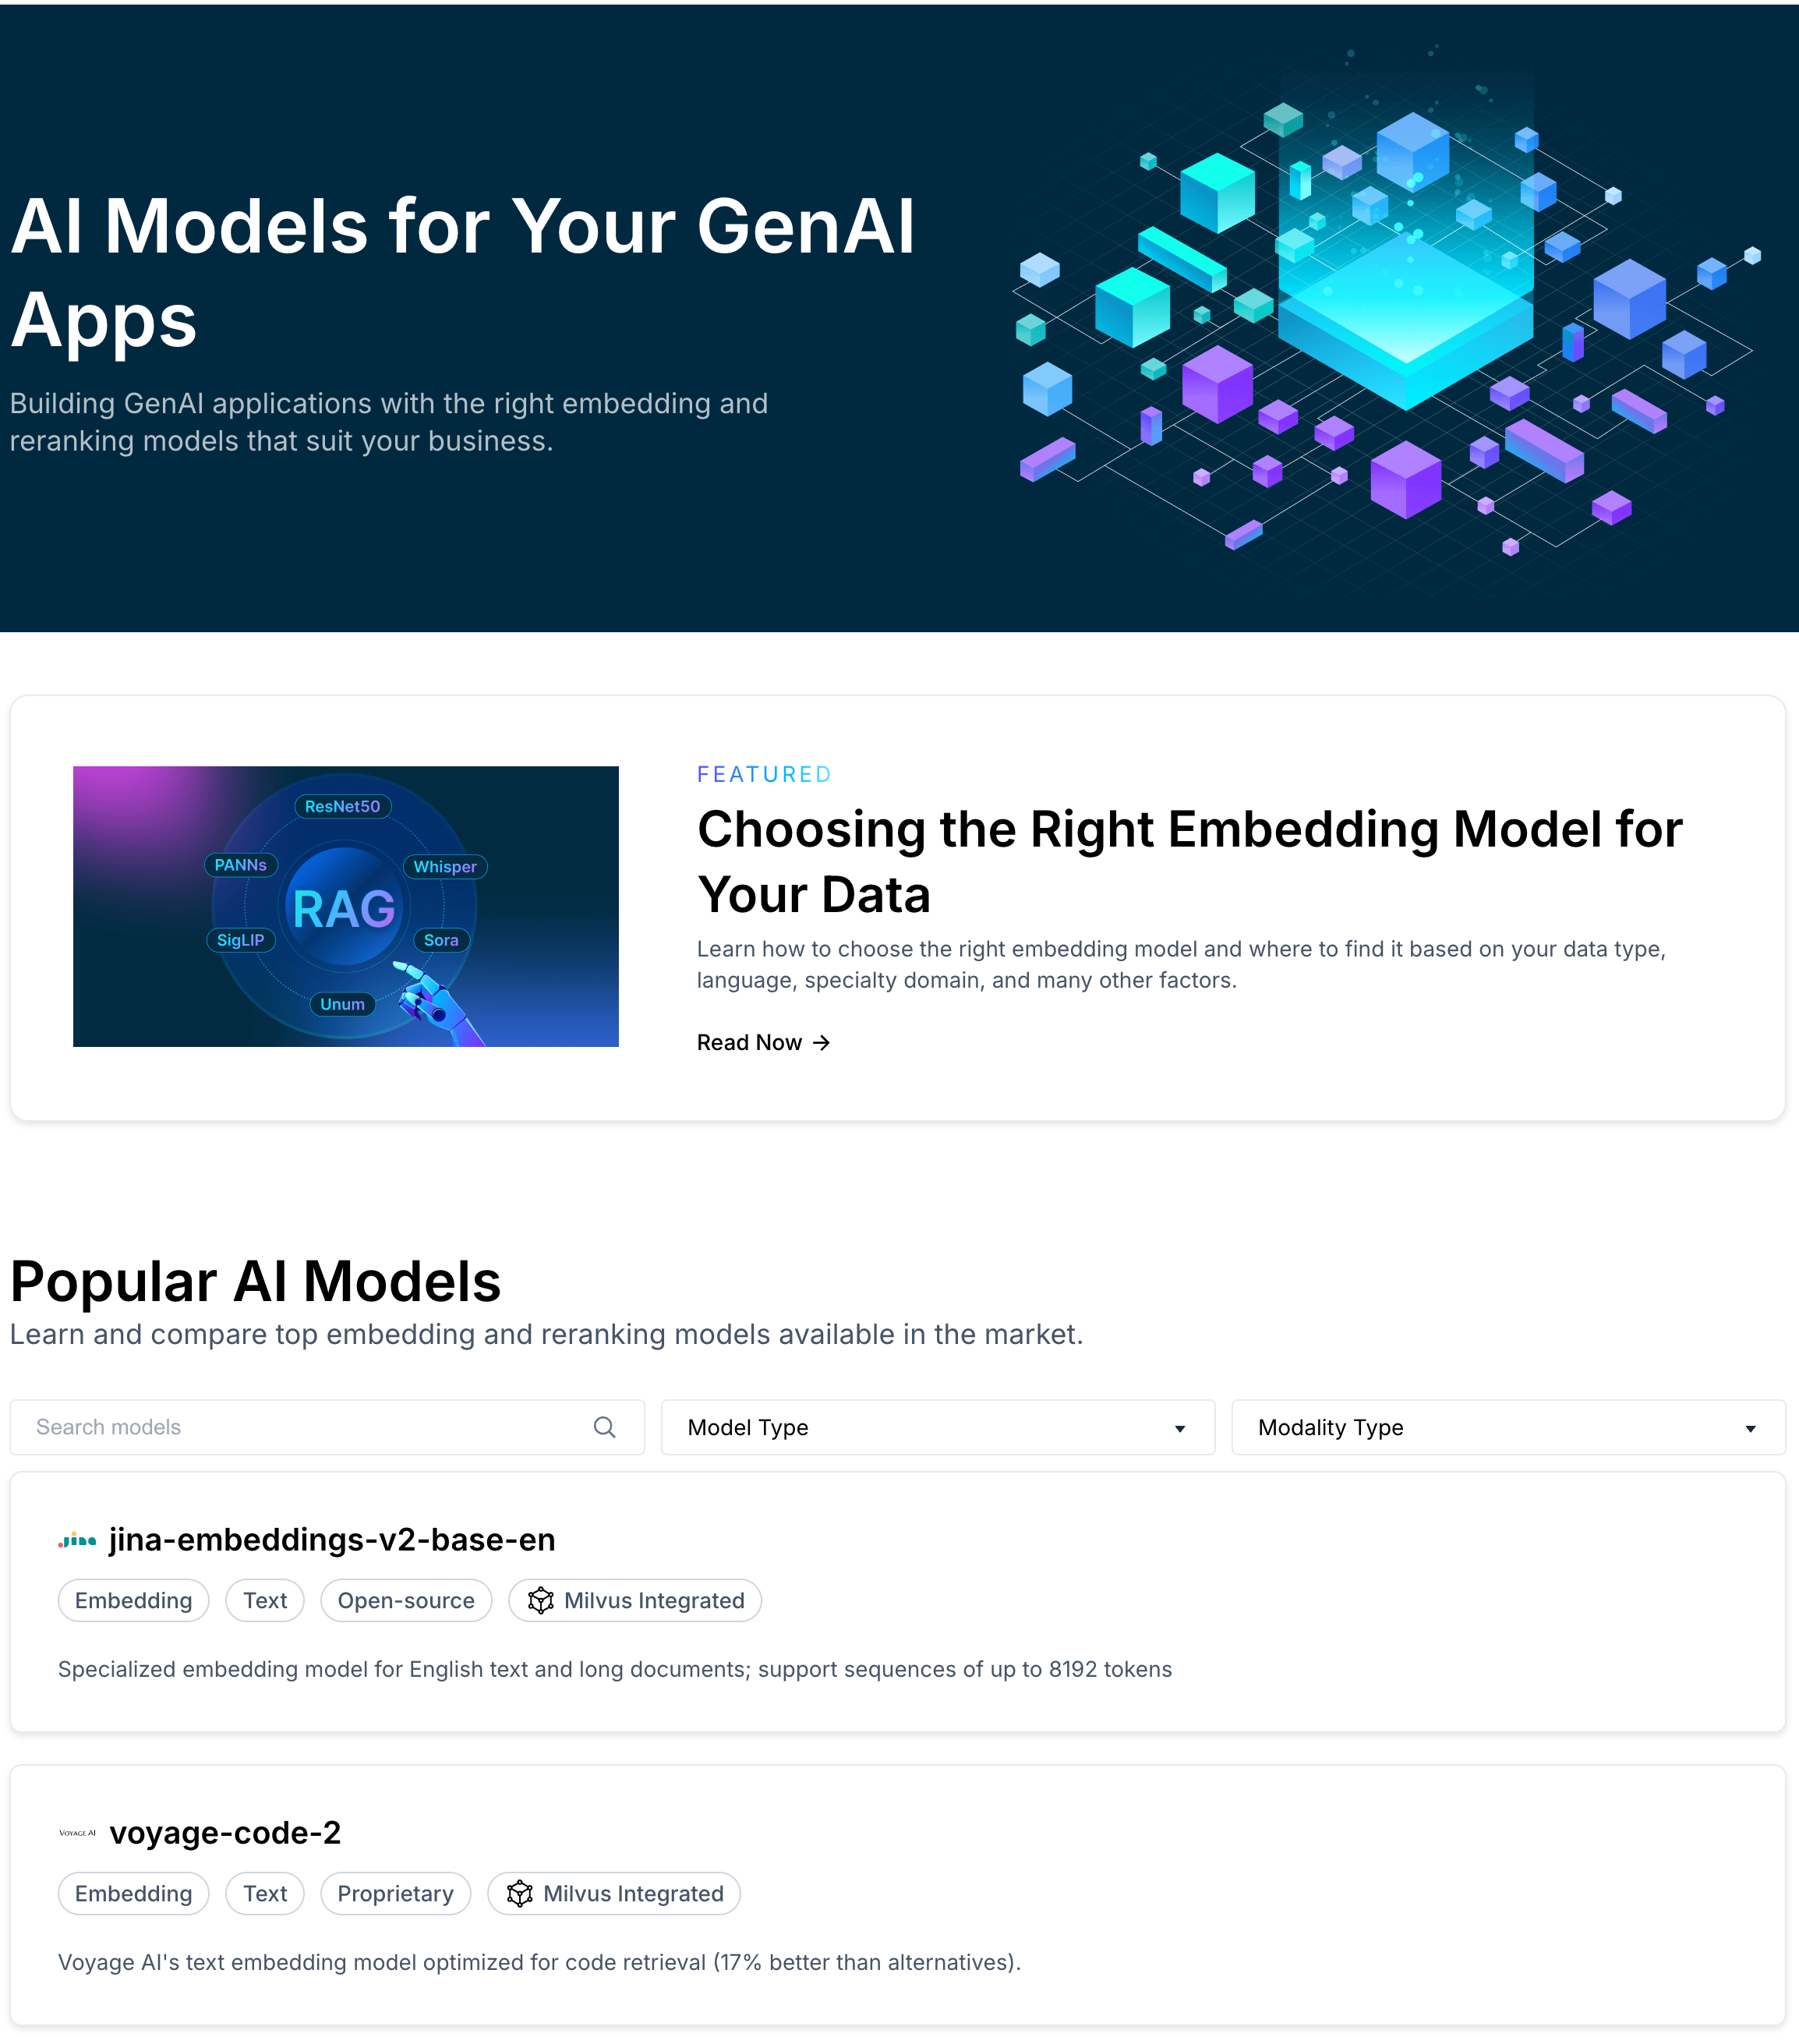 Zilliz AI Model ページ
このページでモデルを選択すると、さまざまな SDK、PyMilvus などを使用してベクトル埋め込みを作成する方法について、いくつかの詳細な手順が示されていることが分かります。
結論
Massive Text Embedding Benchmark (MTEB) は、テキスト埋め込みモデルの評価における大きな前進です。幅広いタスク、言語、テキスト長をカバーすることで、従来のベンチマークの限界に対処しています。MTEB の設計は、多様性、シンプルさ、拡張性、再現性に重点を置いており、自然言語処理の分野における研究者と実務者の双方にとって価値あるツールとなっています。
MTEB の最も包括的なベンチマーク手法は、8 種類の異なるタスクと 58 のデータセットにわたってモデルをテストすることで、従来のベンチマークよりもモデルの能力をより完全に把握できます。すべてのタスクで優れた単一の埋め込み手法は存在しないことを明らかにしており、特定のアプリケーションに適したモデルを選ぶ重要性を示しています。
MTEB を使用する際は、総合スコアだけでなく、アプリケーションの具体的なニーズを考慮することが重要です。言語サポート、専門用語、モデルサイズ、メモリ使用量、最大入力長などの要素はすべて、意思決定プロセスで考慮されるべきです。
MTEB は強力なツールですが、批判的に使用することが重要です。上位モデル間のスコアの差が常に統計的に有意であるとは限らず、性能は特定のタスクやデータセットによって大きく変わる可能性があります。
オープンソースプロジェクトとして、MTEB はコミュニティからの貢献を歓迎しており、分野の進化するニーズに合わせて成長し適応できます。この協調的なアプローチにより、MTEB はテキスト埋め込み技術の評価と改善において、今後も関連性の高い価値あるリソースであり続けることが保証されます。
幅広いタスクと言語にわたってテキスト埋め込みモデルを評価する標準化された方法を提供することで、MTEB はこの分野の進歩を促進し、最終的にはさまざまなアプリケーション向けのより優れた、より汎用性の高いテキスト埋め込みモデルにつながっています。
参考文献
Muennighoff, Niklas and Tazi, Nouamane and Magne, Lo{\"\i}c and Reimers, Nils. "MTEB: Massive Text Embedding Benchmark" arXiv 2022
Shitao Xiao, Zheng Liu, Peitian Zhang, Niklas Muennighoff. "C-Pack: Packaged Resources To Advance General Chinese Embedding" arXiv 2023
Michael Günther, Jackmin Ong, Isabelle Mohr, Alaeddine Abdessalem, Tanguy Abel, Mohammad Kalim Akram, Susana Guzman, Georgios Mastrapas, Saba Sturua, Bo Wang, Maximilian Werk, Nan Wang, Han Xiao. "Jina Embeddings 2: 8192-Token General-Purpose Text Embeddings for Long Documents" arXiv 2023
Silvan Wehrli, Bert Arnrich, Christopher Irrgang. "German Text Embedding Clustering Benchmark" arXiv 2024
Orion Weller, Benjamin Chang, Sean MacAvaney, Kyle Lo, Arman Cohan, Benjamin Van Durme, Dawn Lawrie, Luca Soldaini. "FollowIR: Evaluating and Teaching Information Retrieval Models to Follow Instructions" arXiv 2024
Dawei Zhu, Liang Wang, Nan Yang, Yifan Song, Wenhao Wu, Furu Wei, Sujian Li. "LongEmbed: Extending Embedding Models for Long Context Retrieval" arXiv 2024
Kenneth Enevoldsen, Márton Kardos, Niklas Muennighoff, Kristoffer Laigaard Nielbo. "The Scandinavian Embedding Benchmarks: Comprehensive Assessment of Multilingual and Monolingual Text Embedding" arXiv 2024