




情報検索システムのためのBEIRベンチマークとは
情報検索システムのためのBEIRベンチマークとは
情報検索のためのBEIRベンチマークの分析
情報検索とBEIRの紹介
IRシステムは、ユーザーのクエリに応じて文書を見つけるように設計されています。これらのシステムが進化するにつれて、既存のシステムを理解するための包括的な評価方法の必要性も高まってきました。
BEIR(Benchmarking IR)は、多くのタスクや情報の種類にわたって検索システムがどれほど優れた性能を発揮するかを評価するためのツールです。研究者たちは、既存の評価方法の限界に対処するためにBEIRを開発しました。BEIRは、特にドメイン外において、検索技術をより現実的に評価します。
特定のタスクやドメインに焦点を当てる従来のベンチマークとは異なり、BEIRは多くのシナリオにわたって多数のIRシステムモデルをテストする異種混合の評価フレームワークです。ファクトチェック、質問応答、生物医学情報検索など、さまざまなタスクのための18のデータセットを備えています。この多様性により、BEIRはIRシステムの汎用性と堅牢性を、実世界のアプリケーションにより近い形で評価できます。
BEIRの主要な革新の1つは、ゼロショット評価に焦点を当てていることです。これは、モデルが特に訓練されていないタスクでどれほど優れた性能を発揮するかをテストします。これにより、さまざまなIRモデルの強みと弱みに関する重要な知見、特にドメイン外検索において密検索モデルが直面する課題が明らかになりました。
以下では、BEIRの特徴、情報検索におけるその重要性、そして検索技術に与える影響について詳しく見ていきます。BEIRを従来の字句的手法や検索エンジンから最新のニューラルモデルまでのさまざまなアプローチと比較し、堅牢で適応性の高い検索システムを構築する開発者にとって何を意味するのかを議論します。
BEIRとは?
「beer」のように聞こえ、ロゴも2つのビールジョッキですが、残念ながら私が慣れ親しんでいる種類のビールではなく、まったく別の種類の「Bier!」です。BEIRはBenchmarking IR(Information Retrieval)の略で、多くのタスクや情報の種類にわたって情報検索システム(検索システム)がどれほど優れた性能を発揮するかを評価するためのツールです。研究者たちは、既存の評価方法の限界に対処するためにBEIRを開発しました。BEIRは、検索技術をより現実的に評価します。
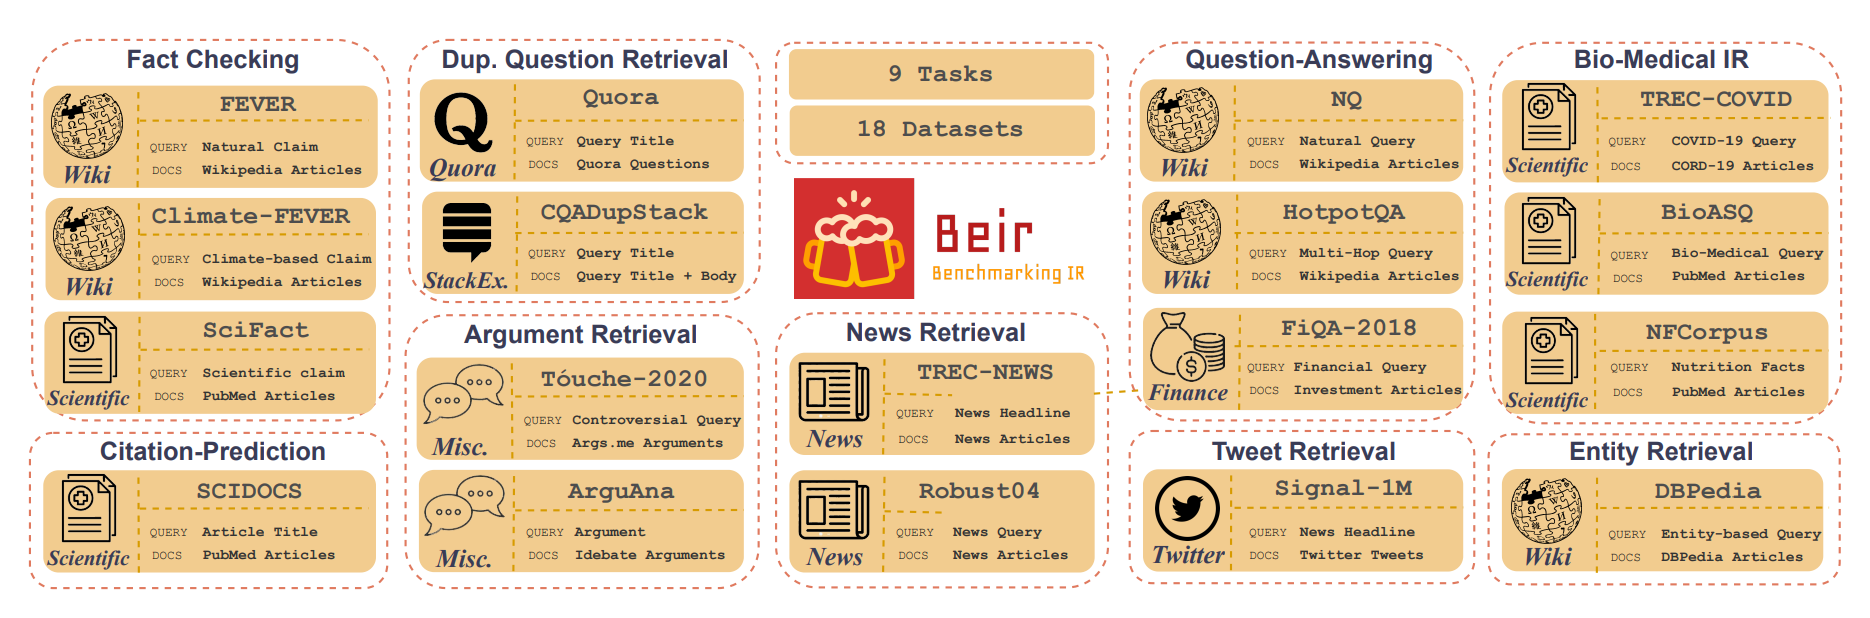 Bierの多様なデータセットコレクションの概要
BEIRの特徴
Benchmarking Information Retrievalは、情報検索モデルの性能を評価するための標準的なベンチマークであり、さまざまな検索タスクに焦点を当てた多様なデータセットのコレクションを提供します。多様なタスクやドメインにわたって検索技術をより現実的に評価する必要性に対応しています。BEIRの主な特徴をいくつか紹介します。
BEIRは、情報検索モデルの汎用性と堅牢性を評価するために設計されたベンチマークです。バイオインフォマティクス、金融、ニュースなどのドメインからなる18の多様なデータセットを備えており、ファクトチェック、質問応答、文書検索、推薦システムなど、幅広い多様なテキスト検索タスクでモデルをテストできます。
このベンチマークは、類似性検索、議論検索、ファクトチェックなど、9つの異なる検索タスクを対象としており、さまざまな実世界のシナリオでモデルをテストします。そのクロスドメインテスト機能により、モデルを訓練ドメイン外のタスクで評価でき、汎化能力を評価するための貴重なツールとなっています。
BEIRは、NDCGやRecallのような標準化された評価指標を使用しており、モデルやデータセット間の比較を簡素化します。また、BERT、T5、GPTのような人気モデルとの統合も含まれており、ベンチマーキングプロセスを効率化します。BEIRのオープンソースという性質は、コミュニティの協力と適応を促進し、ベンチマーキングツールにとって重要な透明性の維持に役立ちます。
さらに、BEIRはゼロショット評価を重視しており、検索システムが明示的に訓練されていないタスクでどの程度うまく機能するかを測定し、その適応性に関する洞察を提供します。そのデータセットには、短いツイートから長い科学論文まで、多様なテキストタイプも含まれており、ウェブ全体で見られるコンテンツの範囲を模倣しています。
BEIRにより、研究者や開発者はIRアルゴリズムの長所と短所を特定し、アプローチを公平に比較し、より堅牢なベースラインとなる汎用的な検索技術を開発できます。その包括的な評価はIR技術の進歩を促し、さまざまなアプリケーションにおける検索体験を改善する可能性があります。
制限事項
パッセージ検索への重点
このベンチマークは、transformerベースのモデルの長さ制限のため、パッセージ検索に重点を置いています。BEIRのほとんどの文書は、transformer modelsの512トークン制限内に収まります。robust04データセットに格納されている文書のように、約700語のニュース記事を含む例外もあります。しかしBEIRには、数百ページのPDFのような非常に長い文書はありません。これは、将来のベンチマークを開発できる「盲点」です。
ベンチマークのより難しいバージョンの作成
密な検索モデルが改善されるにつれて、BEIR上での性能は大幅に向上しました。最近の結果では、語彙検索(BM25のようなもの)は、以前の結果ではほとんどのデータセットで優れていたのに対し、14データセット中2つでしか優れていないことが示されています。これは、BEIRがまだ挑戦的なベンチマークであるかどうかという疑問を提起します。コミュニティでは、モデルの限界を押し広げるために、より挑戦的な検索データセットを備えた「BEIR 2」が必要かどうかについて議論があります。
ドメイン外検索における密な検索モデル
BEIRは、ドメイン内タスクで非常に良好に機能した密な埋め込みモデル(最大18ポイントの向上)が、ドメイン外シナリオでは大きく苦戦することを示しました。たとえば、一部の密なモデルは、訓練に使用されたWikipediaデータセットでのみ良好に機能しましたが、BEIRの他の17すべてのデータセットでは語彙検索より劣っていました。これにより、密なモデルが未知のドメインで苦戦する理由に関する多くの研究が行われました。研究者は、一部のデータセットにおける高い訓練・テスト間の重複や未知語などの問題を発見しました。これらの洞察は、ドメイン外の単語を処理するより良い方法や、訓練セットとテストセットの明確な分離を備えたより堅牢なベンチマークを含む、モデル訓練技術の改善を促してきました。
BEIRから得られたこれらの結果は、IRの進歩、モデル、訓練、評価における革新を推進してきました。
BEIRの理由:
BEIRは、検索の評価方法におけるギャップを埋めます。標準化され、多様で挑戦的なテストセットを提供することで、研究者や開発者は現在の検索アルゴリズムの長所と短所を把握し、アプローチを公平かつ包括的に比較し、より汎用的で優れた検索技術を構築できます。またBEIRは、検索システムが現実世界の多様なアプリケーションでどのように機能するかを把握するのにも役立ちます。
ウェブ検索エンジンやテクノロジーのユーザーにとって、BEIRの結果は、すべてのアプリケーションやプラットフォームにわたって、より正確で汎用的かつ効率的な検索体験につながります。これは、ウェブ検索からデータベースクエリまで、日常的なアプリケーションにおける検索結果の改善を意味します。
BEIRはオープンソースプロジェクトであるため、世界中の研究者が貢献し、その恩恵を受けることができます。このオープン性により、研究者がBEIRを基盤として発展させ、改良していくことで、検索技術の向上が加速します。BEIRが改善されるにつれて、IR分野全体が恩恵を受け、最終的にはエンドユーザーがあらゆるアプリケーションでより優れた検索体験を得られるようになります。
Beirの背景
BEIR(Benchmarking IR)は、初の広範なゼロショット情報検索ベンチマークです。従来のベンチマークとは異なり、ゼロショット設定において、複数のドメインとタスクタイプにわたって現代的な情報検索を評価します。MultiReQAやKILTのような従来の研究は、範囲が限定されており、単一タスク、小規模コーパス、または特定ドメインに限られていました。
このベンチマークは、IR手法が進化している時期に登場しました。従来は、TF-IDFやBM25のような語彙ベースのアプローチが、主要なテキスト検索手法でした。近年では、これらの手法を改善または置き換えるために、Spladeのようなニューラルネットワークを使用することへの関心が高まっています。初期のニューラル技術は、文書拡張のためのdocT5queryや用語重み付けのためのDeepCTのように、語彙ベースの情報検索技術を強化するものでした。
その後、意味的な一致を捉え、語彙のギャップを埋めるために密検索モデルが開発されました。これらのモデルは、クエリと文書を共有された密ベクトル空間にマッピングします。その後、両者の強みを組み合わせるために、語彙ベースと密ベクトルを組み合わせたハイブリッドモデルが登場しました。
別の研究の流れでは、密検索器を訓練するための教師なしドメイン適応が探求されました。また、ColBERTのようなモデルは、検索のためにトークンレベルの文脈化された埋め込みを導入しました。
ニューラルネットワーク、特にBERTのクロスアテンション機構を使用するものによる再ランキングは、大きな性能向上を示しましたが、計算コストは高くなりました。
BEIRは、これら既存の検索システムや手法が、特にゼロショット設定において、異なるドメインやタスクにどの程度汎化するかを確認し、現代のIRシステムの適応性に関する理解のギャップを埋めようとしています。
Beirのソフトウェアとフレームワーク
BEIRは、pipでインストールできる使いやすいPythonフレームワークです。IRタスクにおけるモデル評価を容易にするよう設計されています。このソフトウェアには、実験を再現し、Sentence-Transformers、Transformers、Anserini、DPR、Elasticsearch、ColBERT、Universal Sentence Encoderなどのよく知られたリポジトリのモデルを評価するための包括的なラッパーが付属しています。この幅広い互換性により、BEIRは学術研究と産業応用の両方に役立ちます。
このフレームワークは、多くのIRベースの指標を提供します:Precision、Recall、Mean Average Precision(MAP)、Mean Reciprocal Rank(MRR)、任意のtop-kに対するNormalized Discounted Cumulative Gain(nDCG)。これにより、検索モデルを包括的に評価できます。
BEIRは柔軟であり、ユーザーは新しいデータセットで既存モデルを評価したり、ベンチマーク内のデータセットで新しいモデルを評価したりできます。異なる形式のデータセットという問題に対処するため、BEIRはコーパス、クエリ、関連性判定(qrels)の標準形式を導入しています。この標準化により、多くのデータセットにわたる評価プロセスが容易になり、研究者や開発者がさまざまなデータ検索タスクでモデルをテストしやすくなります。
BEIRで使用される評価指標
BEIRは、主要な評価指標としてNormalized Discounted Cumulative Gain(nDCG@10)を使用します。これは、ベンチマーク内の異なるモデルやデータセット間で比較可能な結果を得るために選ばれました。
nDCG@10の選択は、以下に基づいています。
実世界のアプリケーションはprecision重視にもrecall重視にもなり得るため、バランスの取れた指標が必要でした。
PrecisionやRecallのような一部の指標は、検索タスクで重要となる結果のランキングを考慮しません。
Mean Reciprocal Rank (MRR) や Mean Average Precision (MAP) のような他のランキング考慮型指標は、二値の関連性判定に限定されており、すべてのタスクに適しているわけではありません。
nDCG@10は、二値および段階的な関連性判定の両方を扱えるため、さまざまな種類の検索タスクにおいて汎用性があります。
BEIRチームは、nDCG@10はさまざまな検索タスクを広く評価するのに適した指標だと述べています。彼らは公式TREC評価ツールのPythonインターフェースを使用して、ベンチマーク内のすべてのデータセットについてこの指標を計算しています。
すべてのタスクで単一の指標を使用することで、BEIRは、二値または段階的な関連性判定のどちらを使用しているかに関係なく、異なる検索モデルや異なるデータセット間の比較を可能にします。
ニューラル検索手法の比較における主な発見
Beirの論文を見る(または著者の一人であるNils Reimersによるわかりやすく短い動画を見る)と、彼らはさまざまなニューラル検索手法とBM25(語彙検索)の比較に関するいくつかの発見を共有しています。
BEIRは、多くの最先端の検索アーキテクチャを評価しており、transformerベースのニューラル手法に焦点を当てています。このベンチマークでは、公開されている事前学習済みチェックポイントを使用し、モデルを5つのカテゴリ(lexical、sparse、dense、late-interaction、re-ranking)に分類しています。transformerネットワークの制約により、実験ではテキスト文書の最初の512 word piecesのみが使用されています。
BEIRの評価から得られた主な発見は次のとおりです。
研究者たちは、情報検索(IR)向けのdenseモデルについて包括的なベンチマークを行いました。従来、embeddingアプローチは、モデルをドメイン固有のデータで学習し、その同じドメイン内の検索に適用するin-domain IRに使用されていました。しかし研究者たちは、より興味深い課題であるout-of-domain IRを探究しました。これは、事前学習済みモデルを、特定のデータ向けに再学習することなく新しいドメインに適用するものです。これを評価するために、彼らはさまざまな検索タスクにまたがる多くのデータセットを収集しました。たとえば、tweet retrievalでは、ニュース記事を関連するツイートとマッチングすることがタスクでした。ArguAnaおよびTouche-2020データセットでは、タスクはargument retrievalであり、具体的には反論を見つけることでした。Feverデータセットは、特定の主張を支持するWikipedia記事を見つけるために使用されました。
彼らは、多くのdense retrievalモデルをベースラインの語彙検索モデル(BM25)と比較しました。Facebookのdense retrievalモデルは、学習に使用されたWikipediaでは良好に機能しましたが、他の17のデータセットではBM25と比べて性能が低い結果となりました。最良のdense embedding modelであるTAS-Bでさえ、18データセット中8つでしかBM25を上回りませんでした。したがって、denseモデルはout-of-domainタスクにおいて大きな課題を抱えています。つまり、dense embeddingモデルは未知のドメインに適用されると大きな困難に直面します。汎化能力を向上させるには、さらなる研究が必要です。
SPLADEのような一部のモデルは、未知のドメインでより良好に機能しました。しかし、多くの設定において、最も堅牢な検索手法はBM25にcross-encoderとT5 query modelを組み合わせたものであり、多くのドメインで安定した結果を示しました。denseモデルが進化するにつれて、最近のベンチマークでは、14データセット中2つで語彙検索が依然としてdenseモデルを上回ることが示されています。一部のモデルは、現在のBeir Benchmarkデータセットに過学習している可能性があります。より困難で多様なデータセットを備えたBeir Benchmark 2を作成する時期かもしれません。
Denseモデルは、クエリと文書をベクトル空間に射影し、最も近いベクトル一致を見つけることで文書を取得します。これはドメイン内ではうまく機能しますが、未知語やドメイン外では苦戦します。研究者たちはまた、多くのドメイン内データセットには、テストクエリが学習中に見られているという訓練・テストの重複があり、そのため人為的に高い性能が出ていることを発見しました。Denseモデルは、訓練中に見ていないドメインや単語にさらされると苦戦します。これにより、Denseモデルの訓練ドメインを超えた汎化性能を改善する研究がさらに進みました。
次に研究者たちは、訓練セットとテストセットを適切に分離し、より長い文書やより複雑な検索タスクを含む、より優れたベンチマークを用意することを提案しています。今後の研究は、特にドメイン外検索において、多くのドメインにわたって良好に機能できるモデルに焦点を当てるでしょう。
結論
BEIR(Benchmarking IR)は情報検索のためのツールです。最初の広範なゼロショット情報検索ベンチマークとして、多くのドメインとタスクにわたって検索技術を評価するためのギャップを埋めています。18のデータセットと9つのタスクを備えたBEIRは、特にドメイン外において、多くの情報検索手法とモデルに対する前例のない理解を提供します。
このベンチマークは、未知のドメインへの汎化におけるDense検索モデルとSparse検索モデルの課題を示し、それがさらなる研究とイノベーションにつながりました。BM25のような従来手法の強みを場合によって示し、またハイブリッドアプローチを示すことで、BEIRはsparse retrievalモデルとシステム能力について、よりバランスの取れた見方を促しました。
さらに、BEIRはオープンソースであり、標準化された指標を備えているため、研究コミュニティでの協力を促し、進歩を加速させました。モデルが改善するにつれて、より困難なバージョンのベンチマークを作成する議論は、BEIRがなお重要であり、情報検索が動的な分野であることを証明しています。
次に、BEIRから得られた知見は、より堅牢で柔軟かつ効率的な検索技術を推進するでしょう。これらは、専門的な学術データベースから日常的なWeb検索まで、多くのアプリケーションにわたって検索体験を改善します。この分野が前進するにつれ、BEIRは、情報検索システムの限界を押し広げるために包括的な実世界での評価が重要であることを示す証拠となっています。
参考文献
Reimers, N. (2022). BEIRによる情報検索の評価. Cohere. [YouTube動画]. https://www.youtube.com/watch?v=w6_5-hAsjBQ
Thakur, N., Reimers, N., Rücklé, A., Srivastava, A., & Gurevych, I. (2021). BEIR:情報検索モデルのゼロショット評価のための異種混合ベンチマーク. arXivプレプリント arXiv:2104.08663.