




WeaviateとRocksetの比較:ニーズに合ったベクターデータベースの選択
AIやデータ駆動型テクノロジーの進歩に伴い、アプリケーションに適したベクターデータベースを選択することがますます重要になってきている。WeaviateとRocksetは、この分野における2つの選択肢です。本記事では、これらのテクノロジーを比較し、プロジェクトのための十分な情報に基づいた意思決定を支援します。
ベクターデータベースとは?
WeaviateとRocksetを比較する前に、まずベクターデータベースの概念について説明しましょう。
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、高次元のベクトルを保存し、クエリするために特別に設計されたもので、非構造化データの数値表現である。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品属性などの複雑な情報を符号化する。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLM)の性能を向上させる技術であるRAG(Retrieval Augmented Generation) において重要な役割を果たす。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)、Weaviateなど。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Weaviateは専用のベクターデータベースであり、Rocksetは検索・分析データベースである。この記事では、両者のベクトル検索機能を比較する。
Weaviate概要とコアテクノロジー
Weaviateは、AIアプリケーション開発を簡素化するために設計されたオープンソースのベクトルデータベースです。ビルトインのベクトルおよびハイブリッド検索機能、機械学習モデルとの容易な統合、データプライバシーへの配慮を提供します。これらの機能は、様々なスキルレベルの開発者がAIアプリケーションをより効率的に作成、反復、拡張できるようにすることを目的としています。
Weaviateの強みの一つは、高速かつ正確な類似検索である。HNSW(Hierarchical Navigable Small World)インデックスを使用し、大規模データセットでのベクトル検索を可能にしている。Weaviateはまた、ベクトル検索と従来のフィルタを組み合わせることもサポートしており、意味的類似性と特定のデータ属性の両方を活用した強力なハイブリッドクエリを可能にしている。
Weaviateの主な特徴は以下の通り:
1.PQ 圧縮による効率的な保存と検索 2.BM25検索とベクトル検索の間を調整するアルファ・パラメータを持つハイブリッド検索。 3.エンベッディングとリランキング用のプラグインを内蔵しており、開発が容易。
Weaviateは、開発者がベクトル検索を試すためのエントリー・ポイントである。簡単なセットアップと十分に文書化されたAPIにより、開発者に優しいアプローチを提供する。GenAIエコシステムと深く統合されているため、小規模なプロジェクトや概念実証に適している。Weaviateの対象者は、AIアプリケーションを構築するソフトウェアエンジニア、大規模データセットを扱うデータエンジニア、機械学習モデルを展開するデータサイエンティストである。Weaviateは、セマンティック検索、推薦システム、コンテンツ分類、その他のAI機能を簡素化します。
Weaviate は水平方向に拡張できるように設計されており、クラスタ内の複数のノードにデータを分散することで、大規模なデータセットや高負荷のクエリを処理できる。マルチモーダルデータをサポートし、使用するベクトル化モジュールに応じて様々なデータタイプ(テキスト、画像、音声、動画)を扱うことができる。WeaviateはRESTful APIとGraphQL APIの両方を提供しており、開発者が柔軟にデータベースとやり取りできるようになっている。
しかし、大規模なプロダクション環境においては、いくつかの留意点がある:
1.エンタープライズグレードのセキュリティ機能の制限 2.数十億ベクトル・データセットに対するスケーラビリティの潜在的課題 3.新しくリリースされた階層型ストレージ・オプションには手動管理が必要 4.水平方向のスケールアップには、Weaviate のエンジニアのサポートが必要であり、自動的には行えない。
この最後の点は特に注目すべき点である。つまり、組織は事前に計画を立て、スケーリングオペレーションのための時間を割り当て、適切な準備なしにシステムの限界に近づかないようにする必要があるということだ。
ロックセット概要とコアテクノロジー
Rocksetは、ベクトル埋め込みを含む、構造化・非構造化データのリアルタイム検索・分析データベースです。リアルタイムにデータを取り込み、インデックスを作成し、クエリを実行することができるため、瞬時の洞察を必要とするアプリケーションに最適です。Rocksetは、ストリーミングとバルクの両方のデータ取り込みをサポートしており、高速イベントストリームと変更データキャプチャ(CDC)フィードを1~2秒で処理できます。
Rocksetの主な特徴の一つは、ミュータブルなRocksDB上に構築されたコンバージド・インデクシングです。これにより、ベクターとメタデータをインプレースで更新できるため、データが頻繁に変更されるシナリオでは非常に効率的です。Rocksetは最大40MBまでのドキュメントを扱うことができ、最大200,000までのベクトル次元をサポートしているので、幅広いベクトル埋め込みユースケースに適しています。
Rocksetはコアにベクトル検索を内蔵しています。KNN (K-Nearest Neighbors) と ANN (Approximate Nearest Neighbors) 検索をサポートし、スケーラビリティのために分散 FAISS インデックスを使用しています。Rocksetはアルゴリズムにとらわれないので、独自の検索実装を選択することができます。コストベースのオプティマイザは、最適なパフォーマンスを得るためにKNNとANNの検索方法を動的に選択することができます。
ベクトル検索用のRocksetのユニークな点は、検索、ANN、列インデックス、行インデックスを1つにまとめたコンバージド・インデックスです。つまり、様々なクエリーパターンをすぐに扱うことができるのです。Rocksetはメタデータフィルタリングとハイブリッド検索もサポートしている。オプティマイザが最も効率的なクエリパスを選択します。複数のANNフィールドを横断して検索することができ、マルチモーダルモデルをサポートし、クエリーインターフェイスにはSQLとREST APIの両方が用意されている。
主な違い
ベクトル検索ツールとしてWeaviateとRocksetのどちらかを選ぶ際には、その違いを知っておく必要がある。どちらもパワフルですが、得意とする分野は異なります。いくつかの重要な側面から比較してみましょう。
検索方法
Weaviateは、HNSW(Hierarchical Navigable Small World)インデックスを使用してベクトル検索を行う。また、ベクトル類似度と従来のフィルタを組み合わせたハイブリッド検索もサポートしています。
Rocksetは、KNN(K-Nearest Neighbors)とANN(Approximate Nearest Neighbors)検索を提供します。スケーラビリティのために分散FAISSインデックスを使用しており、KNNとANNを動的に選択して最高のパフォーマンスを得ることができる。
データ
Weaviateはマルチモーダルデータを扱い、テキスト、画像、音声、動画など様々なタイプをサポートする。大規模なデータセットを扱うように設計されています。
Rocksetはリアルタイムデータ処理に優れている。構造化・非構造化データ(ベクトル埋め込みを含む)を数秒で取り込み、インデックスを付けることができる。Rocksetは、高速イベントストリームや変更データキャプチャフィードを1-2秒で処理できます。
スケーラビリティとパフォーマンス
Weaviateは、クラスタ内の複数のノードにデータを分散させることで、水平方向に拡張することができる。しかし、数十億ベクトルを超えるスケーリングにはWeaviateのエンジニアの助けが必要です。
Rocksetは、検索、ANN、列インデックス、行インデックスを組み合わせたコンバージド・インデックスを備えている。これにより、多くのクエリーパターンに対応できる。Rocksetはリアルタイムの検索と分析のために構築されているため、一刻を争う洞察を必要とするアプリケーションに適している。
柔軟性とカスタマイズ
Weaviateには、エンベッディングとリランキング用のプラグインが組み込まれており、開発を簡素化することができる。RESTful APIとGraphQL APIの両方が用意されているため、開発者はデータベースとのやり取りを柔軟に行うことができる。
Rocksetはアルゴリズムにとらわれないので、ユーザーは独自の検索実装を選択できる。メタデータのフィルタリングや、最適なクエリパスを選択するオプティマイザによるハイブリッド検索をサポートしている。
統合とエコシステム
WeaviateはGenAIのエコシステムと深く統合されているため、AIアプリケーション、セマンティック検索、推薦システム、コンテンツ分類に適している。
Rocksetは、ストリーミングとバルクの両方のデータ取り込みをサポートしているので、多くのデータソースに適している。クエリ用のSQLとREST APIを備えており、既存システムとの統合が容易だ。
使いやすさ
Weaviateは、シンプルなセットアップとよく文書化されたAPIで開発者に優しいことで知られている。そのため、初めてベクトル検索を利用する人にとっては、良いエントリーポイントになるだろう。
Rocksetの使いやすさは、多くのデータ型とクエリーパターンをすぐに扱えることにある。コストベースのオプティマイザが自動的に最適な検索方法を選択するので、手動でチューニングする必要はないかもしれない。
コスト
価格に関する情報は提供されていないが、Weaviate の水平スケーリングには、エンジニアによる手動管理とヘルプが必要である。このため、大規模なデプロイでは運用コストがかさむ可能性がある。
価格情報は提供されていないが、リアルタイム処理が必要なアプリケーションには価値があるかもしれない。
セキュリティ機能
Weaviate は、エンタープライズグレードのセキュリティ機能に制限があるため、組織によっては適さない場合がある。
それぞれを選択するタイミング
Weaviateは、AIファーストのプロジェクト、特にセマンティック検索、推薦システム、コンテンツ分類に適しています。大規模でマルチモーダルなデータセット(テキスト、画像、音声、動画)を扱い、ベクトル検索を必要とするプロジェクト向け。Weaviateは開発者に優しく、GenAIエコシステムと深く統合されているため、AIをゼロから構築するチームや、既存のシステムにベクター検索を追加するチームに最適です。
Rocksetは、リアルタイムのデータ処理と分析が必要なユースケース向けだ。ゼロレイテンシーでデータをインジェストし、インデックスを作成し、クエリを実行する必要がある場合に最適です。秒単位の洞察が必要なアプリケーション向け。Rocksetは、高速なイベントストリーム、頻繁なデータ更新、またはベクトル検索と複雑なSQLクエリを組み合わせる必要がある場合に適しています。Rocksetは、構造化データと非構造化データの両方に対応し、リアルタイム処理が可能なため、即座に実用的な洞察を必要とする最新のデータ集約型アプリケーションに最適です。
結論
Weaviateは、AIを中心としたアプローチ、スケーラビリティに優れたベクトル検索、マルチモーダルデータのサポートに適している。シンプルでエコシステムが統合されているため、AIアプリケーションの開発に適している。Rocksetはリアルタイムのデータ処理と分析用で、高速なデータストリームや複雑なクエリーパターンに対応できる。AIアプリケーションやベクトル検索を構築するのであればWeaviateを、リアルタイム処理や分析を優先するのであればRocksetを選択しよう。最終的には、データ量、更新頻度、クエリの複雑さ、ベクトル検索と従来型検索のバランスを考慮し、プロジェクトのニーズに合わせて選択する必要がある。
本記事ではWeaviateとRocksetの概要を紹介したが、これらのデータベースを評価する際には、それぞれのユースケースを考慮することが重要である。このプロセスを支援するツールの一つが、ベクターデータベースのパフォーマンスを比較するために設計されたオープンソースのベンチマークツールであるVectorDBBenchである。最終的には、特定のデータセットとクエリーパターンによる徹底的なベンチマークが、分散データベースシステムにおけるベクトル検索に対する、強力でありながら異なる2つのアプローチのどちらを選ぶかについて、十分な情報を得た上で決断を下すために不可欠となる。
オープンソースのVectorDBBenchを使って、ベクターデータベースを自分で評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのために設計されたオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)などの異なるベクトルデータベースシステムの性能を、自身のデータセットを用いてテスト・比較し、ユースケースに最も適したものを決定することができます。VectorDBBenchを使用することで、ユーザーはマーケティング上の主張や逸話的証拠に頼るのではなく、実際のベクトルデータベースのパフォーマンスに基づいて情報に基づいた決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースの性能を簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: Open-Source Vector Database Benchmark Tool](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
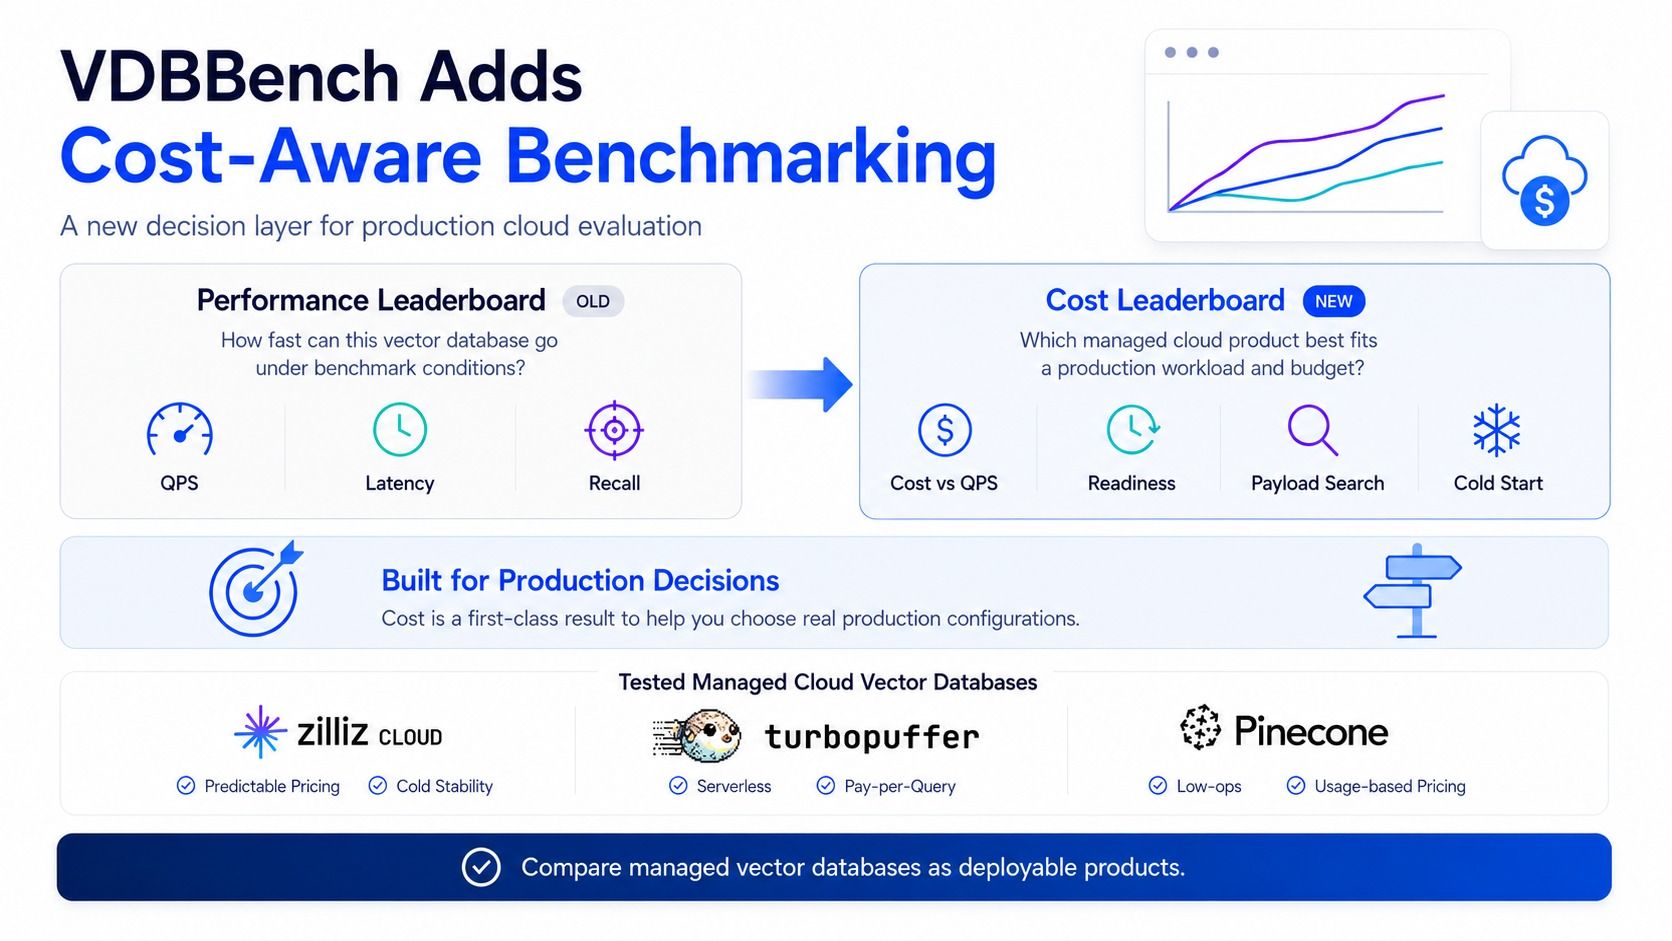
VDBBench Adds Cost-Aware Benchmarking for Vector Databases
Compare Zilliz Cloud, Pinecone, and turbopuffer with VDBBench cost-aware vector database benchmarks across latency, freshness, multitenancy, and cold starts.
What Exactly Are AI Agents? Why OpenAI and LangChain Are Fighting Over Their Definition?
AI agents are software programs powered by AI that can perceive their environment, make decisions, and take actions to achieve a goal—often autonomously.
Demystifying the Milvus Sizing Tool
Explore how to use the Sizing Tool to select the optimal configuration for your Milvus deployment.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.