




Vespa vs Rockset AIアプリに適したベクターデータベースの選択
ベクターデータベースとは?
VespaとRocksetを比較する前に、まずベクターデータベースの概念について調べてみましょう;
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするように設計されています。ベクトルは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品の属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLM)の性能を向上させる技術であるRAG(Retrieval Augmented Generation)でも重要な役割を果たしている。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Vespaは専用のベクターデータベースである。Rocksetは、アドオンとしてベクトル検索機能を持つ検索・分析データベースである。この記事では、両者のベクトル検索機能を比較する。
Vespa概要とコアテクノロジー
Vespaは強力な検索エンジンとベクトルデータベースで、複数の種類の検索を一度に扱うことができます。ベクター検索、テキスト検索、構造化データによる検索に優れています。つまり、類似したアイテム(画像や商品など)を検索したり、テキスト内の特定の単語を検索したり、日付や数字に基づいて検索結果をフィルタリングしたりすることができます。Vespaは柔軟性があり、単純な数値から複雑な構造まで、さまざまな種類のデータを扱うことができます。
Vespaの際立った特徴のひとつは、ベクトル検索ができることです。ドキュメントにいくつでもベクトルフィールドを追加することができ、Vespaはそれらを素早く検索します。Vespaはテンソルと呼ばれる特殊なベクトルも扱うことができ、マルチパートのドキュメント埋め込みなどを表現するのに便利です。Vespaはこれらのベクトルをどのように保存し検索するかについてスマートなので、速度を落とすことなく本当に大量のデータを扱うことができます。
Vespaは超高速かつ効率的に構築されています。メモリを管理し、検索を行うためにC++で書かれた独自の特別なエンジンを使用しているため、複雑なクエリや大量のデータを扱ってもうまく動作します。新しいデータを追加したり、たくさんの検索を同時に処理したりしても、スムーズに動作し続けるように設計されています。そのため、多くのトラフィックやデータを処理する必要がある、大規模で現実的なアプリケーションに最適です。
Vespaのもう一つの優れた点は、より多くのデータやトラフィックを処理するために自動的にスケールアップできることです。Vespaのセットアップにコンピュータを追加すれば、自動的にそのコンピュータに作業を分散させることができる。これは、複雑なセットアップをすることなく、ニーズの成長に合わせて検索システムを成長させることができることを意味します。Vespaは、データ量やトラフィックの変化に対応するために自動的に調整することもでき、コスト削減に役立ちます。そのため、時間とともに成長する検索システムを必要とするビジネスには最適です。
##ロックセット概要とコアテクノロジー
Rocksetは、ベクトル埋め込みを含む、構造化・非構造化データのリアルタイム検索・分析データベースです。リアルタイムにデータを取り込み、インデックスを作成し、クエリを実行することができるため、瞬時の洞察を必要とするアプリケーションに最適です。Rocksetは、ストリーミングとバルクの両方のデータ取り込みをサポートしており、高速イベントストリームと変更データキャプチャ(CDC)フィードを1~2秒で処理できます。
Rocksetの主な特徴の一つは、ミュータブルなRocksDB上に構築されたコンバージド・インデクシングです。これにより、ベクターとメタデータをインプレースで更新できるため、データが頻繁に変更されるシナリオでは非常に効率的です。Rocksetは最大40MBまでのドキュメントを扱うことができ、最大200,000までのベクトル次元をサポートしているので、幅広いベクトル埋め込みユースケースに適しています。
Rocksetはコアにベクトル検索を内蔵しています。KNN (K-Nearest Neighbors) と ANN (Approximate Nearest Neighbors) 検索をサポートし、スケーラビリティのために分散 FAISS インデックスを使用しています。Rocksetはアルゴリズムにとらわれないので、独自の検索実装を選択することができます。コストベースのオプティマイザは、最適なパフォーマンスを得るためにKNNとANNの検索方法を動的に選択することができます。
ベクトル検索用のRocksetのユニークな点は、検索、ANN、列インデックス、行インデックスを1つにまとめたコンバージド・インデックスです。つまり、様々なクエリーパターンをすぐに扱うことができるのです。Rocksetはメタデータフィルタリングとハイブリッド検索もサポートしている。オプティマイザが最も効率的なクエリパスを選択します。複数のANNフィールドを横断して検索することができ、マルチモーダルモデルをサポートし、クエリーインターフェイスにはSQLとREST APIの両方が用意されている。
主な違い
ベクトル検索のためにVespaとRocksetのどちらかを選択する場合、それぞれが検索とデータ管理の異なる側面をどのように扱っているかを理解する必要がある。主要な部分で比較してみましょう。
検索とパフォーマンス
VespaはC++ベースの検索エンジンを持ち、ベクトル検索、テキスト検索、構造化データ検索を1つのクエリで行うことができる。これは、異なる検索タイプを混在させた複雑なクエリを、パフォーマンスの低下なしに実行できることを意味します。特にベクトル検索では、Vespaはドキュメントごとに複数のベクトルフィールドと高次元テンソルをサポートしています。
RocksetはRocksDB上に構築されたConverged Indexingシステムで異なるアプローチを取っている。これはK-最近傍(KNN)と近似最近傍(ANN)検索法をサポートし、スケーリング用に分散FAISSインデックスを備えている。Rocksetのベクトル検索は最大20万次元をサポートし、クエリに基づいてKNNとANNを選択するオプティマイザを備えている。
データ管理と更新
Vespaはリアルタイムでデータの更新を行います。そのアーキテクチャーにより、検索パフォーマンスを維持したまま継続的な更新が可能です。インデックスを再構築することなく、ベクトル埋め込みとメタデータの両方を更新できます。
Rocksetは1-2秒のインジェストレイテンシでリアルタイムのデータ処理のために構築されている。ミュータブルなRocksDBを基盤としているため、ベクターやメタデータを素早く更新することができます。システムは最大40MBまでのドキュメントを扱うことができるので、様々なデータタイプに適している。
スケーリングとアーキテクチャ
Vespaは自動シャーディングとレプリケーションを使ってノード間でデータを分散します。クラスタにノードを追加すると、Vespaがデータのリバランスを行います。この水平スケーリングにより、データが大きくなってもパフォーマンスが維持されます。
Rocksetの分散アーキテクチャは、クラスタ全体に計算を分散します。Converged Indexは複数のインデックスタイプ(search、ANN、columnar、row)を1つのシステムに統合しているため、様々なパターンのクエリーを行うことができます。
統合とAPI
VespaにはRESTとカスタムAPIの両方があります。一般的なプログラミング言語用のクライアントライブラリがあり、拡張性のためのカスタムプラグインをサポートしています。
RocksetにはSQLとREST APIがあり、SQLに精通したチームがアクセスできる。ストリーミング・データ・ソースとうまく統合でき、変更データ・キャプチャ(CDC)フィードをサポートしている。
##それぞれを選択するタイミング
ベクター、テキスト、構造化データを大規模に検索する必要がある場合は、Vespaを選択してください。リアルタイムの提供、複雑なクエリの組み合わせ、ランキングと関連性の正確な制御を必要とするプロダクションシステム向けです。Vespaは、レコメンデーションシステム、製品検索、コンテンツディスカバリー、AIアプリケーションなど、従来の検索とベクトル類似性を融合させる必要があるユースケースに最適です。セルフホスト型は、インフラを完全にコントロールする必要があり、それを管理する技術的な専門知識を持っている企業に最適です。
Rocksetは、リアルタイムのデータ処理とベクトル検索が必要で、運用のオーバーヘッドがゼロの場合に適しています。高速なデータ取り込み、ベクターやメタデータの頻繁な更新、SQLベースのクエリーを必要とするアプリケーションに最適です。Rocksetは、リアルタイム分析、イベント駆動型アプリケーション、ベクトル検索とライブデータストリームを組み合わせる必要があるシナリオに最適です。マネージドサービスは、インフラを管理するのではなく、アプリケーションを構築したいチームに最適です。
要約
VespaとRocksetはどちらも強力なベクトル検索を持っているが、得意とする分野は異なる。Vespaは、統一された検索、多くのカスタマイズ、複雑なマルチモーダルなクエリーを大規模に行うことができる。Rocksetは、リアルタイムデータ処理、SQL、運用のオーバーヘッドを減らすマネージドサービスに優れている。この2つのどちらを選ぶかは、データの鮮度、クエリの複雑さ、運用リソース、スケーリング・ニーズなどの要件に合わせる必要がある。チームの専門知識、既存のインフラ、予算、長期的なメンテナンスなどを考慮して決定してください。
VespaとRocksetの概要についてはこちらをお読みいただきたいが、これらを評価するには、ユースケースに基づいて評価する必要がある。それに役立つツールのひとつが、ベクターデータベースの比較のためのオープンソースのベンチマークツールであるVectorDBBenchです。最終的には、独自のデータセットとクエリパターンを使って徹底的にベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力だが異なるこの2つのアプローチのどちらを選ぶかを決める鍵となるだろう。
オープンソースのVectorDBBenchを使ってベクトルデータベースを評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのためのオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)のような異なるベクトルデータベースシステムを独自のデータセットを使ってテストし比較し、自分のユースケースに合うものを見つけることができます。VectorDBBenchを使えば、ユーザーはマーケティング上の主張や伝聞ではなく、実際のベクターデータベースのパフォーマンスに基づいて決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースの性能を簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: Open-Source Vector Database Benchmark Tool](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
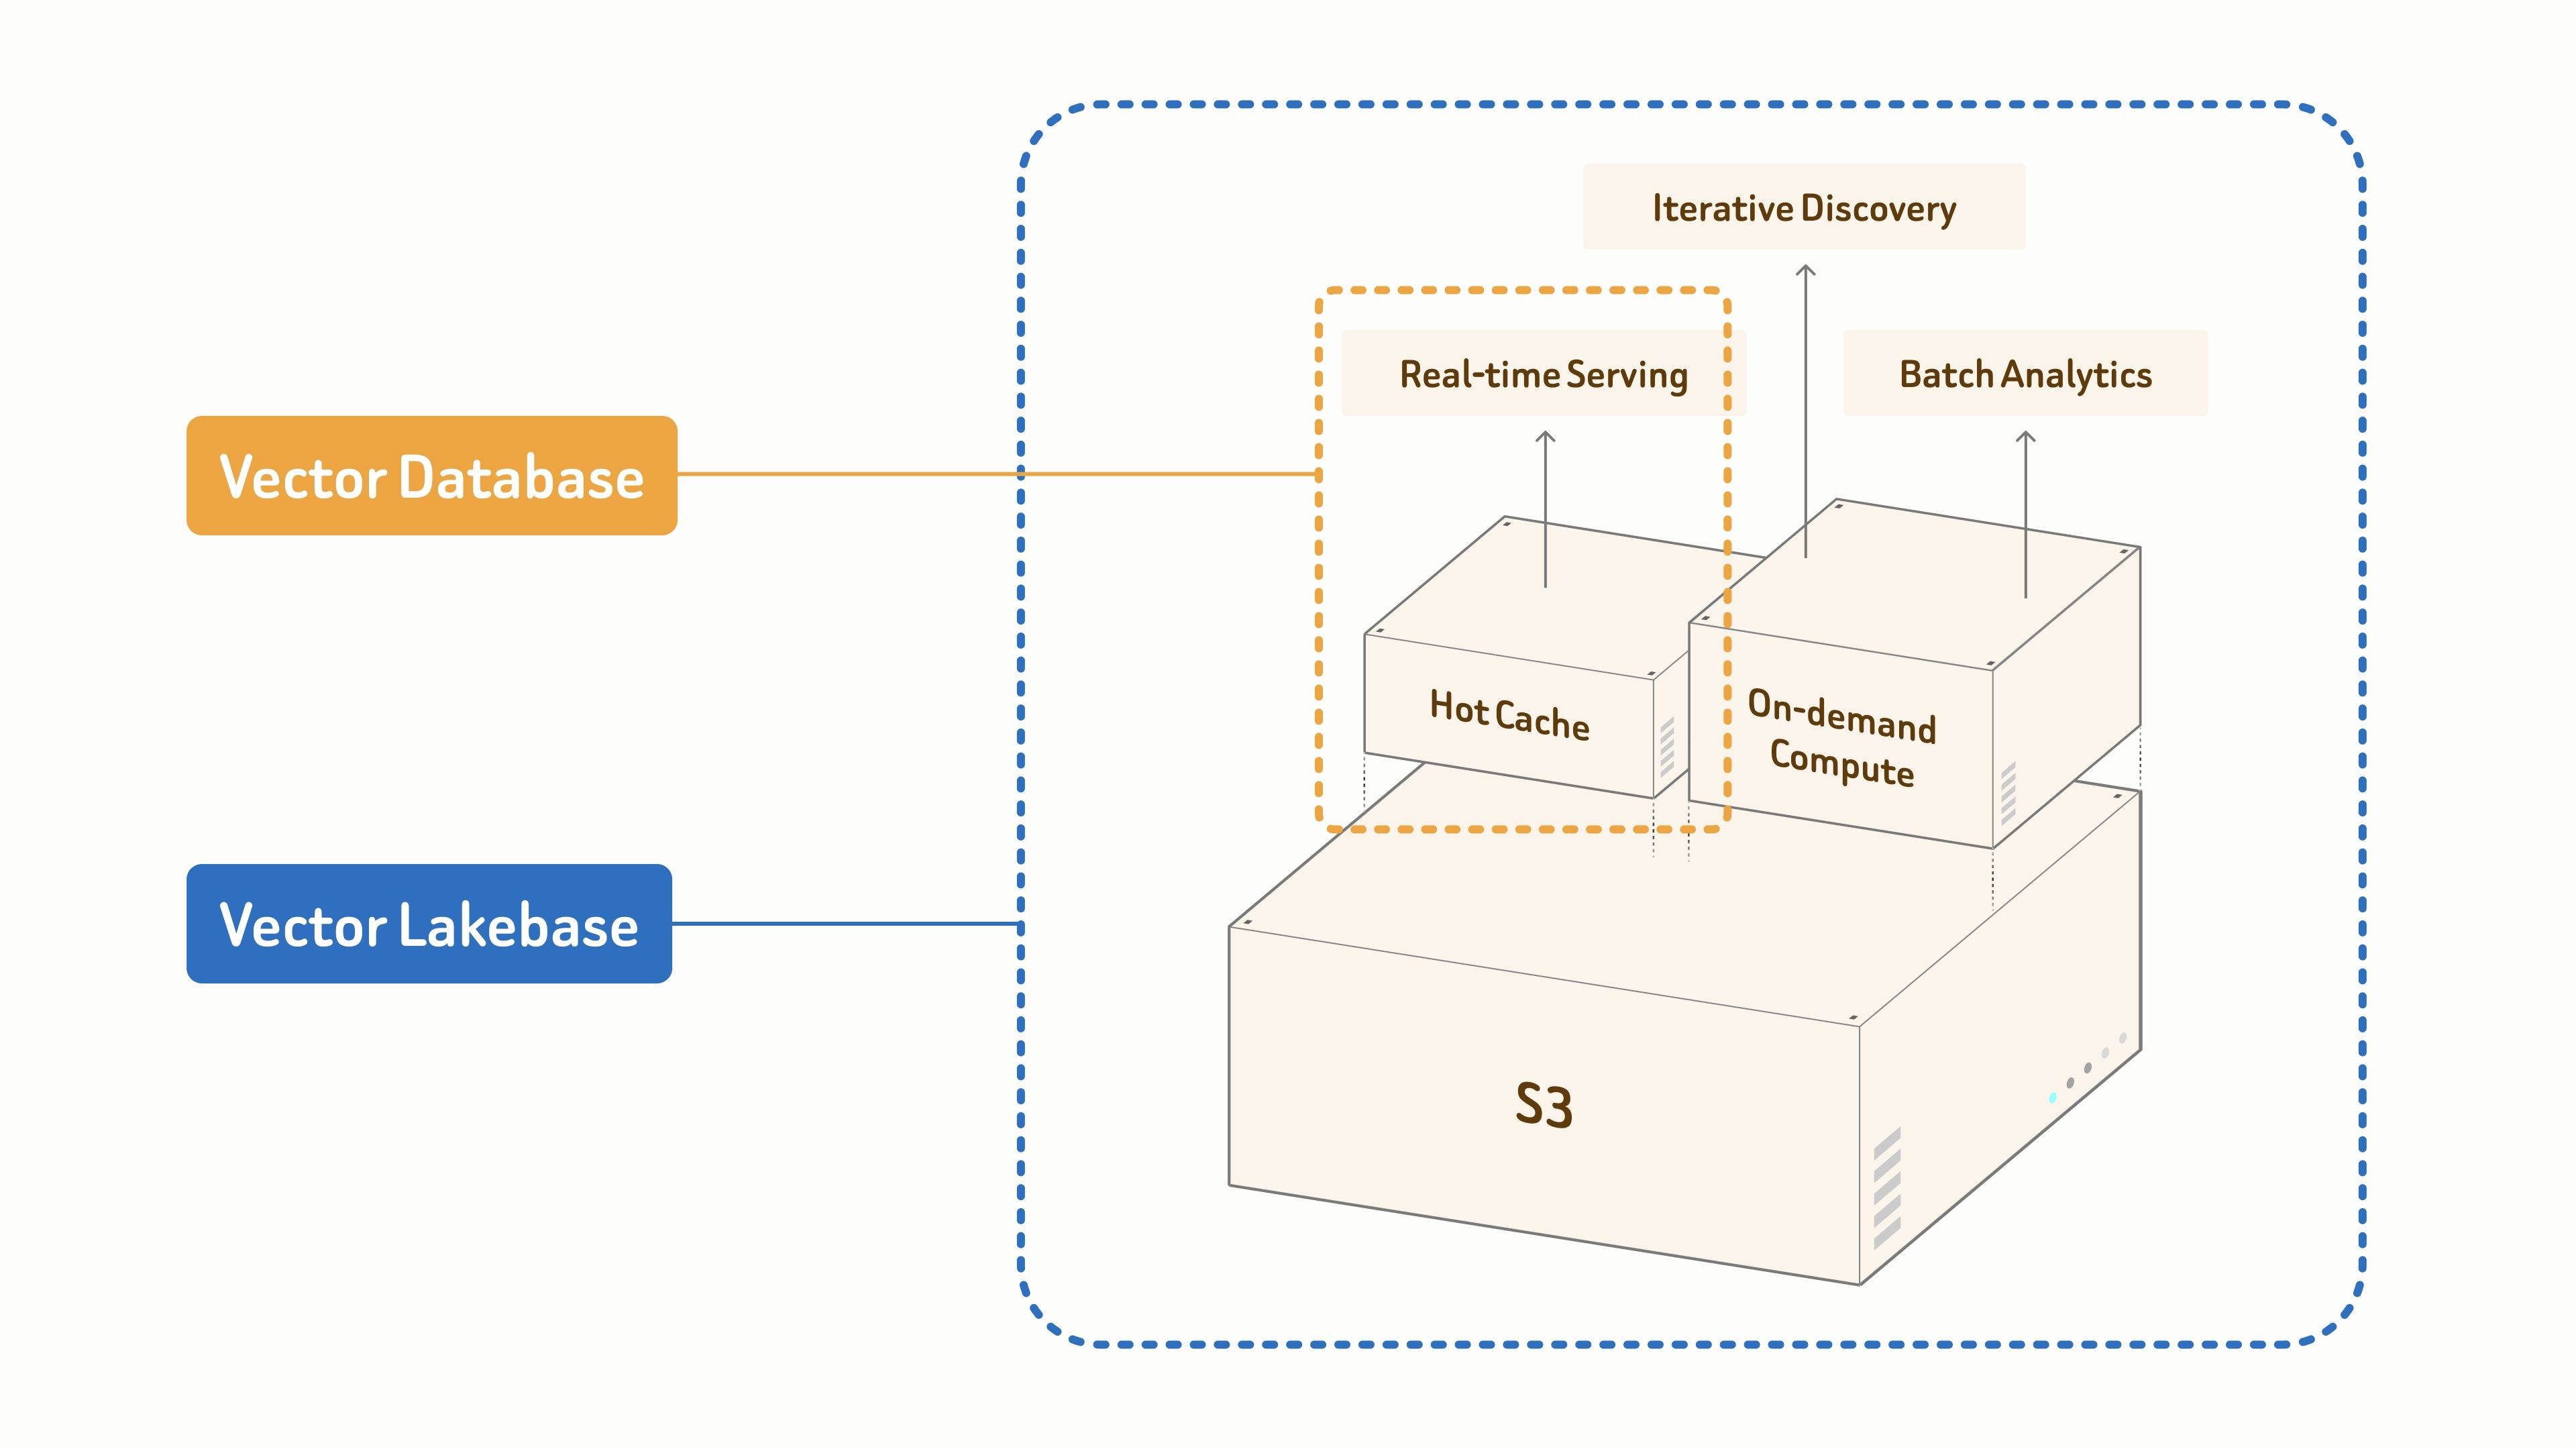
From Vector Database to Vector Lakebase
Zilliz offers a fully managed Vector Lakebase powered by Milvus, unifying real-time vector search, lake-scale discovery, and Al data operations.
My Wife Wanted Dior. I Spent $600 on Claude Code to Vibe-Code a 2M-Line Database Instead.
Write tests, not code reviews. How a test-first workflow with 6 parallel Claude Code sessions turns a 2M-line C++ codebase into a daily shipping pipeline.
Zilliz Cloud BYOC Upgrades: Bring Enterprise-Grade Security, Networking Isolation, and More
Discover how Zilliz Cloud BYOC brings enterprise-grade security, networking isolation, and infrastructure automation to vector database deployments in AWS
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.