




RedisとVearchの比較:ニーズに合ったベクターデータベースの選択
AIやデータドリブン・テクノロジーの進歩に伴い、アプリケーションに適切なベクター・データベースを選択することがますます重要になってきている。RedisとVearchは、この分野における2つの選択肢です。この記事では、プロジェクトのために十分な情報を得た上で決断するのに役立つ、これらのテクノロジーを比較します。
ベクターデータベースとは?
RedisとVearchを比較する前に、まずベクターデータベースの概念について調べてみましょう。
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするように設計されています。ベクトルは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品の属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLMs)の性能を向上させる技術であるRAG(Retrieval Augmented Generation) において重要な役割を果たす。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)、Weaviateなど。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Redisは、ベクトル検索機能を追加したインメモリデータベースである。Vearchは、専用のベクトルデータベースである。この投稿では、両者のベクトル検索機能を比較する。 ;
Redis:概要とコアテクノロジー
Redisはもともとインメモリ・データ・ストレージとして知られていたが、現在はRedis Stackの一部であるRedis Vector Libraryを通じてベクトル検索機能を追加した。これにより、Redisはスピードとパフォーマンスを維持したまま、ベクトルの類似検索を行うことができるようになりました。
Redisのベクトル検索は既存のインフラストラクチャの上に構築されており、高速なクエリ実行のためにインメモリ処理を使用している。Redisは近似最近傍検索にFLATとHNSW(Hierarchical Navigable Small World)アルゴリズムを使用し、高次元のベクトル空間での高速かつ正確な検索を可能にしています。
Redisのベクトル検索の主な強みの1つは、ベクトルの類似性検索と他の属性に関する従来のフィルタリングを組み合わせることができる点です。このハイブリッド検索により、開発者は意味的類似性と特定のメタデータ基準の両方を考慮した複雑なクエリを作成することができるため、多くのAI駆動型アプリケーションで汎用性があります。
Redis Vector Libraryは、開発者がRedisでベクトルデータを扱うためのシンプルなインターフェースを提供します。柔軟なスキーマ設計、カスタムベクタークエリ、セマンティックキャッシングやセッション管理などのLLM関連タスクの拡張機能などを備えている。これにより、AI/MLエンジニアやデータサイエンティストは、特にリアルタイムのデータ処理と検索のために、RedisをAIワークフローに統合することが容易になります。
Vearch概要とコアテクノロジー
Vearchは、高速で効率的な類似検索を必要とするAIアプリケーションの開発者のために設計された強力なツールです。スーパーチャージされたデータベースのようなものだが、通常のデータを保存するのではなく、最新のAI技術の多くを支えるトリッキーなベクトル埋め込みを扱うように構築されている。
Vearchの最もクールな点は、そのハイブリッド検索機能だ。ベクトルを使った検索(似たような画像やテキストを見つけることを想像してほしい)だけでなく、数値やテキストのような通常のデータに基づいて結果をフィルタリングすることもできる。つまり、"これに似た商品を探す。ただし、電子機器カテゴリーで500ドル以下 "というような複雑な検索ができるのだ。検索速度も速く、数百万点の商品をわずか数ミリ秒で検索できる。
Vearchは、ニーズに応じて成長するように作られている。クラスタ・セットアップを使用しており、コンピュータのチームが一緒に働くようなものです。異なるタイプのノード(マスター、ルーター、パーティション・サーバー)があり、メタデータの管理からデータの保存や計算まで、異なるジョブを処理する。このセットアップにより、Vearchは簡単にスケールアウトでき、データが増大しても信頼性を保つことができる。より多くのデータやトラフィックを処理するために、汗をかくことなくマシンを追加することができます。
開発者にとっては、Vearchは生活をより簡単にするいくつかの優れた機能を提供している。リアルタイムでインデックスにデータを追加できるので、検索結果は常に最新の状態に保たれます。1つのドキュメントで複数のベクトル・フィールドをサポートしているので、複雑なデータにも便利だ。また、Python SDKも用意されており、迅速な開発とテストが可能です。さらに、Vearchはインデックス作成方法(IVFPQやHNSWなど)に柔軟に対応し、CPU版とGPU版の両方をサポートしているため、特定のハードウェアやユースケースに合わせて最適化することができます。レコメンデーションシステムや類似画像検索、あるいは高速な類似マッチングを必要とするAIアプリの構築など、Vearchはそれを効率的に実現するツールを提供します。
##主な違い
ベクトル検索のためにRedisとVearchのどちらかを選択する際は、以下の点を考慮してください:
検索方法:
Redisは近似最近傍検索にFLATとHNSW(Hierarchical Navigable Small World)を使う。Vearchは複数のインデックス方式(IVFPQとHNSW)をサポートし、検索用にCPU版とGPU版がある。
データ
Redisはベクトル類似度検索と他の属性でのフィルタリングを組み合わせているので、ハイブリッドなクエリができる。Vearchもハイブリッド検索が可能で、1つのシステムでベクトル埋め込みと通常のデータ型を扱うことができる。
スケーラビリティとパフォーマンス:
Redisは高速なクエリ実行のためにインメモリ処理を使用し、既存のインフラストラクチャの上にベクトル検索を構築する。Vearchは、異なるノードタイプ(マスター、ルーター、パーティションサーバー)を持つクラスタセットアップを使用して、タスクを分散し、水平方向に拡張します。
柔軟性とカスタマイズ:
Redis Vector Libraryは柔軟なスキーマ設計とカスタムベクタークエリーを備えています。Vearchは、1つのドキュメントで複数のベクトルフィールドをサポートし、特定のユースケースに最適化するための様々なインデックス作成方法をサポートしています。
統合とエコシステム:
RedisはAIワークフローとうまく統合し、セマンティックキャッシングとセッション管理を備えています。Vearchには、迅速な開発とテストのためのPython SDKがあり、様々なAIアプリケーションに適している。
使いやすさ:
Redis Vector Libraryは、開発者がベクトルデータを扱うためのシンプルなインターフェースを提供しようとしている。Vearchはリアルタイムのインデックスを持ち、ベクトルの類似性とメタデータのフィルタリングを組み合わせた複雑なクエリーをサポートする。
コスト:
Redisはオープンソースで、有料のエンタープライズ・オプションがある。Vearchもオープンソース。
セキュリティ
Redisには様々なセキュリティ機能(暗号化やアクセス制御)があり、特にエンタープライズ版ではその機能が充実している。Vearchのドキュメントではセキュリティについてあまり触れられていないので、具体的なセキュリティ機能については詳しく調べる必要がある。
各技術を選択するタイミングについて
Redisは、従来のデータ操作に加え、超高速リアルタイムベクトル検索を必要とするアプリケーションに最適です。レコメンデーションシステム、リアルタイムの不正検知、ライブ環境でのコンテンツマッチングなど、低レイテンシーが鍵となるシナリオに優れています。Redisは、すでに他の目的でRedisを使用しており、新しいデータベースを導入することなくベクトル検索を追加したいプロジェクトに最適です。ハイブリッド検索は、パーソナライズされたeコマース商品のレコメンデーションやコンテキストを意識したチャットボットのように、意味的類似性と属性フィルタリングを組み合わせる必要があるアプリケーションに最適です。
Vearchは、膨大なデータに対して複雑な類似性検索を必要とする大規模AIアプリケーションに最適です。画像認識システム、自然言語処理タスク、数百万のアイテムを扱う推薦エンジンなどに最適です。Vearchの分散アーキテクチャは、急速な成長が見込まれ、水平方向に拡張できるシステムを必要とするプロジェクトに最適です。CPU版とGPU版の両方をサポートしているため、ハードウェアの最適化に柔軟性があり、計算リソースが多様な組織や、ベクトル検索にGPUアクセラレーションを使用したい組織に適しています。
結論
Redisは、インメモリ処理、既存のRedisセットアップとのシームレスな統合、ベクトル類似性と従来のデータフィルタリングを組み合わせたハイブリッド検索に最適である。Vearchは、スケーラビリティ、大量データ用の分散アーキテクチャ、パフォーマンス最適化のためのGPUサポートを備えた複雑なAI駆動型検索に最適である。RedisとVearchのどちらを選ぶかは、ユースケース、データ量、パフォーマンス要件、既存のインフラストラクチャに基づいてください。リアルタイム処理が必要で、すでにスタックでRedisを使用している場合、または高速なハイブリッドクエリが必要な中規模データの場合は、Redisを選択してください。大規模なAIアプリケーションを構築する場合、堅牢なスケーラビリティが必要な場合、GPUアクセラレーションでパフォーマンスを最適化したい場合はVearchを選択する。どちらも強力なベクトル検索を備えているが、それぞれの強みは異なるタイプのプロジェクトや組織に適合する。
この記事ではRedisとVearchの概要を説明したが、これらのデータベースを特定のユースケースに基づいて評価することが重要だ。このプロセスを支援するツールの1つが、ベクターデータベースのパフォーマンスを比較するために設計されたオープンソースのベンチマークツールであるVectorDBBenchだ。最終的には、特定のデータセットとクエリーパターンを使った徹底的なベンチマークが、分散データベースシステムにおけるベクトル検索に対する、強力でありながら異なるこの2つのアプローチの間で、十分な情報に基づいた決断を下すために不可欠となるだろう。
オープンソースのVectorDBBenchを使って、ベクターデータベースを自分で評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのために設計されたオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)などの異なるベクトルデータベースシステムの性能を、自身のデータセットを用いてテスト・比較し、ユースケースに最も適したものを決定することができます。VectorDBBenchを使用することで、ユーザーはマーケティング上の主張や逸話的証拠に頼るのではなく、実際のベクトルデータベースのパフォーマンスに基づいて情報に基づいた決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースの性能を簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: Open-Source Vector Database Benchmark Tool](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
AI Agents Are Quietly Transforming E-Commerce — Here’s How
Discover how AI agents transform e-commerce with autonomous decision-making, enhanced product discovery, and vector search capabilities for today's retailers.
Milvus/Zilliz + Surveillance: How Vector Databases Transform Multi-Camera Tracking
See how Milvus vector database enhances multi-camera tracking with similarity-based matching for better surveillance in retail, warehouses and transport hubs.
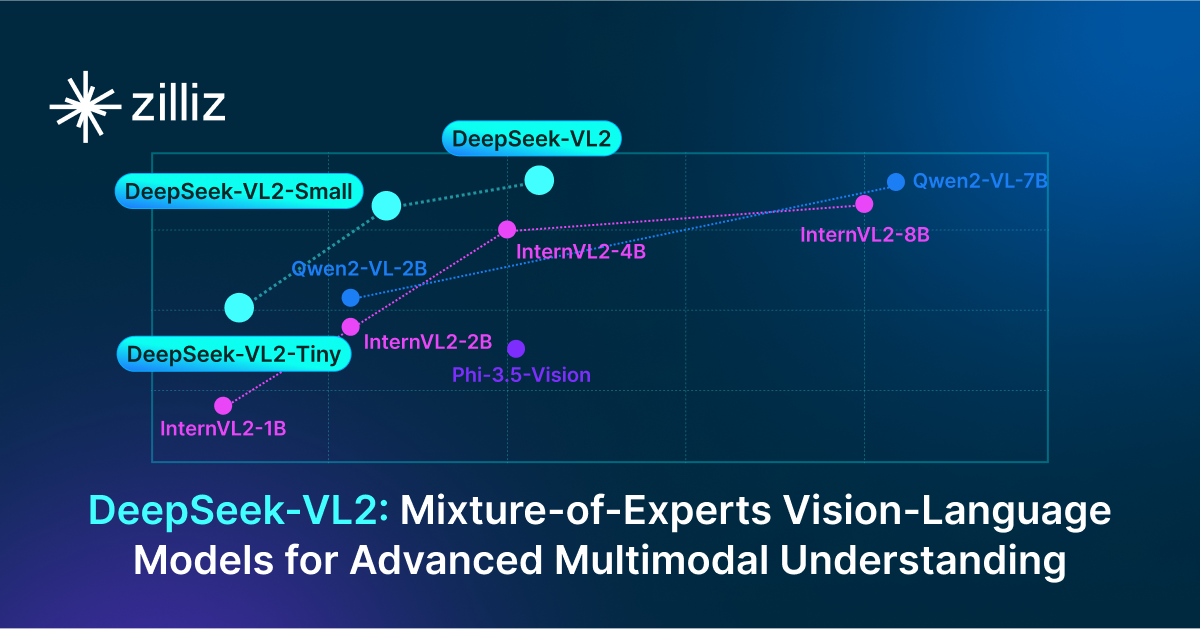
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.