




MongoDBとMyScaleの比較:GenAIアプリケーションに適したデータベースの選択
AI主導のアプリケーションが進化する中、これらの進化をサポートするベクトル検索機能の重要性はいくら強調してもしすぎることはない。このブログ記事では、ベクトル検索機能を持つ2つの著名なデータベースについて説明する:MongoDBとMyScaleである。MongoDBとMyScale**である。それぞれ、推薦エンジン、画像検索、セマンティック検索などのアプリケーションに必須の機能であるベクトル検索を扱うための堅牢な機能を提供している。私たちのゴールは、開発者やエンジニアに明確な比較を提供し、どのデータベースが彼らの特定の要件に最も合致しているかを判断する手助けをすることです。
ベクターデータベースとは?
MongoDBとMyScaleを比較する前に、まずベクターデータベースの概念について説明します;
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするように設計されています。ベクトルは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品の属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLMs)の性能を向上させる技術であるRAG(Retrieval Augmented Generation) において重要な役割を果たす。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
MongoDBは、ベクトル検索をアドオンとして持つNoSQLデータベースであり、MyScaleは、ベクトル検索とSQLアナリティクスを組み合わせたClickHouse上に構築されたデータベースである。この投稿では、それらのベクトル検索機能を比較する。 ;
MongoDB: 基礎編
MongoDB Atlas のベクトル検索は、MongoDB Atlas に保存されているデータをベクトルで類似検索する機能です。ドキュメントデータと一緒に高次元のベクトル埋め込みデータをインデックス化してクエリし、データベース内でAIや機械学習を行うことができます。
Atlas Vector Searchの中核は、HNSW(Hierarchical Navigable Small World)アルゴリズムを使ったベクトルデータのインデックス化と検索です。これによりベクトル空間の多階層グラフが作成され、近似最近傍(ANN)検索が可能になる。これは大規模なベクトル検索におけるスピードと精度のバランスです。Atlas Vector Search は、10,000 ドキュメントまでのクエリに対して、パフォーマンスよりも精度を優先する Exact Nearest Neighbors (ENN) 検索もサポートしています。
Atlas Vector Searchの大きな利点の一つは、MongoDBの柔軟なドキュメントモデルとの統合です。ベクトル埋め込みを他のドキュメントデータと一緒に保存できるので、より文脈に沿った正確な検索ができます。最大4096次元まで埋め込むことができ、どのようなデータでもクエリできます。アトラスベクター検索では、ベクトルの類似検索と従来の文書フィルタリングを組み合わせることができます。例えば、商品のセマンティック検索は、カテゴリー、価格帯、在庫状況でフィルタリングすることができます。
また、Atlas Vector Searchはハイブリッド検索にも対応しており、ベクトル検索とフルテキスト検索を組み合わせることで、より詳細な検索結果を得ることができます。これは、キーワードベースの検索に特化したAtlas Searchとは異なる。このプラットフォームは一般的なAIサービスやツールと統合されているため、OpenAIやVoyageAI、その他Hugging Faceに掲載されている多くのプロバイダーのモデルを埋め込んで使用することができる。また、大規模言語モデル(LLM)を使用するアプリケーションを構築するためのLangChainやLlamaIndexのようなオープンソースのフレームワークもサポートしています。
スケーラビリティとパフォーマンスを保証するために、MongoDBアトラスは、アトラスサーチとベクターサーチのワークロード専用のインフラを提供するサーチノードを提供しています。これにより、最適化されたコンピュートリソースと、検索ニーズの独立したスケーリングが可能になり、スケール時のパフォーマンスが向上します。
これらの機能をMongoDBエコシステム内に持つことで、Atlas Vector SearchはAIを活用したアプリケーション、レコメンデーションシステム、高度な検索機能を構築する開発者にとって完全なソリューションとなります。ベクターデータベースを別途用意する必要がなく、MongoDBのスケーラビリティと豊富な機能をベクター検索と共に利用することができます。
MyScaleとは?基礎編
MyScaleはオープンソースのClickHouseデータベース上に構築されたクラウドベースのデータベースで、AIや機械学習のワークロード向けに設計されている。構造化データ、ベクトルデータ、リアルタイム分析、機械学習を扱うことができる。MyScaleは時系列、ベクトル検索、全文検索に重点を置いているため、リアルタイム処理やAI主導の洞察に適している。ClickHouseアーキテクチャを使用することで、MyScaleはAI向けに高性能でスケーラブルです。
MyScaleの主な特徴の1つはネイティブSQLのサポートで、ベクトル検索、全文検索、従来のSQLクエリを1つのシステムに統合することで、AI主導のクエリを簡素化します。これにより、複数のツールの必要性を減らし、AI向けのスケーラビリティを実現している。MyScaleは、ベクトル化されたデータを操作するためのOLAPデータベース・アーキテクチャを使用して、1つのプラットフォーム上で構造化データとベクトル化データの両方の分析処理をサポートし、管理します。開発者はSQLを使用してMyScaleとやり取りできるため、リレーショナルデータベースに精通したすべてのプログラマーがアクセス可能です。
MyScaleには複数のベクトルインデックスタイプと類似度メトリクスがあり、様々なユースケースをサポートします。ユークリッド距離(L2)、内積(IP)、余弦類似度といった一般的な距離メトリクスをサポートしています。データベースには複数のインデックス作成アルゴリズムがあります:MSTG(マルチスケールツリーグラフ)、ScaNN、IVFFLAT、IVFPQ、IVFSQ、HNSWがあり、それぞれパラメータを調整することができます。MyScale独自のMSTGベクトルエンジンは、NVMe SSDを使用してデータ密度を高めているため、パフォーマンスとコストの両面で特殊なベクトルデータベースを凌駕します。
SQLデータベース、ベクトルデータベース、全文検索エンジンの機能を1つのシステムに統合することで、MyScaleはインフラとメンテナンスコストを削減します。この統合により、共同データクエリーと分析が可能になり、AIアプリケーションのための単一のデータ基盤が実現します。MyScaleはまた、LLMシステムの完全な観測性を実現するMyScale Telemetryを備えているため、効率的なモニタリングとデバッグが可能です。データがより複雑になるにつれ、MyScaleは、異なるデータタイプ間のコンピューティング・パフォーマンスと統合性を維持しながら、より新しいデータ様式とデータベース・サイズに対応できる、将来性のあるソリューションです。
主な違い
ベクトル検索ツールに関しては、MongoDB Atlas Vector SearchとMyScaleは2つの素晴らしい選択肢です。この2つを比較することで、あなたのプロジェクトに必要な情報を得ることができます。
検索方法
MongoDB Atlas Vector Search は、HNSW (Hierarchical Navigable Small World) アルゴリズムを使ってベクトルデータのインデックス化と検索を行います。これはベクトル空間の多階層グラフを作成し、近似最近傍 (ANN) 検索を可能にします。また、最大10,000ドキュメントまでの厳密最近傍(ENN)検索もサポートしている。
MyScaleには、複数のベクトルインデックスタイプと類似度メトリクスがあります。ユークリッド距離(L2)、内積(IP)、余弦類似度などの一般的な距離メトリクスをサポートしています。MyScaleには複数のインデックス作成アルゴリズムがあります:MSTG(マルチスケールツリーグラフ)、ScaNN、IVFFLAT、IVFPQ、IVFSQ、HNSWです。これにより、検索のパフォーマンスと精度をよりコントロールすることができます。
データ処理
MongoDB Atlas Vector Search は MongoDB の柔軟なドキュメントモデルで動作します。ベクトル埋め込みデータを他のドキュメントデータと一緒に保存して、より文脈に沿った正確な検索ができます。最大 4096 次元まで埋め込むことができ、ベクトルの類似性検索とドキュメントのフィルタリングを組み合わせることができます。
MyScaleは、構造化データとベクトルデータの両方を扱えるように構築されています。MyScaleはリアルタイム分析および機械学習ワークロード用に設計されているため、時系列検索、ベクトル検索、全文検索に適しています。MyScaleは、OLAPデータベース・アーキテクチャにより、構造化データとベクトル化データの両方の分析ワークロードを1つのプラットフォームで処理できるユニークな製品です。
スケーラビリティとパフォーマンス
MongoDB Atlasにはサーチノードがあり、アトラスサーチとベクターサーチのワークロード専用のインフラを提供します。これは、最適化されたコンピュートリソースと検索ニーズの独立したスケーリングにより、スケール時のパフォーマンスを向上させることを意味します。
MyScaleは、高いパフォーマンスとスケーラビリティで知られるClickHouseアーキテクチャで構築されています。独自のMSTGベクトルエンジンは、NVMe SSDを使用してデータ密度を向上させ、パフォーマンスとコストの両面で特殊なベクトルデータベースを上回る可能性があります。
柔軟性とカスタマイズ
MongoDB Atlas Vector Searchでは、ハイブリッド検索が可能で、ベクトル検索とフルテキスト検索を組み合わせることで、より詳細な検索結果を得ることができます。また、ベクトル類似検索とドキュメントフィルタリングを組み合わせることで、より柔軟なクエリ構築を可能にします。
MyScaleはネイティブSQLをサポートしているため、開発者はベクトル検索、全文検索、従来のSQLクエリを1つのシステムに統合することができます。このSQLベースのアプローチは、リレーショナルデータベースの経験を持つ開発者にとって、より馴染みやすく、利用しやすいものです。
統合とエコシステム
MongoDB Atlas Vector Searchは一般的なAIサービスやツールと統合しており、OpenAIやVoyageAIのモデルの埋め込みをサポートしています。LangChainやLlamaIndexのようなオープンソースのフレームワークと連携し、大規模言語モデル(LLM)を使用するアプリケーションを構築できます。
MyScaleの統合についてはドキュメントに明示的に記載されていないが、SQLをサポートしていることから、多くのSQL互換のツールやフレームワークと統合できるものと思われる。
使いやすさ
MongoDB Atlas Vector Searchは、既存のMongoDBエコシステムの上に構築されているので、すでにMongoDBに慣れ親しんでいるのであれば、学習曲線は緩やかでしょう。
MyScaleのベクターデータをクエリするSQLは、SQLの経験がある開発者にとってはアクセスしやすいかもしれないが、インデックスアルゴリズムやパラメータが多様なので、最高のパフォーマンスを得るためには、より多くの学習とチューニングが必要になるだろう。
コスト
MongoDBには確立されたエコシステムがあり、たくさんのドキュメントがあり、開発者はMongoDBに精通している。すでにMongoDBを使っているなら、ベクトル検索を追加するのは当然のことかもしれません。
MyScaleの統一されたアプローチは、1つのシステムに複数の機能を持たせることで、インフラとメンテナンスコストを削減できる。そのMSTGベクトルエンジンは、特化したベクトルデータベースよりも性能が高く、費用対効果も高いと主張している。
それぞれを選択する場合
MongoDB Atlas Vector Search は、すでにデータベースとして MongoDB を使っていて、別のシステムを導入することなくベクトル検索を追加したい場合に適しています。レコメンデーションシステムや高度な商品検索のように、ベクトル検索とドキュメントデータをシームレスに統合する必要があるアプリケーションに最適です。MongoDBのソリューションは、ベクトル類似検索とドキュメントフィルタリングを組み合わせる必要がある場合に最適で、より文脈に沿った質問をすることができます。スケーラビリティや一般的なAIツールとの統合など、MongoDBのエコシステムを利用したい場合は、MongoDB Atlas Vector Searchをお選びください。
SQLデータベース、ベクトル検索、全文検索を組み合わせた単一のプラットフォームが必要な場合は、MyScaleを選択するのがよいでしょう。MyScaleは、AI主導の分析や、ベクトル成分を含む複雑な時系列分析など、構造化データとベクトルデータの両方をリアルタイムで処理する必要があるアプリケーションに最適です。MyScaleはネイティブSQLをサポートしているため、使い慣れたクエリ言語でベクトル検索を行いたいSQLスキルの高いチームに最適です。ベクトルインデキシングアルゴリズムに柔軟性が必要な場合、規模に応じてコストとパフォーマンスを最適化したい場合、1つのプラットフォームで複数のデータタイプと検索モダリティを扱えるソリューションが必要な場合は、MyScaleをお選びください。
結論
MongoDB Atlas Vector Search は、既存の MongoDB デプロイメントとシームレスに統合でき、強力なベクトル検索を持ち、ベクトル検索とドキュメントフィルタリングを組み合わせることができます。MyScaleは、SQL、ベクトル、全文検索のための単一プラットフォームで、柔軟なインデックス作成とベクトルクエリのネイティブSQLサポートを備えています。これらのどちらを選択するかは、既存のインフラ、ユースケース、チームによって異なります。文書データとの統合、SQLベースのクエリ、扱うデータの種類、スケーラビリティの必要性などの要素を考慮してください。どちらも堅牢なベクトル検索を備えているが、それぞれの強みは異なるシナリオや開発環境に適合する。
これを読めばMongoDBとMyScaleの概要がわかるが、これらを評価するにはユースケースに基づいて評価する必要がある。それに役立つツールの一つが、ベクターデータベースを比較するためのオープンソースのベンチマークツールであるVectorDBBenchだ。最終的には、独自のデータセットとクエリパターンで徹底的なベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力だが異なるこの2つのアプローチのどちらを選ぶかを決める鍵となるだろう。
オープンソースのVectorDBBenchを使ってベクトルデータベースを評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのためのオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)のような異なるベクトルデータベースシステムを独自のデータセットを使ってテストし比較し、自分のユースケースに合うものを見つけることができます。VectorDBBenchを使えば、ユーザーはマーケティング上の主張や伝聞ではなく、実際のベクターデータベースのパフォーマンスに基づいて決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースの性能を簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: Open-Source Vector Database Benchmark Tool](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
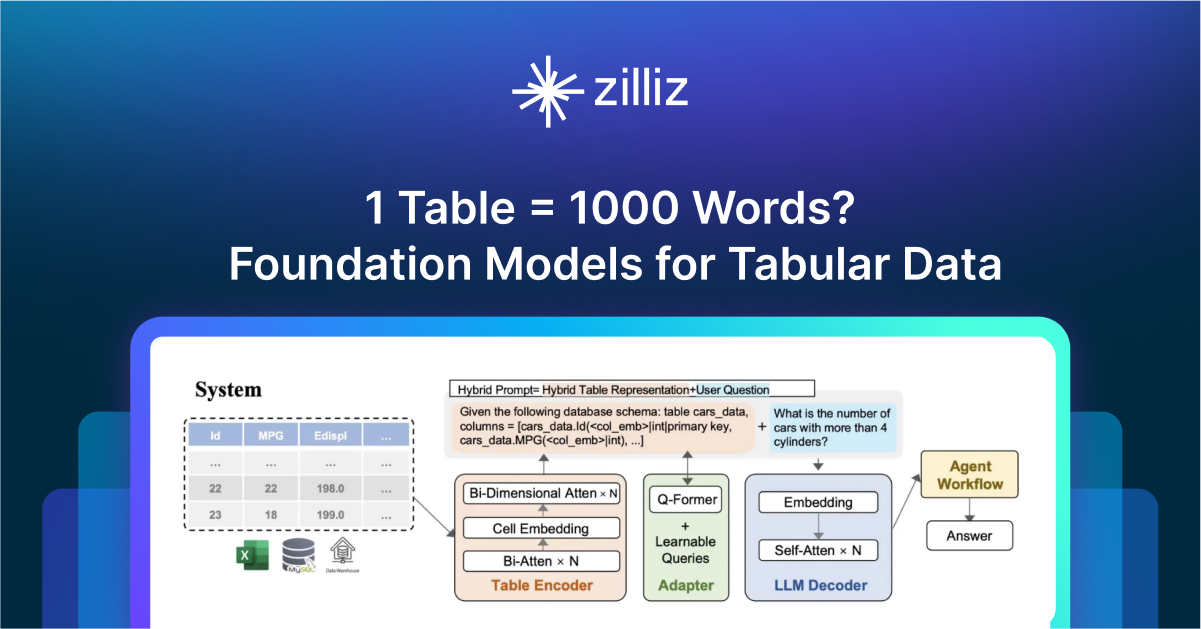
1 Table = 1000 Words? Foundation Models for Tabular Data
TableGPT2 automates tabular data insights, overcoming schema variability, while Milvus accelerates vector search for efficient, scalable decision-making.
Vector Databases vs. Time Series Databases
Use a vector database for similarity search and semantic relationships; use a time series database for tracking value changes over time.
Multimodal Pipelines for AI Applications
Learn how to build scalable multimodal AI pipelines using DataVolo and Milvus. Discover best practices for handling unstructured data and implementing RAG systems.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.