




Milvus 3.0 vs Elasticsearch: 検索ギャップを埋める
最新の検索には、正確なキーワードマッチングと意味的類似性という2つのことが同時に必要です。両方を得るには通常、2つのシステムが必要であり、同期、コスト、複雑さの代償を伴います。
私はElasticsearchで4年間働いていました。現在はZillizでベクトル検索を担当しています。1つのエンジンが両方をカバーできると断言するのではなく、誰でも確認できるものを構築しました。1台のマシン上の2つのDockerコンテナで動作するMilvus 3.0とElasticsearch 9です。同じCPUとメモリの上限、同じParquetファイル、同じベクトル、同じアナライザチェーンを備え、すべてのクエリをライブで並行して実行します。リポジトリは最後にリンクされているので、自分のデータで検証して実行できます。
TL;DR: ほとんどのチームにとって、Milvus 3.0はキーワード検索とベクトル検索の両方を十分にカバーし、2つのエンジン構成を置き換えられます。いくつかの機能はロードマップ上にあり、それらは出てきた時点で指摘します。
検索のギャップ
キーワード検索とベクトル検索は異なるエンジンで発展してきたため、両方をカバーするには妥協が必要でした。
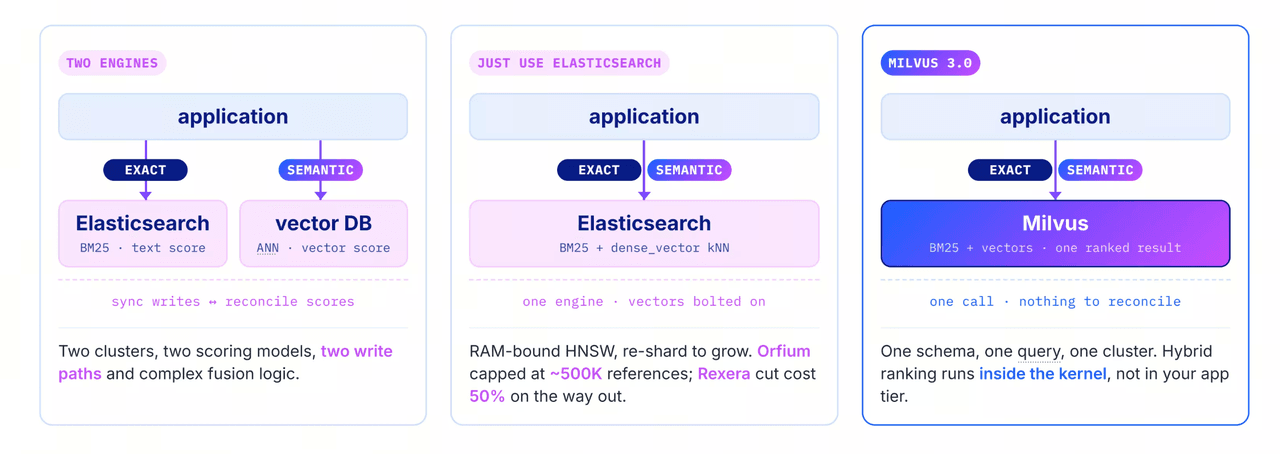
よくある妥協は2つのエンジンを使うことです。BM25にはElasticsearchまたはOpenSearch、その隣にANN用のベクトルデータベース。つまり、2つのクラスタ、2つの書き込みパス、そしてクエリ時に自分で調整する2つのスコアリングモデルがあります。
もう1つの方法は、キーワードエンジン自身のベクトル検索を使い、2つ目のクラスタを省略することです。小規模では機能しますが、そこではベクトルはLuceneプラグインに過ぎません。セグメントごとに1つのHNSWグラフ、RAMに制約され、拡張するには再シャーディングが必要です。上限があります。Orfiumは、音楽著作権管理を手がける世界的リーダーですが、移行する前に約500Kのリファレンストラックで上限に達しています。
Milvus 3.0は両方のために構築された1つのエンジンです。 BM25とベクトルを1つのスキーマに統合し、調整不要の単一呼び出しとしてハイブリッドクエリを実行し、アプリ層ではなくカーネル内でランキングを行います(相互ランク融合 - RRF - も標準装備)。
この記事の残りでは、Milvus 3.0とElasticsearchを機能ごとに比較し、Milvusが及ばない点も含めて検証します。(OpenSearchも同じLuceneベクトルアーキテクチャを共有しているため、これらの点は一般的にOpenSearchにも当てはまります。Elasticsearch固有の唯一の違いはライセンスです。そのRRFハイブリッド融合はオープンソース機能ではなく、以下で指摘しています。)
正確な検索と意味的検索の両方を必要とするのは誰か?
単一のクエリには、正確な制約と曖昧な意図が同時に含まれることがよくあります。だからこそAIアプリケーションは常にこの問題に直面します。
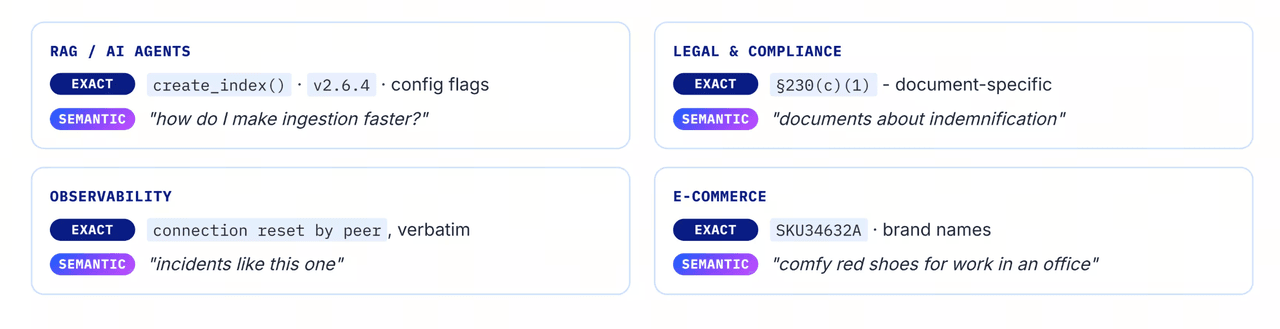
RAGとAIエージェント。 完全一致: 関数名やバージョンフラグ(
create_index()、v2.6.4)。意味的: 「どうすれば取り込みを高速化できるか?」法務とコンプライアンス。 完全一致: 条項や引用(
§230(c)(1))。意味的: 「免責に関する文書」可観測性。 完全一致: エラー文字列をそのまま(
connection reset by peer)。意味的: 「これと似たインシデント」Eコマース。 完全一致: SKUまたはブランド。意味的: 「オフィス用の履き心地のよい赤い靴」
キーワードのみのエンジンは意図を取りこぼし、ベクトルのみのエンジンは完全一致を取りこぼします。1つのエンジンが両方を処理する必要があります。
Elasticsearch vs Milvus テスト設定: エンジン、データ、リソース使用量
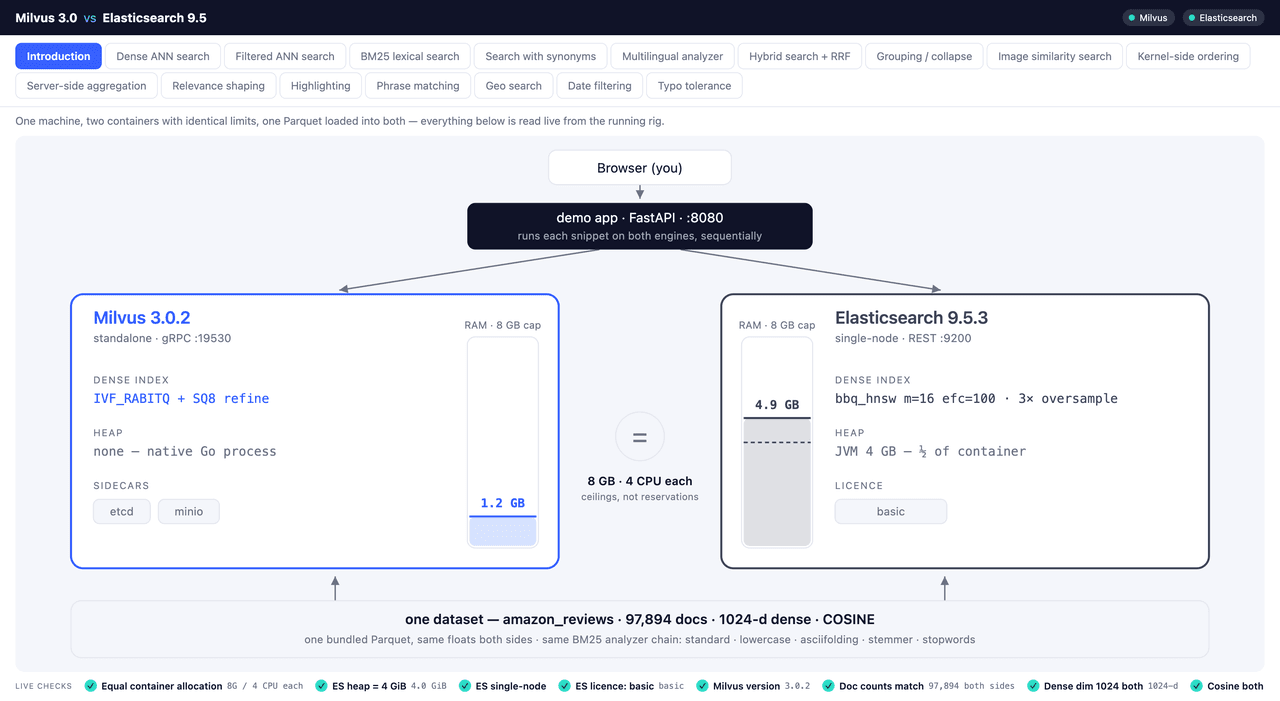
両方のエンジンは同等に実行されるため、違いはハーネスではなくエンジンに起因します。
エンジン: Milvus 3.0スタンドアロンとElasticsearch 9.5。それぞれDockerで実行され、それぞれ8GB RAM / 4 CPUに制限されます(Milvusの
etcdとMinIOサイドカーもその枠を共有)。データ: 1つのParquetファイルから約98K件のAmazon製品レコードを、バイト単位で両方に読み込み。
ベクトル: 両側で同じ1024次元のコサイン浮動小数点。一度生成してそれぞれに読み込むため、再エンベッドはありません。
インデックス: 同じBM25アナライザーチェーン(標準トークナイザー、小文字化、ASCIIフォールディング、英語ステマー/ストップワード)。ベクトルには、MilvusはRaBitQ 1ビット+ SQ8リファインメントを使用し、Elasticsearchはbbq_hnswを使用します。
グラウンドトゥルース: リコールは、全セットに対する正確なブルートフォース近傍に対してスコアリングされるため、数値は自己申告ではなく測定値です。
デモの最初のタブは、クエリが実行される前にこれらすべてをライブで検証します。
リソース使用量。 同じデータセットで、Milvusとそのサイドカーは合計約0.5GBのメモリを使用しましたが、Elasticsearchのフットプリントは約5GBでした。
注記: これはベンチマークではありません。レイテンシはJVMのウォームアップ、コンテナ制限、コールドキャッシュによって左右されるため、タイミングは方向性の参考として扱い、実際の数値には公開された大規模ベンチマークを使用してください。以降の結果にはさらに2つの注意点があります。アナライザーの同等性は近いが完全ではありません(englishステマーはElasticsearchではPorter1、MilvusではPorter2)。また、ハイブリッドパスの1つはElasticsearchではライセンス制限があります。どのマシンでも再現できるのは、機能カバレッジ、クエリ動作、エンジン間の一致、そしてリコールです。
以下が結果です。
デンス(ANN)ベクトル検索:リコールはどこから来るか
# Milvus
client.search(
  "amazon_reviews",
  data=[qv],
  anns_field="text_vec",
  search_params={
    "params": {
      "nprobe": 4,
      "rbq_bits_query": 4,
      "refine_k": 2.0,
    },
  },
  limit=10,
)
# Elasticsearch
client.search(
  index="amazon_reviews",
  knn={
    "field": "text_vec",
    "query_vector": qv,
    "k": 100,
    "num_candidates": 100,
  },
  size=10,
)
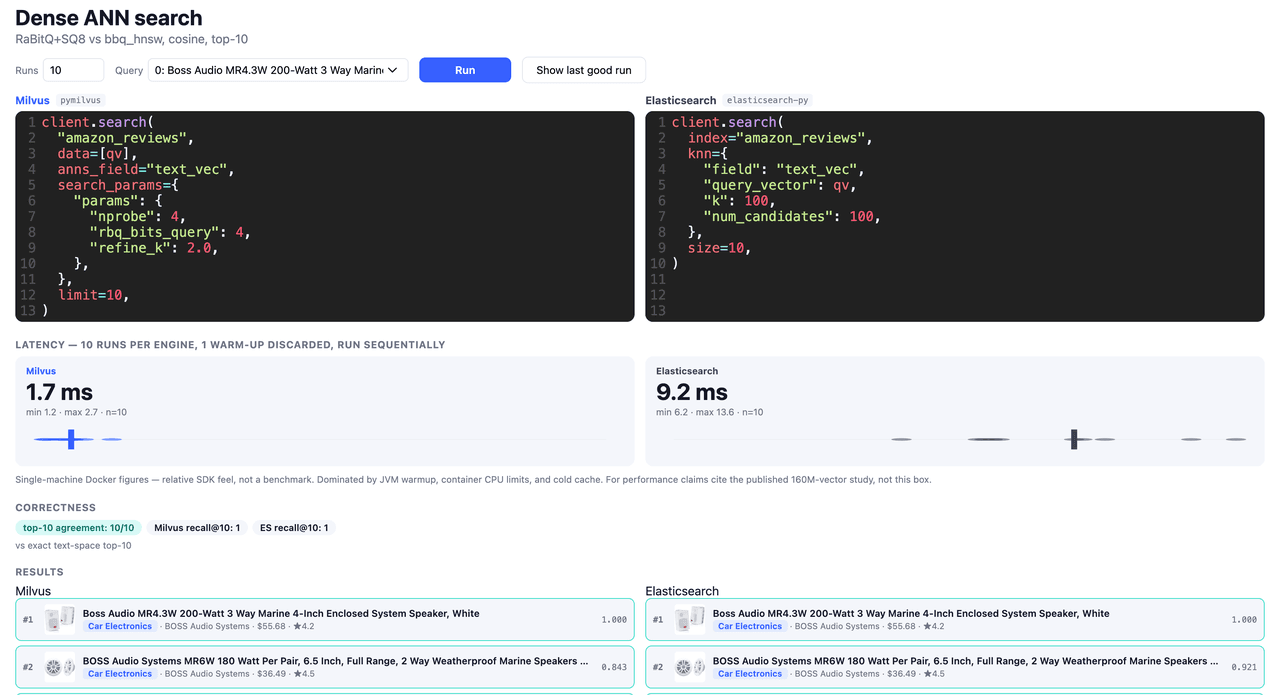
両方とも高いリコールで実質的に同じ近傍を返します。有用な疑問は、どのノブがそれを実現するかです。なぜなら、それは明白なものではないからです。デフォルト(nprobe=64、refine_k=2.0)ではrecall@10は約0.99です。ノブを分けて見ると:
nprobe | refine_k | recall@10 |
|---|---|---|
| unset | 1.0 | 0.928 |
| 64 | 1.0 | 0.930 |
| unset | 2.0 | 0.980 |
| 64 | 2.0 | 0.990 |
nprobeは数値をほとんど動かさず、約8で飽和します。refine_kを1.0から2.0に上げると+0.05〜+0.06の改善になります。リコールは、グラフをより多くスキャンすることではなく、SQ8パスが1ビットの候補を再スコアリングすることから得られます。したがって、リコールが低い場合はrefine_kを上げてください。ここではほぼコストがかかりません。トレードオフ:1ビット量子化は非可逆であり、リファインメントパスこそが、リコールを高く保ちながらメモリを低く保つものです。
全文(BM25)検索:小規模インデックスでの同等性
# Milvus
client.search(
  "amazon_reviews",
  data=["wireless earbuds"],
  anns_field="text_sparse",
  limit=10,
)
# Elasticsearch
client.search(
  index="amazon_reviews",
  query={"match": {"text_snippet": "wireless earbuds"}},
  size=10,
)
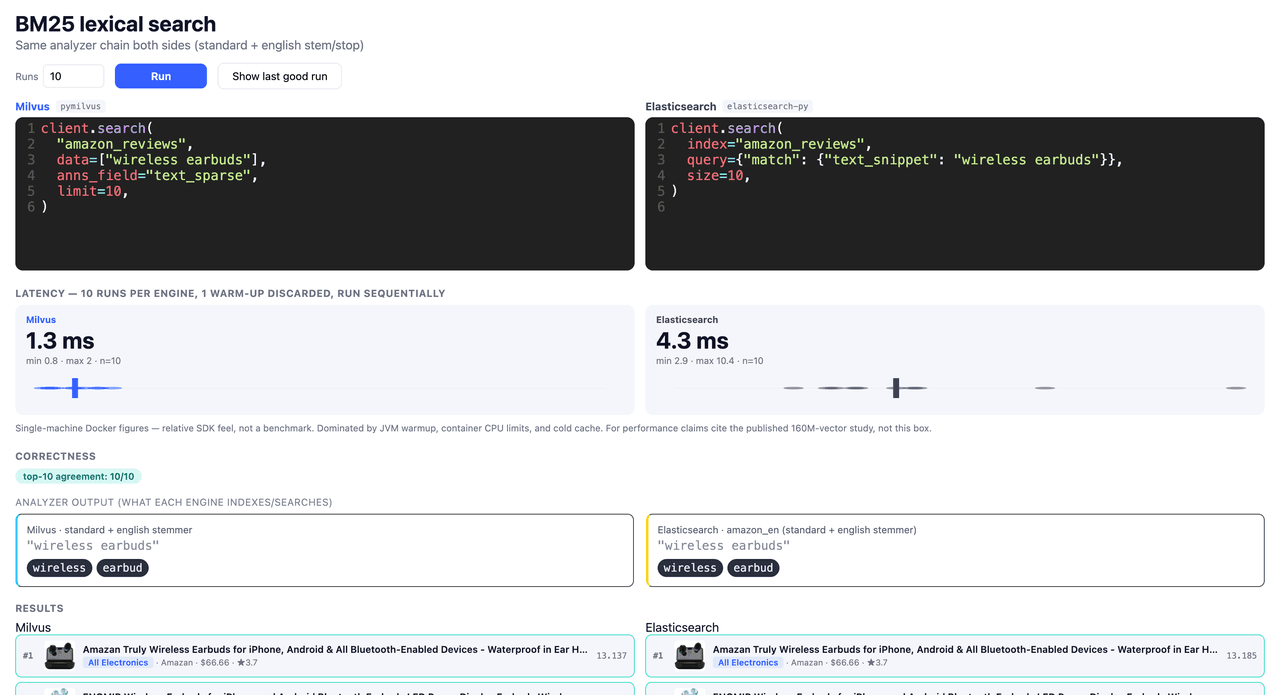
同じトップ10、結果セットの完全な一致、そしてMilvusは多くの場合少し速いです。違いはその下にあります。MilvusのBM25インデックス(Zilliz Cloud用に構築され、その後オープンソースにコントリビュートされたもの)は、Elasticsearchのものより約3倍小さいサイズで動作し、背後にJVMヒープはなく、耐久性のためにレプリカも必要ありません。
ハイブリッド検索:デンス+ BM25とRRF
ハイブリッド検索は、デンス結果と字句検索結果を1つのランキングに融合する必要があります。Milvusでは、両方のリクエストが融合ランカーと一緒に1回の呼び出しで送られます:
# Milvus
dense = AnnSearchRequest(
  [qv], "text_vec", SEARCH, limit=50)

sparse = AnnSearchRequest(
  ["wireless earbuds"], "text_sparse", {}, limit=50)

client.hybrid_search(
  "amazon_reviews",
  [dense, sparse],
  ranker=RRFRanker(),
  output_fields=["parent_asin"],
  limit=10,
)
Elasticsearch版はほぼ同じに見えます — rrfで融合された2つのレトリーバー:
# Elasticsearch
sparse = {"standard": {"query": {
  "match": {"text_snippet": "wireless earbuds"}}}}

dense = {"knn": {
  "field": "text_vec", "query_vector": qv,
  "k": 50, "num_candidates": 100}}
`client.search( index="amazon_reviews", retriever={"rrf": { "retrievers": [sparse, dense], "rank_window_size": 50, }}, size=10, )
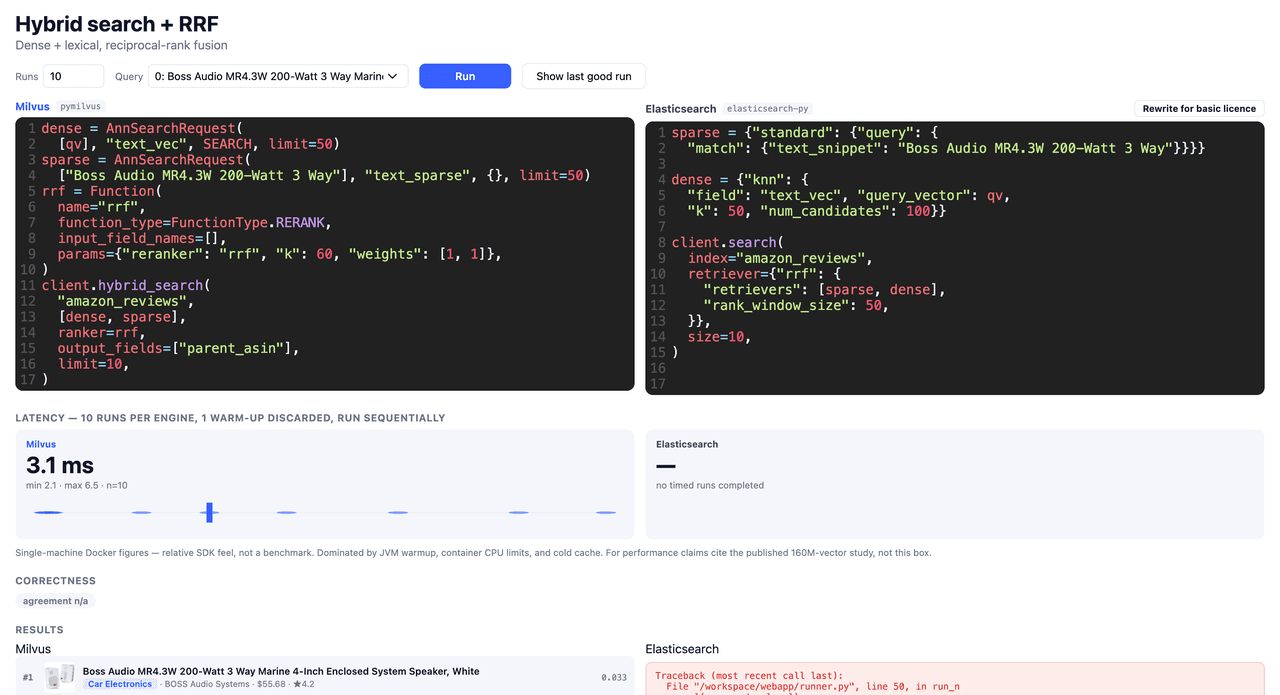
ベーシックライセンスの Elasticsearch では、これは **403** を返します。`rrf` と `linear` は Platinum ティアのリトリーバーであり、一方 Milvus の `RRFRanker` と `WeightedRanker` は無料ビルドに含まれています。無料版の Elasticsearch では、代わりに手動調整した `boost` ウェイトで `knn` と `match` を融合しなければなりません:
```python
# Elasticsearch, basic-licence rewrite
client.search(
index="amazon_reviews",
query={"match": {"text_snippet": {
"query": "wireless earbuds", "boost": 0.3}}},
knn={
"field": "text_vec", "query_vector": qv,
"k": 50, "num_candidates": 100, "boost": 0.7,
},
size=10,
)
これらの 0.3/0.7 というウェイトが、2つのエンジンを組み合わせる真のコストです。BM25 スコアには上限がなく、コサインは 0〜1 の範囲に収まるため、ウェイトを手動で調整し、コーパスが変化するたびに調整し直す必要があります。RRF はランクに基づく融合によってこれを回避します。
グループ化: group_by vs collapse
# Milvus
client.search(
  "amazon_reviews",
  data=[qv],
  anns_field="text_vec",
  group_by_field="main_category",
  group_size=1,
  search_params={"params": {"nprobe": 1, "rbq_bits_query": 4}},
  limit=10,
)
# Elasticsearch
client.search(
  index="amazon_reviews",
  knn={
    "field": "text_vec",
    "query_vector": qv,
    "k": 800,
    "num_candidates": 1600,
  },
  collapse={"field": "main_category.keyword"},
  size=10,
)
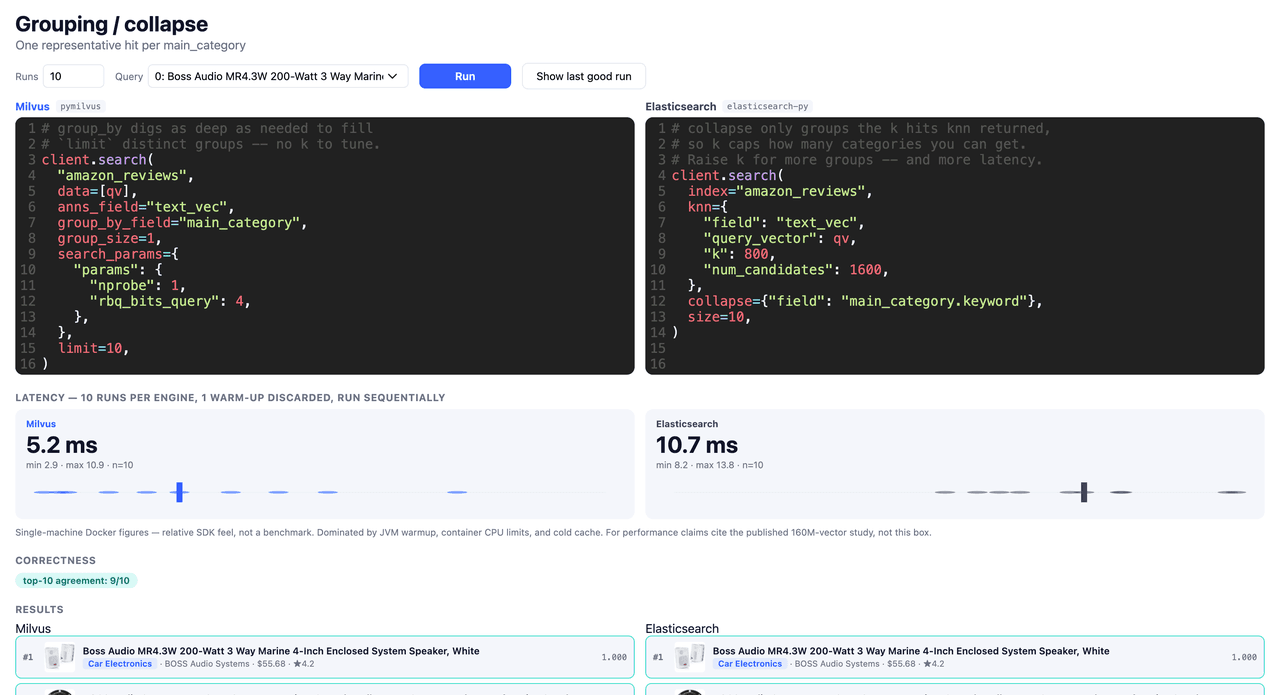
Milvus の group_by は、limit 個の異なるグループが満たされるまで読み取りを続けます。Elasticsearch の collapse は、kNN がすでに返した k 件のヒットのみをグループ化するため、取得できるカテゴリ数は k によって制限されます。より多くのカテゴリを得るには k を増やす必要があり、その分スキャン範囲が広がるコストを払うことになります。これが k=800/num_candidates=1600 と limit=10 の対比です。一方は構造上完全ですが、もう一方は十分に過剰取得した場合にのみ完全になります。
サーバーサイド集約
サーバーサイド集約は Milvus 3.0 の新機能で、グループ化するフィールドを設定し、出力配列に計算フィールドを定義することで使用します。
# Milvus
client.query(
  "amazon_reviews",
  group_by_fields=["main_category"],
  output_fields=[
    "main_category", "count(*)", "avg(price)",
    "min(price)", "max(price)", "avg(average_rating)",
  ],
  order_by_fields=[{"field": "main_category", "order": "asc"}],
  limit=20,
)
Elasticsearch はバージョン 1.0 から集約を備えており、集約グループと計算された出力フィールドを持つオブジェクトを設定することで使用します。
# Elasticsearch
client.search(
  index="amazon_reviews", size=0, request_cache=False,
  aggs={"by_group": {
    "terms": {
      "field": "main_category.keyword",
      "size": 20,
      "order": {"_key": "asc"},
    },
    "aggs": {
      "avg_price": {"avg": {"field": "price"}},
      "min_price": {"min": {"field": "price"}},
      "max_price": {"max": {"field": "price"}},
      "avg_rating": {"avg": {"field": "average_rating"}},
    },
  }},
)
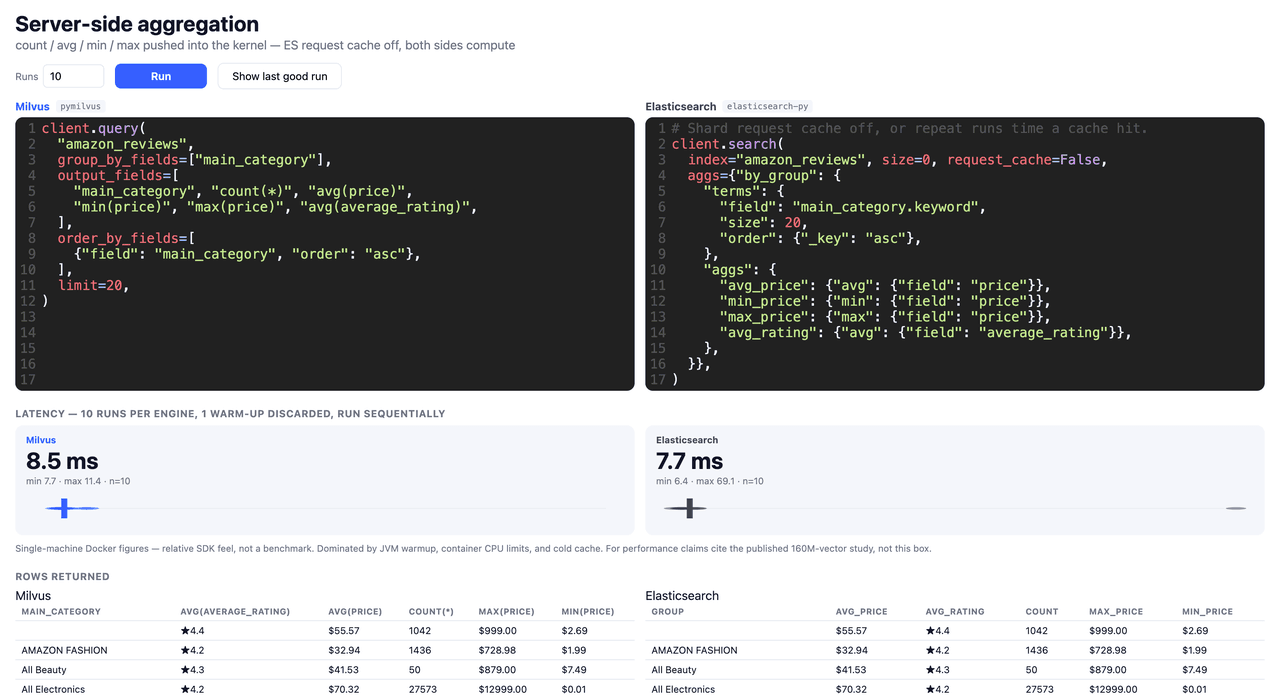
両方とも同じ集約結果を返しますが、ここでは Elasticsearch がわずかに高速です(純粋な集約パフォーマンステストのためにリクエストキャッシュを無効にしています)。terms 集約は、フィールドの異なる値の数が各シャードが返す数よりも多い場合、近似的です。シャードはローカルの上位 terms のみを返すため、カウントが過小評価されたり、上位 N 件が正しくなくなったりする可能性があります。Milvus 3.0 は、クエリ時に可視なすべての行に対して集約を正確に計算します。すべてのグループを返します。Milvus の集約は新しく、まだ最適化が進行中です。ワークロードの中心となる場合は、ご自身のデータでベンチマークを実施し、必要な機能をお知らせください。
多くの検索ユースケースでは再ランキングと複数ステージが必要です。例えば、最初に最も関連性の高い結果を取得し、次に評価で再ランキングし、最後に価格でランキングする、といった具合です。マルチステージ再ランキングはMilvus 3.0.1で新しく導入され、再ランク関数をチェーンさせて複雑なビジネスロジックを1回の検索で実現できます。
# Milvus
l0 = (FunctionChain(FunctionChainStage.L0_RERANK)
  .map("rated", fn.decay(col("average_rating"),
    function="linear", origin=5, scale=4))
  .map("$score", fn.num_combine(col("$score"), col("rated"),
    mode="weighted", weights=[1, 0.2])))
# L1 re-scores all 200 by price, keeps 50.
l1 = (FunctionChain(FunctionChainStage.L1_RERANK)
  .map("cheap", fn.decay(col("price"),
    function="gauss", origin=0, scale=30, offset=10))
  .map("$score", fn.num_combine(col("$score"), col("cheap"),
    mode="weighted", weights=[1, 0.2]))
  .sort("$score").limit(50))
# L2: 0.5 -> 1.0 ramp up to 100 reviews, keeps 10.
l2 = (FunctionChain(FunctionChainStage.L2_RERANK)
  .map("proven", fn.decay(col("rating_number"),
    function="linear", origin=1e6,
    offset=1e6 - 100, scale=100))
  .map("$score", fn.num_combine(col("$score"), col("proven"),
    mode="weighted", weights=[1, 0.2]))
  .sort("$score").limit(10))
client.search(
  "amazon_reviews",
  data=[qv],
  anns_field="text_vec",
  function_chains=[l0, l1, l2],
  limit=200,
)
Elasticsearchの構文は、リスコア関数の配列です:
# Elasticsearch
client.search(
  index="amazon_reviews",
  query={"function_score": {
    "query": {"knn": {
      "field": "text_vec", "query_vector": qv,
      "k": 200, "num_candidates": 400, "boost": 2}},
    "functions": [{"linear": {"average_rating": {
      "origin": 5, "scale": 4}}, "weight": 0.2}],
    "boost_mode": "sum",
  }},
  rescore=[
    {"window_size": 200, "query": {
      "rescore_query_weight": 0.2,
      "rescore_query": {"function_score": {"functions": [
        {"gauss": {"price": {
          "origin": 0, "scale": 30, "offset": 10}}}]}}}},
    {"window_size": 50, "query": {
      "rescore_query_weight": 0.2,
      "rescore_query": {"function_score": {"functions": [
        {"linear": {"rating_number": {"origin": 1e6,
          "offset": 1e6 - 100, "scale": 100}}}]}}}},
  ],
  size=10,
)
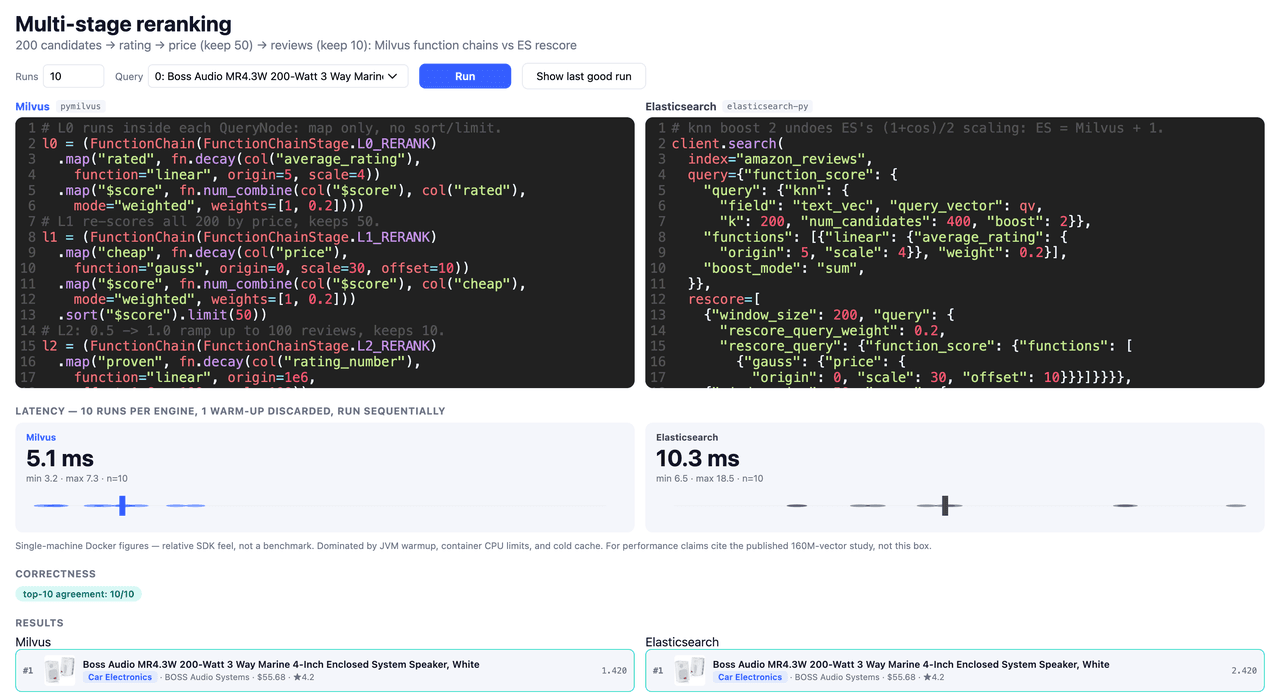
この比較の概要
ウォークスルー全体を通じて、各エンジンの位置づけは次のとおりです。
| 機能 | 結果 |
|---|---|
| 密ベクトル(ANN)検索 | 互角:>0.99 recall@10 |
| 全文(BM25)検索 | 互角:同一のトップ10 |
| ハイブリッド検索(RRF) | Milvus:1回の呼び出しで、無料ビルドにRRF搭載。Elasticsearchは有料ティアの背後にゲート |
| グループ化 | Milvus:設計上完全。collapse は k によって制限される |
| 順序付け、関連性調整、地理、ハイライト | 互角:同じセマンティクス、よりクリーンな構文 |
| メモリ使用量 | Milvus:同じデータに対し約1.0 GB vs 約5 GB |
| サーバーサイド集計 | Elasticsearch:現在は高速。Milvusは3.0で実装し、チューニング中 |
| マルチステージ再ランキング | 互角:同一のトップ10 |
| タイポ許容検索 | Elasticsearch は現在、Milvusはロードマップ上 |
Milvusは、コアのキーワード操作とベクトル操作ではElasticsearchに匹敵し、ハイブリッド検索、グループ化、メモリで勝り、劣るのは集計の成熟度とあいまいマッチングのみであり、これらは両方ともロードマップに含まれています。私たちが最もよく目にするワークロード(キーワード検索+セマンティック検索、AI・RAGユースケースで増加中)では、Milvus 3.0は両面を十分にカバーし、より小さいフットプリントで2エンジンスタックを置き換えることができます。検索が集計優先のクラシックなBM25であれば、移行前にそのパスをベンチマークしてください。スケールでのハイブリッドまたはベクトル中心のすべてについては、Milvusが第一の選択肢になるはずです。
さらに追加予定です!
将来の3.xリリースでは、いくつかの機能がまだロードマップにあります:タイポトレラント(あいまい)検索 と 入力中検索(search-as-you-type) です。
ファジーなタイポ(誤字)対応。 Elasticsearchの編集距離ベースのファジー検索は、検索におけるユーザーのスペルミスを補正します。Milvus 3.0では、シノニムフィルターに既知のスペルミスを列挙するか、ファジーマッチフィルタリングを使用できますが、真のファジーBM25検索は近日公開予定です。
検索中逐次表示(Search-as-you-type)。 Milvusには現在フレーズプレフィックス一致クエリタイプはありませんが、エンティティ/ドキュメントごとに正規化されたサジェスト文字列を保存し、フィールドにNグラムインデックスを追加することで、高速なタイプアヘッド検索を実現できます。その後、正規化された検索文字を使用してLIKE "prefix%"クエリを実行し、サブ5msのクライアント側応答を得ることができます。
ご興味がありますか? 詳しくはこちら: https://simonhearne.com/2026/fast-typeahead-milvus/
自分で比較を実行する
(翻訳不要 - コードブロックのため原文のまま)
docker compose up -d
python data/fetch.py        # one Parquet, ~370 MB
docker compose exec demo python data/load_milvus.py
docker compose exec demo python data/load_es.py
Dockerには少なくとも16 GBのRAMが必要です。コードはgithub.com/simonhearne/milvus_es_labにあり、YouTubeでウォークスルーを視聴できます。ご自身のParquetファイルをロードして、ご自身のデータで実行してください — それが重要な数値です。
すでに移行を完了したチーム
2つのエンジンを実行していたチームが、これらの限界のいずれかに達し、MilvusまたはZilliz Cloud上の単一エンジンに移行した事例:
123RF(画像検索、OpenSearch → Zilliz Cloud): 約2億のストックアセットベクトル、検索コストが半分以上削減、レイテンシが半分のサブ50msに短縮。
PLAUD(エージェントメモリ、OpenSearch → Zilliz Cloud): リージョンあたり100億以上のメモリチャンクを200ms未満の平均リコールレイテンシで処理、200万台以上のデバイスに対応。
Rexera(RAG + エージェント、Elasticsearch → Zilliz Cloud): ハイブリッド検索により検索精度が約40%向上、コストが約50%削減。
Orfium(オーディオマッチング、Elasticsearch → Zilliz Cloud): Zilliz Cloud上で約2億5000万のオーディオベクトルを処理、旧環境の限界をはるかに超越。
OpenArt(マルチモーダル検索、Elasticsearch → Zilliz Cloud): 再エンベディングなしで4億5600万ベクトルを移行。P99レイテンシが約25秒から約300msに短縮、コンピュートコストが約85%削減。
数値は顧客シナリオと社内テストに基づきます。結果はデータ規模、分布、インデックスパラメータ、構成によって異なります。詳細: zilliz.com/customers。
読み続けて
How to Install and Run OpenClaw (Previously Clawdbot/Moltbot) on Mac
Turn your Mac into an AI gateway for WhatsApp, Telegram, Discord, iMessage, and more — in under 5 minutes.
Zilliz Cloud Audit Logs Goes GA: Security, Compliance, and Transparency at Scale
Zilliz Cloud Audit Logs are now GA, giving enterprises real-time visibility, compliance-ready trails, and stronger security across AWS, GCP, and Azure.

How to Build an Enterprise-Ready RAG Pipeline on AWS with Bedrock, Zilliz Cloud, and LangChain
Build production-ready enterprise RAG with AWS Bedrock, Nova models, Zilliz Cloud, and LangChain. Complete tutorial with deployable code.