Milvus 3.0 vs Elasticsearch: Fechando a Lacuna de Busca
A busca moderna precisa de duas coisas ao mesmo tempo: correspondência exata de palavras-chave e similaridade semântica. Obter ambas normalmente significa dois sistemas, e pagar por isso em sincronização, custo e complexidade.
Trabalhei na Elasticsearch por quatro anos; agora trabalho com busca vetorial na Zilliz. Em vez de afirmar que um mecanismo pode cobrir ambos, construí algo que você pode verificar: Milvus 3.0 e Elasticsearch 9 em dois contêineres Docker na mesma máquina: os mesmos limites de CPU e memória, o mesmo arquivo Parquet, os mesmos vetores, a mesma cadeia de analisadores; com cada consulta rodando ao vivo, lado a lado. O repositório está linkado no final para que você possa validar e executar com seus próprios dados.
TL; DR: para a maioria das equipes, o Milvus 3.0 cobre tanto a busca por palavras-chave quanto a vetorial bem o suficiente para substituir a configuração de dois mecanismos. Alguns recursos estão no roadmap, e eu os sinalizo conforme eles aparecem.
A lacuna da busca
A busca por palavras-chave e a busca vetorial cresceram em mecanismos diferentes, então cobrir ambas significou fazer concessões.
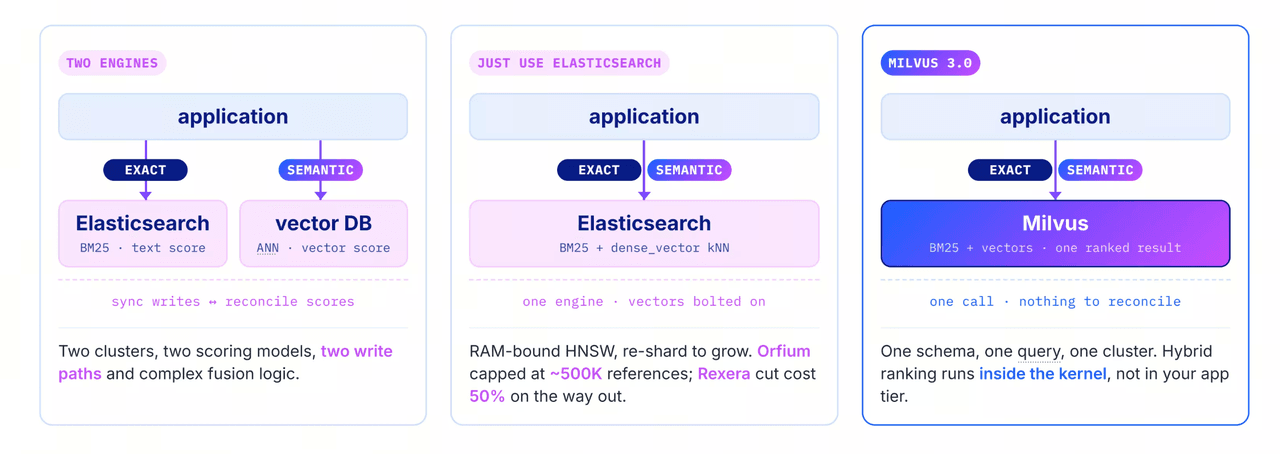
O compromisso usual é dois mecanismos — Elasticsearch ou OpenSearch para BM25, com um banco de dados vetorial ao lado para ANN. Isso resulta em dois clusters, dois caminhos de escrita e dois modelos de pontuação que você mesmo reconcilia no momento da consulta.
A outra é usar a busca vetorial do próprio mecanismo de palavras-chave e pular o segundo cluster. Funciona em pequena escala, mas vetores são um plugin do Lucene ali: um grafo HNSW por segmento, limitado à RAM, com re-sharding para crescer. Há um teto: a Orfium, líder global em gestão de direitos musicais, fica limitada a cerca de 500 mil faixas de referência antes de migrar.
O Milvus 3.0 é um mecanismo único criado para ambos: BM25 e vetores em um mesmo schema, uma consulta híbrida como uma única chamada sem nada para reconciliar, e ranqueamento no núcleo em vez da sua camada de aplicação (incluindo fusão de rank recíproco — RRF — de fábrica).
O restante deste post testa o Milvus 3.0 contra o Elasticsearch, recurso por recurso, inclusive onde o Milvus fica aquém. (O OpenSearch compartilha a mesma arquitetura vetorial do Lucene, então esses pontos geralmente se aplicam a ele também. A única diferença específica do Elasticsearch é o licenciamento: a fusão híbrida RRF dele não é um recurso de código aberto, sinalizado abaixo.)
Quem precisa de busca exata e semântica?
Uma única consulta geralmente carrega uma restrição exata e uma intenção difusa ao mesmo tempo, por isso os aplicativos de IA se deparam com isso constantemente:
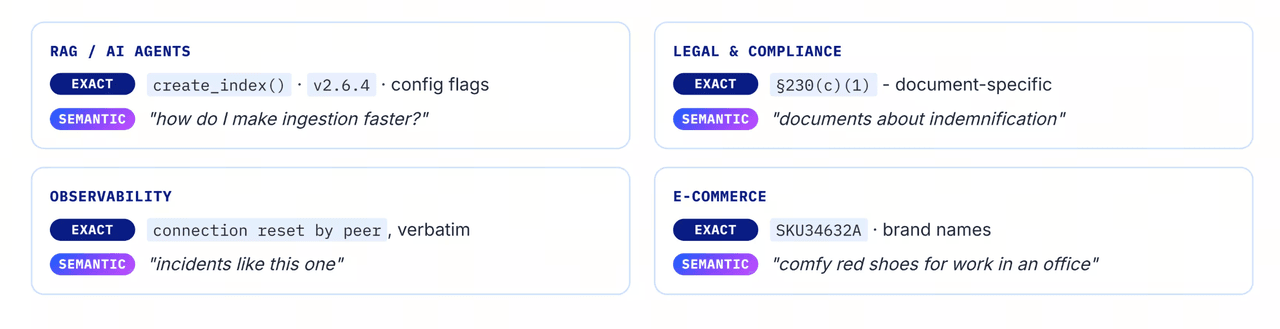
RAG e agentes de IA. Exato: um nome de função ou flag de versão (
create_index(),v2.6.4). Semântico: "como deixo a ingestão mais rápida?"Jurídico e compliance. Exato: uma cláusula ou citação (
§230(c)(1)). Semântico: "documentos sobre indenização".Observabilidade. Exato: uma string de erro, textualmente (
connection reset by peer). Semântico: "incidentes como este".E-commerce. Exato: um SKU ou marca. Semântico: "sapatos vermelhos confortáveis para o escritório".
Um mecanismo apenas de palavras-chave perde a intenção; um mecanismo apenas vetorial perde a correspondência exata. Um único mecanismo precisa dar conta de ambos.
Configuração do teste Elasticsearch vs Milvus: mecanismos, dados e uso de recursos
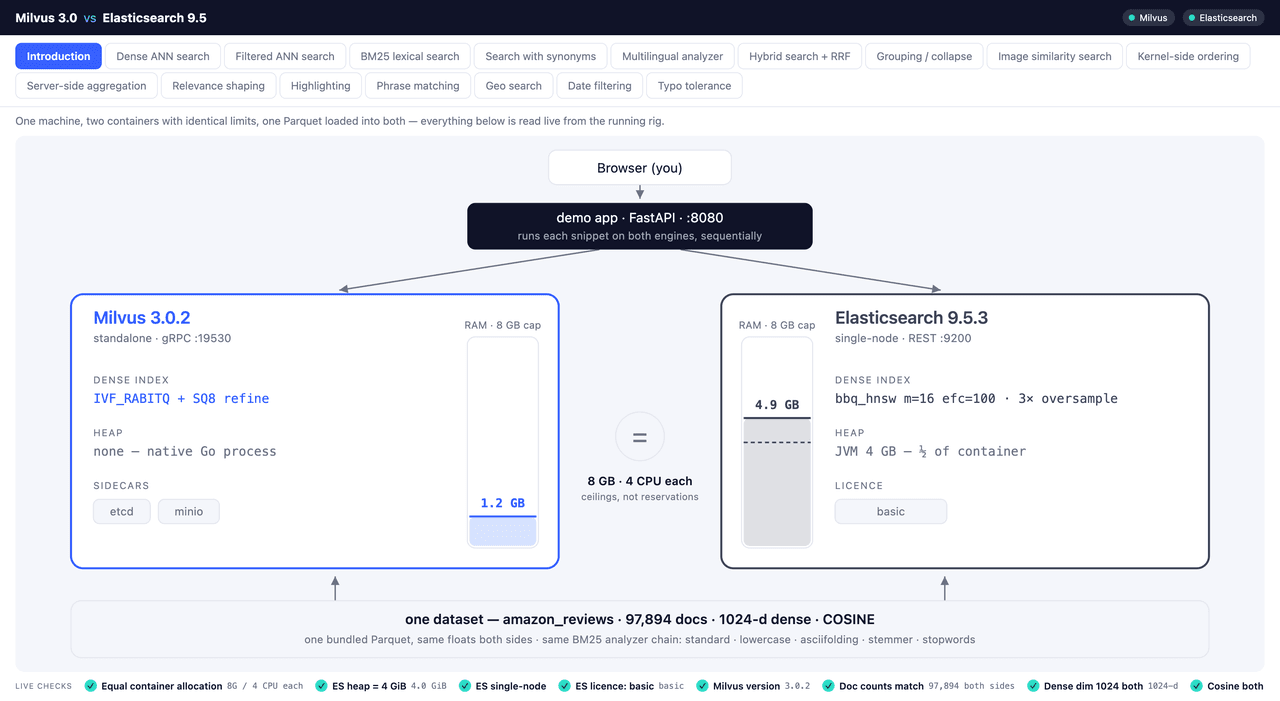
Ambos os mecanismos rodam em igualdade de condições, então qualquer diferença é do mecanismo, não do ambiente de teste:
Mecanismos: Milvus 3.0 standalone e Elasticsearch 9.5, cada um em Docker, cada um limitado a 8 GB de RAM / 4 CPUs (os sidecars
etcde MinIO do Milvus compartilham esse orçamento).Dados: ~98K registros de produtos da Amazon de um único arquivo Parquet, carregados byte a byte em ambos.
Vetores: os mesmos floats de cosseno 1024-d nos dois lados. Gerados uma vez, carregados em cada um, então nada é reembutido.
Índices: a mesma cadeia de analisadores BM25 (tokenizador padrão, minúsculas, ASCII-folding, stem/stop em inglês); Milvus usa RaBitQ 1-bit + refinamento SQ8 para vetores, Elasticsearch usa
bbq_hnsw.Ground truth: recall é pontuado contra vizinhos exatos de força-bruta sobre o conjunto completo, portanto os números são medidos, não auto-reportados.
A primeira aba da demo verifica tudo isso ao vivo antes de qualquer consulta ser executada.
Uso de recursos. Para o mesmo conjunto de dados, Milvus e seus sidecars usaram cerca de 0.5 GB de memória total, enquanto o footprint do Elasticsearch foi de cerca de 5 GB.
Observação: Isto não é um benchmark: a latência é moldada pelo aquecimento da JVM, limites do container e cache fria, portanto trate os tempos como direcionais e use benchmarks publicados em larga escala para números reais. Mais duas ressalvas se aplicam ao restante: a paridade dos analisadores é próxima, mas não exata (o stemmer english é Porter1 no Elasticsearch, Porter2 no Milvus), e um caminho híbrido é limitado por licença no Elasticsearch. O que se reproduz em qualquer máquina é a cobertura de recursos, o comportamento das consultas, a concordância entre mecanismos e o recall.
Abaixo estão os resultados.
Busca vetorial densa (ANN): de onde vem o recall
# Milvus
client.search(
  "amazon_reviews",
  data=[qv],
  anns_field="text_vec",
  search_params={
    "params": {
      "nprobe": 4,
      "rbq_bits_query": 4,
      "refine_k": 2.0,
    },
  },
  limit=10,
)
# Elasticsearch
client.search(
  index="amazon_reviews",
  knn={
    "field": "text_vec",
    "query_vector": qv,
    "k": 100,
    "num_candidates": 100,
  },
  size=10,
)
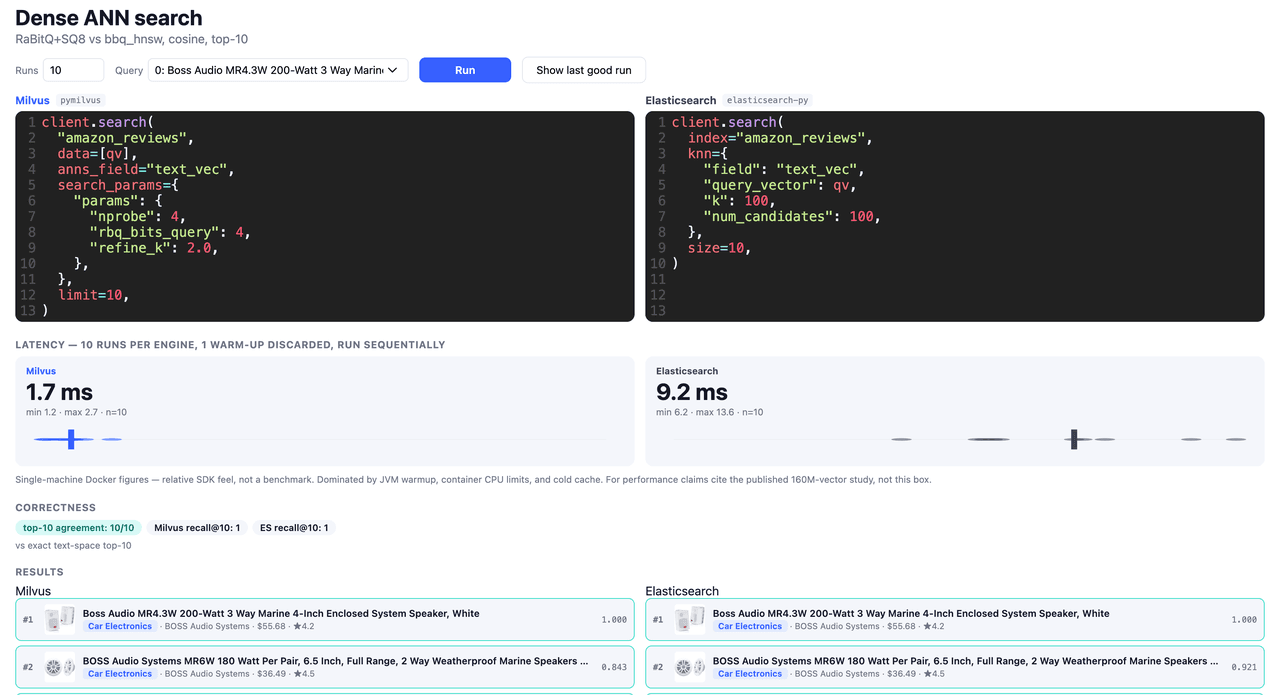
Ambos retornam essencialmente os mesmos vizinhos com recall alto. A questão útil é qual parâmetro compra isso, porque não é o óbvio. No padrão (nprobe=64, refine_k=2.0), o recall@10 é cerca de 0.99; separando os parâmetros:
nprobe | refine_k | recall@10 |
|---|---|---|
| unset | 1.0 | 0.928 |
| 64 | 1.0 | 0.930 |
| unset | 2.0 | 0.980 |
| 64 | 2.0 | 0.990 |
nprobe quase não move o número e satura por volta de 8; elevar refine_k de 1.0 para 2.0 vale +0.05 a +0.06. O recall vem da passagem SQ8 reclassificando os candidatos de 1-bit, não de varrer mais o grafo. Então, se o recall estiver baixo, aumente refine_k; aqui é quase de graça. O trade-off: a quantização de 1-bit é com perdas, e a passagem de refinamento é o que mantém o recall alto e a memória baixa ao mesmo tempo.
Busca de texto completo (BM25): paridade em um índice menor
# Milvus
client.search(
  "amazon_reviews",
  data=["wireless earbuds"],
  anns_field="text_sparse",
  limit=10,
)
# Elasticsearch
client.search(
  index="amazon_reviews",
  query={"match": {"text_snippet": "wireless earbuds"}},
  size=10,
)
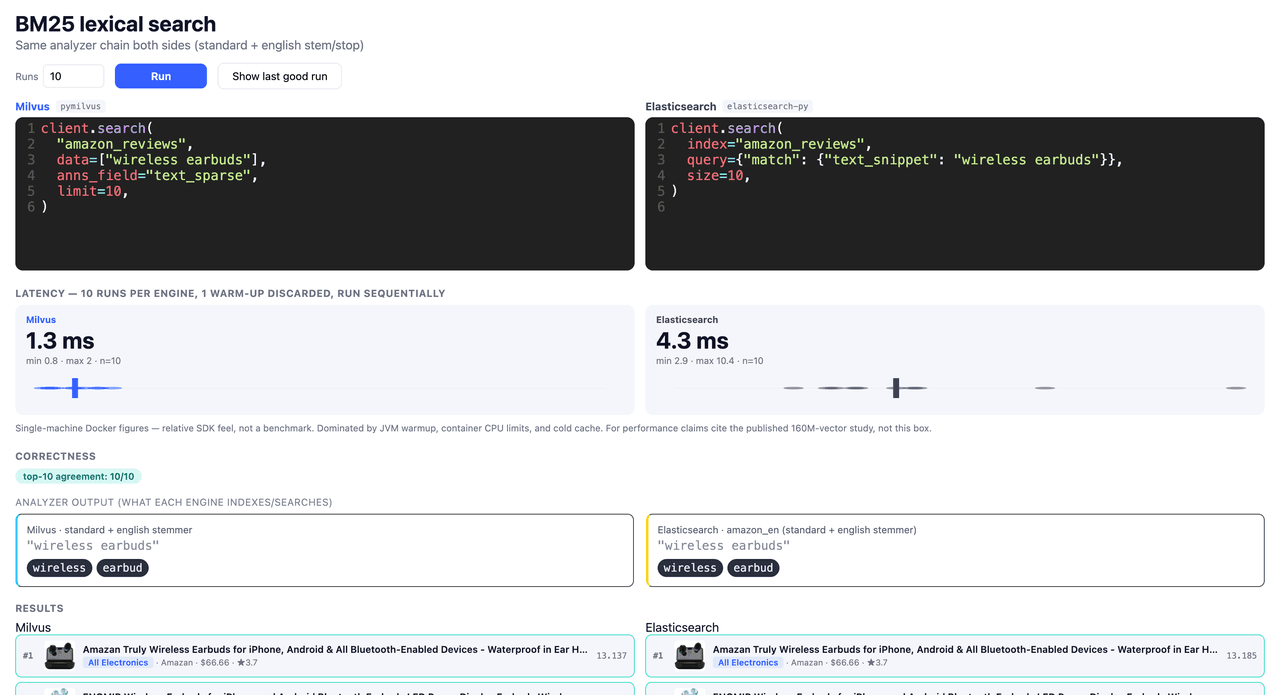
Mesmo top-10, concordância total no conjunto de resultados e Milvus um pouco mais rápido na maioria das vezes. A diferença está por baixo: o índice BM25 do Milvus — criado para a Zilliz Cloud e depois contribuído de volta ao open source — é cerca de 3× menor do que o do Elasticsearch, sem heap de JVM por trás e sem réplica necessária para durabilidade.
Busca híbrida: densa + BM25 com RRF
A busca híbrida precisa fundir resultados densos e lexicais em uma única classificação. No Milvus, ambas as solicitações entram juntas com um ranker de fusão, em uma única chamada:
# Milvus
dense = AnnSearchRequest(
  [qv], "text_vec", SEARCH, limit=50)

sparse = AnnSearchRequest(
  ["wireless earbuds"], "text_sparse", {}, limit=50)

client.hybrid_search(
  "amazon_reviews",
  [dense, sparse],
  ranker=RRFRanker(),
  output_fields=["parent_asin"],
  limit=10,
)
A versão do Elasticsearch parece quase idêntica — dois recuperadores fundidos com rrf:
# Elasticsearch
sparse = {"standard": {"query": {
  "match": {"text_snippet": "wireless earbuds"}}}}

dense = {"knn": {
  "field": "text_vec", "query_vector": qv,
  "k": 50, "num_candidates": 100}}
client.search( index="amazon_reviews", retriever={"rrf": { "retrievers": [sparse, dense], "rank_window_size": 50, }}, size=10, )
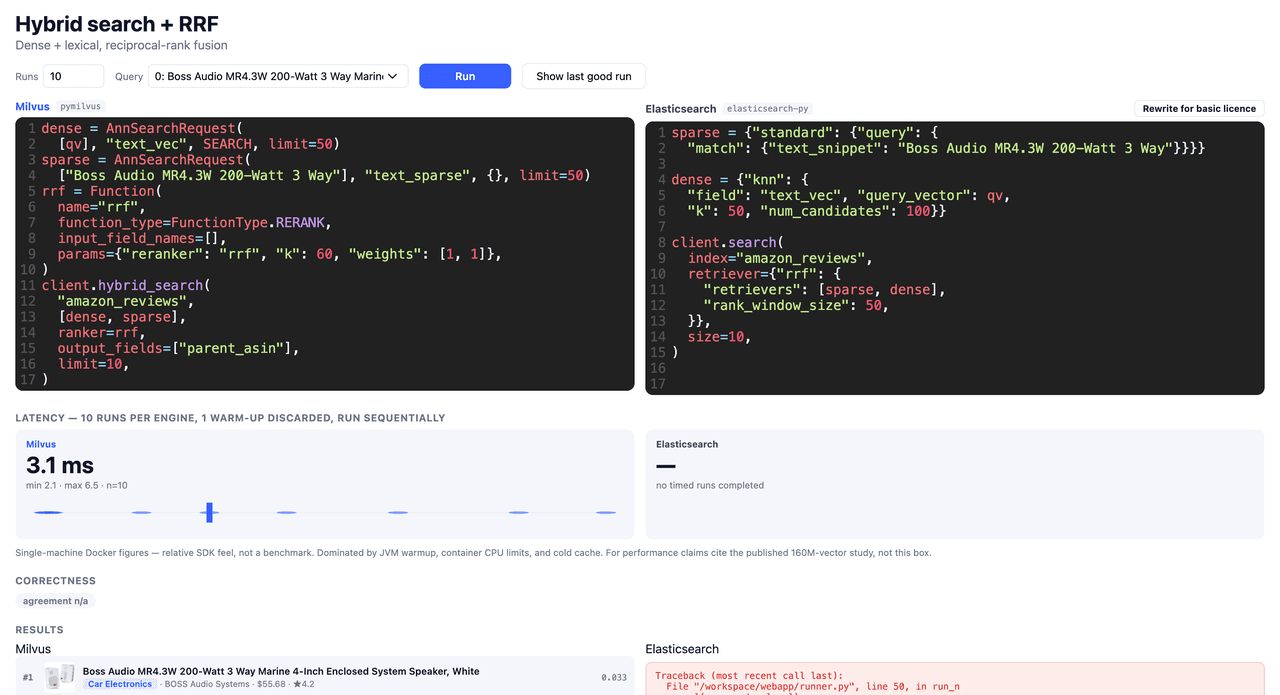
Em um Elasticsearch com licença básica, isso retorna um **403**: `rrf` e `linear` são retrievers do nível Platinum, enquanto o `RRFRanker` e o `WeightedRanker` da Milvus estão na versão gratuita. O caminho gratuito do Elasticsearch exige combinar `knn` e `match` com pesos `boost` ajustados manualmente:
```python
# Reescrita para Elasticsearch, licença básica
client.search(
index="amazon_reviews",
query={"match": {"text_snippet": {
"query": "wireless earbuds", "boost": 0.3}}},
knn={
"field": "text_vec", "query_vector": qv,
"k": 50, "num_candidates": 100, "boost": 0.7,
},
size=10,
)
Esses pesos 0.3/0.7 são o custo real de combinar dois mecanismos: as pontuações BM25 não são limitadas, o cosseno fica entre 0 e 1, então você ajusta os pesos manualmente e os reajusta quando o corpus muda. O RRF evita isso ao combinar por ranking.
Agrupamento: group_by vs collapse
# Milvus
client.search(
  "amazon_reviews",
  data=[qv],
  anns_field="text_vec",
  group_by_field="main_category",
  group_size=1,
  search_params={"params": {"nprobe": 1, "rbq_bits_query": 4}},
  limit=10,
)
# Elasticsearch
client.search(
  index="amazon_reviews",
  knn={
    "field": "text_vec",
    "query_vector": qv,
    "k": 800,
    "num_candidates": 1600,
  },
  collapse={"field": "main_category.keyword"},
  size=10,
)
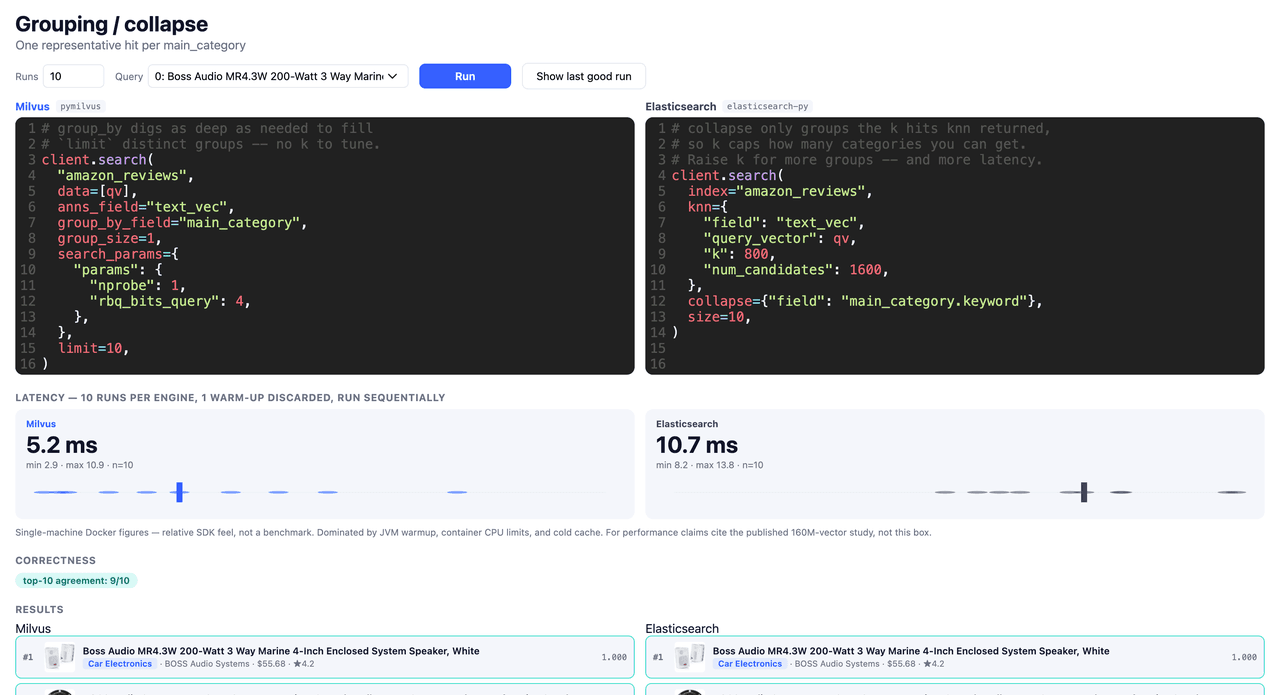
O group_by da Milvus continua lendo até preencher limit grupos distintos. O collapse do Elasticsearch agrupa apenas os k resultados que o kNN já retornou, então k limita quantas categorias você obtém. Para obter mais, você aumenta k e paga pela varredura maior, independentemente. Isso é k=800/num_candidates=1600 contra limit=10: um é completo por construção, o outro só é completo se você buscar dados em excesso o suficiente.
Agregação no servidor
A agregação no servidor é um novo recurso do Milvus 3.0. Ela é usada definindo o(s) campo(s) para agrupar e definindo os campos calculados no array de saída:
# Milvus
client.query(
  "amazon_reviews",
  group_by_fields=["main_category"],
  output_fields=[
    "main_category", "count(*)", "avg(price)",
    "min(price)", "max(price)", "avg(average_rating)",
  ],
  order_by_fields=[{"field": "main_category", "order": "asc"}],
  limit=20,
)
O Elasticsearch tem agregações desde a versão 1.0. Ele é usado definindo seu grupo de agregação e um objeto com os campos calculados de saída:
# Elasticsearch
client.search(
  index="amazon_reviews", size=0, request_cache=False,
  aggs={"by_group": {
    "terms": {
      "field": "main_category.keyword",
      "size": 20,
      "order": {"_key": "asc"},
    },
    "aggs": {
      "avg_price": {"avg": {"field": "price"}},
      "min_price": {"min": {"field": "price"}},
      "max_price": {"max": {"field": "price"}},
      "avg_rating": {"avg": {"field": "average_rating"}},
    },
  }},
)
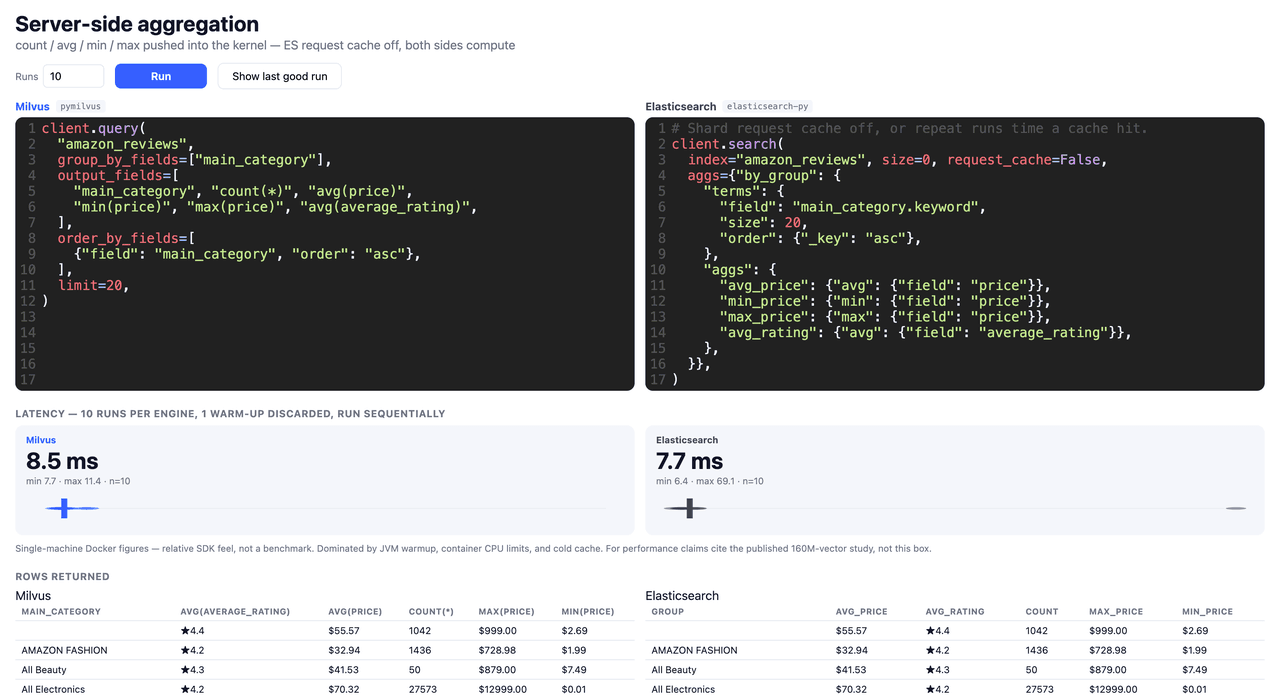
Ambos retornam as mesmas agregações, mas o Elasticsearch é um pouco mais rápido aqui (desativamos o cache de requisição para um teste puro de desempenho de agregação) — sua agregação terms é aproximada quando um campo tem mais valores distintos do que cada shard retorna: os shards enviam de volta apenas seus termos locais principais, então as contagens podem ser subestimadas e o top-N pode estar errado. O Milvus 3.0 calcula agregações exatamente sobre todas as linhas visíveis no momento da consulta. Ele retorna todos os grupos. A agregação no Milvus é nova e ainda está sendo otimizada; se ela for central para sua carga de trabalho, faça benchmarks com seus dados e nos diga quais recursos você precisa.
Reordenação em múltiplos estágios
Muitos casos de uso de busca exigem reordenação e múltiplas etapas, por exemplo, buscar inicialmente os resultados mais relevantes e depois reordenar por avaliações e, por fim, por preço. A reordenação em múltiplas etapas é nova no Milvus 3.0.1 e permite encadear funções de reordenação para alcançar uma lógica de negócios complexa em uma única busca.
# Milvus
l0 = (FunctionChain(FunctionChainStage.L0_RERANK)
  .map("rated", fn.decay(col("average_rating"),
    function="linear", origin=5, scale=4))
  .map("$score", fn.num_combine(col("$score"), col("rated"),
    mode="weighted", weights=[1, 0.2])))
# L1 re-scores all 200 by price, keeps 50.
l1 = (FunctionChain(FunctionChainStage.L1_RERANK)
  .map("cheap", fn.decay(col("price"),
    function="gauss", origin=0, scale=30, offset=10))
  .map("$score", fn.num_combine(col("$score"), col("cheap"),
    mode="weighted", weights=[1, 0.2]))
  .sort("$score").limit(50))
# L2: 0.5 -> 1.0 ramp up to 100 reviews, keeps 10.
l2 = (FunctionChain(FunctionChainStage.L2_RERANK)
  .map("proven", fn.decay(col("rating_number"),
    function="linear", origin=1e6,
    offset=1e6 - 100, scale=100))
  .map("$score", fn.num_combine(col("$score"), col("proven"),
    mode="weighted", weights=[1, 0.2]))
  .sort("$score").limit(10))
client.search(
  "amazon_reviews",
  data=[qv],
  anns_field="text_vec",
  function_chains=[l0, l1, l2],
  limit=200,
)
A sintaxe do Elasticsearch é uma matriz de funções de rescore:
# Elasticsearch
client.search(
  index="amazon_reviews",
  query={"function_score": {
    "query": {"knn": {
      "field": "text_vec", "query_vector": qv,
      "k": 200, "num_candidates": 400, "boost": 2}},
    "functions": [{"linear": {"average_rating": {
      "origin": 5, "scale": 4}}, "weight": 0.2}],
    "boost_mode": "sum",
  }},
  rescore=[
    {"window_size": 200, "query": {
      "rescore_query_weight": 0.2,
      "rescore_query": {"function_score": {"functions": [
        {"gauss": {"price": {
          "origin": 0, "scale": 30, "offset": 10}}}]}}}},
    {"window_size": 50, "query": {
      "rescore_query_weight": 0.2,
      "rescore_query": {"function_score": {"functions": [
        {"linear": {"rating_number": {"origin": 1e6,
          "offset": 1e6 - 100, "scale": 100}}}]}}}},
  ],
  size=10,
)
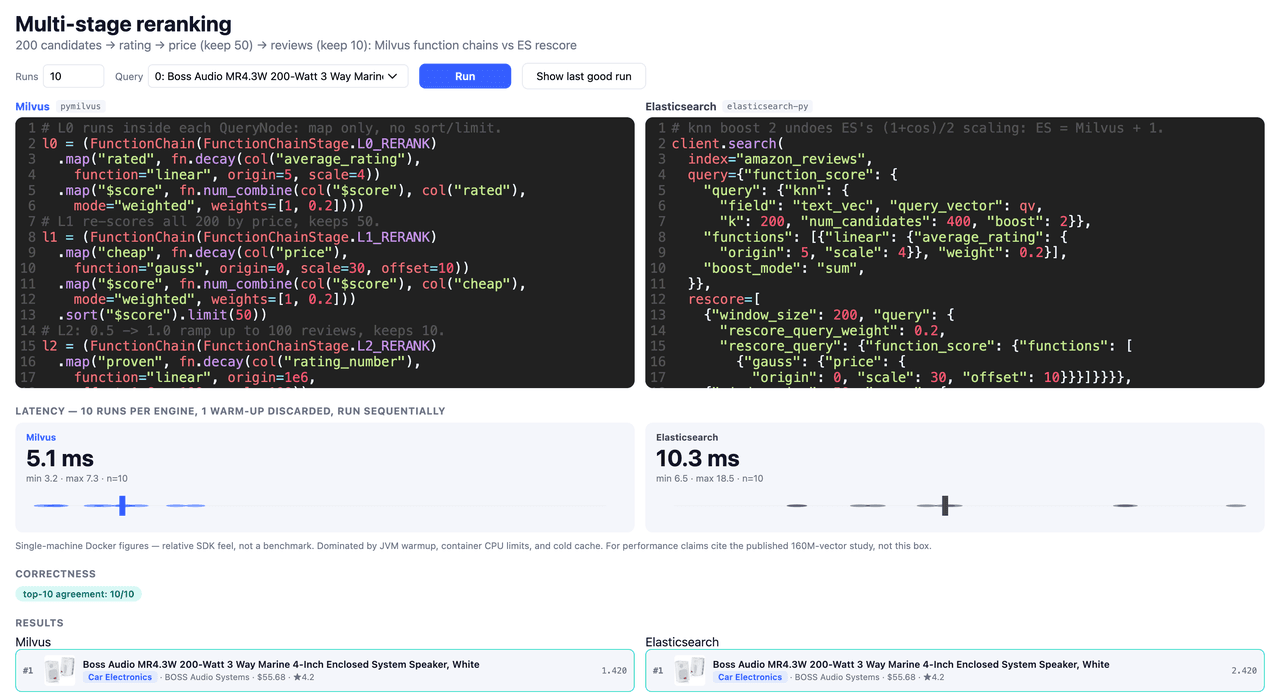
Resumo rápido desta comparação
Ao longo do passo a passo, veja onde cada mecanismo se posiciona:
| Capacidade | Resultado |
|---|---|
| Busca vetorial densa (ANN) | Empate: >0.99 recall@10 |
| Busca de texto completo (BM25) | Empate: mesmos top-10 |
| Busca híbrida (RRF) | Milvus: uma única chamada, RRF na versão gratuita; o Elasticsearch a limita a um plano pago |
| Agrupamento | Milvus: completo por construção; collapse é limitado por k |
| Ordenação, modelagem de relevância, geo, realce | Empate: mesma semântica, sintaxe mais limpa |
| Consumo de memória | Milvus: ~1.0 GB vs ~5 GB nos mesmos dados |
| Agregação no servidor | Elasticsearch: mais rápido hoje; o Milvus o implementou na versão 3.0 e está ajustando |
| Reordenação em múltiplas etapas | Empate: mesmos top-10 |
| Busca tolerante a erros de digitação | Elasticsearch hoje, no roadmap do Milvus |
O Milvus equipara-se ao Elasticsearch nas operações principais de palavra-chave e vetores, vence em busca híbrida, agrupamento e memória, e fica atrás apenas em maturidade das agregações e correspondência difusa (fuzzy), que estão ambas no roadmap. Para as cargas de trabalho que vemos com mais frequência (busca por palavras-chave e semântica, cada vez mais para casos de uso de IA e RAG), o Milvus 3.0 cobre bem os dois lados, a ponto de substituir a stack de dois mecanismos com uma pegada menor. Se sua busca é o clássico BM25 com foco em agregação, avalie esse caminho antes de migrar; para tudo que é híbrido ou com grande volume de vetores em escala, o Milvus deve ser sua primeira escolha.
Mais novidades estão chegando!
Alguns recursos ainda estão no roadmap para futuros lançamentos 3.x: busca tolerante a erros de digitação (fuzzy) e busca enquanto você digita.
Erros de digitação fuzzy. A fuzzy por distância de edição do Elasticsearch captura erros de digitação dos usuários em buscas. No Milvus 3.0, você pode enumerar erros de digitação conhecidos em um filtro de sinônimos ou usar correspondência fuzzy na filtragem, mas a busca fuzzy BM25 de verdade está em breve.
Busca enquanto você digita. Embora atualmente não exista um tipo de consulta de correspondência de prefixo de frase no Milvus, você pode obter uma busca rápida de autocompletar armazenando uma string de sugestão normalizada para cada entidade/documento e adicionando um índice NGRAM ao campo. Você pode então executar consultas LIKE "prefix%" com os caracteres de busca normalizados e obter uma resposta no lado do cliente em menos de 5 ms.
Interessado? Leia mais aqui: https://simonhearne.com/2026/fast-typeahead-milvus/
Execute a comparação você mesmo
docker compose up -d
python data/fetch.py        # one Parquet, ~370 MB
docker compose exec demo python data/load_milvus.py
docker compose exec demo python data/load_es.py
Você vai querer o Docker com pelo menos 16 GB de RAM. O código está em github.com/simonhearne/milvus_es_lab, com um tutorial no YouTube. Carregue seu próprio Parquet para executá-lo com seus dados — é esse o número que importa.
Equipes que já fizeram a mudança
Equipes que executaram dois mecanismos, atingiram um desses limites e migraram para um único mecanismo no Milvus ou no Zilliz Cloud:
123RF (busca de imagens, OpenSearch → Zilliz Cloud): ~200M vetores de ativos de banco de imagens, custo de busca reduzido em mais da metade, latência reduzida pela metade para sub-50ms.
PLAUD (memória de agente, OpenSearch → Zilliz Cloud): 10B+ blocos de memória por região com latência média de recuperação inferior a 200ms, em mais de 2M+ dispositivos.
Rexera (RAG + agentes, Elasticsearch → Zilliz Cloud): a busca híbrida aumentou a precisão da recuperação em ~40% e reduziu o custo em ~50%.
Orfium (correspondência de áudio, Elasticsearch → Zilliz Cloud): ~250M vetores de áudio no Zilliz Cloud, muito além do limite da configuração anterior.
OpenArt (busca multimodal, Elasticsearch → Zilliz Cloud): 456M vetores movidos sem re-embedding; P99 de ~25s para ~300ms, custo de computação reduzido em ~85%.
Os números vêm de cenários de clientes e testes internos; os resultados variam com a escala dos dados, distribuição, parâmetros de índice e configuração. Mais: zilliz.com/customers.
Continue lendo
Announcing the General Availability of Single Sign-On (SSO) on Zilliz Cloud
SSO is GA on Zilliz Cloud, delivering the enterprise-grade identity management capabilities your teams need to deploy vectorDB with confidence.
Zilliz Cloud Audit Logs Goes GA: Security, Compliance, and Transparency at Scale
Zilliz Cloud Audit Logs are now GA, giving enterprises real-time visibility, compliance-ready trails, and stronger security across AWS, GCP, and Azure.
Zilliz Cloud Introduces Advanced BYOC-I Solution for Ultimate Enterprise Data Sovereignty
Explore Zilliz Cloud BYOC-I, the solution that balances AI innovation with data control, enabling secure deployments in finance, healthcare, and education sectors.