CouchbaseとValdの比較:AIアプリケーションに適したベクターデータベースの選択
ベクターデータベースとは?
CouchbaseとValdを比較する前に、まずベクターデータベースの概念を探ってみましょう;
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするために設計されています。これは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品の属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLM)の性能を向上させる技術であるRAG(Retrieval Augmented Generation) において重要な役割を果たす。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Couchbaseは分散マルチモデルNoSQL文書指向データベースで、アドオンとしてベクトル検索機能を備えており、Valdは専用に構築されたベクトルデータベースである。
Couchbase**とは?概要
Couchbaseは、クラウド、モバイル、AI、エッジコンピューティング向けの分散型オープンソースNoSQLデータベースです。リレーショナルデータベースの長所とJSONの柔軟性を兼ね備えている。Couchbaseは、ネイティブのベクトルインデックスを持たないにもかかわらず、ベクトル検索も可能だ。開発者は、ベクトル埋め込み-機械学習モデルによって生成された数値表現-をJSON構造の一部としてCouchbaseドキュメント内に保存できる。これらのベクトルは、高次元空間で互いに近いデータポイントを見つけることが重要であるセマンティック検索に基づく推薦システムや検索拡張生成などの類似検索のユースケースで使用することができます。
Couchbaseでベクトル検索を行う1つの方法は、全文検索(FTS)を使用することです。FTSはテキスト検索用に設計されていますが、ベクトルデータを検索可能なフィールドに変換することで、ベクトル検索に使用することができます。例えば、ベクトルはテキストのようなデータにトークン化することができ、FTSはそれらのトークンに基づいてインデックスを作成し、検索することができます。これにより、近似的なベクトル検索が可能になり、類似性の近いベクトルを持つ文書を照会することができる。
別の方法として、開発者は生のベクトル埋め込みをCouchbaseに保存し、アプリケーションレベルでベクトルの類似度計算を行うことができます。これは、ドキュメントを取得し、ベクトル間のコサイン類似度やユークリッド距離などのメトリックを計算し、最も近い一致を見つけることを意味します。この方法では、Couchbaseはベクトルのためのストレージとして使用され、アプリケーションが計算を処理します。
より高度なユースケースのために、一部の開発者は、ベクトル検索を可能にする特殊なライブラリやアルゴリズムとCouchbaseを統合しています。これらの統合により、Couchbaseはドキュメントストアを管理し、外部ライブラリは実際のベクトル比較を行う。この方法では、Couchbaseはまだベクトル検索を行うソリューションの一部であることができます。
これらのアプローチを使用することで、Couchbaseはベクトル検索機能に使用することができ、類似検索を必要とする様々なAIや機械学習のユースケースに柔軟に対応することができる。
Vald**とは?概要
Vald は膨大なベクトルデータを高速に検索するための強力なツールです。何十億ものベクトルを扱えるように作られており、ニーズが大きくなれば簡単に拡張できます。Vald の素晴らしいところは、NGT と呼ばれる超高速アルゴリズムを使って類似ベクトルを見つけることです。
Valdの最も優れた特徴の一つは、インデックスの処理方法です。通常、インデックスを作成する場合、すべてを停止しなければならない。しかし、Valdは賢い。インデックスを異なるマシンに分散させるので、インデックスが更新されている間も検索を続けることができる。さらに、Valdはインデックス・データを自動的にバックアップするので、何か問題が発生してもすべてを失う心配はない。
Valdは様々なセットアップにフィットするのが素晴らしい。データの出入りをカスタマイズできるので、gRPCとの相性も良い。また、クラウド上でスムーズに動作するように構築されているため、必要なときにコンピューティングパワーやメモリを簡単に追加することができる。Valdはデータを複数のマシンに分散させるので、膨大な量の情報を処理するのに役立つ。
Valdが持つもうひとつの巧妙なトリックは、インデックスの複製だ。各インデックスのコピーを異なるマシンに保存する。つまり、1台のマシンに問題が発生しても、検索は問題なく行えるということだ。Valdは自動的にこれらのコピーのバランスをとるので、心配する必要はない。これらのことから、Valdは大量のベクターデータを迅速かつ確実に検索する必要がある開発者にとって、確かな選択肢となる。
ベクター検索におけるCouchbaseとValdの選択
ベクター検索ツールを選択する際、CouchbaseとValdのようなオプションの主な違いを理解することは非常に重要です。この比較は、特定のニーズに基づいた情報に基づいた決定を行うのに役立ちます。
検索方法
Couchbaseはネイティブではベクトル検索をサポートしていませんが、それに適応させることができます。ベクトルデータを検索可能なフィールドに変換することで、全文検索(FTS)機能を使うことができる。あるいは、生のベクトル埋め込みを保存し、アプリケーションレベルで類似度計算を行うこともできる。
一方、Valdはベクトル検索専用に作られている。NGT アルゴリズムを使用し、数十億のベクトルを高速かつ効率的に類似検索します。
データの取り扱い
Couchbaseは構造化データや半構造化データの管理に優れている。JSONベースのドキュメントモデルを使用しており、ベクトル埋め込みを含む様々なデータタイプを柔軟に格納できる。
Valdは主にベクトルデータに焦点を当てている。大量の高次元ベクトルを効率的に扱い、検索できるように設計されている。
スケーラビリティとパフォーマンス
Couchbaseは水平スケーリングを提供し、分散クラスタ間で大規模なデータセットを扱うことができる。しかし、ベクトル検索では、選択した実装方法によってパフォーマンスが異なる場合があります。
Valdはベクトルデータの高いスケーラビリティとパフォーマンスのために構築されている。数十億のベクトルを扱うことができ、更新中でもパフォーマンスを維持するために分散インデックスを使用している。
柔軟性とカスタマイズ
Couchbaseは、データモデリングとクエリに広範な柔軟性を提供します。必要に応じて外部ライブラリと統合し、ベクトル検索の実装方法をカスタマイズできます。
Valdはデータの入出力やgRPCとの統合にカスタマイズオプションを提供する。ベクトル検索に重点を置いているため、他のデータ型に対する柔軟性が制限される可能性がある。
統合とエコシステム
Couchbaseは幅広いエコシステムを持っており、特にNoSQLやドキュメントデータベースの分野で、様々なツールやフレームワークとうまく統合しています。
Valdはクラウド環境とgRPCでうまく動作するように設計されているが、そのエコシステムはCouchbaseに比べてより限定的かもしれない。
使いやすさ
Couchbaseは、その幅広い機能セットのため、学習曲線がより急です。ベクトル検索を実装するには、追加のセットアップと潜在的なカスタムコードが必要です。
ベクトル検索を専門とするValdは、この特定の目的のために設定し、使用する方が簡単かもしれません。しかし、ドキュメンテーションやコミュニティサポートはCouchbaseより充実していないかもしれない。
コストの考慮
Couchbaseはオープンソース版とエンタープライズ版の両方を提供している。コストは、デプロイの規模やサポートの必要性によって異なります。
Valdはオープンソースであるため、初期費用を抑えることができる。しかし、システムの管理とスケーリングのための運用コストを考慮してください。
セキュリティ機能
Couchbaseは、暗号化、認証、およびきめ細かいアクセス制御を含む堅牢なセキュリティ機能を提供します。
Valdのセキュリティ機能は、アクセス制御や暗号化よりも、主にデータ配布やバックアップに重点を置いており、包括的とは言えないかもしれない。
それぞれを選択する場合
Couchbaseは、複数のデータ型やベクトル検索以外のオペレーションを扱えるデータベースが必要な場合。他のデータベース機能と共にベクトル検索を実装する必要がある場合。暗号化、認証、きめ細かいアクセス制御などの強固なセキュリティ機能が必要な場合。NoSQLやドキュメントデータベースの分野で、様々なツールやフレームワークと統合したい場合。
スケールの大きな効率的なベクトル検索が必要な場合。何十億もの高次元ベクトルを扱い、検索する必要がある場合。ベクトル演算に高いパフォーマンスとスケーラビリティが必要な場合。インデックス更新中も検索を継続できるシステムが必要な場合。
結論
Couchbaseは柔軟性があり、幅広い機能を備えている。構造化データ、半構造化データを得意とし、多くのカスタマイズオプションと強固なセキュリティを持っている。完全なデータベースソリューションでありながら、ベクトル検索のニーズに適応できるため、多くのユースケースに適している。
Valdはベクトル検索に特化している点が優れている。数十億のベクトルにも容易に対応できます。分散インデックスと自動バックアップは、ベクトル検索操作の高いパフォーマンスと信頼性を意味します。
CouchbaseとValdのどちらを選択するかは、あなたのニーズ次第です。扱うデータの種類、ベクトル操作の規模、既存のインフラ、チームの専門知識を考慮してください。ベクトル検索が可能な多目的データベースが必要であれば、Couchbaseが適しているかもしれない。大規模で高性能なベクトル検索を優先するのであれば、Valdの方が良いかもしれない。ユースケース、パフォーマンスニーズ、長期的な目標を評価し、プロジェクトに適した選択をしてください。
この記事ではCouchbaseとValdの概要を説明したが、特定のユースケースに基づいてこれらのデータベースを評価することが重要である。このプロセスを支援するツールの1つが、ベクターデータベースのパフォーマンスを比較するために設計されたオープンソースのベンチマークツールであるVectorDBBenchです。最終的には、特定のデータセットとクエリパターンを使った徹底的なベンチマークが、分散データベースシステムにおけるベクトル検索に対する、強力でありながら異なる2つのアプローチの間で、十分な情報に基づいた決断を下すために不可欠となる。
オープンソースのVectorDBBenchを使って、ベクターデータベースを自分で評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのために設計されたオープンソースのベンチマークツールです。このツールにより、ユーザは独自のデータセットを用いてMilvusやZilliz Cloud(マネージドMilvus)などの異なるベクトルデータベースシステムの性能をテスト・比較し、ユースケースに最も適したものを決定することができます。VectorDBBenchを使用することで、ユーザーはマーケティング上の主張や逸話的証拠に頼るのではなく、実際のベクトルデータベースのパフォーマンスに基づいて情報に基づいた決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースの性能を簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: Open-Source Vector Database Benchmark Tool](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
How Zilliz Saw the Future of Vector Databases—and Built for Production
An inside look at how Zilliz built vector databases for real-world use, focusing on scalability, stability, and running them reliably at scale.
Similarity Metrics for Vector Search
Exploring five similarity metrics for vector search: L2 or Euclidean distance, cosine distance, inner product, and hamming distance.
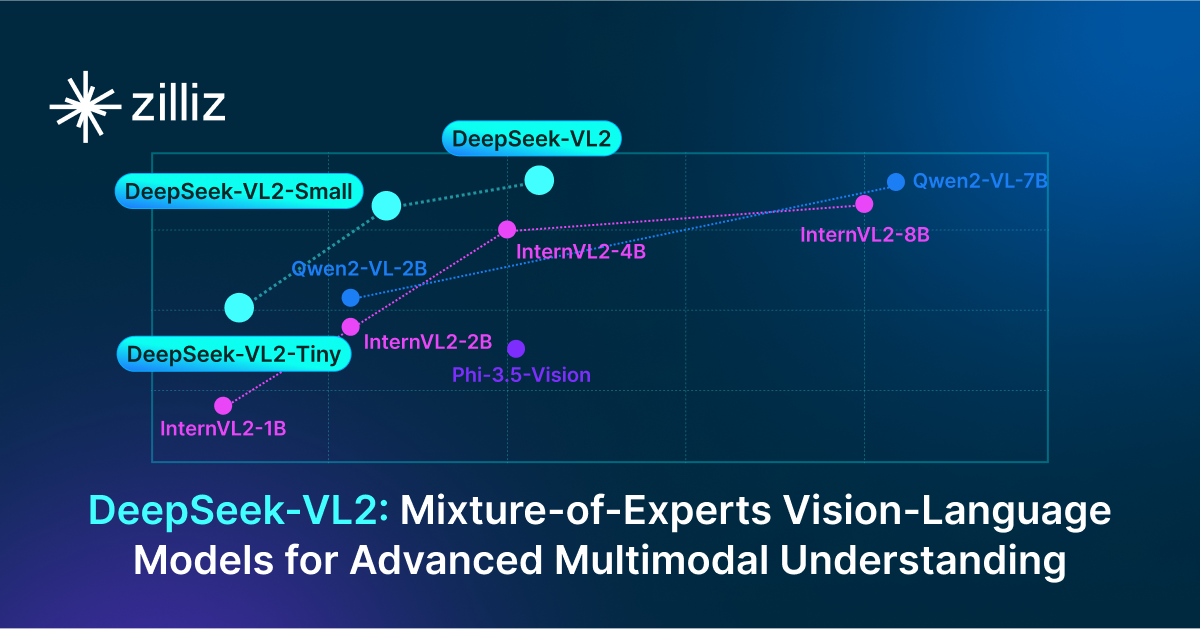
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.