




Apache Cassandra vs Weaviate:AIアプリケーションに適したベクターデータベースを選ぶ
#はじめに
人工知能がデータ主導の世界を再定義し続ける中、ベクトル埋め込みなどの複雑なデータ構造を扱える堅牢なベクトルデータベースの必要性がますます明らかになってきています。このブログでは、2つの注目すべきデータベースを紹介し、比較します:Apache CassandraとDeep Lakeだ。それぞれ、AIアプリケーションに不可欠なベクトル埋め込みを扱うための特徴的なアプローチを提供しています。
ベクターデータベースとは?
Apache CassandraとWeaviateを比較する前に、まずベクターデータベースの概念を探ってみよう。
ベクトル・データベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするために設計されています。ベクトルは、非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または機械学習モデルを使用した製品属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースは、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなど、多くのユースケースで採用されている。また、AI 幻覚のような問題を軽減するために外部知識を提供することによって、大規模言語モデル (LLMs)の性能を向上させる技術であるRetrieval Augmented Generation (RAG)でも重要な役割を果たしている。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 伝統的なデータベース** ** Apache Cassandraのようなベクトル検索アドオン付き。
Apache Cassandraを理解する
Apache Cassandra](https://cassandra.apache.org/doc/latest/)はオープンソースの分散型NoSQLデータベース・システムで、単一障害点のない多数のサーバーで大量のデータを処理できるように設計されています。元々は、多数のノードにまたがる大量の構造化データおよび半構造化データを効率的に処理するために開発された。Cassandraは、高いスケーラビリティ、フォールト・トレランス、ダウンタイムやパフォーマンスの低下を最小限に抑えて分散環境で動作する能力で知られています。
Cassandra 5.0](https://cassandra.apache.org/doc/latest/cassandra/vector-search/concepts.html)のリリースにより、Apache CassandraはNoSQLデータベースとしてのコア機能を超えて、ベクトル埋め込みとベクトル検索をサポートするように進化しています。Cassandraのベクトル検索機能は、既存のアーキテクチャに基づいて構築されています。これにより、ユーザーはベクトル埋め込みを他のデータと一緒に保存し、類似検索を実行できる。この統合により、Cassandraは大規模な分散データを扱う強みを維持しながら、AI主導のアプリケーションをサポートすることができる。
Cassandraのベクトル検索の重要なコンポーネントは、Storage-Attached Indexes(SAI)です。SAIは非常にスケーラブルでグローバルに分散されたインデックスで、あらゆるベクトル・データ型の列に列レベルのインデックスを追加します。ベクトル検索やその他の検索インデックスを使用するデータベースに比類ないI/Oスループットを提供します。SAIは広範なインデックス機能を提供し、クエリとコンテンツ(文書、単語、画像などの大規模な入力を含む)の両方にインデックスを付けてセマンティクスを取得することができます。
Vector Searchは、SAIの新しいモジュール性を活用した、SAIの拡張性を検証する最初の事例です。このVector SearchとSAIの組み合わせは、AIと機械学習のワークロードを処理するCassandraの機能を強化し、ベクトル・データベース分野における強力な候補となる。
Weaviate概要とコア・テクノロジー
Weaviateは、AIアプリケーション開発を簡素化するために設計されたオープンソースのベクトルデータベースです。ビルトインのベクトルおよびハイブリッド検索機能、機械学習モデルとの容易な統合、データプライバシーへの配慮を提供します。これらの機能は、様々なスキルレベルの開発者がAIアプリケーションをより効率的に作成、反復、拡張できるようにすることを目的としています。
Weaviateの強みの一つは、高速かつ正確な類似検索である。HNSW(Hierarchical Navigable Small World)インデックスを使用し、大規模データセットでのベクトル検索を可能にしている。Weaviateはまた、ベクトル検索と従来のフィルタを組み合わせることもサポートしており、意味的類似性と特定のデータ属性の両方を活用した強力なハイブリッドクエリを可能にしている。
Weaviateの主な特徴は以下の通り:
1.PQ 圧縮による効率的な保存と検索 2.BM25検索とベクトル検索の間を調整するアルファ・パラメータを持つハイブリッド検索。 3.エンベッディングとリランキング用のプラグインを内蔵しており、開発が容易。
Weaviateは、開発者がベクトル検索を試すためのエントリー・ポイントである。簡単なセットアップと十分に文書化されたAPIにより、開発者に優しいアプローチを提供する。GenAIエコシステムと深く統合されているため、小規模なプロジェクトや概念実証に適している。Weaviateの対象者は、AIアプリケーションを構築するソフトウェアエンジニア、大規模データセットを扱うデータエンジニア、機械学習モデルを展開するデータサイエンティストである。Weaviateは、セマンティック検索、推薦システム、コンテンツ分類、その他のAI機能を簡素化します。
Weaviate は水平方向に拡張できるように設計されており、クラスタ内の複数のノードにデータを分散することで、大規模なデータセットや高負荷のクエリを処理できる。マルチモーダルデータをサポートし、使用するベクトル化モジュールに応じて様々なデータタイプ(テキスト、画像、音声、動画)を扱うことができる。WeaviateはRESTful APIとGraphQL APIの両方を提供しており、開発者が柔軟にデータベースとやり取りできるようになっている。
しかし、大規模なプロダクション環境においては、いくつかの留意点がある:
1.エンタープライズグレードのセキュリティ機能の制限 2.数十億ベクトル・データセットに対するスケーラビリティの潜在的課題 3.新しくリリースされた階層型ストレージ・オプションには手動管理が必要 4.水平方向のスケールアップには、Weaviate のエンジニアのサポートが必要であり、自動的には行えない。
この最後の点は特に注目すべき点である。つまり、組織は事前に計画を立て、スケーリングオペレーションのための時間を割り当て、適切な準備なしにシステムの限界に近づかないようにする必要があるということだ。
主な違い
ベクトル検索にApache CassandraとWeaviateのどちらを選ぶかは、ニーズによって異なります。以下はその違いの内訳です:
検索方法
Apache Cassandra:Cassandraのベクトル検索は、既存のアーキテクチャの上に構築され、Storage-Attached Indexes(SAI)を使用します。これは、ベクトル・データの列レベルのインデックス作成と、データベース内での直接の類似性検索を意味する。構造化データや半構造化データとともにベクトル埋め込みデータを管理し、ハイブリッドなクエリを実行したいユーザーに適している。
Weaviate:Weaviateは、ベクトル類似性検索にHNSW(Hierarchical Navigable Small World)アルゴリズムを採用している。これは大規模なデータセットを高速かつ正確に検索するために最適化されている。ハイブリッド検索は、セマンティック類似性と従来のフィルターを組み合わせ、きめ細かな検索結果を提供する。
要点:ベクトルと従来のデータベース機能を組み合わせる必要がある場合は、Cassandraを選択する。ハイブリッド・オプションによる高度な類似性検索を優先する場合はWeaviateを選択する。
データ
Apache Cassandra:大量の構造化データおよび半構造化データ用に設計されたCassandraは、ベクトル埋め込みを堅牢な分散システムの拡張として扱います。フォールト・トレラントで可用性が高い。
Weaviate:マルチモーダルなデータ(テキスト、画像、音声、動画)をサポートし、非構造化データの扱いに柔軟性が必要なアプリケーションに適しています。モジュール式のベクトル化プラグインにより、さまざまなデータソースとの統合が容易です。
要点:Cassandraは構造化データやハイブリッドなユースケースに適しており、WeaviateはAI駆動アプリケーションの非構造化、マルチモーダルデータに適している。
スケーラビリティとパフォーマンス
Apache Cassandra:リニアなスケーラビリティ、パフォーマンスに影響を与えることなく多数のノードに水平にスケールできる。分散アーキテクチャは大規模な本番環境に適しています。
Weaviate:Weaviateは水平スケーリングをサポートするが、数十億のベクトル・データセットを扱うには手作業による管理と計画が必要になることが多い。このスケーリング処理には、Weaviateのエンジニアのサポートが必要な場合があります。
要点:大規模なプロダクション・システムでシームレスなスケーリングを行うなら、Cassandraの勝利は明らかだ。Weaviateは、小規模なプロジェクトや手作業でスケーリングに介入できるプロジェクトに適しています。
柔軟性とカスタマイズ性
Apache Cassandra:柔軟なスキーマ設計で、多くのワークロードに適している。しかし、ベクトル検索は比較的新しく、特化したベクトル・データベースほどカスタマイズできない。
Weaviate:開発者に優しいAPI(RESTfulとGraphQL)、クエリのカスタマイズが容易。AIユースケースのためのエンベッディングやリランキング用のプラグインが組み込まれている。
**テイクアウェイWeaviateの方がAIや機械学習のユースケース向けにカスタマイズしやすい。
統合とエコシステム
Apache Cassandra:NoSQLの分野で定評があり、データ・エンジニアリング、アナリティクス、ベクトル検索のための多くのツールやフレームワークと統合されている。
Weaviate:GenAIエコシステムの一部であるWeaviateは、AIアプリケーションの構築を容易にするMLフレームワークとのシームレスな接続を持っている。
**テイクアウェイ従来のエンタープライズ・エコシステムでは、Cassandraの方がより多くのインテグレーションがある。WeaviateはAIファーストの開発ワークフローに適している。
ユーザビリティ
Apache Cassandra:強力だが、新しいユーザー、特に分散システムに慣れていないユーザーにとっては学習曲線が急だ。ドキュメントは包括的だが技術的。
Weaviate:Weaviateは使いやすく設計されており、シンプルなセットアップ、直感的なAPI、よく整理されたドキュメントがある。
要点: Weaviateは使いやすく設計されている:分散データベースの経験が豊富であれば、Cassandraの方が良いかもしれない。
コスト
Apache Cassandra:セルフホスト環境ではかなりのリソースを必要とする。AstraDBのようなマネージド・サービスは運用のオーバーヘッドを削減できるが、コストが増加する可能性がある。
Weaviate:小規模なプロジェクトでは導入コストが低いが、データセットが大きくなると運用コストが高くなる。
おわりにコストの予測可能性と大規模なデプロイにはCassandraが良い。Weaviateは小規模なプロジェクトや実験的なプロジェクトに適している。
セキュリティ
Apache Cassandra:エンタープライズ・グレードのセキュリティ:暗号化、RBAC、認証
Weaviate:Weaviate**:エンタープライズ・グレードのセキュリティは遅れており、高度に規制された環境には適していない。
Apache Cassandraを選ぶとき
Apache Cassandraは、高可用性と耐障害性を必要とする大規模分散データ・ワークロード向けです。最近のStorage-Attached Indexes(SAI)を利用したベクトル検索機能は、ベクトル埋め込みと構造化データまたは半構造化データを組み合わせたアプリケーションに最適です。ハイブリッドなクエリ、分散システム全体にわたる低レイテンシー、厳しいセキュリティとスケーラビリティを要求される本番環境を実行する必要がある場合、Cassandraには実証済みのソリューションがあります。数十億のデータ・ポイントを持つエンタープライズ・グレードのシステム向けのリニアなスケーラビリティと堅牢なアーキテクチャを備えています。
Weaviateを選ぶとき
Weaviateは、セマンティック検索、レコメンデーションシステム、マルチモーダルデータを多用するAIファーストのアプリケーションを構築する開発者向けです。ネイティブの HNSW インデキシングにより、高速かつ正確な類似検索、ハイブリッド検索、機械学習ワークフローと統合するための組み込みプラグインを提供します。Weaviateの開発者フレンドリーなAPIとモジュール設計により、小規模から中規模のデータセットに対するプロトタイピングとデプロイが容易になります。大規模な配布よりも、使いやすさ、柔軟なクエリ、GenAIツールとの統合が重要な、AIイノベーションに注力するチームに最適です。
結論
Apache Cassandraは、スケール、セキュリティ、多様なワークロードの処理に優れているため、エンタープライズ規模のアプリケーションに最適である。Weaviateは、シンプルさ、AIアプリケーション開発、セマンティック検索に優れているので、小規模から中規模のプロジェクトに最適だ。最終的には、ユースケース、データタイプ、パフォーマンス要件次第だ。ハイブリッド・ワークロード向けの堅牢な分散システムが必要な場合はCassandraを、非構造化データやマルチモーダルデータ向けのAI主導の機能と使いやすさが必要な場合はWeaviateを選択しよう。
Apache CassandraとWeaviateの概要についてはこちらをお読みいただきたいが、これらを評価するには、ユースケースに基づいて評価する必要がある。それに役立つツールの一つが、ベクトルデータベース比較のためのオープンソースのベンチマークツールであるVectorDBBenchだ。最終的には、独自のデータセットとクエリパターンで徹底的なベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力だが異なるこの2つのアプローチのどちらを選択するかの鍵となるだろう。
オープンソースのVectorDBBenchを使ってベクトルデータベースを評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのためのオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)のような異なるベクトルデータベースシステムを独自のデータセットを使ってテストし比較し、自分のユースケースに合うものを見つけることができます。VectorDBBenchを使えば、ユーザーはマーケティング上の主張や伝聞ではなく、実際のベクトルデータベースのパフォーマンスに基づいて決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースの性能を簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: オープンソースベクターデータベースベンチマークツール](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
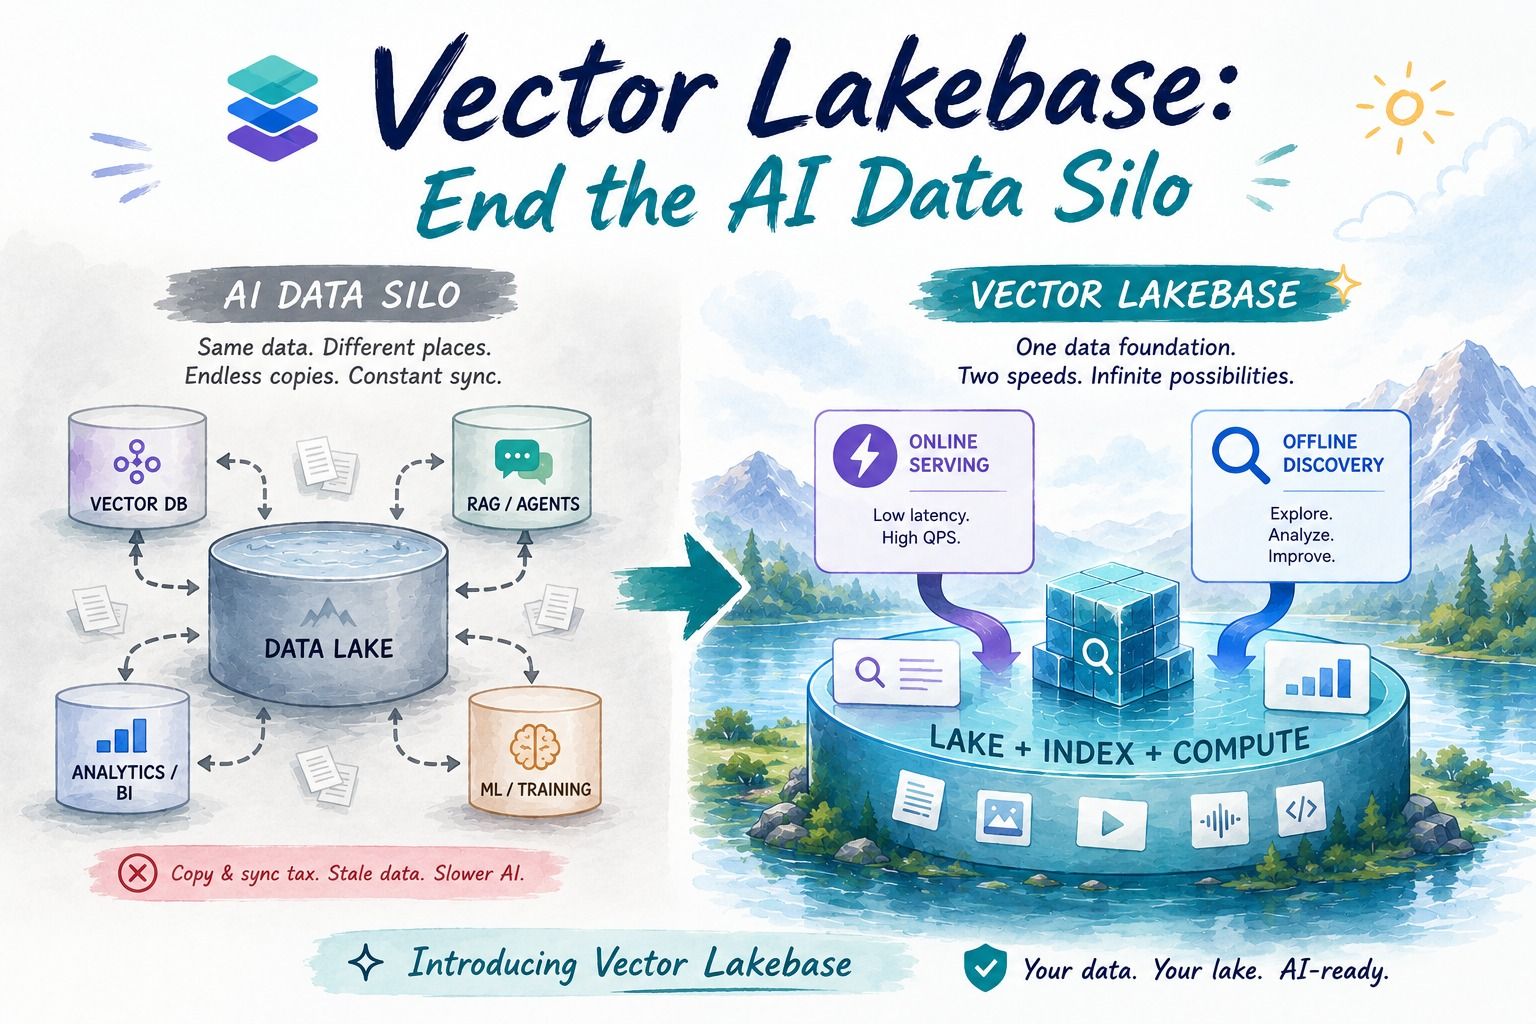
Vector Lakebase: End the AI Data Silo
Learn how Vector Lakebase unifies vector search, data lakes, and AI data operations so teams can serve RAG and agents without copy-and-sync pipelines.
Creating Collections in Zilliz Cloud Just Got Way Easier
We've enhanced the entire collection creation experience to bring advanced capabilities directly into the interface, making it faster and easier to build production-ready schemas without switching tools.
What Exactly Are AI Agents? Why OpenAI and LangChain Are Fighting Over Their Definition?
AI agents are software programs powered by AI that can perceive their environment, make decisions, and take actions to achieve a goal—often autonomously.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.