




Apache CassandraとAerospikeの比較:AIアプリケーションに適したベクターデータベースの選択
AI主導のアプリケーションが普及するにつれ、開発者やエンジニアは、ベクトルデータを効率的に処理する適切なデータベースを選択するという課題に直面している。この分野で人気のある2つの選択肢は、Apache CassandraとAerospikeです。この記事では、ベクターデータベースのニーズを判断するために、これらのテクノロジーを比較します。
ベクターデータベースとは?
Apache Cassandra**とAerospikeを比較する前に、まずベクターデータベースの概念について説明します。
ベクトル・データベース](https://zilliz.com/learn/what-is-vector-database)は、高次元のベクトルエンベッディングを格納し、クエリするために特別に設計されたもので、非構造化データの数値表現です。これらのベクトルは、テキストの意味的な意味、画像の視覚的な特徴、または製品の属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にする。
ベクトルデータベースは、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなど、多くのユースケースで採用されている。また、AI幻覚のような問題を軽減するために外部知識を提供することで大規模言語モデル(LLMs)のパフォーマンスを向上させる技術である、検索拡張生成(RAG)でも重要な役割を果たしている。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Apache Cassandraは伝統的なNoSQLデータベースで、アドオンとしてベクトル検索機能を含むように進化した。Aerospikeは分散型NoSQLデータベースで、ベクトル検索機能を含むように進化している。
Apache Cassandra:概要とコア・テクノロジー
Apache Cassandraは、スケーラビリティと可用性で知られるオープンソースの分散NoSQLデータベースです。Cassandraの特徴には、可用性、拡張性、調整可能な一貫性、柔軟なデータ・モデルのためのマスターレス・アーキテクチャがあります。Cassandra 5.0](https://cassandra.apache.org/doc/latest/cassandra/vector-search/concepts.html)のリリースにより、Storage-Attached Indexes (SAI)機能を通じてベクトル埋め込みとベクトル類似性検索をサポートするようになった。この統合により、Cassandraはベクトル・データを扱えるようになりましたが、ベクトル検索はネイティブ機能ではなく、Cassandraの既存のアーキテクチャの拡張として実装されていることに注意することが重要です。
Cassandraのベクトル検索機能は、既存のアーキテクチャ上に構築されています。これにより、ユーザーはベクトル埋め込みを他のデータと一緒に保存し、類似検索を実行できるようになります。この統合により、Cassandraは大規模な分散データを扱う強みを維持しながら、AI主導のアプリケーションをサポートできるようになる。
Cassandraのベクトル検索の重要なコンポーネントは、Storage-Attached Indexes(SAI)です。SAIは非常にスケーラブルでグローバルに分散されたインデックスで、あらゆるベクトル・データ型の列に列レベルのインデックスを追加します。ベクトル検索データベースやその他の検索インデックスに高いI/Oスループットを提供します。SAIは広範なインデックス機能を提供し、クエリやコンテンツ(文書、単語、画像などの大規模な入力を含む)にインデックスを付けてセマンティクスを取得することができます。
Vector Searchは、SAIの新しいモジュール性を活用し、SAIの拡張性を検証した最初の事例です。このVector SearchとSAIの組み合わせは、AIと機械学習のワークロードを処理するCassandraの機能を強化し、ベクトル・データベース分野における強力な候補となる。
Aerospike概要とコア・テクノロジー
Aerospikeは、高性能なリアルタイムアプリケーション向けに設計された分散NoSQLデータベースである。Aerospikeは、ベクトルインデックスの作成と検索をサポートするように進化し、ベクトルデータベースのユースケースに適しています。このベクトル機能はAerospike Vector Search (AVS)と呼ばれ、現在Previewにあり、ユーザーはAerospikeから早期アクセスをリクエストすることができます。
AVSは、そのベクトル検索機能において、HNSW(Hierarchical Navigable Small World)インデックスのみをサポートしています。AVSで更新や挿入が行われると、ベクトルを含むレコードデータはまずAerospikeデータベース(ASDB)に書き込まれ、すぐに参照できるようになります。インデックスを作成する場合、各レコードには、インデックスの指定されたベクトルフィールドに少なくとも1つのベクトルが含まれていなければなりません。1つのレコードに対して複数のベクトルとインデックスを指定できるため、同じデータに対してさまざまな検索アプローチが可能になります。Aerospikeでは、監視や操作を容易にするために、アップサートされたレコードを特定のセットに割り当てることを推奨しています。
AVSはインデックス構築に対して独自のアプローチを持っており、すべてのAVSノードでインデックスを並行して管理します。ベクトルレコードの更新はASDBに直接コミットされますが、インデックスレコードはインデックス作成キューから非同期に処理されます。この処理はバッチで行われ、すべてのAVSノードに分散されるため、AVSクラスタのCPUコア使用率を最大化し、スケーラブルなインジェストを可能にします。インジェストの性能はホストのメモリとストレージレイヤーの構成に大きく依存します。
インデキシングキュー内の各アイテムについて、AVSはインデキシング用のベクトルを処理し、各ベクトルのクラスタをアセンブルし、これらをASDBにコミットします。インデックスレコードはベクター自体のコピーと、HNSWグラフの与えられたレイヤーにおけるそのベクターに関連するクラスタを含んでいます。インデックスの構築は、単一命令と複数データの並列処理のためにベクトル拡張(AVX)を活用し、効率を高めている。
クラスタ内のレコードは相互に接続されているため、AVSはインジェスト時にクエリを実行し、インデックスキャッシュの「事前水分補給」を行う。これらのクエリはリクエストとして報告されるのではなく、ストレージレイヤーに対する読み込みとして報告される。このアプローチにより、キャッシュに関連データが確実に取り込まれ、クエリのパフォーマンスが向上する可能性があります。これらの機能は、ベクトルデータを扱い、類似検索操作のための効率的なインデックスを構築するAVSのアプローチを示しており、高次元のベクトル検索においてスケーラブルなパフォーマンスを可能にします。
主な相違点
Apache CassandraとAerospikeは、ベクトル検索機能を実装するためのアプローチが異なります。CassandraはStorage-Attached Indexes(SAI)を使ってベクトル検索をコア・データベースに統合しているのに対し、Aerospikeはコア・データベースの上に独立したレイヤー(AVS)として導入しています。この基本的な違いは、インデックス作成手法、データ処理、スケーラビリティ・アプローチ、クエリ最適化手法に影響を与えます。
データ処理とストレージに関して、Cassandraはワイド・カラム・ストア・モデルを活用し、SAIを使用してベクトル・データを他の属性と一緒に格納する柔軟なスキーマ設計を可能にします。Aerospikeはハイブリッド・メモリ・アーキテクチャを採用し、DRAM、SSD、またはその両方にデータを格納します。ベクトル・データはコアのAerospike Database(ASDB)に格納され、インデックス・データはAVSレイヤーで個別に管理されます。
どちらのデータベースもスケーラビリティを提供しますが、強調する点は異なります。Cassandraは書き込み処理にリニアなスケーラビリティを提供し、ベクトル検索のパフォーマンスには分散アーキテクチャを利用している。対照的に、Aerospikeの検索レイヤー(AVS)は、特定のクエリ要件やインジェスト要件に対応するため、ストレージ・レイヤーから独立してスケーリングできる。
また、キャッシュとクエリの最適化に対するアプローチも異なります。Cassandraは既存のキャッシュ・メカニズムを利用し、SAIはベクトル検索に追加の最適化を提供する可能性がある。AerospikeはAVSレイヤーに専用のキャッシング・システムを実装しており、クエリ・パフォーマンスを最適化するためにインジェスト時にインデックス・キャッシュのプリハイドレーションを行います。
これらのベクトル検索機能の成熟度が2つのデータベースで異なることは注目に値する。Cassandraのベクトル検索は、バージョン5.0の時点でコア・データベースの一部であり、本番環境で使用できる安定した機能であることを示している。Aerospikeのベクトル検索(AVS)は現在Previewであり、まだ進化中であり、最終リリースまでに変更が加えられる可能性があることを示唆しています。
結論
Apache CassandraとAerospikeがベクトル検索機能を搭載するように進化したことは、分散データベースが一歩前進したことを意味します。どちらのシステムも、高次元のベクトルデータを効率的に処理したいという需要の高まりに対応しながら、既存の強みを活用する方法でこの課題に取り組んでいます。Cassandraがコアデータベースに直接ベクトル検索を統合したことで、そのエコシステムに慣れ親しんだユーザーにとってシームレスなエクスペリエンスが提供される。対照的に、Aerospikeの専用ベクトル検索レイヤーは、リアルタイム・アプリケーションに高いパフォーマンスを約束する。
ベクトル検索アプリケーションのためにこれら2つのデータベースのどちらを選択するかは、特定のユースケースの要件に大きく依存する。Cassandraの成熟した実装と膨大な量の分散データを扱う能力は、柔軟性とスケーラビリティが最優先される大規模なデプロイメントにとって魅力的だ。ベクトル操作と伝統的なデータベース機能との統合は、複雑なハイブリッドクエリシナリオにとって特に有益である。Aerospikeは、低レイテンシ、高スループットの操作に重点を置いているため、リアルタイムのベクトル検索機能を必要とするユースケースに適しているかもしれない。しかし、プレビュー版であることから、機能セットが進化する可能性がある。
CassandraとAerospikeのどちらを選択するか決める際には、以下のステップを考慮してください:
1.現在と将来のデータ規模と複雑さを評価する。 2.パフォーマンス要件、特にレイテンシーとスループットを評価する。 3.チームの専門知識と各システムへの精通度を考慮する。 4.特定のデータセットとクエリーパターンで概念実証テストを実施する。 5.各システムのベクトル検索機能の成熟度と、本番のタイムラインとの整合性を評価する。
ベクトル検索がAIや機械学習アプリケーションでますます重要になるにつれ、CassandraとAerospikeは実行可能なソリューションとして位置づけられています。しかし、この分野の開発ペースが速いため、これらのテクノロジーは進化し続ける可能性が高い。ベクトル検索のためにこれらのデータベースのいずれかを検討している組織は、現在のニーズと将来のスケーラビリティ要件、およびベクトル検索技術の進歩の可能性を評価する必要があります。
本記事ではCassandraとAerospikeの概要を説明しますが、これらのデータベースを特定のユースケースに基づいて評価することが極めて重要です。このプロセスを支援するツールの1つが、ベクターデータベースのパフォーマンスを比較するために設計されたオープンソースのベンチマークツールであるVectorDBBenchです。最終的には、特定のデータセットとクエリパターンで徹底的なベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力でありながら異なるアプローチであるこの2つの間で、十分な情報に基づいた決断を下すために不可欠となります。
オープンソースのVectorDBBenchを使って、ベクターデータベースを自分で評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのために設計されたオープンソースのベンチマークツールです。このツールにより、ユーザは独自のデータセットを用いてMilvusやZilliz Cloud(マネージドMilvus)などの異なるベクトルデータベースシステムの性能をテスト・比較し、ユースケースに最も適したものを決定することができます。VectorDBBenchを使用することで、ユーザーはマーケティング上の主張や逸話的証拠に頼るのではなく、実際のベクトルデータベースのパフォーマンスに基づいて情報に基づいた決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)**で主流のベクトルデータベースの性能を見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマークベクターデータベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: オープンソースベクターデータベースベンチマークツール](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
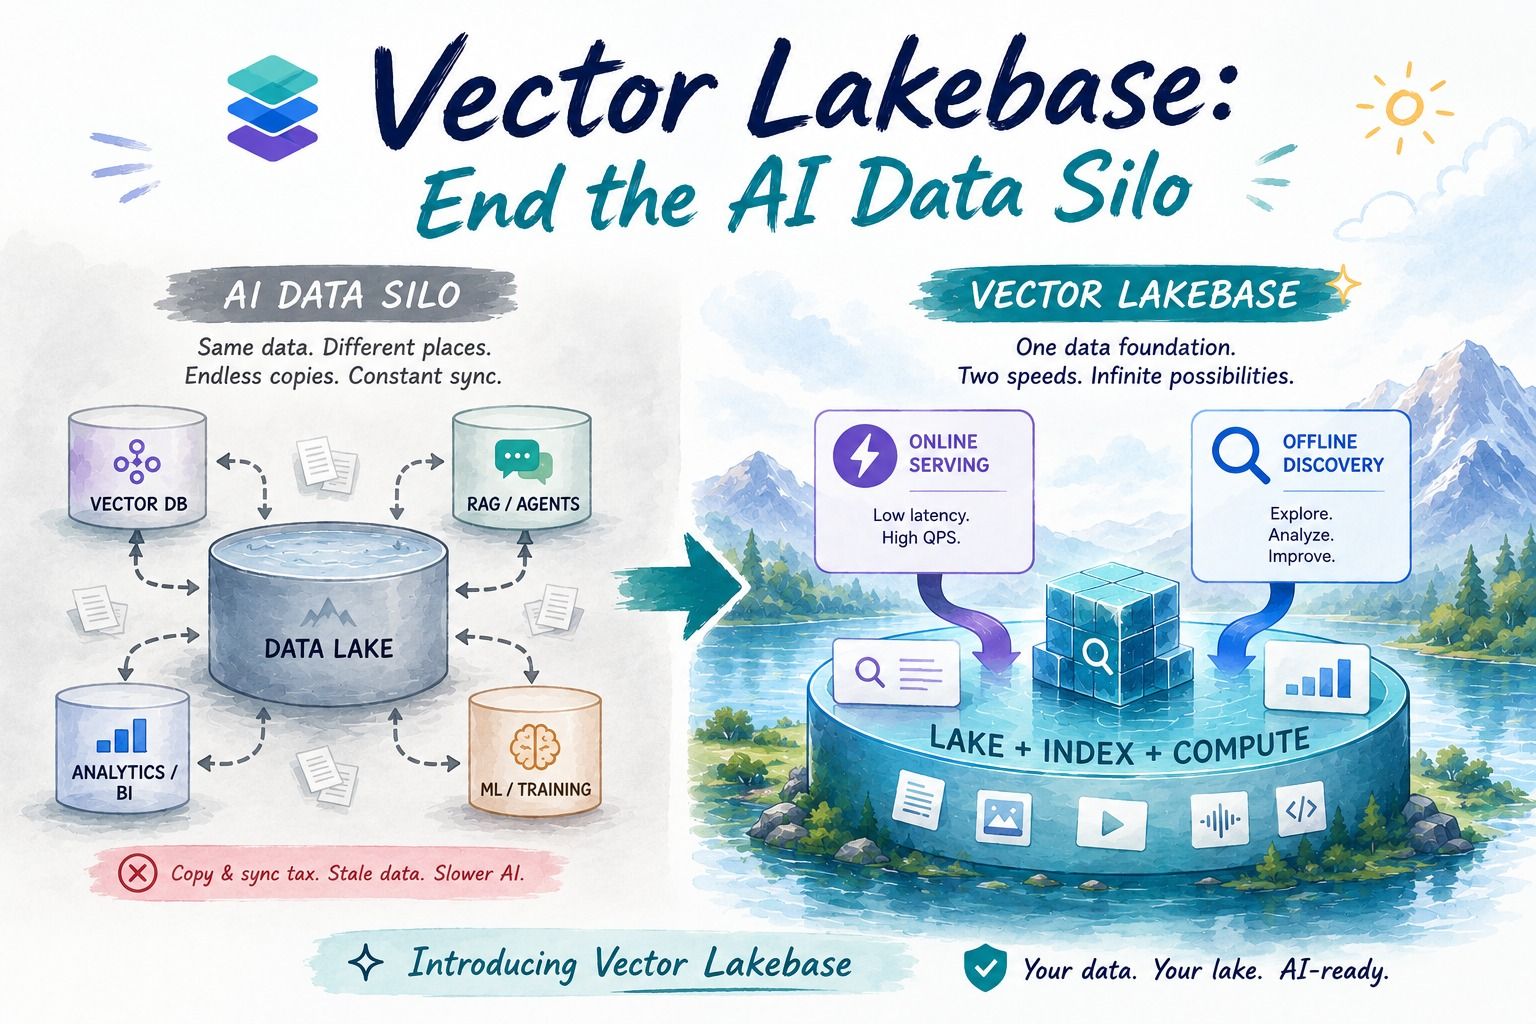
Vector Lakebase: End the AI Data Silo
Learn how Vector Lakebase unifies vector search, data lakes, and AI data operations so teams can serve RAG and agents without copy-and-sync pipelines.
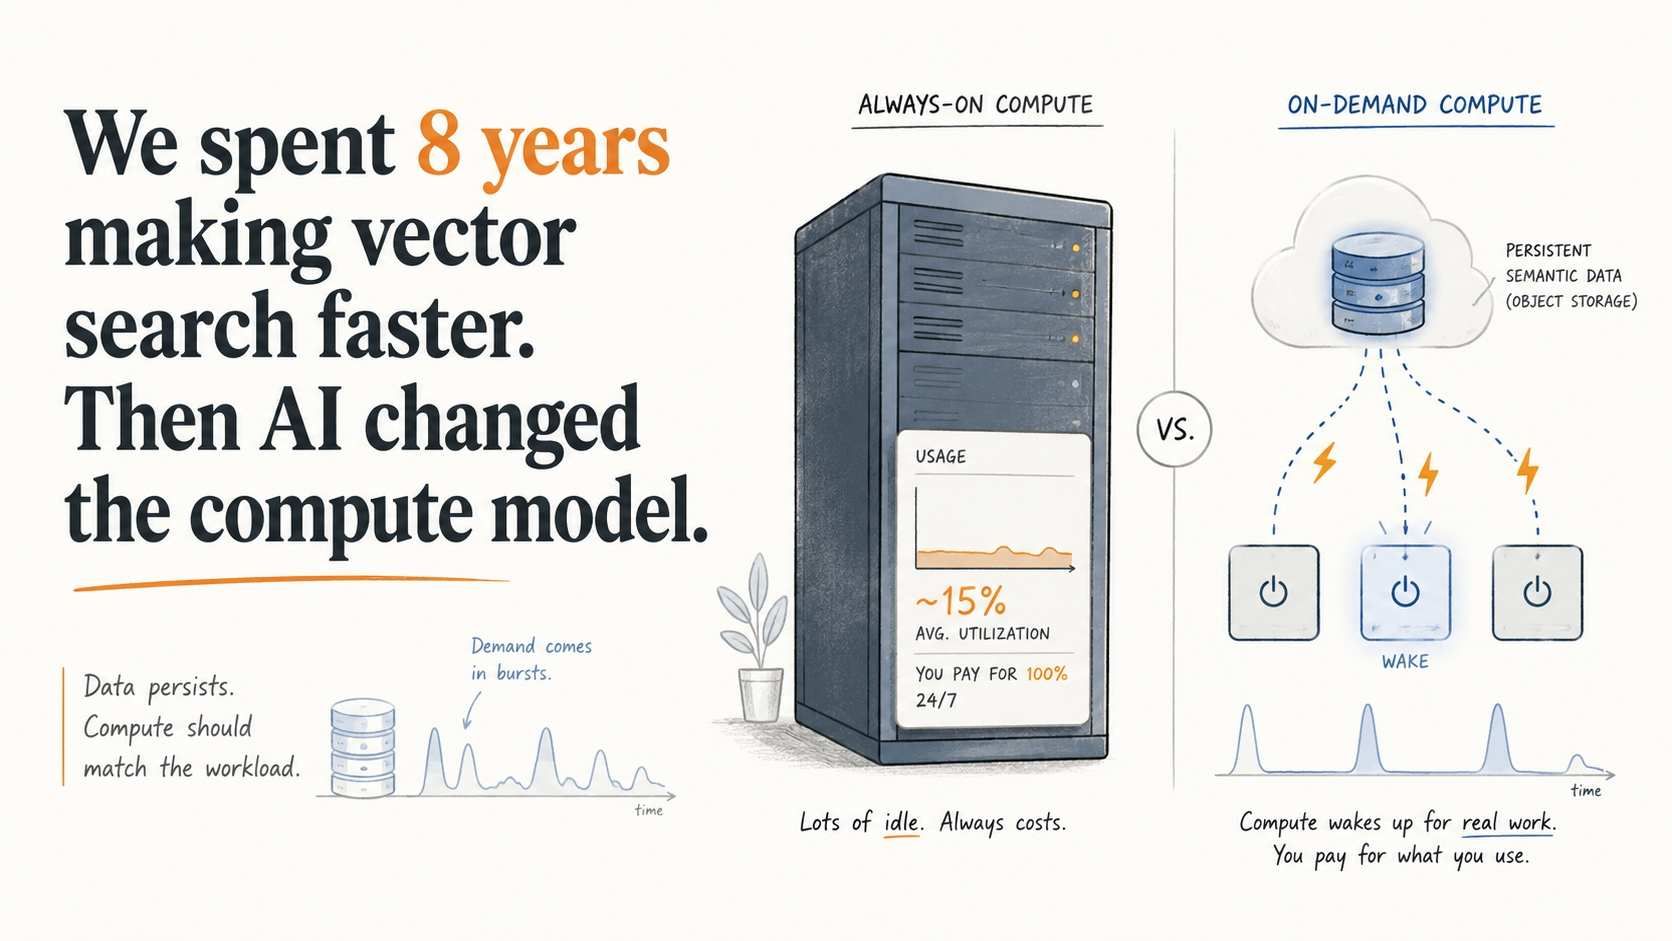
We spent 8 years making vector databases faster. Then we stopped.
Rarely queried embeddings still need to stay searchable. See how Vector Lakebase enables on-demand vector search without always-on compute costs.
Legal Document Analysis: Harnessing Zilliz Cloud's Semantic Search and RAG for Legal Insights
Enhance legal document analysis with Zilliz Cloud’s Semantic Search and RAG. Improve accuracy, efficiency, and scalability for contracts, case law, and compliance.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.