MilvusとOpenAIによるセマンティック検索
このガイドでは、MilvusとOpenAIのEmbedding APIを統合したセマンティック検索機能について、書籍のタイトル検索をユースケース例としてご紹介します。

#はじめに
セマンティック検索(類似検索)は、最近最もエキサイティングなデジタルイノベーションの一つとして静かに注目を集めている。多くの人々はこのコンセプトをよく知らないが、セマンティック検索テクノロジーはグーグルなどの主要な検索エンジンに取り入れられ、eコマースサイトやウェブアプリケーションの数も増えているため、日々その恩恵を受けている。
セマンティック検索](https://zilliz.com/glossary/semantic-search)は、従来の検索方法で単にキーワードを照合するのではなく、クエリの意味的類似性、すなわち類似性をデータポイントと照合することで機能する。これにより、従来のキーワード検索よりも包括的な検索結果が生成される。なぜなら、文字通りに一致する結果だけではなく、検索キーワードに文脈上関連するコンテンツを返すからである。
自然言語を解釈することで、セマンティック検索はアプリケーションがユーザーのクエリの背後にある「意図」をより良く理解し、より良い結果を返すことを可能にします。この効率化により、ユーザーは探しているものをより正確に見つけることができ、時間の節約、フラストレーションの防止、全体的なユーザーエクスペリエンスの向上が可能になります。
このガイドでは、MilvusとOpenAIのEmbedding APIを統合したセマンティック検索機能について、本のタイトル検索をユースケースの例として紹介します。ベクターデータベースへのデータ入力、データセットの埋め込み作成、効率的な検索のためのデータインデックス作成、Milvusへのクエリなど、セマンティック検索アプリケーションの作成方法をステップバイステップで説明します。
前提条件
セマンティック検索アプリケーションを構築する最初のステップは、Milvusのインスタンスを初期化し、OpenAIからエンベッディングAPIキーを取得することです。
Milvusインスタンス](https://milvus.io/docs/install_standalone-docker.md)を実行するには、まずdockerを起動し(dockerがインストールされていない場合は、dockerのドキュメントからダウンロードしてください)、次のようにMilvusをダウンロードして起動します:
wget https://raw.githubusercontent.com/Milvus-io/Milvus/master/scripts/standalone_embed.sh
bash standalone_embed.sh start
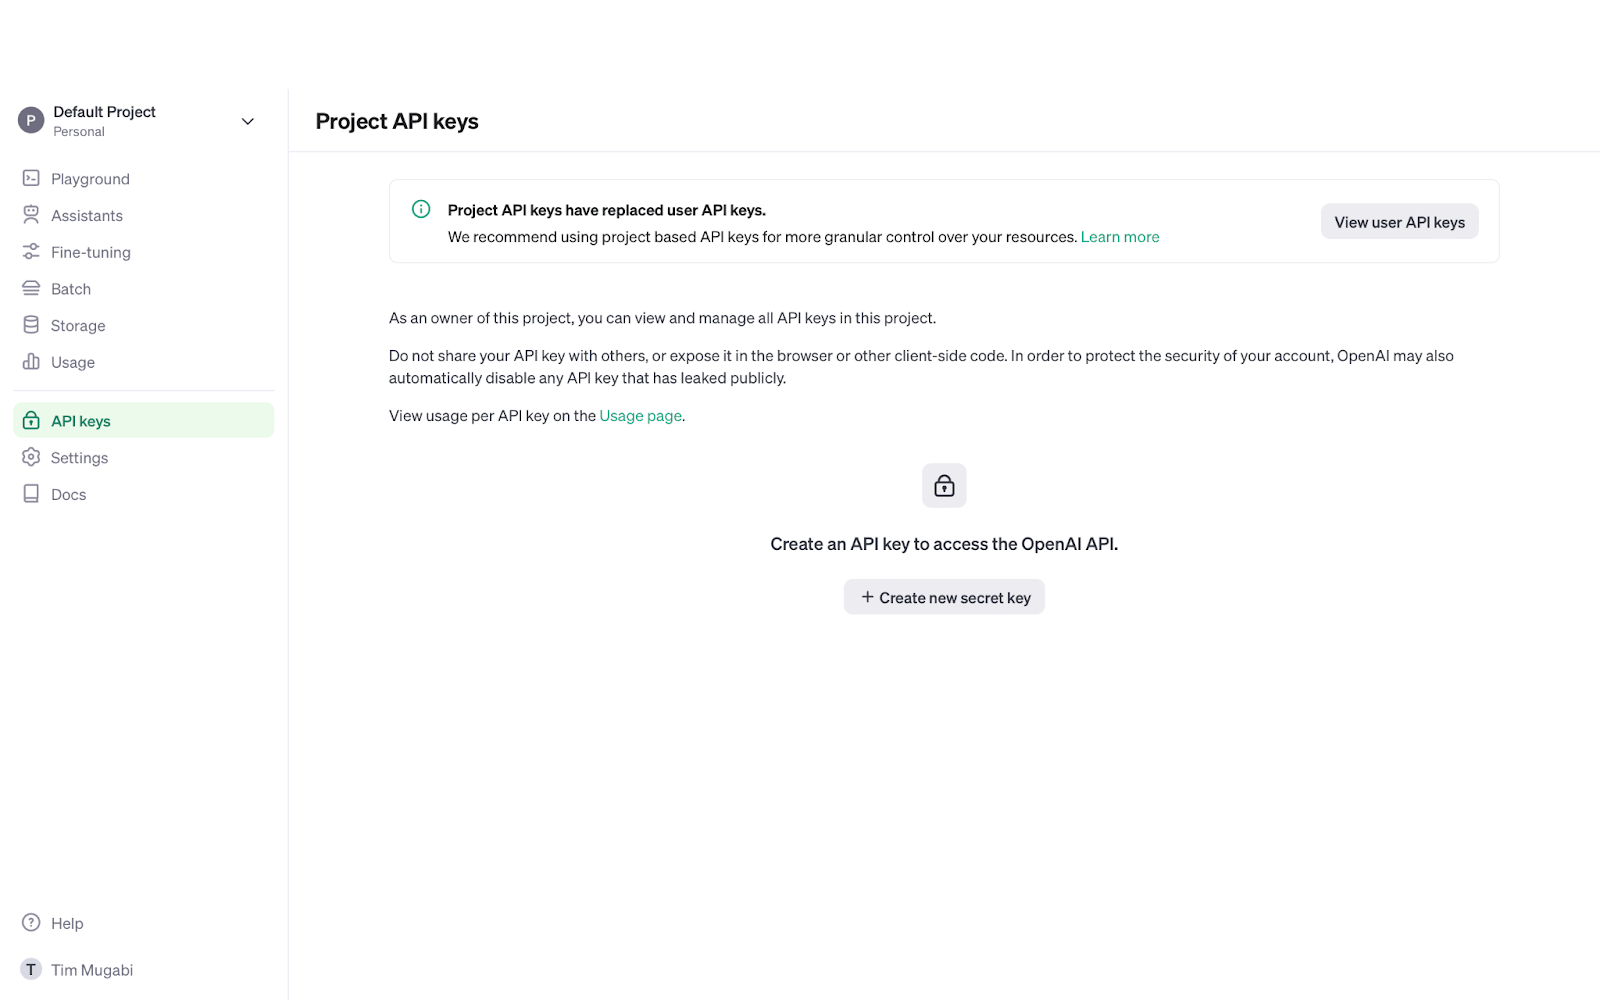
次に、埋め込みAPIキーを取得するために、OpenAIのウェブサイトにアクセスし、アカウントを作成(または既存のアカウントにログイン)して、メニューからAPI Keysを選択し、Create new secret keyボタンをクリックします。
環境のセットアップ
Milvusをダウンロードし、APIキーを取得したら、次は必要なPythonプログラミングパッケージをインストールして開発環境を整えます。
セマンティック検索書籍タイトル検索プロジェクトでは、Milvusデータベースに接続するためのPyMilvus SDKと、エンベッディングAPIに接続するためのOpenAIライブラリをインストールする必要があります。
これは以下のコードで実行できます:
pip install pymilvus openai
ステップ 1: データの準備
環境のセットアップが完了したら、埋め込みとインデックス作成のためにデータを準備しましょう。
この例では、CSVファイルからデータをインポートします。書籍のタイトル検索データが入ったCSVのダウンロードができます。
書名を読み込む関数を作りましょう:
    インポート csv

    def csv_load(file):
    with open(file, newline='') as f:
    reader = csv.reader(f, delimiter=',')
    return [行[1] for 行 in reader].
**ステップ2:埋め込みデータの生成
CSVファイルから書籍のタイトルを読み込んだら、OpenAIのembeddings APIを使って、エンベッディングを生成します。そのためには、先ほど取得したエンベッディングAPIキーが必要です。
ベクトル埋め込みは、機械がデータを解釈し、より効率的に処理するための数学的表現です。各埋め込みは、他の埋め込みとの意味的関連性を決定するために使用される様々な特徴を表す、ある次元数(この場合、text-embedding-3-smallという埋め込みモデルが生成する埋め込み次元数である1536次元)を持っています。
例えば、"The White Tiger "というタイトルでは、"Tiger "という単語は動物であるだけでなく、大型ネコ科動物の一種でもある。さらに、哺乳類であること、4本足であること、縞模様があることなど、他の特徴もエンコードされます。その結果、big cats, animals, mammalsなどに関連するクエリの結果にタイトルが表示されます。
埋め込みモデルは、高次元ベクトル空間におけるベクトル間の距離を測定することで、ベクトル間の類似性を決定します。
OpenAIのエンベッディングAPIを使って、以下のようにエンベッディングを生成することができます:
    インポート openai

    client = OpenAI()
    client.api_key = 'あなたの_api_key_here'.

    def embed(text):
       response = client.embeddings.create(
    input=text、
    model='text-embedding-3-small'
       )
       return response.data[0].embedding
埋め込みモデルとして text-embedding-3-small を選んだのは、OpenAIの埋め込みモデルの中で最もコストとリソース効率が良いからです。 OpenAIのドキュメント](https://platform.openai.com/docs/guides/embeddings) を参照してください。
ステップ3: Milvusによるインデックス作成と検索
埋め込みモデルを生成したら、次はデータセットをベクトルデータベースに挿入します:
1.**コレクションの作成
2.**インデックスの作成
コレクションは、従来のリレーショナルデータベースのテーブルのようなもので、Milvusが保存と管理のためにベクトル埋め込みをグループ化する方法です。コレクションを作成するには、スキーマを定義する必要がある:
ID(自動的に割り当てられるプライマリフィールド)
ブックタイトル
タイトルの埋め込み
コレクションを作成したら、インデックスを作成することができます。インデックスとは、ベクトル間のセマンティックな関連性を事前に計算し、類似した埋め込みをより近くに保存することで、より高速なクエリを可能にするデータ構造です。データインデックスを作成することで、ベクトルデータベースは、類似性を判断するためにすべての埋め込みとクエリを比較する必要がなくなります。
以下のコードスニペットはMilvusにデータセットを挿入し、インデックスを作成します:
    from pymilvus import connections, Collection, FieldSchema, CollectionSchema, DataType

    # Milvusに接続する
    connections.connect(host='localhost', port='19530')

    fields = [
    FieldSchema(name='id', dtype=DataType.INT64, is_primary=True, auto_id=True)、
    FieldSchema(name='title', dtype=DataType.VARCHAR, max_length=255)、
    FieldSchema(name='embedding', dtype=DataType.FLOAT_VECTOR, dim=1536)
    ]
    schema = CollectionSchema(fields, description='本のタイトル')
    コレクション = コレクション(name='book_titles', schema=schema)

    # インデックスを作成する
    index_params = { インデックス・パラメータ
        'index_type': 'IVF_FLAT'、
        'metric_type': 'L2'、
        'params':{'nlist': 1024}.
    }
    collection.create_index(field_name="embedding", index_params=index_params)

    # データの挿入
    collection.insert([{'title': title, 'embedding': embed(title)} for title in collection])
上記のコードスニペットでは、いくつかのパラメータでインデックスを初期化している。最も重要なパラメータは index_type と metric_type である。
インデックスタイプには IVF_FLAT を選んだ。これは速度と精度のバランスが良く、他のデータインデックスタイプよりもメモリ消費量が少ないからだ。IVF_FLATは埋め込みデータが格納されているベクトル空間をいくつかのクラスタ(nlist`パラメータで定義、この場合は1024)に分割し、効率的な近似最近傍(ANN)検索を可能にします。
metric typeはデータのインデックスを作成する際に、[embeddings](https://zilliz.com/glossary/vector-embeddings) 間の類似度を測定するために使用するアルゴリズムを定義します。この例ではL2(ユークリッド距離) を使用します。L2 は IVF_FLAT と同様、効率的で解釈が簡単なので、最も一般的に使用される距離メトリックである。
高度なクエリテクニック
データセットのインデックス付けが完了したので、ベクターデータベースの書籍タイトルをセマンティック検索できるようになりました。
データを埋め込むのと同様に、Milvusがセマンティック検索を実行するためのクエリを埋め込む必要があります。 さらに、データのインデックス作成と同様に、いくつかの検索パラメータを定義する必要があります。L2 の metric type はインデックスのものと一致し、nprobe はクエリ中にベクトルデータベースがいくつのクラスタを検索するかを定義する。 nprobe`の値が大きいほど、より包括的な検索を行うことができるが、計算負荷は高くなる。
最後に output_fields であるが、これは検索操作によって返されるデータを決定する重要なパラメータである。
検索操作の例です:
    collection.load()

    def search(query):
    embedded_query = embed(query)
    search_params = {"metric_type":"L2", "params":{"nprobe":10}}
    results = collection.search([embedded_query], "embedding", search_params, limit=5, output_fields=['score', 'title'])
    結果を返す

    search_term ='自己改善'

        print("Search term" + search_term + ":")
        for result in search(search_term):
            print(result)
以下のような出力が得られるはずだ:
    検索語: 自己啓発
    [ 0.37948882579803467, 'The Road Less Traveled:愛の新しい心理学 伝統的価値観と精神的成長']]
    [0.39301538467407227,'あなたの中のリーダー:友人を獲得し、人々に影響を与え、変化する世界で成功する方法'] [0.39301538467407227
    0.4081816077232361, 『Think and Grow Rich: The Landmark Bestseller Now Revised and Updated for the 21st Century』] [0.40816077232361, 『Think and Grow Rich: The Landmark Bestseller Now Revised and Updated for the 21st Century
    0.4174671173095703, 『グレート・エクスペクテーション』] [0.4174671173095703, 『グレート・エクスペクテーション
    0.41889268159866333, 『ニコマコス倫理学』] [ 0.41889268159866333, 『ニコマコス倫理学
本のタイトルの前にある浮動小数点値は、埋込みのスコア、つまりクエリ埋込みからのデータ点からの距離です。スコアが低いほど、ベクトル間の距離が短く、意味的な関連性が高いことを意味する。
結論
まとめると、MilvusとOpenAIを使ったセマンティック検索アプリケーションの作成手順は以下のようになる:
前提条件: Milvusのインスタンスをインストールして起動し、OpenAIからエンベッディングAPIキーを取得する。
環境のセットアップ:** pymilvusとopenaiライブラリをインストールする。
ステップ1: データの準備:**書籍のタイトルを含むCSVファイルをダウンロードし、ロードする。
ステップ2: エンベッディングの生成:** OpenAI APIを通してベクトルエンベッディングを生成する。
埋め込みデータを挿入するコレクションとインデックスを作成する。
高度なクエリ技術:** ベクターデータベースをクエリする
セマンティック検索は10年以上前から採用されているが、我々はその膨大な可能性の表面をなぞったに過ぎない。AI分野が急速に進歩し続けるにつれて、セマンティック検索機能はより正確で効率的になり、優れたユーザー体験を可能にし、生産性を向上させ、より迅速な意思決定を可能にする。
セマンティック検索に対する理解を深め、特定のユースケースにより適合させるために、エンベッディングモデル、インデクシングタイプ、類似度メトリックなど、様々なパラメータを試してみることをお勧めします。
ベクトルベース、学習言語モデル(LLM)、その他の主要なAIや機械学習の概念については、Zilliz Learn ナレッジベースをご覧ください。
**その他のリソース
ミルバス
Milvusドキュメント](https://milvus.io/docs/quickstart.md)
Milvusコミュニティページ](https://milvus.io/community/)
Milvus GitHub](https://github.com/milvus-io/milvus/discussions)
Milvus Stack Overflow](https://stackoverflow.com/questions/tagged/milvus)
オープンAI
OpenAIドキュメント](https://platform.openai.com/docs/guides/embeddings)
OpenAI開発者フォーラム](https://community.openai.com/)
OpenAI API GitHub】(https://github.com/search?q=org%3Aopenai+discussion&type=discussions)
OpenAI Stack Overflow](https://stackoverflow.com/questions/tagged/milvus)
 Tim MugabiFreelance Technical Writer