




Couchbase vs Vespa AIアプリに適したベクターデータベースの選択
ベクターデータベースとは?
CouchbaseとVespaを比較する前に、まずベクターデータベースの概念を探求してみましょう;
ベクトルデータベース](https://zilliz.com/learn/what-is-vector-database)は、特に高次元のベクトルを格納し、クエリするために設計されています。これは非構造化データの数値表現です。これらのベクトルは、テキストの意味、画像の視覚的特徴、または製品の属性などの複雑な情報をエンコードします。効率的な類似検索を可能にすることで、ベクトルデータベースはAIアプリケーションにおいて極めて重要な役割を果たし、より高度なデータ分析と検索を可能にしている。
ベクトルデータベースの一般的なユースケースには、電子商取引の商品推奨、コンテンツ発見プラットフォーム、サイバーセキュリティにおける異常検知、医療画像分析、自然言語処理(NLP)タスクなどがある。また、AI幻覚のような問題を軽減するために、外部知識を提供することによって大規模言語モデル(LLM)の性能を向上させる技術であるRAG(Retrieval Augmented Generation) において重要な役割を果たす。
市場には、以下のような多くの種類のベクトル・データベースがある:
- Milvus](https://zilliz.com/what-is-milvus)、Zilliz Cloud(フルマネージドMilvus)など。
- Faiss](https://zilliz.com/learn/faiss)やAnnoyのようなベクトル検索ライブラリ。
- Chroma](https://zilliz.com/blog/milvus-vs-chroma)やMilvus Liteのような軽量ベクトルデータベース。
- 小規模なベクトル検索が可能なベクトル検索アドオンを備えた従来のデータベース**。
Couchbaseは分散マルチモデルNoSQLドキュメント指向データベースで、ベクトル検索機能が付加されている。Vespaは専用のベクトルデータベースです。この投稿では、それらのベクトル検索機能を比較する。
Couchbase:概要とコアテクノロジー
Couchbaseは分散型オープンソースのNoSQLデータベースで、クラウド、モバイル、AI、エッジコンピューティング向けのアプリケーション構築に利用できる。リレーショナルデータベースの強みとJSONの汎用性を兼ね備えている。Couchbaseはまた、ベクトルインデックスをネイティブサポートしていないにもかかわらず、ベクトル検索を実装する柔軟性を提供する。開発者は、ベクトル埋め込み-機械学習モデルによって生成された数値表現-をJSON構造の一部としてCouchbaseドキュメント内に格納することができる。これらのベクトルは、高次元空間で互いに近いデータポイントを見つけることが重要であるセマンティック検索に基づく推薦システムや検索拡張生成などの類似検索のユースケースで使用することができます。
Couchbaseでベクトル検索を可能にする1つのアプローチは、全文検索(FTS)を活用することです。FTSは一般的にテキストベースの検索用に設計されていますが、ベクトルデータを検索可能なフィールドに変換することで、ベクトル検索に対応させることができます。例えば、ベクトルをテキストライクなデータにトークン化することで、FTSはそれらのトークンに基づいてインデックスを作成し、検索することができる。これにより、近似ベクトル検索が容易になり、類似性の近いベクトルを持つ文書に問い合わせる方法を提供することができる。
あるいは、開発者は生のベクトル埋め込みをCouchbaseに保存し、アプリケーションレベルでベクトルの類似度計算を実行することができます。これは、ドキュメントを取得し、ベクトル間のコサイン類似度やユークリッド距離などのメトリックを計算し、最も近い一致を識別することを含む。この方法では、アプリケーションが数学的比較ロジックを処理する間、Couchbaseはベクトルのストレージソリューションとして機能することができます。
より高度なユースケースのために、一部の開発者は、効率的なベクトル検索を可能にする特殊なライブラリやアルゴリズム(FAISSやHNSWのような)とCouchbaseを統合しています。これらの統合は、外部ライブラリが実際のベクトル比較を実行しながら、Couchbaseがドキュメントストアを管理することを可能にします。このように、Couchbaseはまだベクトル検索をサポートするソリューションの一部であることができます。
これらのアプローチを使用することで、Couchbaseはベクトル検索機能を扱うように適応させることができ、類似検索に依存する様々なAIや機械学習タスクのための柔軟な選択肢となる。
Vespa概要とコアテクノロジー
Vespaは強力な検索エンジンとベクトルデータベースで、複数の種類の検索を一度に扱うことができます。ベクター検索、テキスト検索、構造化データによる検索に優れています。つまり、類似したアイテム(画像や商品など)を検索したり、テキスト内の特定の単語を検索したり、日付や数字に基づいて検索結果をフィルタリングしたりすることができます。Vespaは柔軟性があり、単純な数値から複雑な構造まで、さまざまな種類のデータを扱うことができます。
Vespaの際立った特徴のひとつは、ベクトル検索ができることです。ドキュメントにいくつでもベクトルフィールドを追加することができ、Vespaはそれらを素早く検索します。Vespaはテンソルと呼ばれる特殊なベクトルも扱うことができ、マルチパートのドキュメント埋め込みなどを表現するのに便利です。Vespaはこれらのベクトルをどのように保存し検索するかについてスマートなので、速度を落とすことなく本当に大量のデータを扱うことができます。
Vespaは超高速かつ効率的に構築されています。メモリを管理し、検索を行うためにC++で書かれた独自の特別なエンジンを使用しているため、複雑なクエリや大量のデータを扱ってもうまく動作します。新しいデータを追加したり、たくさんの検索を同時に処理したりしても、スムーズに動作し続けるように設計されています。そのため、多くのトラフィックやデータを処理する必要がある、大規模で現実的なアプリケーションに最適です。
Vespaのもう一つの優れた点は、より多くのデータやトラフィックを処理するために自動的にスケールアップできることです。Vespaのセットアップにコンピュータを追加すれば、自動的にそのコンピュータに作業を分散させることができる。これは、複雑なセットアップをすることなく、ニーズの成長に合わせて検索システムを成長させることができることを意味します。Vespaは、データ量やトラフィックの変化に対応するために自動的に調整することもでき、コスト削減に役立ちます。そのため、時間とともに成長する検索システムを必要とするビジネスには最適です。
##主な違い
ベクトル検索を実装する必要がある場合、CouchbaseとVespaの両方が異なるアプローチを提供します。それぞれの違いを理解することで、プロジェクトに適した選択をすることができます。
ネイティブサポート vs. アダプテッドソリューション
Vespaは組み込みのベクトル検索機能を提供します。ドキュメントに直接ベクトルフィールドを追加でき、Vespaは効率的に検索を処理します。テンソルを含む様々なベクトル型をサポートしており、複雑なドキュメントの埋め込みに便利です。
Couchbaseは異なるアプローチを取る。ネイティブなベクトル検索サポートはありませんが、いくつかの方法でベクトル検索を実装することができます:
1.ベクトルを検索可能なフィールドに変換し、全文検索(FTS)を使用する。 2.生のベクトル埋め込みを保存し、アプリケーションで類似度計算を処理する。 3.FAISSやHNSWのような外部ベクトル検索ライブラリとの統合
パフォーマンスとスケーラビリティ
Vespaはパフォーマンスの最適化において優れています。メモリ管理と検索操作に特化したC++エンジンを使用しているため、複雑なクエリや大きなデータセットでも速度を維持することができます。Vespaのセットアップにマシンを追加することができ、自動的に作業負荷を分散します。
Couchbaseのベクトル検索へのアプローチは、より手動での最適化が必要かもしれない。ベクトル検索はビルトインではないので、良好なパフォーマンスを維持するために実装方法を慎重に検討する必要があります。FTSを使うかアプリケーションレベルの計算を使うかの選択は、スケーリング戦略に影響する。
データ処理
どちらのシステムもJSONデータをうまく扱うが、その方法は異なる:
Vespaはベクトル検索、テキスト検索、構造化データクエリといった複数の検索タイプを同時に処理することができます。つまり、1つのクエリで異なる検索タイプを組み合わせることができる。
CouchbaseはNoSQLの柔軟性とリレーショナルデータベースの機能を併せ持つ。CouchbaseはJSONを効果的に処理しますが、ベクトル検索を実装するには、追加のセットアップと潜在的な外部ツールが必要です。
実装の容易さ
Vespaでベクトル検索を設定するのは、コア機能なので簡単です。スキーマでベクトルフィールドを定義し、Vespaが残りを処理します。
Couchbaseでは、ベクトル検索戦略を選択し、実装する必要があります。これは柔軟性を与えますが、より多くの開発作業を必要とします。以下のいずれかを決定する必要があります:
Couchbaseを選択する時
ベクトル検索に使用できるNoSQLデータベースが必要な場合、特にアプリの他の場所ですでにCouchbaseを使用している場合は、Couchbaseを選択してください。フルテキスト検索の適応、アプリケーションレベルの計算、FAISSのような特殊なライブラリとの統合など、ベクトル検索の実装をコントロールしたいプロジェクトに向いている。これは、あなたが選択したベクトル検索戦略を実装し、最適化するための開発リソースを持っている場合に最適です。
Vespa を選ぶとき
Vespaは、実装作業を伴わないビルトインベクター検索が必要な場合に適しています。複数の検索タイプ(ベクトル、テキスト、構造化データ)を必要とし、自動スケーリングが重要なシナリオに適しています。VespaのC++エンジンと自動ワークロード分散は、手動で最適化することなく複雑なクエリと高トラフィックを処理する必要がある大規模アプリケーションに最適です。
結論
Couchbaseは様々なアプローチで柔軟にベクトル検索を実装できるので、ベクトル検索戦略をコントロールしたいチームに適している。Vespaは、自動スケーリングと最適化機能を備えたビルトインベクター検索を提供するので、すぐにベクター検索を導入したい場合に適しています。あなたのチームの技術的な専門知識、既存のインフラ、そしてベクトル検索実装の具体的な要件に合わせて選択する必要があります。開発リソース、スケーリングの必要性、すぐにベクター検索が必要かカスタムアプローチが必要かを考慮してください。
CouchbaseとVespaの概要を知るにはこちらをお読みください。しかし、これらを評価するには、ユースケースに基づいて評価する必要があります。それに役立つツールの1つが、ベクターデータベースを比較するためのオープンソースのベンチマークツールであるVectorDBBenchだ。最終的には、独自のデータセットとクエリパターンで徹底的なベンチマークを行うことが、分散データベースシステムにおけるベクトル検索に対する、強力だが異なるこれら2つのアプローチのどちらを選択するかの鍵となるだろう。
オープンソースのVectorDBBenchを使ってベクトルデータベースを評価・比較する
VectorDBBenchは、高性能なデータ保存・検索システム、特にベクトルデータベースを必要とするユーザーのためのオープンソースのベンチマークツールです。このツールにより、ユーザはMilvusやZilliz Cloud(マネージドMilvus)のような異なるベクトルデータベースシステムを独自のデータセットを使ってテストし比較し、自分のユースケースに合うものを見つけることができます。VectorDBBenchを使えば、ユーザーはマーケティング上の主張や伝聞ではなく、実際のベクターデータベースのパフォーマンスに基づいて決定を下すことができます。
VectorDBBenchはPythonで書かれており、MITオープンソースライセンスの下でライセンスされています。VectorDBBenchは、その機能と性能の改善に取り組む開発者のコミュニティによって活発にメンテナンスされています。
VectorDBBenchをGitHubリポジトリ**からダウンロードして、我々のベンチマーク結果を再現したり、あなた自身のデータセットでパフォーマンス結果を得てください。
VectorDBBench Leaderboard](https://zilliz.com/vector-database-benchmark-tool?database=ZillizCloud%2CMilvus%2CElasticCloud%2CPgVector%2CPinecone%2CQdrantCloud%2CWeaviateCloud&dataset=medium&filter=none%2Clow%2Chigh&tab=1)で、主流のベクトルデータベースのパフォーマンスを簡単に見てみましょう。
ベクターデータベースの評価については、以下のブログをお読みください。
- ベンチマーク・ベクター・データベースのパフォーマンス:テクニックと洞察](https://zilliz.com/learn/benchmark-vector-database-performance-techniques-and-insights)
- VectorDBBench: オープンソースベクターデータベースベンチマークツール](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
- ベクターデータベースを他のデータベースと比較する](https://zilliz.com/comparison)
VectorDB、GenAI、MLに関するその他のリソース
- ジェネレーティブAIリソースハブ|Zilliz](https://zilliz.com/learn/generative-ai)
- あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
- RAGとは](https://zilliz.com/learn/Retrieval-Augmented-Generation)
- 大規模言語モデル(LLM)を学ぶ](https://zilliz.com/learn/ChatGPT-Vector-Database-Prompt-as-code)
- ベクトルデータベース101](https://zilliz.com/learn/what-is-vector-database)
- 自然言語処理(NLP)](https://zilliz.com/learn/introduction-to-natural-language-processing-tokens-ngrams-bag-of-words-models)

読み続けて
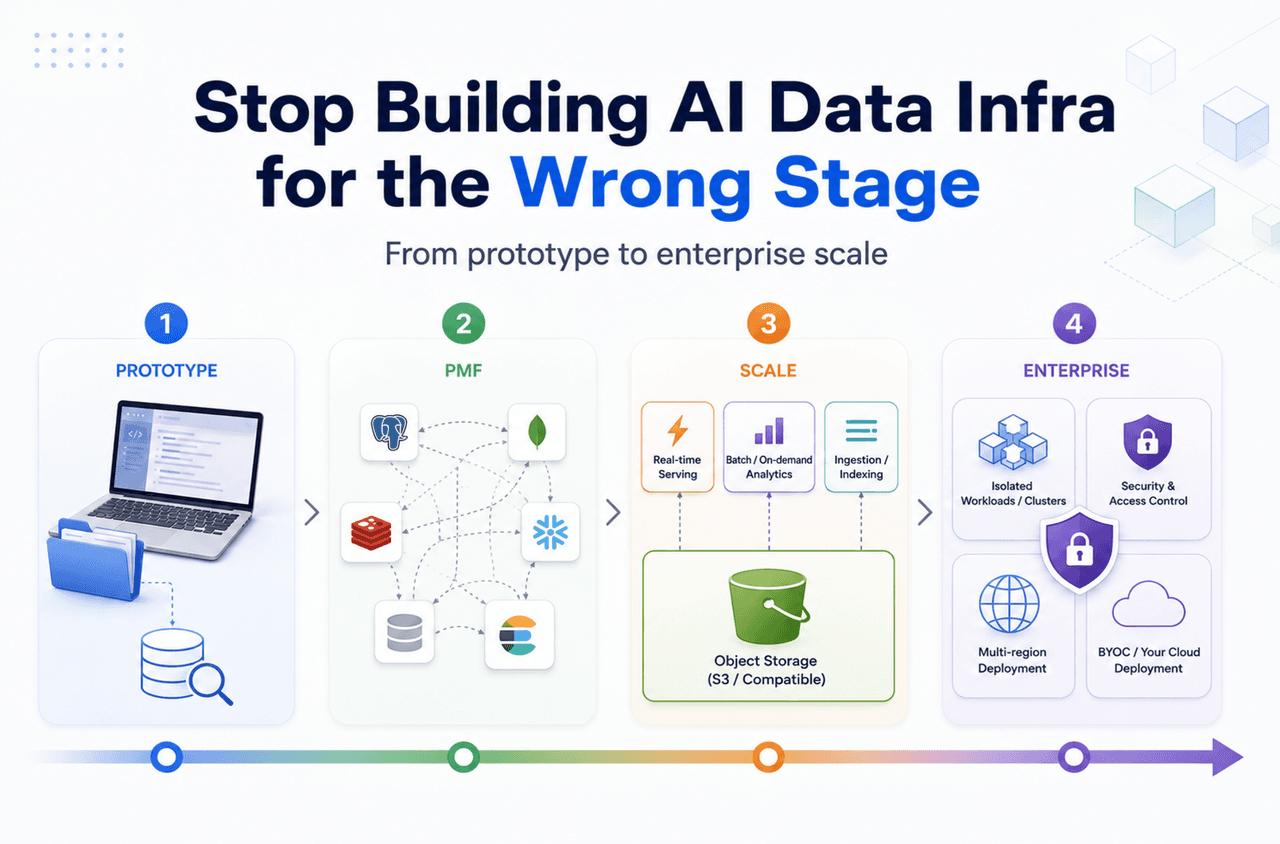
Stop Building AI Data Infra for the Wrong Stage
Learn how AI data infrastructure should evolve from prototype to enterprise scale, and when Vector Lakebase becomes the right architecture for AI apps.
Why We Built Vector Lakebase: Rethinking Unstructured Data Architecture for AI
Vector Lakebase: a unified, lake-native data foundation for AI workloads — and an answer to what happens after vector databases succeed.
Vector Databases vs. Spatial Databases
Use a vector database for AI-powered similarity search; use a spatial database for geographic and geometric data analysis and querying.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.