Хватит ждать, начните создавать: голосовой ассистент с Milvus и Llama 3.2
"К сожалению, эта функция пока недоступна в вашем регионе."
Если вы находитесь в Европе, вы, вероятно, видели это сообщение больше раз, чем хотелось бы считать. Пока остальной мир празднует каждый новый прорыв в области ИИ, многие из нас оказываются прижатыми носом к метафорическому окну, наблюдая за вечеринкой снаружи. От Llama 3.2 до Advanced Voice Mode от OpenAI — мы застряли в бесконечном цикле «Скоро появится в вашем регионе... скоро™️».
Что ж, мне надоело ждать. Если мы не можем присоединиться к вечеринке, давайте устроим свою!
В этом блоге мы проведем вас через создание голосового ассистента, специализированной Agentic RAG (Retrieval-Augmented Generation) системы, предназначенной для голосовых взаимодействий. Используя проекты с открытым исходным кодом, такие как Milvus для векторной базы данных, Llama 3.2 и различные технологии GenAI, включая Assemby AI, DuckDuckGo и ElevenLabs, этот голосовой ассистент выходит за рамки простой обработки — он интеллектуально понимает голосовые запросы и отвечает на них.
Ключевые технологии, которые мы будем использовать
- Milvus — это высокопроизводительная, хорошо масштабируемая векторная база данных с открытым исходным кодом, которая хранит, индексирует и ищет неструктурированные данные миллиардного масштаба с помощью многомерных векторных эмбеддингов. Она идеально подходит для создания современных ИИ-приложений, таких как Retrieval Augmented Generation (RAG), семантический поиск, мультимодальный поиск и рекомендательные системы. Milvus эффективно работает в различных средах, от ноутбуков до крупномасштабных распределенных систем.
- Llama 3.2 — это новейшая большая языковая модель (LLM), предоставленная Meta. Мы будем использовать ее для генерации ответов на основе информации, извлеченной из Milvus.
- Assembly AI предоставляет продвинутые API для преобразования речи в текст, предназначенные для конвертации устной речи в письменный текст с высокой степенью точности.
- DuckDuckGo — это поисковая система, которая делает акцент на конфиденциальности пользователей и предоставляет одинаковые результаты поиска для всех пользователей, в отличие от традиционных поисковых систем, которые адаптируют результаты на основе пользовательских данных.
- ElevenLabs специализируется на продвинутом синтезе речи, позволяя пользователям создавать реалистичные голосовые клоны на основе коротких аудиообразцов.
Что мы создадим: Agentic RAG система для голосовых взаимодействий
Существует несколько способов создания Agentic RAG системы. Для тех, кому интересно, я написал блог с пошаговым разбором того, как создать локальную agentic RAG систему с использованием Llama 3.2, LangChain и LangGraph.
Однако на этот раз мы пойдем другим путем и создадим агента с нуля, не полагаясь ни на какие существующие фреймворки. Архитектура этой RAG системы разбита на несколько компонентов (как показано ниже), каждый из которых отвечает за определенную часть этого процесса.
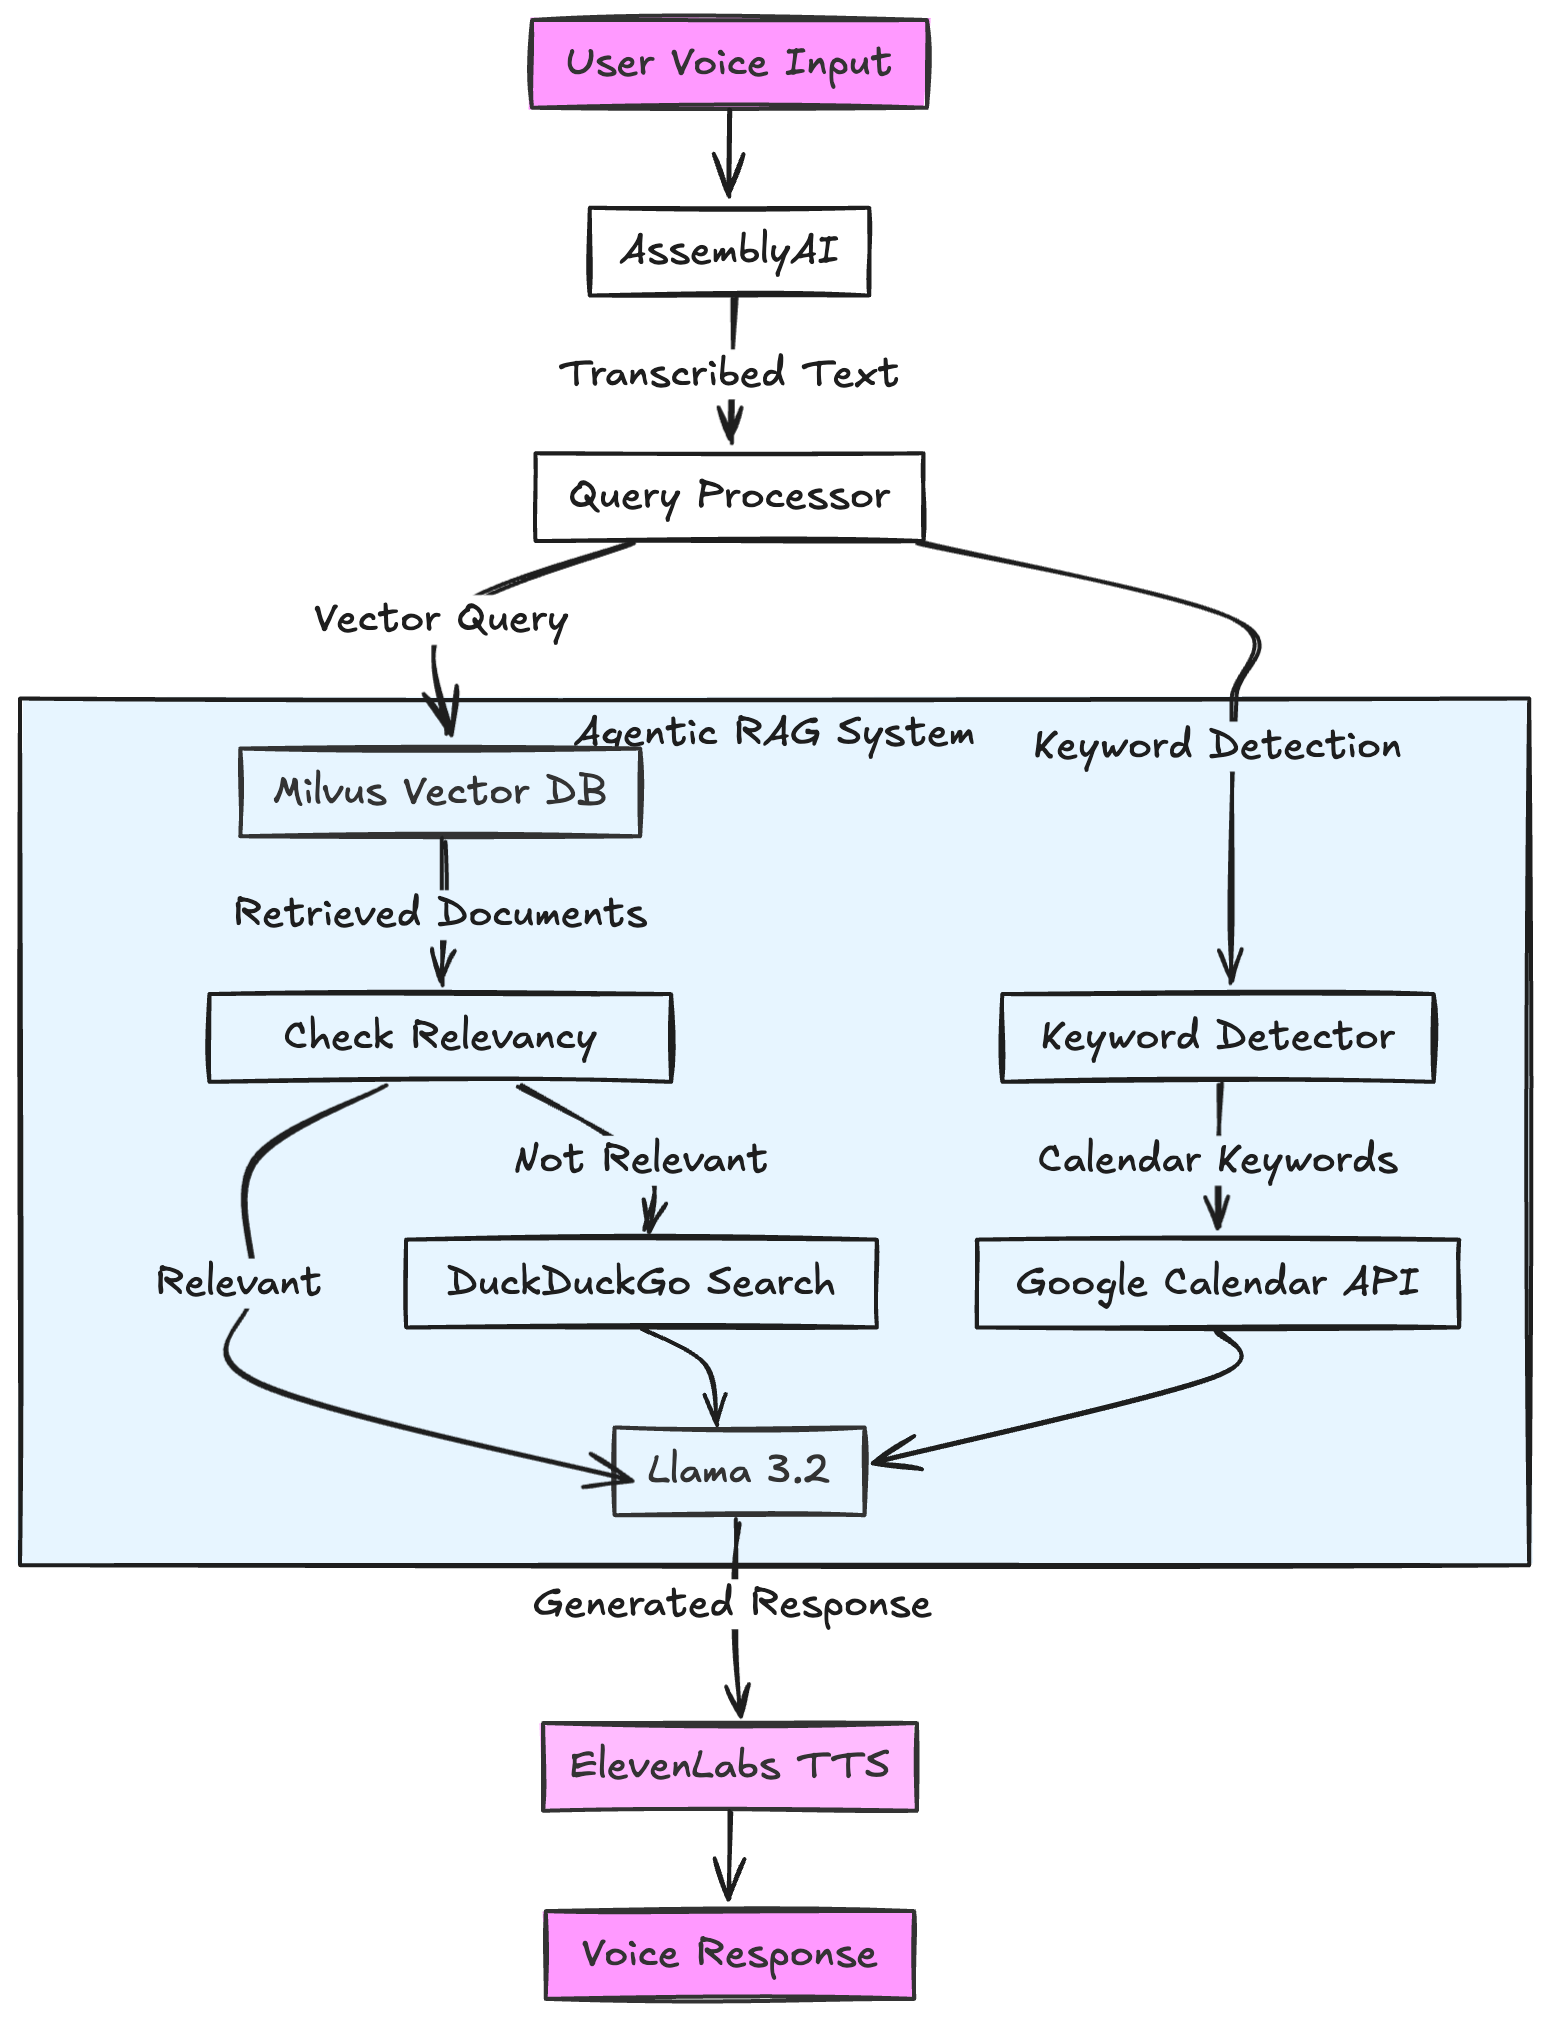 Рисунок- архитектура этой agentic RAG системы.png
Рисунок: Архитектура этой agentic RAG системы
Ниже приведен обзор того, как работает эта agentic RAG система.
- Пользователь отправляет свой голосовой запрос в систему, начиная взаимодействие.
- Assembly AI транскрибирует голос пользователя в текст в реальном времени.
- Транскрибированный текст обрабатывается Query Processor, который подготавливает его для векторного анализа и обнаружения ключевых слов в агентной RAG-системе.
- Векторная база данных Milvus выполняет поиски по семантическому сходству и извлекает документы с высоким семантическим сходством с запросом.
- Одновременно Keyword Detector сканирует текст на наличие конкретных ключевых слов, которые могут запускать определенные действия, например доступ к Google Calendar API, если обнаружены ключевые слова, связанные с календарем.
- Документы, извлеченные из Milvus, проверяются нашей агентной системой на релевантность запросу. Если они релевантны, они переходят к генерации ответа с использованием Llama 3.2; если нет, инициируется веб-поиск. Если документы из Milvus нерелевантны, DuckDuckGo затем выполняет веб-поиск.
- Llama 3.2 использует информацию либо из Milvus, либо из DuckDuckGo, либо от Keyword Detector, в зависимости от проверки релевантности, чтобы сгенерировать связный и соответствующий контексту ответ.
- Ответ, сгенерированный Llama 3.2, преобразуется в речь с использованием технологии Text-to-Speech от ElevenLabs.
- Наконец, синтезированный голосовой ответ доставляется обратно пользователю, завершая цикл взаимодействия интеллектуальным, контекстно-осведомленным ответом.
В следующем разделе мы обсудим, как мы создаем эту агентную RAG-систему, в частности как эта система одновременно обрабатывает различные типы поиска.
Оркестрация нескольких источников
В отличие от традиционных RAG-систем, которые следуют линейному шаблону запрос → извлечение → генерация, наша система думает самостоятельно. Давайте рассмотрим ключевые компоненты нашей реализации:
💡 Примечание: Для ясности и удобочитаемости здесь мы сосредоточимся на самых важных фрагментах кода. Полная реализация доступна в нашем GitHub-репозитории.
Сначала, векторный поиск Milvus
milvus_results = self.milvus_wrapper.search_similar_text(text)
relevant_results = [result for result in milvus_results
                   if result["distance"] > 0.6]

if relevant_results:
    context = "\n".join([result["text"] for result in milvus_results])
    augmented_query = f"""
    Context: {context}
    User Query: {text}
    Please answer based on the given context.
    """
Когда вы задаете вопрос, мы сначала проверяем нашу базу знаний Milvus на наличие релевантных результатов. Если мы находим что-то релевантное (сходство > 0.6), мы используем это, чтобы ответить на ваш запрос.
Затем, интеграция с календарем
elif any(keyword in text.lower() for keyword in
        ["calendar", "schedule", "events", "appointment"]):
    events = await self.calendar_service.get_upcoming_events()
    augmented_query = f"""
    Calendar Events: {events}
    User Query: {text}
    Please answer based on their calendar events.
    """
Если вы спрашиваете о своем расписании, мы полностью пропускаем базу знаний и сразу переходим к вашему календарю. Нет необходимости искать по векторам, когда мы точно знаем, где находится информация!
Наконец, резервный веб-поиск
else:
    web_results = self.web_searcher.search(text)
    if web_results:
        context = "\n".join(web_results[:3])
        augmented_query = f"""
        Web search results: {context}
        User Query: {text}
        Please answer based on the web search results.
        """
Если мы не можем найти ничего релевантного в Milvus и это не запрос к календарю, мы используем DuckDuckGo в качестве резервного варианта для веб-поиска. Затем мы получаем лучшие результаты, извлекаем самые релевантные абзацы и передаем это обратно нашей LLM Llama 3.2.
Наконец, Llama 3.2 использует информацию как контекст, чтобы сгенерировать связный и точный ответ.
Почему Milvus для RAG?
RAG-системы хороши ровно настолько, насколько высоки скорость их извлечения и качество их извлечения. Вот почему Milvus здесь играет ключевую роль:
- Скорость важна: Когда вы создаёте голосового ассистента, никто не хочет ждать ответа 5 секунд. Milvus может выполнять поиск по миллионам векторов за миллисекунды.
- Точность при масштабировании: Milvus отлично справляется с управлением поиском по высокоразмерным векторам с помощью алгоритмов Approximate Nearest Neighbor (ANN). Благодаря надёжным вариантам индексирования, таким как IVF_FLAT, HNSW и DiskANN, Milvus обеспечивает высокие показатели полноты поиска даже по мере масштабирования векторной базы данных, сохраняя целостность результатов поиска в крупных системах.
Результаты?
Наш DIY голосовой ассистент, возможно, не лучший из существующих, но у него есть несколько уникальных преимуществ:
- Модульный дизайн: Замените любой компонент (попробовать Whisper вместо AssemblyAI — почему бы и нет?)
- Полный контроль: Никаких чёрных ящиков, только прозрачный код, который можно взломать и доработать
- Ориентация на конфиденциальность: Ваши данные остаются вашими
Заключение
Хотя этот проект, очевидно, далёк от того, на что способен OpenAI Advanced Voice mode, к тому же, есть что-то приятное в создании собственного AI-ассистента. Возможно, у него нет обаяния Claude или лоска ChatGPT, но у него есть характер. Что ещё важнее, он предлагает подлинное владение и контроль над вашим AI-стеком. Используя инструменты с открытым исходным кодом, такие как векторная база данных Milvus, мы показали, как можно создать нечто, что является:
- По-настоящему вашим: Каждый компонент прозрачен и поддаётся изменению
- Географически неограниченным: Развёртывайте где угодно, обслуживайте кого угодно
- Всегда доступным: Никаких внезапных изменений API или прекращения работы сервисов
- Полностью настраиваемым: Добавляйте функции, изменяйте поведение или оптимизируйте под конкретные потребности
- С приоритетом конфиденциальности: Ваши данные остаются в вашей инфраструктуре, под вашим контролем
И, в отличие от некоторых других AI-инструментов, которые я мог бы упомянуть, этот точно знает, где находится Европа на карте!
Полный код доступен на нашем Github.
Нам бы очень хотелось узнать ваше мнение!
Если вам понравилась эта публикация в блоге, пожалуйста, рассмотрите возможность:
- ⭐ Поставить нам звезду на GitHub
- 💬 Присоединиться к нашему Milvus Discord community, чтобы поделиться своим опытом
- 🔍 Изучить наш Bootcamp repository, чтобы увидеть больше примеров RAG-приложений с Milvus
Читать далее
What Is a Vector Lakebase?
A Vector Lakebase is a unified, lake-native data architecture for AI that combines vector-database-grade serving with open lake storage, reusable lake-level indexes, and a shared semantic layer.
How to Improve Retrieval Quality for Japanese Text with Sudachi, Milvus/Zilliz, and AWS Bedrock
Learn how Sudachi normalization and Milvus/Zilliz hybrid search improve Japanese RAG accuracy with BM25 + vector fusion, AWS Bedrock embeddings, and practical code examples.
Balancing Precision and Performance: How Zilliz Cloud's New Parameters Help You Optimize Vector Search
Optimize vector search with Zilliz Cloud’s level and recall features to tune accuracy, balance performance, and power AI applications.