




Inverted Index
転置インデックスは、用語をドキュメント内の位置にマッピングするデータ構造であり、すべてをスキャンすることなく高速に検索し、適切な結果を得ることができます。検索エンジン、データベース、テキスト分析にとって不可欠であり、迅速かつ正確な情報検索を可能にします。この記事では、転置インデックスとは何か、その種類、ユースケースと利点、そして作成・実装方法について説明します。
重要なポイント
転置インデックスは、用語をドキュメント内の位置にマッピングするデータ構造であり、すべてのエントリをスキャンすることなく関連ドキュメントへすばやくアクセスできるため、効率的な検索を促進します。
転置インデックスには主に2つの種類があります。詳細な検索のために個々の単語の出現をマッピングする単語レベルと、より大規模なデータセットを管理するためにドキュメント参照の包括的なリストを保持するレコードレベルです。
転置インデックスは、検索エンジンやデータベースを含むさまざまなアプリケーションに不可欠であり、検索速度、精度、関連性を向上させます。ただし、ストレージ要件や書き込み操作への影響に関連する課題もあります。
転置インデックスとは?
 情報検索システムにおける転置インデックスの概念を描いたイラスト
転置インデックスは、用語をドキュメント内の位置にマッピングするデータ構造です。これは、ドキュメントを用語にマッピングする順方向インデックスとは逆であるため、画期的です。これにより、用語とそれに対応する位置を一覧化することで非常に高速な検索が可能になり、検索中のデータ処理が削減されます。
転置インデックスの力は、検索クエリを関連ドキュメントに非常に高速に結び付けられることにあります。検索システムは、その用語を含むドキュメントの事前にコンパイルされたリストを参照するだけでよく、すべてのドキュメントをスキャンする必要はありません。これは、検索エンジンや大規模データベースシステムを含む多くの現代的な情報検索システムの基盤です。
転置インデックスはドキュメント検索システムに組み込まれており、大量のドキュメントをまとめて高速かつ正確に検索するために必須のものです。
転置インデックス
転置インデックスには、単語レベルとレコードレベルの2種類があります。それぞれ異なるユースケースに対応しています。種類を理解することで、ニーズに合った適切なインデックス作成方法を選択できます。
単語レベルの転置インデックスは、個々の単語をドキュメント内の出現箇所にマッピングすることで、詳細な検索機能を提供します。レコードレベルの転置インデックスは、各用語についてドキュメント参照のリストを保持するため、より大規模なデータセットの管理に最適です。
これら2つの詳細に入っていきましょう。
これら2つの種類をさらに深く掘り下げ、検索機能をどのように変革できるか見てみましょう。
単語レベルの転置インデックス
単語レベルの転置インデックスは、個々の単語をドキュメント内の出現箇所と位置にマッピングすることで、検索精度を次のレベルへ引き上げます。この綿密なマッピングにより、より nuanced で詳細な検索機能が可能になります。
ドキュメント内で位置を持つ各ユニークな単語を追跡することで、フレーズ検索のような高度な検索機能が可能になります。つまり、特定の単語を含むドキュメントだけでなく、その単語がドキュメント内の正確にどこにあるかも見つけられるため、検索はより的を絞った高速なものになります。
レコードレベルの転置インデックス
レコードレベルの転置インデックスは、各単語についてドキュメント参照のリストを保持することで、より大規模なデータセット向けに設計されています。これは大規模なドキュメントコレクションの管理に適しています。
これらのインデックスは、特定の検索語がデータベーステーブル内のどこで見つかるかに関する情報を保存するため、より大規模なデータベースでデータを整理・取得するのに適しています。個々の単語位置に焦点を当てるのではなく、レコードレベルの転置インデックスは、より広範でありながら効率的な検索機能を提供します。
転置インデックスのユースケース
 検索エンジンとデータベースにおける転置インデックスのさまざまなユースケースの図解
転置インデックスは、検索エンジンからデータベース、テキスト分析まで、多くのアプリケーションで使用されています。その主な役割は、検索の精度と関連性を向上させ、ユーザーが必要なものをすばやく見つけられるようにすることです。
転置インデックスは、ステミングや同義語展開などの高度な検索機能もサポートし、複数の言語にも対応できるため、検索システムをより利用しやすくできます。
検索エンジン
Google のような検索エンジンは、ユーザークエリに応答して関連文書をすばやく見つけて返すために、転置インデックスを使用します。検索エンジンは、文書をトークン化した後、各用語をその用語が含まれる文書にリンクするリストを作成します。これにより、検索エンジンはユーザークエリを関連文書とすばやく照合し、高速で正確な結果を返すことができます。
このシステムは非常に高速で、Web ページ上の情報を数秒で見つけることができます。
データベース
データベースでは、レコードレベルの転置インデックスが大規模なデータセットを管理するために使用されます。各単語に関連付けられた文書参照を一覧化することで、これらのインデックスはテキスト検索を高速化し、クエリ効率を向上させます。
大規模データセットにおける転置インデックスの処理能力とストレージ要件の増加に対応するには、効果的な管理戦略が不可欠です。これにより、データ量が増加しても堅牢な検索のパフォーマンスを確保できます。
テキスト分析
テキスト分析において、転置インデックスはまさに宝です。自然言語処理(NLP)で、異なるデータソース間の同一テキスト文字列を検索するために使用されます。これは、異なる文書間で同じ単語や数字の同一文字列を見つけることが重要な剽窃検出のようなアプリケーションで非常に有用です。
転置インデックスは、ステミングやその他の高度な検索機能もサポートするため、検索結果の関連性が高まります。そのため、多くのアプリケーションでテキストデータを見つける上で重要であり、全文検索やその他のテキストベースのデータ分析の全体的な効率と有効性を高めます。
転置インデックスの利点
 データ取得における転置インデックス利用の利点を強調した図解
転置インデックスには多くの利点があります。大きな利点の 1 つは、全文検索のためにテーブル内のすべての行をスキャンする必要がないことです。これは大規模なデータベースでは重要で、高速な全文検索中に読み取る行数を減らすことが大きな違いを生みます。
転置インデックスは、特に検索エンジンアプリケーションにおいて、文書検索システムで選ばれるデータ構造です。広範なテキストデータセットを効率的に検索し、特定の用語を含む文書を迅速に特定できます。
転置インデックスは、新しいコンテンツのほぼリアルタイムのインデックス作成のために迅速に更新でき、Boolean クエリや近接クエリなど、さまざまなクエリタイプに対応するようにカスタマイズできます。
課題と制限
多くの利点がある一方で、転置インデックスにも問題がないわけではありません。大きな制限の 1 つは、文書数と一意の用語数が増えるにつれて指数関数的に増加するストレージ要件です。これを軽減するために、デルタ符号化とガンマ符号化を使用して、転置インデックスのストレージフットプリントを削減できます。
もう一つは書き込み性能への影響です。転置インデックスは読み取り性能を向上させる一方で、追加のインデックス作成作業が必要になるため、書き込み性能をわずかに低下させます。転置インデックスの維持にはデータのソートや再編成が伴い、書き込み操作中に非効率性が生じます。転置インデックスの更新も、ドキュメントの追加や変更により処理量の増加、ポスティングリストの再計算と更新が必要になるため、性能面で複雑かつ高コストです。
転置インデックスの作成
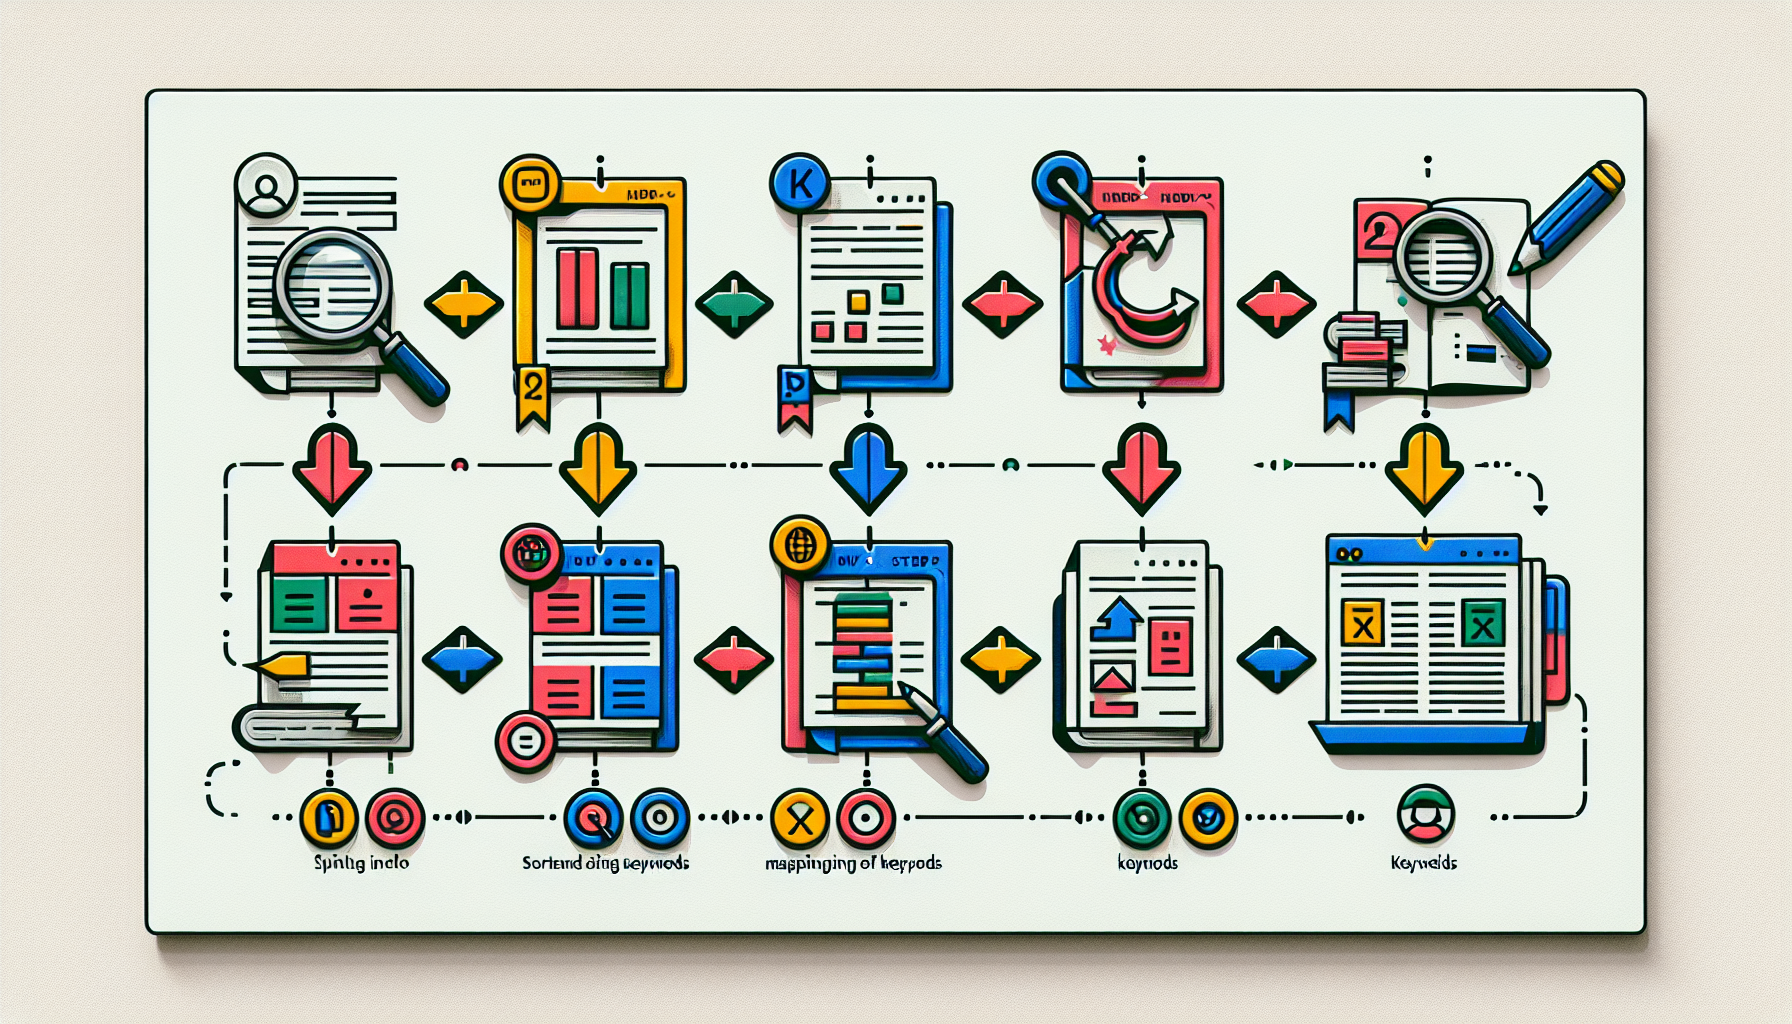 転置インデックスを作成するプロセスを示す図
転置インデックスの作成にはいくつかの手順があり、まずドキュメントのテキストを個々の用語にトークン化します。これにより、生のテキストがインデックス作成用の構造化された形式に変換されます。検索をより効果的にするために、ステミングやレンマ化もトークン化に使用できます。
転置インデックスの作成と微調整には、基本的な方法と高度な方法を使用できます。基本的な方法は、上記で作成した転置インデックスの初期作成と整理に使用され、高度な方法は性能と関連性の向上に使用されます。
基本的な転置インデックスの作成
基本的な転置インデックスの作成は、ドキュメントのテキストを個々の用語にトークン化することから始まります。一意の用語ごとに空のドキュメントリストが作成されます。システムは、その用語が各ドキュメントに含まれているかを確認し、転置インデックス辞書に追加します。
その後、各用語がそのドキュメントリストとともに出力されるため、その用語がデータセット内のどこにあるかを示すマップが得られます。
高度なテクニック
インデックスを転置するための高度なテクニックには、ステミングやストップワードの削除があります。Porter’s Stemmer のようなステミングアルゴリズムは、単語を語根形に縮約するため、インデックス内でより広範に検索できます。ストップワードを削除すると、一般的ではあるものの関連性の低い単語が除去され、検索結果が改善されます。
これらを組み合わせることで、はるかに多くの機能とより良い結果が得られます。
データベースにおける転置インデックスの実装
 データベースで転置インデックスがどのように実装されるかを示す図
データベースに転置インデックスを実装すると、特にログ分析やドキュメント管理のようなアプリケーションにおいて、ドキュメント検索が大幅に高速化されます。転置インデックスは、特定の検索語がデータベーステーブル内のどこにあるかを記録するため、テーブル全体をスキャンする必要がなくなり、性能が大きく向上します。
性能向上のほとんどは、読み取り操作時の転置によって得られます。書き込み操作は、追加のインデックス更新が必要になるため、わずかに遅くなります。
最新のデータベースは、転置インデックス向けにさまざまなデータ型をサポートしており、特定の条件に基づいて、最も一般的なデータ構造のサブセットに対する部分インデックス作成を可能にし、ストレージと性能の両方を最適化します。さらに、database index や database indexes を使用することで、クエリ効率をさらに高めることができます。
SQL を使用した実践例
SQL で転置インデックスを作成すること(より正確には、テキスト検索または JSONB データに GIN インデックスを使用すること)は、PostgreSQL の簡単なコマンドで実行できます。たとえば、GIN インデックスを作成するには、次の SQL クエリを使用できます。
CREATE INDEX index_name ON table_name USING GIN (column_to_index);
CREATE INDEX index_name ON table_name USING GIN (column_to_index);
このコマンドは、指定された列に GIN インデックスを作成します。これは、JSONB、配列、または全文検索データのような型のインデックス作成に役立ちます。
文字列データ検索用の Trigram インデックス
テキストデータをより効率的に検索するために、PostgreSQL の pg_trgm 拡張機能を使用して trigram index を作成できます。
CREATE INDEX index_name ON table_name USING GIN (column_to_index gin_trgm_ops);
このインデックスは、文字列データ内の 類似性 やパターンマッチングの検索に役立ちます。
部分インデックス
部分インデックスを作成して、データの特定のサブセットのみをインデックス化することもできます。これにより、大規模データセットをクエリする際のパフォーマンスを向上できます。たとえば、次のコマンドは、id が 10 より大きい行のみを対象にインデックスを作成します。
CREATE INDEX index_name ON table_name USING GIN (column_to_index) WHERE id > 10;
この部分インデックスは、条件に基づいて選択的に適用されます。
複数列 GIN インデックス
PostgreSQL では、複数列 GIN インデックスを作成することもできます。簡単な例として、user_type 列と user_profile 列(user_profile が JSONB 列であると仮定)を両方ともインデックス化するには、次のようにします。
CREATE INDEX index_name ON users USING GIN (user_type, user_profile);
まとめ
転置インデックスは、今日のデータ豊富な環境において、効率的な検索と取得のための強力なツールです。用語をドキュメント内の位置にマッピングすることで、迅速かつ正確な検索を可能にし、検索エンジン、データベース、テキスト分析アプリケーションのパフォーマンスを大幅に向上させます。基本的な作成手法から、ステミングやストップワード除去のような高度な最適化まで、転置インデックスは大規模データセットを管理するための汎用的で効果的なソリューションを提供します。
このガイドを締めくくるにあたり、転置インデックスを理解し実装することで、データの扱い方や検索方法を変革できることは明らかです。検索機能を最適化するための新しい価値を求める開発者であれ、テキスト分析を強化したいデータサイエンティストであれ、ここで提供した洞察は、転置インデックスを効果的に活用する力を与えてくれるでしょう。
よくある質問
転置インデックスとは何ですか?
転置インデックスは、用語をドキュメント内の位置にマッピングする重要なデータ構造であり、検索時により高速で効率的なデータ取得を可能にします。この非常に一般的なデータ構造は、処理する必要のあるデータを最小限に抑えることで、検索プロセスも大幅に最適化します。
単語レベルの転置インデックスとレコードレベルの転置インデックスはどのように異なりますか?
単語レベルの転置インデックスは、個々の単語をドキュメント内の出現箇所と位置にマッピングすることに重点を置く一方、レコードレベルの転置インデックスは各用語に対してドキュメント参照の包括的なリストを提供するため、より大規模なデータセットに適しています。
転置インデックスの一般的な用途にはどのようなものがありますか?
転置インデックスは、検索精度を向上させ、非常に大規模なデータセットを効果的に管理するために、検索エンジンやデータベースで一般的に利用されています。テキスト分析に不可欠な高度な検索機能をサポートします。
転置インデックスを使用する利点は何ですか?
転置インデックスを使用すると、より高速な全文検索や、フルテーブルスキャンの必要性をなくすことによる検索効率の向上など、大きな利点があります。このデータ構造は、ドキュメント取得システムを最適化するために不可欠です。
転置インデックスに関連する課題は何ですか?
転置インデックスには、ストレージ要件の増加、追加のインデックス作成タスクによる書き込み操作への悪影響、インデックス更新の複雑さなどの課題があります。圧縮技術を利用することで、ストレージに関する懸念に効果的に対処できます。