




Data Lakehouse
data lakes の柔軟性と data warehouses のパフォーマンスのどちらを選ぶべきか悩んでいませんか?もし、そもそも選ぶ必要がなかったとしたらどうでしょうか?データレイクハウスは、組織が最も価値ある資産を保存、処理、分析する方法を大きく改善する、データ管理への優れたアプローチとして登場しています。企業が、構造化された取引記録から非構造化 IoT センサーデータまで、ますます多様なデータタイプを生成するようになる中、従来のアーキテクチャは限界に達しつつあります。データレイクハウスはこのギャップを埋めるソリューションとして登場し、パフォーマンスを犠牲にすることなく、かつてない柔軟性を提供します。
Data Lakehouse とは?
データレイクハウスは、データレイクの柔軟性、コスト効率、スケールと、データウェアハウスのデータ管理機能および ACID トランザクションを組み合わせた、モダンでオープンなデータ管理アーキテクチャです。このハイブリッドなアプローチにより、単一の統合プラットフォーム内で、あらゆるデータタイプに対してビジネスインテリジェンス(BI)と機械学習(ML)の両方の運用が可能になります。
異なるデータタイプごとに別々のシステムを必要とする従来の二層アーキテクチャとは異なり、データレイクハウスは、構造化データ、半構造化データ、非構造化データが共存する単一の信頼できる情報源を作り出します。このアーキテクチャは、低コストのクラウドオブジェクトストレージ(データレイクに類似)を活用しながら、このストレージレイヤーの直上にデータ構造と管理機能(データウェアハウスに類似)を実装します。
主な定義上の特徴は次のとおりです:
統合ストレージ: すべてのデータタイプを低コストのオブジェクトストレージ上にオープン形式で保存
ACID トランザクション: データの信頼性と一貫性を確保
スキーマ強制: 必要に応じてデータ品質と構造を維持
マルチワークロード対応: 同一プラットフォーム上で BI、分析、データサイエンス、ML を可能にする
オープン標準: Parquet のような形式や Apache Iceberg のような技術を使用
Data Lakehouse はどのように機能するのか?
コア技術スタック
データレイクハウスアーキテクチャは、この統合アプローチを可能にするいくつかの重要な技術的進歩に依存しています:
メタデータレイヤー: Delta Lake、Apache Iceberg、Apache Hudi などの技術は、オープンファイル形式(Parquet など)の上に配置され、どのファイルがどのテーブルバージョンに属するかを追跡します。これらのレイヤーは、ACID 準拠のトランザクション、タイムトラベル機能、スキーマ強制と進化、データ検証など、豊富な管理機能を提供します。
高性能クエリエンジン: モダンなクエリエンジンは、ホットデータを RAM/SSD にキャッシュすること、頻繁にアクセスされるデータをまとめてクラスタリングするデータレイアウト最適化、統計やインデックスのような補助データ構造、モダン CPU 上でのベクトル化実行など、さまざまな最適化を通じて、データレイク上で直接高性能な SQL 実行を可能にします。
オープンデータ形式: Parquet や ORC のようなオープン形式を使用することで、データサイエンティストや機械学習エンジニアは、複雑なデータ移動や変換プロセスなしに、pandas、TensorFlow、PyTorch、Spark DataFrames などの一般的なツールを使用してデータに容易にアクセスできます。
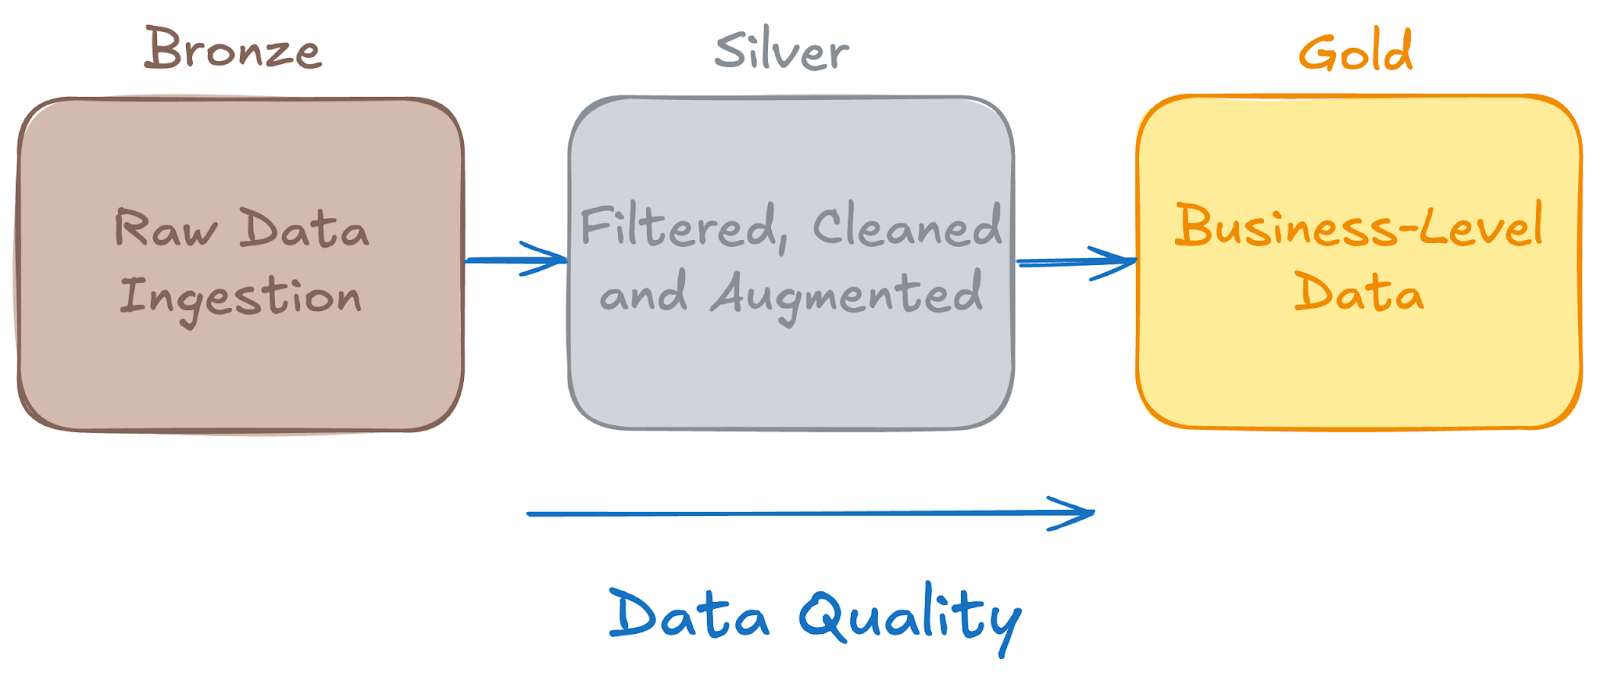
メダリオンアーキテクチャ
典型的なデータレイクハウスは、3 つの異なるレイヤーを持つメダリオンアーキテクチャを実装します:
ブロンズレイヤー(生データ): この取り込みレイヤーは、さまざまなソースから複数の形式でバッチデータまたはストリーミングデータを受け取ります。データは未処理の生の形式で保存され、元のソースへの完全な忠実性を維持しながら、スキーマオンリードの柔軟性を可能にします。
シルバーレイヤー(クレンジング済み・準拠済み): 処理レイヤーは、データ品質ルールを適用し、形式を標準化し、初期変換を実行します。これにより、詳細な監査証跡とデータリネージ情報を維持しながら、クリーンで検証済みのデータセットが作成されます。
ゴールドレイヤー(ビジネス対応): 最終レイヤーは、特定のユースケースに最適化された、クリーンで強化されたデータを提供します。テーブルは、分析クエリと機械学習ワークロードの両方を効率的に処理できるよう、適切なデータレイアウトと最適化を備えて設計されています。
データ処理機能
リアルタイム処理: データレイクハウスはストリーミングデータの取り込みと処理をサポートし、リアルタイム分析と即時のインサイトを可能にします。これにより、多くのシナリオで Kafka のような個別のメッセージバスが不要になります。
バッチ処理: 従来のバッチ処理機能は、大規模な履歴データ分析や、リアルタイム実行を必要としない複雑な変換を処理します。
インタラクティブ分析: ユーザーは、データを別の分析システムに移動することなく、レイクハウス上で直接アドホッククエリや探索的データ分析を実行できます。
Delta Lake: 最新データレイクハウスの基盤
Delta Lake は、最新のデータレイクハウスアーキテクチャを支える最も重要なテクノロジーの1つとして台頭しています。オープンソースのストレージフレームワークとして、Delta Lake はデータレイクストレージに信頼性、パフォーマンス、ガバナンスをもたらすことで、データレイクとデータウェアハウスのギャップを埋めます。
Delta Lake とは何か?
Delta Lake は、既存のデータレイク上で動作するオープンソースのストレージレイヤーであり、ACID トランザクション、スケーラブルなメタデータ処理、そしてストリーミングとバッチデータ処理の統合を提供します。もともと Databricks によって構築され、現在は Linux Foundation によって保守されている Delta Lake は、クラウドオブジェクトストレージの上にトランザクションログレイヤーを追加することで、信頼性の低いデータレイクを信頼性の高いデータレイクハウスへと変換します。
その中核において、Delta Lake はデータを Parquet 形式で保存しながら、データに加えられたすべての変更を追跡するトランザクションログを維持します。このトランザクションログこそが、ACID 特性、タイムトラベル、そして従来は伝統的なデータウェアハウスでしか利用できなかったその他の高度な機能を可能にする重要な革新です。
主な機能と能力
ACID トランザクション: Delta Lake は完全な ACID トランザクションサポートを提供し、同時読み取りおよび書き込みが行われる場合でもデータの信頼性を確保します。これにより、複数のプロセスが同じデータに同時にアクセスした際に従来のデータレイクで発生し得るデータ破損の問題が解消されます。
タイムトラベルとバージョニング: Delta テーブル上のすべての操作は新しいバージョンを作成し、ユーザーがデータの過去のバージョンにアクセスできるようにします。この機能により、データ復旧、監査、実験の再現、問題のある変更のロールバックが可能になります。これらはデータガバナンスとコンプライアンスに不可欠な機能です。
スキーマ強制と進化: Delta Lake はスキーマ検証を強制することで、不正なデータが書き込まれるのを防ぎます。スキーマを変更する必要がある場合、Delta Lake は制御されたスキーマ進化をサポートし、データ品質を維持しながら、変化するビジネス要件にテーブルを適応させることができます。
統合されたバッチとストリーミング: Delta Lake は、バッチワークロードとストリーミングワークロードの両方が同じテーブルに同時に読み書きできるようにします。これにより、個別のシステムや複雑なデータ同期プロセスが不要になり、継続的に更新されるデータに対するリアルタイム分析が可能になります。
スケーラブルなメタデータ処理: 大量のファイルがあると遅くなる従来のファイルベースストレージとは異なり、Delta Lake は数百万のファイルと数十億のオブジェクトを持つテーブルのメタデータを効率的に処理し、大規模環境でも高速なクエリパフォーマンスを維持します。
データ品質機能: Delta Lake は、書き込み時にデータ品質を自動的に検証する expectations と制約をサポートし、破損したデータや無効なデータがレイクハウスに入るのを防ぎます。
Delta Lake がデータレイクハウスアーキテクチャを支える仕組み
Delta Lake は、データレイクハウスの概念を実用的かつ信頼性の高いものにするストレージ基盤として機能します:
信頼性レイヤー: 従来のデータレイクは、一貫性の問題、書き込み失敗、データ破損に悩まされていました。Delta Lake のトランザクションログは、すべての操作がアトミックかつ一貫していることを保証し、エンタープライズワークロードが必要とする信頼性を提供します。
パフォーマンス最適化: Delta Lake には、データスキッピング、Z-ordering、自動ファイルコンパクションなど、クエリパフォーマンスを劇的に向上させる組み込みの最適化機能が含まれています。これらの最適化は、手動介入を必要とせず透過的に実行されます。
ガバナンスとコンプライアンス: 監査証跡、タイムトラベル、スキーマ強制などの機能により、Delta Lake は組織が規制要件を満たし、適切なデータガバナンスを維持できるようにします。これは、従来のデータレイクでは困難または不可能だったことです。
マルチエンジンサポート: Delta Lake テーブルは、Apache Spark、Apache Flink、Trino などを含む複数の処理エンジンからアクセスでき、データの一貫性を維持しながらツール選択の柔軟性を提供します。
データレイクハウス vs. データレイク vs. データウェアハウス
これら3つのアーキテクチャの違いを理解することで、データレイクハウスのアプローチをいつ選択すべきかが明確になります。
| 機能 | データウェアハウス | データレイク | データレイクハウス |
|---|---|---|---|
| データ構造 | Schema-on-write | Schema-on-read | Schema-on-read and schema-on-write |
| データ型 | 構造化データのみ | すべての型 | すべての型 |
| トランザクションサポート | 限定的 | 完全 (ACID) | 完全 (ACID) |
| パフォーマンス | 高速なSQLクエリ | 可変的なパフォーマンス | ウェアハウスに近い速度 |
| コスト | 大規模では高い | 低コストストレージ、可変コンピュート | 低コストストレージ、最適化コンピュート |
データレイクハウスの利点と課題
データレイクハウスの利点
シンプルなアーキテクチャ: 個別のデータウェアハウスシステムとデータレイクシステムを維持する複雑さを排除し、運用上のオーバーヘッドと、データの不整合を引き起こす可能性のある複数の ETL プロセスの必要性を削減します。
最適化されたコスト: 低コストのオブジェクトストレージを活用しながら、高性能なクエリ機能を提供することで、従来のデータウェアハウスのスケーリングと比較して総所有コストを大幅に削減します。
強化されたデータ品質: スキーマ強制と ACID トランザクションを実装してデータ整合性を維持しながら、多様なデータ型と進化するスキーマに対応する柔軟性を保持します。
コラボレーションの向上: データエンジニア、アナリスト、データサイエンティストが同じデータを使って同じプラットフォーム上で作業できるようにし、異なるデータチーム間の従来のサイロを解消します。
リアルタイム機能: バッチワークロードとストリーミングワークロードの両方をサポートし、システム間の複雑なデータ移動なしにリアルタイム分析と即時のインサイトを可能にします。
データ重複の削減: 異なるシステム間でデータの複数コピーを維持する必要をなくす単一の信頼できる情報源を提供し、一貫性を向上させ、ストレージコストを削減します。
データレイクハウスの課題
技術的複雑性: データレイクハウスの構築と維持には、複数の技術に関する専門知識と、パフォーマンスのボトルネックを回避し、適切なガバナンスを確保するための慎重なアーキテクチャ計画が必要です。
ベンダーロックインに関する考慮事項: オープン標準に基づいて構築されている一方で、一部のマネージドレイクハウスソリューションは、特定のクラウドプロバイダーやテクノロジーベンダーへの依存関係を生み出す可能性があります。
パフォーマンスチューニング: 最適なパフォーマンスを実現するには、データパーティショニング、ファイルサイズ設定、インデックス戦略、クエリ最適化技術に細心の注意を払う必要があります。
移行の複雑さ: 既存のデータインフラストラクチャを持つ組織は、ビジネスの中断を避けるために慎重な計画を必要とする複雑な移行パスに直面します。
Data Lakehouseのユースケース
データレイクのスケーラビリティとデータウェアハウスのパフォーマンスを組み合わせる能力により、データレイクハウスは以下を含むさまざまな業界で影響を与えています。
ヘルスケア: データレイクハウスは、電子カルテ、医用画像、ウェアラブルデバイスなどの多様なデータソースを統合し、患者の健康状態を包括的に把握できるようにします。この統合により、疾患の早期発見のための予測分析、個別化された治療計画、効率的なリソース配分が可能になります。
金融サービス: 金融機関は、取引、市場フィード、顧客とのやり取りからのデータを集約・分析するためにデータレイクハウスを活用します。この包括的なデータ分析により、リスク評価モデルが強化され、不正検知アルゴリズムが改善され、規制遵守の取り組みが支援され、全体的な金融業務が強化されます。
小売: 小売業者は、POSシステム、eコマースプラットフォーム、顧客ロイヤルティプログラムからのデータを統合するためにデータレイクハウスを活用します。この統合されたデータアプローチにより、個別化されたマーケティング戦略、動的価格設定モデル、在庫最適化が可能になり、顧客体験と運用効率が向上します。
製造: 製造業では、データレイクハウスがセンサー、生産ライン、サプライチェーンからのデータを統合します。この統合は、設備の摩耗パターンを特定し、適時の介入をスケジュールすることで予知保全を支援し、ダウンタイムを削減して生産プロセスを最適化します。
…その他多数。
多様なデータタイプと分析ワークロードをサポートする統合プラットフォームを提供することで、データレイクハウスは組織が実用的なインサイトを導き出し、意思決定を強化し、イノベーションを推進できるようにします。
次の進化: Vector Data Lake
Vector Data Lakeとは?
組織がAIおよび機械学習ワークフローをますます採用するにつれ、前例のない課題に直面しています。文書や画像から音声ファイル、センサーデータに至るまで、膨大な量の非構造化データが日次、月次、年次で生成されています。この非構造化データからインサイトを引き出すには、組織はそれを、意味的な意味を捉え、類似性ベースの分析を可能にするベクトル埋め込みに変換する必要があります。
Vector Data Lakeは、大規模かつ低コストでベクトル埋め込みを保存・処理するために特別に最適化されています。組織がAIインサイトを引き出すためにベクトルへ変換しなければならないテラバイトからペタバイト規模の非構造化データを生成する中で、Vector Data Lakeは、大規模なオフライン分析ワークロード向けに、専用ベクトルデータベースに代わるコスト効率の高い選択肢を提供します。ベクトルデータベースはリアルタイムのユースケースに優れたパフォーマンスを提供しますが、テラバイト規模のベクトルを保存・処理することは非常に高額になります。Vector Data Lakeは、劇的に低いコストと引き換えに、より高いレイテンシーを許容できる組織向けに、コスト最適化されたソリューションを提供することでこれを解決します。
Vector Data Lakeの主要機能
統合データスタック: Vector Data Lakeは、一貫した形式と効率的なストレージにより、オンラインとオフラインのデータレイヤーをシームレスに接続します。つまり、再フォーマットや複雑な移行なしに、ホット層とコールド層の間でデータを移動でき、ベクトルデータ管理に対する真に統合されたアプローチを構築できます。
互換性のあるコンピュートエコシステム: SparkやRayのようなフレームワークとネイティブに連携するよう構築されたVector Data Lakeは、ベクトル検索から従来のETLや分析まで、あらゆるものをサポートします。この互換性により、既存のデータチームは、すでに知っているツールを使用してベクトルデータを扱うことができ、専門的なベクトルデータベースの知識が不要になります。
コスト最適化アーキテクチャ: システムはデータ配置をインテリジェントに管理します—ホットデータは高速アクセスのためにSSDまたはNVMeに保持され、コールドデータはS3のようなオブジェクトストレージへ自動的に移動します。スマートなインデックス作成とストレージ戦略により、必要なときにはI/Oを高速に保ちながら、ストレージコストを予測可能かつ手頃にします。
データレイクハウス vs. ベクトルデータレイク vs ベクトルデータベース
データレイクハウス、ベクトルデータレイク、ベクトルデータベースはいずれも大規模データセットと分析を扱いますが、まったく異なるニーズのために構築されています—データレイクハウスは柔軟性とガバナンスに焦点を当て、ベクトルデータレイクは大規模な低コストストレージを優先し、ベクトルデータベースは速度を重視します:
| 機能 | データレイクハウス | ベクトルデータレイク | ベクトルデータベース |
|---|---|---|---|
| 主要なデータ型 | 構造化、半構造化、非構造化 | ベクトル埋め込み + すべての従来型データタイプ | 主にベクトル埋め込み |
| クエリタイプ | SQL分析、BIレポート、MLトレーニング | セマンティック検索、類似性分析、ベクトル分析 | リアルタイム類似検索、最近傍探索 |
| レイテンシ | ニアリアルタイムからバッチまで | バッチ最適化、高めのレイテンシも許容可能 | 超低レイテンシ(ms) |
| コストモデル | 一般的な分析ワークロード向けに最適化 | 大規模ベクトルストレージ向けの超低コスト | パフォーマンスのために高コスト |
| コンピュートフレームワーク | Spark、SQLエンジン、MLフレームワーク | Spark、Ray、ベクトル対応処理 | 専用ベクトルエンジン(FAISS、Pineconeなど) |
| ユースケース | ビジネスインテリジェンス、データサイエンス、レポート作成 | 履歴ドキュメント分析、バッチ類似性、トレンド分析 | リアルタイム推薦、チャットボット、ライブ検索 |
| ストレージ階層 | すべてのデータタイプ向けのホット/ウォーム/コールド | ホットベクトル(SSD/NVMe)、コールドベクトル(オブジェクトストレージ) | 主にホットストレージ、最適化されたインデックス |
| スケーリング | 水平スケーリング、マルチクラウド | 大規模な水平スケーリング、クラウドネイティブ | 垂直 + 水平、専用設計 |
| ACID特性 | 完全なACID準拠のサポート | 限定的なACID、結果整合性 | 限定的なACID、可用性重視 |
| データガバナンス | 包括的なカタログ、リネージ追跡 | 基本的なガバナンス、メタデータ中心 | 最小限のガバナンス機能 |
よくある質問
1. データレイクに対するデータレイクハウスの主な利点は何ですか?
データレイクハウスはACIDトランザクションのサポートとスキーマ適用を提供し、従来のデータレイクでは通常不足している、分析のためのデータ信頼性とパフォーマンスを確保します。
2. データレイクハウスはデータウェアハウスを置き換えられますか?
データレイクハウスはデータウェアハウスと同じワークロードの多くを処理できますが、一部の組織では特定のニーズを満たすために両方のシステムを使用することを選ぶ場合があります。
3. データレイクハウスで一般的に使用されるツールは何ですか?
一般的なツールには、メタデータ管理のためのDelta Lake、データ処理のためのApache Spark、分析のためのさまざまなBIおよび機械学習プラットフォームが含まれます。
4. データレイクハウスはリアルタイム分析に適していますか?
はい、データレイクハウスはリアルタイムのデータ取り込みとクエリをサポートしているため、リアルタイム分析アプリケーションに適しています。
5. データレイクハウスはデータガバナンスをどのように扱いますか?
データレイクハウスは、スキーマを適用し、データリネージを追跡し、アクセス制御をサポートするメタデータレイヤーを組み込み、堅牢なデータガバナンスを確保します。