




Data Lakehouse
Вам трудно выбрать между гибкостью озер данных и производительностью хранилищ данных? А что, если бы вам вообще не пришлось выбирать? Data lakehouse становится впечатляющим подходом к управлению данными, который значительно улучшает то, как организации хранят, обрабатывают и анализируют свой самый ценный актив. По мере того как компании генерируют всё более разнообразные типы данных — от структурированных записей транзакций до неструктурированных данных датчиков IoT, — традиционные архитектуры достигают своих пределов. Data lakehouse становится решением, которое устраняет этот разрыв, предлагая беспрецедентную гибкость без ущерба для производительности.
Что такое Data Lakehouse?
Data lakehouse — это современная открытая архитектура управления данными, которая сочетает гибкость, экономическую эффективность и масштабируемость озер данных с возможностями управления данными и ACID-транзакциями хранилищ данных. Этот гибридный подход позволяет выполнять операции бизнес-аналитики (BI) и машинного обучения (ML) со всеми типами данных в рамках единой унифицированной платформы.
В отличие от традиционных двухуровневых архитектур, которым требуются отдельные системы для разных типов данных, data lakehouse создает единый источник истины, где сосуществуют структурированные, полуструктурированные и неструктурированные данные. Архитектура использует недорогое облачное объектное хранилище (подобно озерам данных), одновременно реализуя структуры данных и функции управления (подобно хранилищам данных) непосредственно поверх этого уровня хранения.
К ключевым определяющим характеристикам относятся:
Единое хранилище: все типы данных хранятся в открытых форматах в недорогом объектном хранилище
ACID-транзакции: обеспечение надежности и согласованности данных
Принудительное применение схемы: поддержание качества и структуры данных при необходимости
Поддержка нескольких рабочих нагрузок: обеспечение BI, аналитики, науки о данных и ML на одной платформе
Открытые стандарты: использование форматов, таких как Parquet, и технологий, таких как Apache Iceberg
Как работает Data Lakehouse?
Основной технологический стек
Архитектура data lakehouse опирается на несколько ключевых технологических достижений, которые делают такой унифицированный подход возможным:
Уровни метаданных: такие технологии, как Delta Lake, Apache Iceberg и Apache Hudi, располагаются поверх открытых файловых форматов (например, Parquet) и отслеживают, какие файлы относятся к различным версиям таблиц. Эти уровни предоставляют богатые функции управления, включая ACID-совместимые транзакции, возможности перемещения во времени, принудительное применение и эволюцию схем, а также проверку данных.
Высокопроизводительные механизмы запросов: современные механизмы запросов обеспечивают высокопроизводительное выполнение SQL непосредственно на озерах данных благодаря различным оптимизациям, включая кэширование часто используемых данных в RAM/SSD, оптимизацию размещения данных, которая группирует часто запрашиваемые данные вместе, вспомогательные структуры данных, такие как статистика и индексы, а также векторизованное выполнение на современных CPU.
Открытые форматы данных: использование открытых форматов, таких как Parquet и ORC, облегчает специалистам по данным и инженерам машинного обучения доступ к данным с помощью популярных инструментов, таких как pandas, TensorFlow, PyTorch и Spark DataFrames, без сложных процессов перемещения или преобразования данных.
Медальонная архитектура
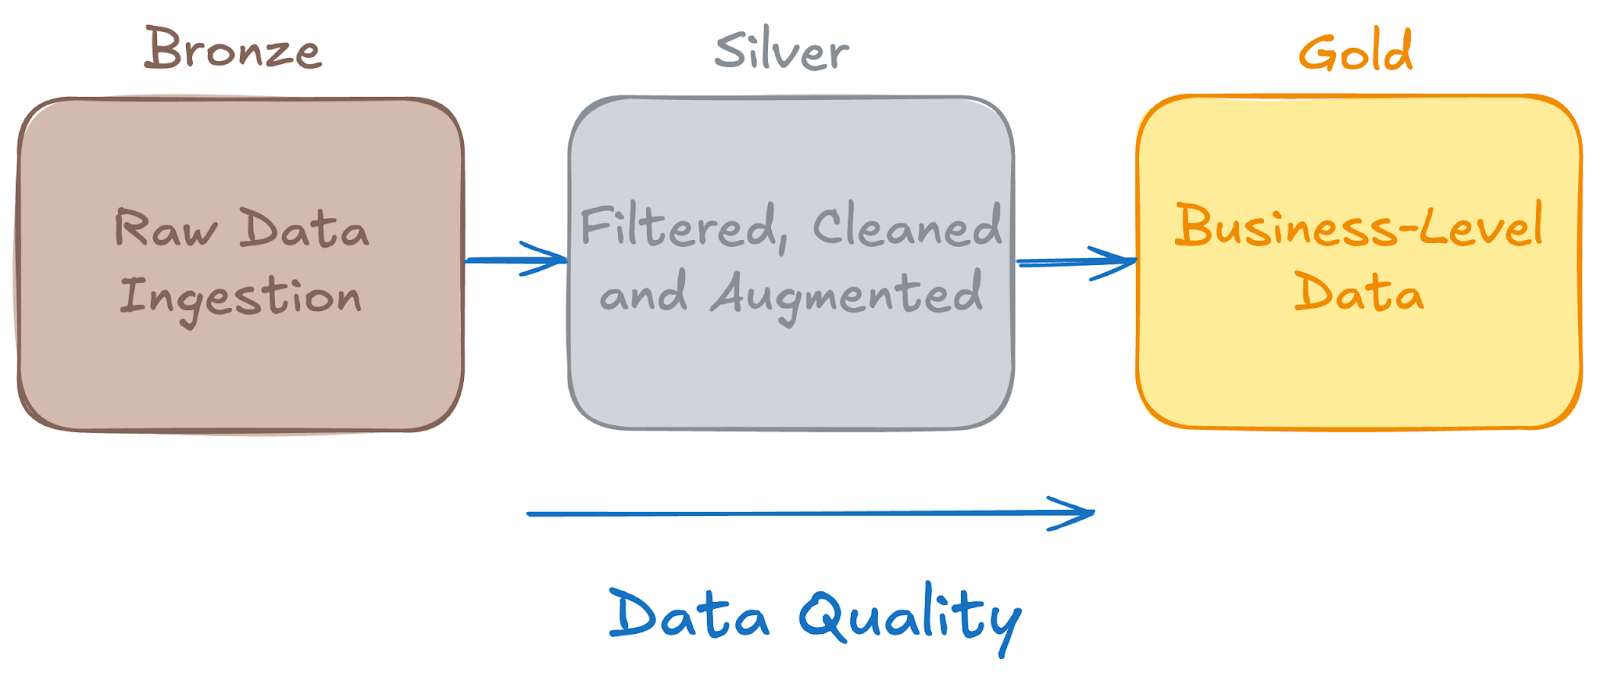
Типичный data lakehouse реализует медальонную архитектуру с тремя отдельными уровнями:
Бронзовый уровень (сырые данные): этот уровень приема получает пакетные или потоковые данные из различных источников в нескольких форматах. Данные хранятся в исходном, необработанном виде, сохраняя полную точность относительно исходного источника и одновременно обеспечивая гибкость схемы при чтении.
Серебряный уровень (очищенные и согласованные данные): уровень обработки применяет правила качества данных, стандартизирует форматы и выполняет начальные преобразования. Это создает чистые, проверенные наборы данных, сохраняя при этом подробные журналы аудита и информацию о происхождении данных.
Золотой слой (готовый для бизнеса): Финальный слой предоставляет чистые, обогащенные данные, оптимизированные для конкретных сценариев использования. Таблицы проектируются с соответствующими схемами данных и оптимизациями, чтобы эффективно обслуживать как аналитические запросы, так и рабочие нагрузки машинного обучения.
Возможности обработки данных
Обработка в реальном времени: Data lakehouse поддерживают потоковую загрузку и обработку данных, обеспечивая аналитику в реальном времени и немедленное получение инсайтов. Во многих сценариях это устраняет необходимость в отдельных шинах сообщений, таких как Kafka.
Пакетная обработка: Традиционные возможности пакетной обработки обеспечивают крупномасштабный анализ исторических данных и сложные преобразования, которые не требуют выполнения в реальном времени.
Интерактивная аналитика: Пользователи могут выполнять специальные запросы и исследовательский анализ данных непосредственно в lakehouse без перемещения данных в отдельные аналитические системы.
Delta Lake: основа современных Data Lakehouse
Delta Lake стала одной из наиболее важных технологий, лежащих в основе современных архитектур data lakehouse. Как open-source фреймворк хранения данных, Delta Lake устраняет разрыв между data lake и data warehouse, привнося надежность, производительность и управление в хранилище data lake.
Что такое Delta Lake?
Delta Lake — это open-source слой хранения, который работает поверх существующих data lake и обеспечивает ACID-транзакции, масштабируемую обработку метаданных, а также унифицированную потоковую и пакетную обработку данных. Изначально созданная Databricks и теперь поддерживаемая Linux Foundation, Delta Lake превращает ненадежные data lake в надежные data lakehouse, добавляя слой журнала транзакций поверх облачного объектного хранилища.
В своей основе Delta Lake хранит данные в формате Parquet, одновременно поддерживая журнал транзакций, который отслеживает все изменения, внесенные в данные. Этот журнал транзакций является ключевой инновацией, обеспечивающей ACID-свойства, time travel и другие расширенные функции, которые ранее были доступны только в традиционных data warehouse.
Ключевые функции и возможности
ACID-транзакции: Delta Lake обеспечивает полноценную поддержку ACID-транзакций, гарантируя надежность данных даже при одновременном чтении и записи. Это устраняет проблемы повреждения данных, которые могут возникать в традиционных data lake, когда несколько процессов одновременно обращаются к одним и тем же данным.
Time Travel и версионирование: Каждая операция с таблицей Delta создает новую версию, позволяя пользователям получать доступ к историческим версиям своих данных. Эта возможность обеспечивает восстановление данных, аудит, воспроизведение экспериментов и откат проблемных изменений — функции, критически важные для управления данными и соответствия требованиям.
Контроль схемы и эволюция схемы: Delta Lake предотвращает запись некорректных данных, обеспечивая проверку схемы. Когда схемы необходимо изменить, Delta Lake поддерживает контролируемую эволюцию схемы, позволяя таблицам адаптироваться к меняющимся бизнес-требованиям при сохранении качества данных.
Унифицированная пакетная и потоковая обработка: Delta Lake позволяет как пакетным, так и потоковым рабочим нагрузкам одновременно читать из одних и тех же таблиц и записывать в них. Это устраняет необходимость в отдельных системах и сложных процессах синхронизации данных, обеспечивая аналитику в реальном времени на постоянно обновляемых данных.
Масштабируемая обработка метаданных: В отличие от традиционного файлового хранилища, которое замедляется при большом количестве файлов, Delta Lake эффективно обрабатывает метаданные для таблиц с миллионами файлов и миллиардами объектов, сохраняя высокую производительность запросов в масштабе.
Функции качества данных: Delta Lake поддерживает expectations и constraints, которые автоматически проверяют качество данных во время записи, предотвращая попадание поврежденных или недопустимых данных в lakehouse.
Как Delta Lake обеспечивает архитектуру Data Lakehouse
Delta Lake служит основой хранения, которая делает концепцию data lakehouse практичной и надежной:
Уровень надежности: Традиционные озера данных страдают от проблем с согласованностью, неудачных записей и повреждения данных. Журнал транзакций Delta Lake гарантирует, что все операции являются атомарными и согласованными, обеспечивая надежность, необходимую для корпоративных рабочих нагрузок.
Оптимизация производительности: Delta Lake включает встроенные функции оптимизации, такие как пропуск данных, Z-ordering и автоматическое уплотнение файлов, которые значительно повышают производительность запросов. Эти оптимизации выполняются прозрачно, без необходимости ручного вмешательства.
Управление и соответствие требованиям: Благодаря таким функциям, как журналы аудита, time travel и принудительное соблюдение схемы, Delta Lake позволяет организациям соответствовать нормативным требованиям и поддерживать надлежащее управление данными — то, что было сложно или невозможно при использовании традиционных озер данных.
Поддержка нескольких движков: Таблицы Delta Lake могут быть доступны нескольким движкам обработки, включая Apache Spark, Apache Flink, Trino и другие, обеспечивая гибкость в выборе инструментов при сохранении согласованности данных.
Data Lakehouse vs. Data Lake vs. Data Warehouse
Понимание различий между этими тремя архитектурами помогает прояснить, когда следует выбрать подход data lakehouse:
| Функция | Data Warehouse | Data Lake | Data Lakehouse |
|---|---|---|---|
| Структура данных | Schema-on-write | Schema-on-read | Schema-on-read и schema-on-write |
| Типы данных | Только структурированные | Все типы | Все типы |
| Поддержка транзакций | Ограниченная | Полная (ACID) | Полная (ACID) |
| Производительность | Быстрые SQL-запросы | Переменная производительность | Скорость, близкая к хранилищу данных |
| Стоимость | Высокая при масштабировании | Низкая стоимость хранения, переменные вычисления | Низкая стоимость хранения, оптимизированные вычисления |
Преимущества и проблемы Data Lakehouse
Преимущества Data Lakehouse
Простая архитектура: Устраняет сложность поддержки отдельных систем хранилища данных и озера данных, снижая операционные накладные расходы и необходимость в нескольких процессах ETL, которые могут приводить к несогласованности данных.
Оптимизированная стоимость: Использует недорогое объектное хранилище, одновременно предоставляя высокопроизводительные возможности запросов, что значительно снижает совокупную стоимость владения по сравнению с масштабированием традиционного хранилища данных.
Повышенное качество данных: Реализует принудительное соблюдение схемы и ACID-транзакции для поддержания целостности данных, сохраняя при этом гибкость для работы с разнообразными типами данных и изменяющимися схемами.
Улучшенное сотрудничество: Позволяет инженерам данных, аналитикам и специалистам по данным работать на одной платформе с одними и теми же данными, устраняя традиционные разрозненные структуры между различными командами по работе с данными.
Возможности реального времени: Поддерживает как пакетные, так и потоковые рабочие нагрузки, обеспечивая аналитику в реальном времени и мгновенное получение выводов без сложного перемещения данных между системами.
Сокращение дублирования данных: Предоставляет единый источник истины, устраняющий необходимость поддерживать несколько копий данных в разных системах, повышая согласованность и снижая затраты на хранение.
Проблемы Data Lakehouse
Техническая сложность: Создание и поддержка data lakehouse требует экспертизы в нескольких технологиях и тщательного планирования архитектуры, чтобы избежать узких мест производительности и обеспечить надлежащее управление.
Соображения о привязке к поставщику: Хотя решения построены на открытых стандартах, некоторые управляемые lakehouse-решения могут создавать зависимости от конкретных облачных провайдеров или поставщиков технологий.
Настройка производительности: Достижение оптимальной производительности требует тщательного внимания к партиционированию данных, размеру файлов, стратегиям индексирования и методам оптимизации запросов.
Сложность миграции: Организации с существующей инфраструктурой данных сталкиваются со сложными путями миграции, которые требуют тщательного планирования, чтобы избежать сбоев в бизнесе.
Варианты использования Data Lakehouse
Благодаря способности сочетать масштабируемость озер данных с производительностью хранилищ данных, data lakehouse оказывают влияние на различные отрасли, включая:
Здравоохранение: data lakehouse интегрируют различные источники данных — такие как электронные медицинские карты, медицинские изображения и носимые устройства, — чтобы обеспечить комплексное представление о здоровье пациента. Эта интеграция позволяет применять предиктивную аналитику для раннего выявления заболеваний, разрабатывать персонализированные планы лечения и эффективно распределять ресурсы.
Финансовые услуги: финансовые учреждения используют data lakehouse для агрегирования и анализа данных из транзакций, рыночных потоков и взаимодействий с клиентами. Этот комплексный анализ данных улучшает модели оценки рисков, совершенствует алгоритмы выявления мошенничества и поддерживает усилия по соблюдению нормативных требований, укрепляя финансовые операции в целом.
Розничная торговля: ритейлеры используют data lakehouse для консолидации данных из систем точек продаж, платформ электронной коммерции и программ лояльности клиентов. Этот унифицированный подход к данным позволяет применять персонализированные маркетинговые стратегии, динамические модели ценообразования и оптимизацию запасов, улучшая клиентский опыт и операционную эффективность.
Производство: в производстве data lakehouse интегрируют данные с датчиков, производственных линий и цепочек поставок. Эта интеграция поддерживает предиктивное обслуживание, выявляя закономерности износа оборудования и планируя своевременные вмешательства, сокращая простои и оптимизируя производственные процессы.
…и многое другое.
Предоставляя унифицированную платформу, которая поддерживает различные типы данных и аналитические рабочие нагрузки, data lakehouse позволяют организациям получать практические инсайты, улучшать принятие решений и стимулировать инновации.
Следующая эволюция: Vector Data Lake
Что такое Vector Data Lake?
По мере того как организации все активнее внедряют рабочие процессы ИИ и машинного обучения, они сталкиваются с беспрецедентной задачей: ежедневно, ежемесячно и ежегодно генерируются огромные объемы неструктурированных данных — от документов и изображений до аудиофайлов и данных датчиков. Чтобы извлечь инсайты из этих неструктурированных данных, организациям необходимо преобразовать их в векторные эмбеддинги, которые отражают семантический смысл и позволяют проводить анализ на основе сходства.
Vector Data Lake специально оптимизирован для хранения и обработки векторных эмбеддингов в огромном масштабе и с низкими затратами. Поскольку организации генерируют терабайты и петабайты неструктурированных данных, которые необходимо преобразовать в векторы, чтобы раскрыть инсайты ИИ, Vector Data Lake предоставляет экономически эффективную альтернативу специализированным векторным базам данных для крупномасштабных офлайн-аналитических рабочих нагрузок. Хотя векторные базы данных обеспечивают отличную производительность для сценариев использования в реальном времени, хранение и обработка терабайтов векторов становится чрезвычайно дорогой задачей. Vector Data Lake решает это, предоставляя оптимизированное по стоимости решение для организаций, которые могут допустить более высокую задержку в обмен на значительно более низкие затраты.
Ключевые возможности Vector Data Lake
Унифицированный стек данных: Vector Data Lake бесшовно соединяет онлайн- и офлайн-слои данных с согласованными форматами и эффективным хранением. Это означает, что вы можете перемещать данные между горячими и холодными уровнями без переформатирования или сложных миграций, создавая по-настоящему унифицированный подход к управлению векторными данными.
Совместимая вычислительная экосистема: Созданный для нативной работы с такими фреймворками, как Spark и Ray, Vector Data Lake поддерживает все — от векторного поиска до традиционных ETL и аналитики. Эта совместимость означает, что ваши существующие команды по работе с данными могут работать с векторными данными, используя уже знакомые им инструменты, устраняя необходимость в специализированной экспертизе по векторным базам данных.
Архитектура, оптимизированная по затратам: Система интеллектуально управляет размещением данных — горячие данные остаются на SSD или NVMe для быстрого доступа, а холодные данные автоматически перемещаются в объектное хранилище, например S3. Умные стратегии индексирования и хранения обеспечивают быстрый I/O, когда это необходимо, при этом делая затраты на хранение прогнозируемыми и доступными.
Data Lakehouse vs. Vector Data Lake vs Vector Database
Хотя data lakehouse, векторные озера данных и векторные базы данных обрабатывают огромные наборы данных и аналитику, они созданы для совершенно разных потребностей: Data Lakehouses ориентированы на гибкость и управление данными, Vector Data Lakes — на дешевое хранение в масштабе, а Vector Databases — прежде всего на скорость:
| Функция | Data Lakehouse | Vector Data Lake | Vector Database |
|---|---|---|---|
| Основные типы данных | Структурированные, полуструктурированные, неструктурированные | Векторные эмбеддинги + все традиционные типы данных | Преимущественно векторные эмбеддинги |
| Типы запросов | SQL-аналитика, BI-отчетность, обучение ML | Семантический поиск, анализ сходства, векторная аналитика | Поиск сходства в реальном времени, ближайший сосед |
| Задержка | От почти реального времени до пакетной обработки | Оптимизировано для пакетной обработки, допустима более высокая задержка | Ультранизкая задержка (мс) |
| Модель затрат | Оптимизирована для общих аналитических нагрузок | Сверхнизкая стоимость для массового хранения векторов | Более высокая стоимость ради производительности |
| Вычислительные фреймворки | Spark, SQL-движки, ML-фреймворки | Spark, Ray, обработка с учетом векторов | Специализированные векторные движки (FAISS, Pinecone и т. д.) |
| Сценарии использования | Бизнес-аналитика, data science, отчетность | Исторический анализ документов, пакетное сравнение сходства, анализ трендов | Рекомендации в реальном времени, чат-боты, поиск в реальном времени |
| Уровни хранения | Горячее/теплое/холодное для всех типов данных | Горячие векторы (SSD/NVMe), холодные векторы (объектное хранилище) | Преимущественно горячее хранилище, оптимизированные индексы |
| Масштабирование | Горизонтальное масштабирование, multi-cloud | Массовое горизонтальное масштабирование, cloud-native | Вертикальное + горизонтальное, специализированное |
| Свойства ACID | Полная поддержка соответствия ACID | Ограниченный ACID, итоговая согласованность | Ограниченный ACID, фокус на доступности |
| Управление данными | Комплексный каталог, отслеживание происхождения данных | Базовое управление данными, сильный акцент на метаданные | Минимальные возможности управления данными |
Часто задаваемые вопросы
1. Каково основное преимущество data lakehouse перед data lake?
Data lakehouse обеспечивает поддержку ACID-транзакций и применение схемы, гарантируя надежность данных и производительность аналитики, чего обычно не хватает традиционным data lake.
2. Может ли data lakehouse заменить data warehouse?
Хотя data lakehouse может обрабатывать многие из тех же рабочих нагрузок, что и data warehouse, некоторые организации могут выбрать использование обеих систем для удовлетворения конкретных потребностей.
3. Какие инструменты обычно используются с data lakehouse?
К распространенным инструментам относятся Delta Lake для управления метаданными, Apache Spark для обработки данных, а также различные платформы BI и машинного обучения для аналитики.
4. Подходят ли data lakehouse для аналитики в реальном времени?
Да, data lakehouse поддерживают прием и запросы данных в реальном времени, что делает их подходящими для приложений аналитики в реальном времени.
5. Как data lakehouse обеспечивают управление данными?
Озёра данных с хранилищами включают слои метаданных, которые обеспечивают соблюдение схемы, отслеживают происхождение данных и поддерживают контроль доступа, обеспечивая надёжное управление данными.