




Batch Gradient Descent
バッチ勾配降下法は、精度と安定性で知られる、機械学習における最適化のゴールドスタンダードです。データセット全体に対してコスト関数の勾配を計算することで、優れたモデル学習につながる一貫した更新を保証します。本記事では、バッチ勾配降下法の仕組み、その長所と短所、そして実世界の機械学習でどのように使われているかを解説します。
要約
勾配降下法は、コスト関数に基づいてモデルパラメータを反復的に更新することで損失を最小化する、機械学習における最も基本的な最適化手法です。
バッチ勾配降下法は、勾配計算にトレーニングデータセット全体を使用するため、安定して一貫性がありますが、多くの計算資源を必要とします。
バッチ勾配降下法は、適切なバッチサイズを選択し、大規模データセットを扱い収束を監視するための実践を取り入れることで改善できます。
勾配降下法の基礎
 勾配降下法の基礎を示すイラスト
本質的に、勾配降下法は機械学習における損失を最小化するためにモデルパラメータを最適化する方法です。この最適化プロセスでは、予測結果と実際の結果の誤差を測定する損失関数の勾配とは反対方向に、モデルのパラメータを反復的に移動させます。目標は、最も低い誤差をもたらすパラメータを見つけ、モデルが良好に機能するようにすることです。
勾配降下法は、ディープラーニングから金融モデリングまで、多くの実世界のアプリケーションで使用されています。その重要性を理解するには、この強力な最適化技術の基礎となる基本を知る必要があります。
コスト関数
コスト関数は、モデルが予測を行う際にどれだけうまく機能しているかを測定する数学的概念です。予測結果と実際の結果の差を測定し、モデルの性能を示す指標を提供します。コスト関数を最小化することで、モデルのパラメータを最適化し、精度を向上させます。
実際には、コスト関数はモデルの予測が実際の結果とどれだけ一致しているかを示すことで、最適化プロセスを導きます。これにより勾配を計算でき、その勾配は誤差を減らす方向にパラメータを移動させるために使用されます。重要なのは、モデルをより良い性能へ導くために、コスト関数を正しく計算し解釈することです。
学習率とその影響
学習率は、最適化中にモデルのパラメータをどれだけ変更するかを制御する、勾配降下法における重要なハイパーパラメータです。適切な学習率は、トレーニングプロセスの速度と安定性に大きな違いをもたらします。学習率が低すぎると、モデルの収束が非常に遅くなり、トレーニングが非効率になります。学習率が高すぎると、モデルは最小値を飛び越えて発散してしまいます。
学習率の適切なバランスを見つけることは、モデルのトレーニングにおいて重要です。適切な学習率により、最適化は安定して進み、不安定さや遅い収束なしにコスト関数を最小化できます。このバランスは、最適な性能と効率にとって重要です。
局所最小値と大域最小値
損失関数のランドスケープにおいて、局所最小値とは勾配がゼロであるものの、全体として最も低い点ではない点です。局所最小値は最適化を閉じ込め、モデル性能が準最適になる可能性があります。大域最小値は損失関数のランドスケープにおける絶対的に最も低い点であり、モデルにとっての最適解です。
局所最小値と大域最小値は、勾配降下法における大きな課題です。異なる初期重みやモメンタムを使用することで、局所最小値を避け、最適化を大域最小値へ導く助けになります。
局所最小値と大域最小値の違いを理解することは、機械学習モデルを最適化するうえで重要です。
バッチ勾配降下法
 バッチ勾配降下法が動作している様子の視覚的表現
バッチ勾配降下法は、元祖の勾配降下アルゴリズムです。バッチ勾配降下法では、モデルを調整する際にすべての訓練データを一度に確認します。これは、意思決定を行う前にあらゆる証拠を検討するようなものです。この手法は、各ステップでモデルをどのように改善するかを計算するためにデータセット全体を使用します。一度にデータの一部だけを使用する他のアプローチとは異なります。これは徹底的ですが、大規模なデータセットでは遅くなることがあります。
バッチ勾配降下法は最適解に収束するのが得意ですが、その代償として計算リソースが必要になります。バッチ勾配降下法を使用するには、計算効率とモデル精度のバランスを取る必要があります。
バッチ勾配降下法の仕組み
バッチ勾配降下法は、すべての訓練データを一度に使用してモデルを更新します。これは、ケーキを焼くときに、オーブンに入れる前にすべての材料を混ぜ合わせるようなものです。この手法は、データセット内のすべての例を一度に見て、モデルをどのように改善するかを計算します。部分ごとに見るのではありません。このプロセスでは、モデルのいずれかのパラメータを更新する前にデータセット全体を処理するため、勾配が正確に計算されます。計算された勾配はその後、パラメータを更新するために使用され、コスト関数の方向へ移動させます。
このアプローチは安定した予測可能な収束をもたらしますが、特に大規模なデータセットでは遅く、リソースを大量に消費する可能性があります。何かを更新する前にデータセット全体を処理する必要があるため、バッチ勾配降下法は遅くなることがあります。
こうした課題にもかかわらず、その精度と安定性により、機械学習において価値のあるツールとなっています。
バッチ勾配降下法の利点
バッチ勾配降下法の最大の利点の1つは、最適解へ安定して一貫して収束することです。データセット全体を使用することで安定した誤差勾配が得られ、それが予測可能な収束につながります。これは、誤差曲面が滑らかで収束が安定している凸最適化問題に非常に有用です。
滑らかな誤差多様体上でのバッチ勾配降下法の一貫性により、機械学習モデルを最適化するための優れた手法となります。安定した誤差勾配は、最適化プロセスを円滑に進め、変動や不安定性の可能性を減らします。これは多くの実世界のアプリケーションで非常に有用です。
バッチ勾配降下法の欠点
利点がある一方で、バッチ勾配降下法には大きな欠点があり、主にその高い計算コストです。更新を行う前にデータセット全体を処理することは遅く、リソースを大量に消費する可能性があり、非常に大規模なデータセットでは実用的ではありません。この非効率性により、訓練時間が長くなり、より多くの計算リソースが必要になる可能性があります。
バッチ勾配降下法の高い計算コストは、特に大規模な問題において、機械学習での実用性を制限します。安定した正確な更新を提供する一方で、計算効率の面でのトレードオフが大きな障壁になることがあります。これらのトレードオフを管理することが、実世界のシナリオでバッチ勾配降下法を使用する鍵となります。
勾配降下法のバリアント
 確率的勾配降下法やミニバッチ勾配降下法を含む、さまざまな勾配降下法のバリアントを比較するインフォグラフィック
機械学習モデルに適した勾配降下法を選ぶことは非常に重要です。各バリアントには長所と短所があるため、さまざまなシナリオやユースケースに適しています。
このセクションでは、バッチ勾配降下法を確率的勾配降下法(SGD)およびミニバッチ勾配降下法と比較します。
確率的勾配降下法(SGD)
確率的勾配降下法(SGD)は、各サンプルが処理された後にモデルの重みを更新することで、真のコスト勾配を確率的に近似する手法です。データセット全体を処理するバッチ勾配降下法とは異なり、SGDはサンプルごとに1回更新するため、より高速ですが、学習中のノイズは大きくなります。
SGDの確率的な性質により、局所的最小値からよりうまく抜け出せますが、ノイズによって収束が不安定になることがあります。そのためSGDは、安定性とのトレードオフがあるとしても高速な更新が重要な大規模機械学習タスクに適しています。
ミニバッチ勾配降下法
ミニバッチ勾配降下法は、バッチ勾配降下法と確率的勾配降下法の中間に位置する手法です。ミニバッチ(学習サンプルの部分集合)を使用することで、この方法は両方の利点を得られます。ベクトル化された演算を使用するため、少ない反復でより高速になります。
これにより、複数の局所的最小値を持つコスト関数に対応し、よりバランスの取れた効率的な最適化を行う方法が得られます。バッチサイズを小さくすることで、ミニバッチ勾配降下法は勾配推定を正確かつ高速に保つことができます。そのため、多くの機械学習アプリケーションで使用されています。
バッチ勾配降下法の実務上の考慮事項
 バッチ勾配降下法の実務上の考慮事項に焦点を当てた図解
バッチ勾配降下法には、考慮すべき実務上の点が多くあります。バッチサイズから大規模データセット、収束の監視まで、これらは性能と効率にとって重要です。
バッチサイズ
適切なバッチサイズを選ぶことは、計算量とモデル品質のバランスを取るうえで重要です。ミニバッチ勾配降下法では、通常、32や64など、2の累乗であるバッチサイズを選びます。
これにより、計算効率を保ちつつ、学習品質を高く維持できます。
大規模データセット
大規模データセットの扱いは、高いメモリ要件と計算要件のため、バッチ勾配降下法における大きな課題です。データのシャッフルと並列処理はこれらの課題に役立ち、バッチがデータセット全体を代表するようになり、batch gdにおける学習を改善します。
これらにより、大規模機械学習において効率的かつ効果的であり続けます。
収束の監視
モデルの収束を監視することは、効果的に学習し、損失を最小化するために重要です。可視化ツールはこれに役立ち、最適な停止基準を見つけ、モデルが十分に収束した後に不要な計算を行わないようにできます。
このアプローチにより、効率的で効果的な学習プロセスが保証されます。
よくある問題と解決策
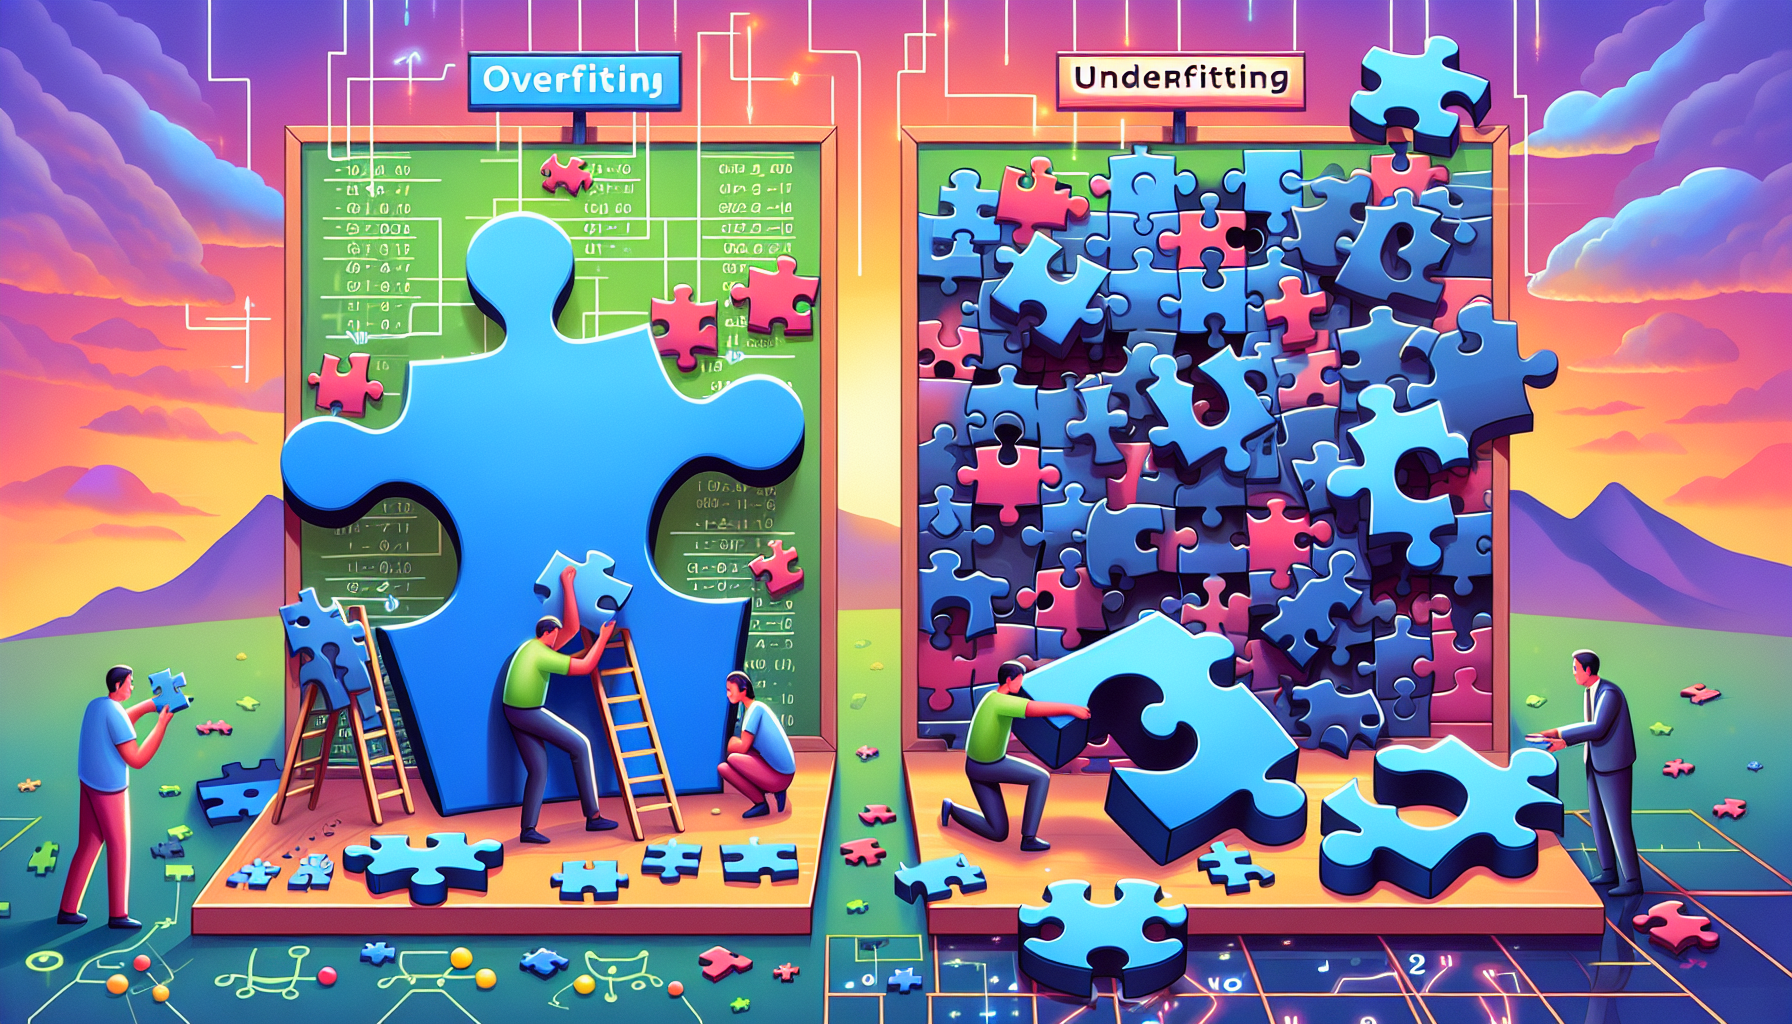 勾配降下法に関連する機械学習の一般的な落とし穴を描いた図解
勾配降下法は優れた最適化手法ですが、落とし穴がないわけではありません。過学習、未学習、非凸関数はモデルの性能を損なう可能性があります。
このセクションでは、モデルが最適に機能できるように、これらの問題に対する解決策を取り上げます。
過学習と未学習
過学習は、モデルが学習時に与えられた特定の例に過度に集中してしまうときに起こります。これは、科目を理解する代わりに答えを暗記するようなものです。その結果、モデルは新しい未知のデータに対して性能が低くなる可能性があります。
未学習は、モデルが単純すぎてデータ内の重要なパターンを捉えられないときに発生します。これは、曲線的な関係を直線で説明しようとするのに似ています。モデルは重要な傾向を見逃し、学習データと新しいデータの両方で性能が低くなります。
学習曲線を使用して学習損失と検証損失を可視化し、交差検証を行うことで、これらの問題を特定して修正し、モデルが新しいデータに対してうまく汎化できるようにします。
学習率
動的な学習率は、学習が停滞するのを防ぎ、モデル最適化中の進捗を確保できます。学習率とバッチサイズのバランスを取ることで、モデル学習が最適化され、より速く収束します。
そのため、トレーニングは効果的かつ効率的です。
非凸関数
非凸関数は最適化における大きな課題です。ランダムリスタートのような手法を使用すると、局所最小値を回避し、非凸最適化問題を進めるのに役立ちます。
これらの戦略は、複雑な損失ランドスケープで最適解を達成するために不可欠です。
実世界での応用
バッチ勾配降下法は、コンピュータビジョン、自然言語処理、金融モデリングなど、多くの分野で使用されています。ここでは、2つの主要な分野におけるその応用例を2つ見て、それがどれほど汎用的で効果的であるかを確認します。
画像認識
画像認識タスクでは、バッチ勾配降下法は、画像を正確に分類するためにディープラーニングモデルをトレーニングするために使用されます。畳み込みニューラルネットワークを最適化することで、特徴抽出と分類精度が向上し、コンピュータビジョンにおける強力なツールになります。
自然言語処理
自然言語処理バッチ勾配降下法では、感情分析や言語翻訳などのタスクで、言語パターンを予測するためにモデル性能を最適化するために使用されます。大規模データセットを扱う能力により、NLPモデルで非常に有用です。
まとめ
バッチ勾配降下法は、機械学習モデルの最適化の鍵です。基礎から実践上のポイント、よくある落とし穴まで、ここではすべてを取り上げました。これを適用すれば、モデルの性能と効率を向上させることができます。
FAQ
確率的勾配降下法に対するバッチ勾配降下法の主な利点は何ですか?
バッチ勾配降下法の主な利点は、データセット全体を使用して勾配を計算するため、最適解へより安定して収束し、したがって更新がより正確で、誤差勾配の変動が少ないことです。
学習率は勾配降下法にどのように影響しますか?
学習率は、モデルパラメータの更新サイズを決定するため、勾配降下法にとって重要です。最適な学習率は効率的な収束と安定性をもたらし、不適切な学習率は収束の遅さや発散をもたらします。
バッチ勾配降下法で大規模データセットを扱うにはどうすればよいですか?
バッチ勾配降下法で大規模データセットを扱うには、データシャッフリングと並列処理が不可欠です。これらにより、バッチがデータセット全体を適切に代表し、ひいては学習が適切に行われることが保証されます。
機械学習モデルで過学習を防ぐにはどうすればよいですか?
機械学習モデルで過学習を防ぐには、学習曲線を使用してトレーニング損失と検証損失を可視化し、交差検証を使用して未知のデータに一般化します。
ミニバッチ勾配降下法とは何ですか?また、バッチ勾配降下法や確率的勾配降下法とどう違いますか?
ミニバッチ勾配降下法は、トレーニングデータのサブセットを処理することで、バッチ勾配降下法と確率的勾配降下法のバランスを取る方法であり、より速い収束と安定性をもたらします。これは計算効率が高く、多くの機械学習アプリケーションで使用されています。