




MeituanがMilvus上に100億規模の検索プラットフォームを構築し、100以上のユースケースを支える方法

100億+ ベクトル
本番環境では、Milvus上で自己運用
1つのコレクションに20億+
アーキテクチャの再設計なしで成長した最大の単一ワークロード
P99 8.1 ms
1億ベクトル・768次元のベンチマークで、~1,000 QPS、97%超の再現率
100+ユースケース
共有された一つのMilvusプラットフォーム上で: RAG、エージェントメモリ、など
"MeituanがAIに本腰を入れたとき、私たちはベクトルのためにゼロから構築された検索基盤を必要としていました。私たちはオープンソースのMilvusを選び、あらゆるチームがその上に構築できるプラットフォームへと変えました。1年後、それは100億を超えるベクトルを保持し、RAGからエージェントメモリまで、当社で最も急速に成長しているAIワークロードを実行しています。"
The Meituan Database Team
Meituanについて
Meituan は、アジア最大級のテクノロジー企業のひとつであり、ローカルサービス向けの有力なオンデマンドプラットフォームを運営しています。そのスーパーアプリは、フードデリバリー、店内飲食・消費者レビュー、ホテル・旅行予約、生鮮食品、即時小売にまで及び、それらはすべて地域の加盟店と配達員の広大なネットワークを通じて実現されています。
AIは、Meituanがそのマーケットプレイスにサービスを提供する方法の中核となっており、顧客の質問への回答から、加盟店向けのよりスマートなツールの提供までを支えています。現在、100以上のビジネスシナリオがRAG、エージェントメモリ、マルチモーダル検索を利用しており、それぞれの基盤には高速でフィルタリング可能なベクトル検索が必要です。Meituanのデータベースチームは、その共有データ基盤をオープンソースのMilvus上で運用しています。
課題
Meituan全体でベクトル検索が拡大するにつれ、データベースチームはますます多様化するワークロードに対応する必要がありました。アプリケーションごとに、ベクトルデータ型、インデックスアルゴリズム、次元数、検索パフォーマンスの要件は異なり、データセットの規模は数百万から数十億ベクトルに及びました。
Meituanには、クエリパフォーマンス、リソース効率、運用コストのバランスを保ちながら、これらのさまざまな要件を大規模に満たす共有インフラストラクチャが必要でした。当初はElasticsearchでベクトル検索を運用していましたが、すぐにMeituanのパフォーマンス要件とコスト要件を満たせなくなりました。Elasticsearchはベクトルを4,096次元に制限しており、サポートするベクトル型はわずかで、ディスクインデックスもなかったため、すべてのベクトルをメモリ上に置く必要がありました。数億ベクトルの規模では、これによりMeituanの最大かつ最も急成長しているデータセットをオンラインで維持することが最も高コストになりました。チームは、RAMだけでなくディスク上でも巨大なデータセットを保持できるインデックスタイプを持つ、専用設計のベクトル検索エンジンを必要としていました。
Milvusを選んだ理由
データベースチームは、主要なベクトル検索エンジンを機能、パフォーマンス、エコシステムの観点から評価し、オープンソースのMilvusを選択しました。その決定には3つの理由があります。
- 機能面。 Milvusは、非常に多様なワークロードにわたってMeituanが必要とする幅広いベクトルデータ型とインデックスアルゴリズムを提供しました。超大規模コレクション向けのディスクベースのインデックスも含みます。また、ストレージとコンピューティングを分離したアーキテクチャにより、チームは大規模なベクトルワークロードを効率的にスケールさせる、より高い柔軟性を得られました。
- パフォーマンス。 チーム自身のベンチマーク(HNSWインデックス上の1億個の768次元ベクトル)では、MilvusはP99レイテンシを8.1ms、約1,000 QPSに維持し、再現率は97%以上でした。
- エコシステム。 Milvusはまた、Meituanのより広範なオープンソースAIスタックに自然に適合しました。成熟したSDK、ドキュメント、活発なコミュニティ(GitHubスター46k以上)を備え、社内チームが採用している一部のオープンソースフレームワークはすでにMilvusを直接サポートしていました。そのため、統合の摩擦が軽減され、新しいベクトル検索シナリオをプラットフォームに導入しやすくなりました。
ソリューション
主要なベクトル検索エンジンを評価した後、Meituanは成長するAIワークロードのためのベクトルネイティブ基盤としてMilvusを選択しました。一方、既存のElasticsearchデプロイメントは、より広範なデュアルエンジンアーキテクチャの一部として残りました。これらのベクトル利用ケースは、RAGとナレッジベース、エージェントメモリ、カスタマーサービス・診断エージェント、レコメンデーション、マルチモーダル検索に及びます。大半は類似した構成です。数百万から数千万のベクトル、768から1,536次元、約100クエリ/秒で提供されます。ごく一部ははるかに大きく、20億ベクトルを超えたワークロードもあります。
各チームがそれぞれMilvusを運用するのではなく、データベースチームがすべてを1つの共有プラットフォームに載せ、どのチームにもプロダクション対応のクラスターを提供し、ベクターデータベースの専門家にする必要をなくしました。このように多様なワークロードを単一のプラットフォームで処理するには、次の4つが重要でした。数十億のベクトルを安価に保持すること、テナントを分離して互いに悪影響を及ぼさないようにすること、ビジネスクリティカルなワークロードの信頼性を維持すること、そして小規模なチームが全員をサポートできる十分なセルフサービスを提供することです。
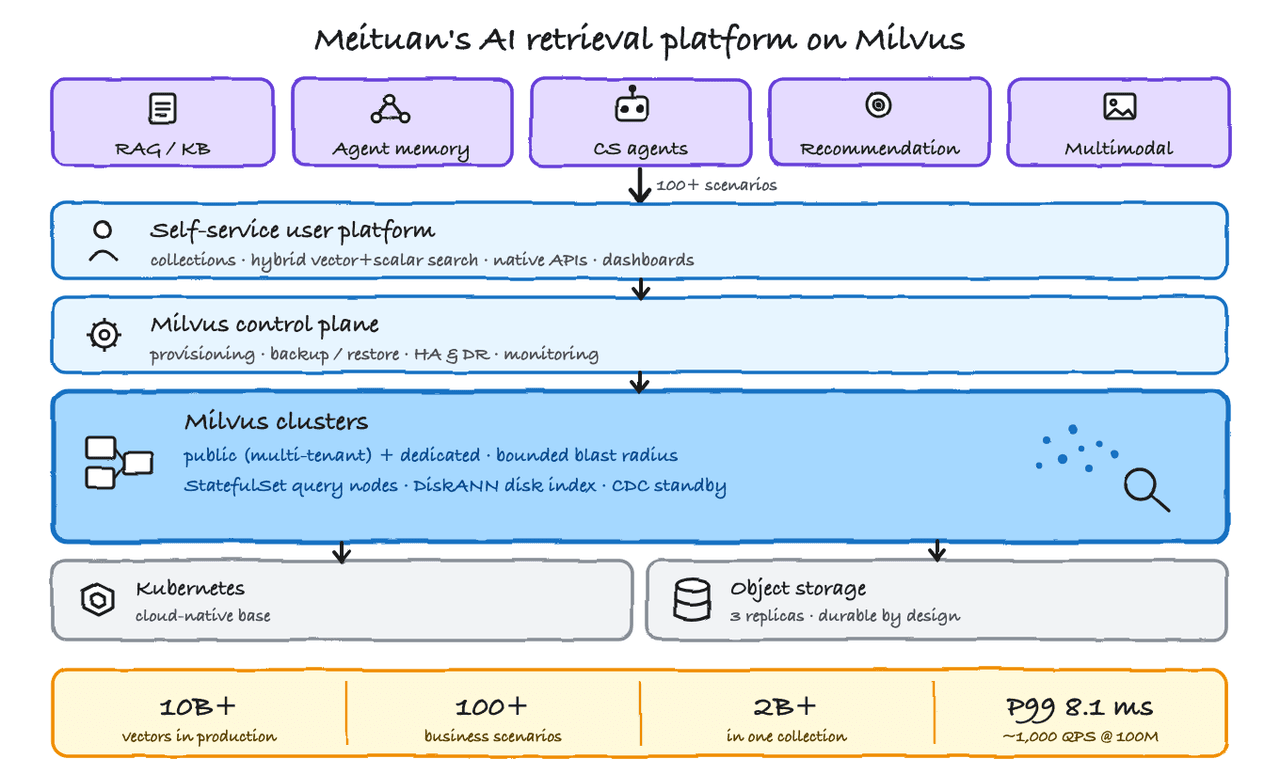 Meituan's AI retrieval platform on Milvus.PNG
ディスクインデックスで数十億のベクトルを安価に保持
コスト面での利点は、Milvusのディスクインデックスにあります。DiskANNにより、大規模なコレクションはメモリではなく大半をディスク上に置くため、20億ベクトルのワークロードでも手頃なコストを維持できます。Meituanのハードウェアでは、これらのインデックスは標準的なデプロイメントがクエリノードに与えるよりも多くのローカルディスクを必要とするため、チームは専用ボリュームをマウントし、MilvusのオペレーターをStatefulSetとして実行して、各ノードが再起動後も自分のディスクを保持するようにしました。オペレーターはオープンソースなので、これは簡単な変更であり、Meituanがこれほどディスクインデックスに依存できる理由です。
多数のテナントにわたる分離:爆発半径を制限したパブリッククラスターと専用クラスター
Milvusは、多くのテナントがそれぞれのデータベースを持ちながら1つのクラスターを共有できるため、Meituanは小規模ワークロードのロングテールをパブリッククラスターにまとめ、利用率を高く保っています。大規模なワークロードには専用クラスターが割り当てられます。100万ベクトルを超えるもの、高いQPSが必要なもの、ビジネスクリティカルなもの、独自のチューニングが必要なものなどです。
共有における唯一のリスクは爆発半径、つまり1つの問題のあるテナントが隣接するテナントを巻き添えにすることです。そのためMeituanはパブリッククラスターに載せるテナント数を制限し、配置前に新しいワークロードのジョブ、重要度、データを評価します。
クリティカルなワークロードの信頼性:高速フェイルオーバー、そしてCDCスタンバイ
Milvusはストレージとコンピューティングを分離しているため、データ自体はすでに安全です(オブジェクトストレージに3つのコピーが置かれています)。そのためMeituanの信頼性対策は、実際にはサービスを到達可能に保つことです。クライアントはプロキシノードを介してMilvusにアクセスしますが、プロキシがダウンすると、トラフィックを迅速に移動させる必要があります。Meituanは自社のMilvus SDK(Python版とJava版)にフェイルオーバーを組み込みました。コントロールプレーンが健全なプロキシを追跡し、そのリストをSDKに提供することで、クライアントは稼働中のプロキシに直接アクセスし、障害が発生したプロキシはシャットダウン前にリストから外れます。これにより、各クラスターの前にロードバランサーとそれに伴うオーバーヘッドを置く必要がなくなります。
ディザスタリカバリのために、Meituanはクラスターのノードをデータセンター全体に分散させます。まずプロキシとコーディネーター、次にミドルウェアを配置し、すべてのコンポーネントがアベイラビリティゾーン間でバランスを取り、予備(N+1)を持つことを目指します。本当に停止できないワークロードについては、MilvusのCDCを使用してスタンバイクラスターを同期し、プライマリが完全に障害になった場合に引き継げるようにしています。
セルフサービスで、小規模チームが全員を支える
Meituanのプラットフォームは、ワークロードを所有するチームに日常的な管理を委ねています。ビジュアルなCollection管理(作成、削除、ロード、リリース)、MilvusのネイティブAPIへのワンクリックアクセス、ベクトルとスカラーのハイブリッド検索、監視ダッシュボード、データベースレベルのアクセス制御です。バックアップはデータベース単位で自動実行され、データ同期チャネルはHiveやRDSなどのソースからベクトルを取り込み、ディザスタリカバリのために外部へ送り出します。日常的な作業がユーザーに移るため、オンコールの負荷は低く抑えられ、小規模なプラットフォームチームがフリート全体の健全性を維持します。
結果と利点
本番環境で100億+ベクトル、約1年でゼロから達成。1つの標準化されたプラットフォームが、100以上のユースケースでMilvusを大規模に実行し、自動化されたクラスターデリバリー、バックアップ、セルフサービスにより運用チームを小規模に保っています。
単一ワークロードでの10億規模、余裕あり。最大の単一ワークロードは、再アーキテクチャリングなしで20億ベクトルを超えました。
P99 8.1ms、約1,000 QPS、再現率97%以上を、チームの1億ベクトル・768次元のベンチマークで達成し、主に100 QPS未満のワークロードが必要とするよりはるかに余裕があります。
同社で最も急速に成長しているAIワークロードはここで稼働しています。 RAGとエージェントメモリが成長を牽引しているため、Meituanは各チームが独自に構築するのではなく、共有の検索基盤を構築しています。
10億規模のコレクションは手頃な価格を維持できます。 コレクションの大部分をRAMではなくディスクに置くことで、20億ベクトルのワークロードを手頃なコストで実行でき、Milvusがオープンソースであるため、チームは独自のディスクインデックスでさらにコストを削減し続けています。
戦略的な効果:ベクトル検索はもはや各Meituanチームが単独で解決する問題ではありません。それは標準化された信頼性の高いプラットフォームとなり、その上のAIチームはインフラストラクチャではなく製品の構築に集中できます。
次のステップ
Meituanは、3つの方面でMilvusへの投資を深めています。新しいクラスターはデフォルトでMilvus 2.6になり、チームは組み込みエンベディング機能などの機能を採用しながら、既存のワークロードを移行しています。カーネル側では、10億規模でコスト効率をさらに高めるために、Milvus 2.6上で独自に構築した量子化ベースのディスクインデックスを開発しています。また、エージェントが社内に広がるにつれて、チームはMilvusとそのエコシステム上にプラットフォームレベルのエージェントメモリ機能を構築しており、内部チームはメモリとナレッジベースの構成要素をすぐに利用できます。これらのそれぞれがMilvus上で実行されるものを成長させており、チームは今後もコミュニティに貢献し続ける予定です。
「Meituanは、オープンソースを前進させるまさにエンジニアリング駆動型の企業です:彼らは、ほとんどのチームが到達できない規模でMilvusを運用し、学んだことを還元しています。私たちは、MilvusがMeituanのAIワークロードの下にあるベクトル基盤であることを誇りに思いますし、彼らのチームやコミュニティとともに構築し続けることを楽しみにしています。」— James Luan, CTO, Zilliz
Milvusを始める、またはマネージドMilvusサービスを試す
Milvusは、世界で最も広く採用されているオープンソースのベクトルデータベースであり、10億規模の類似検索のために構築され、ラップトップから分散クラスターまで動作します。Meituanのプラットフォームの背後にある同じベクトルネイティブエンジンを提供します:あらゆる種類のインデックス、ベクトル・スカラーハイブリッド検索、そしてスケールするストレージ・コンピューティング分離アーキテクチャです。
MilvusはGitHubで始め、ドキュメントを読み、Discordでコミュニティに参加しましょう。
同じエンジンをフルマネージドサービスとして、メンテナンス不要な運用とエンタープライズセキュリティで利用したい場合、Zilliz CloudはMilvus上に構築され、そのAPIと互換性があります。